
La investigación de IDC muestra que los desafíos relacionados con documentos cuestan a las organizaciones $19,732 por cada trabajador de la información anualmente y reducen la productividad en 21.3 por ciento. Las organizaciones que reciben facturas de cientos de proveedores a menudo enfrentan diseños que varían según el emisor y cambian sin aviso. Los sistemas basados en plantillas requieren un mantenimiento constante a esta escala. El personal puede dedicar hasta el 30 por ciento de su tiempo a tareas relacionadas con documentos, y las tasas de error en la entrada manual de datos oscilan entre 1–4 por ciento. Las soluciones convencionales de procesamiento inteligente de documentos (IDP) abordan parte de esta carga, pero requieren una extensa configuración previa para cada formato de documento y se rompen cuando los diseños varían entre proveedores.
En esta publicación, aprende a crear un sistema agentico de IDP usando Amazon Bedrock AgentCore que clasifica, extrae, valida y aprende de documentos comerciales con una intervención humana mínima. Amazon Bedrock AgentCore es una plataforma para construir, conectar y optimizar agentes a escala, con cualquier framework o modelo. Sus agentes manejan automáticamente nuevos formatos de documentos, como facturas de proveedores, órdenes de compra, reclamaciones de seguros y solicitudes de préstamos. Al final de esta publicación, podrá:
- Desplegar un sistema de IDP multiagente, a menudo en menos de 20 minutos.
- Procesar nuevos tipos de documentos sin configuración manual de plantillas.
- Permitir que los agentes se entrenen a sí mismos en cada nuevo formato de documento y reutilicen lo que aprenden, de modo que los documentos posteriores de ese tipo vayan directamente a la extracción sin reentrenamiento.
Desafíos del procesamiento de documentos basado en reglas
Muchos pipelines de IDP requieren que defina plantillas, reglas de extracción y lógica de validación para cada formato de documento de antemano. Cuando un nuevo proveedor envía una orden de compra con un diseño diferente, el pipeline se rompe. Esto crea tres desafíos fundamentales:
- Rigidez de plantillas: Cada nuevo formato de documento requiere configuración manual, e incluso cambios menores en el diseño pueden causar fallos de extracción.
- Sin aprendizaje: Los mismos errores de extracción se repiten en documentos similares porque el sistema no retiene el conocimiento de correcciones anteriores.
- Carga de escalado: Cada nuevo proveedor o variante de documento multiplica el esfuerzo de mantenimiento, y las organizaciones que procesan documentos de cientos de fuentes enfrentan costos operativos continuos.
Un enfoque agentico aborda estos desafíos. En lugar de plantillas estáticas, los agentes de IA analizan cada documento, generan instrucciones de extracción, validan los resultados y aprenden de las correcciones automáticamente. Con el tiempo, su sistema construye una base de conocimiento de formatos de documentos, de modo que procesa documentos similares con una configuración adicional mínima.
Descripción general de la solución
En esta solución, ocho agentes especializados colaboran en dos flujos de trabajo basados en grafos que se ejecutan en Amazon Bedrock AgentCore.
El siguiente diagrama muestra el grafo de flujo de trabajo multiagente construido usando Strands Agents, un SDK de código abierto para construir agentes de IA.
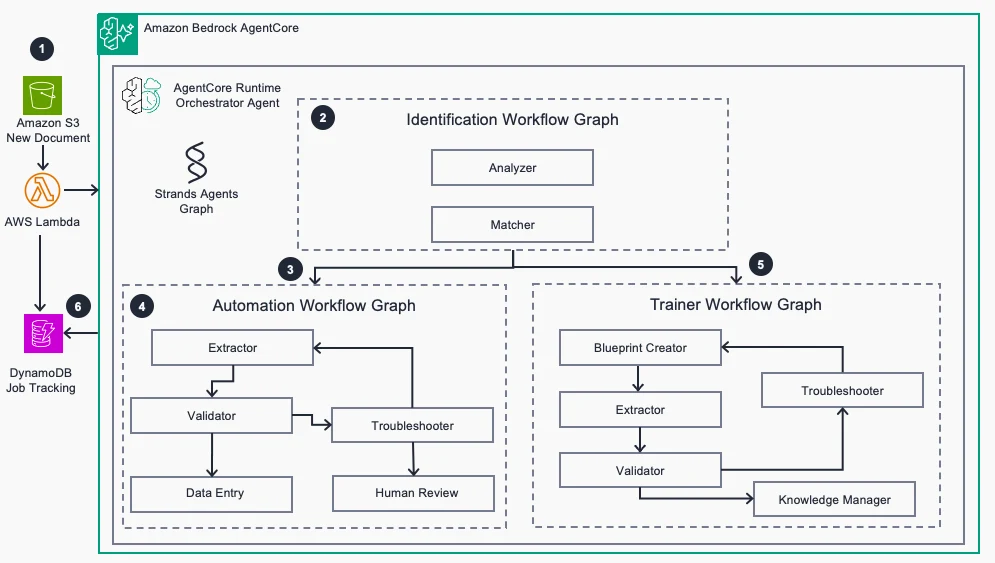
Figura 1: Grafo de flujo de trabajo de orquestación multiagente
- Flujo de trabajo de identificación: El agente Analyzer extrae texto usando Amazon Textract e identifica el tipo de documento y el remitente. El agente Matcher busca documentos similares usando similitud vectorial en Amazon S3 Vectors, una capacidad de Amazon Simple Storage Service (Amazon S3).
- Flujo de trabajo de entrenamiento (tipos de documentos nuevos): cuando no se encuentra ninguna coincidencia, el agente Instructions genera prompts de extracción, el agente Extractor extrae datos estructurados y el agente Validator verifica los resultados contra esquemas y reglas de negocio en Amazon Aurora DSQL. Si la validación falla, el agente Instructions Fixer refina los prompts y lo reintenta. Si tiene éxito, el agente Save Instructions persiste las instrucciones para su reutilización.
- Flujo de trabajo de automatización (tipos de documentos conocidos): cuando se encuentra una coincidencia, el agente Extractor usa instrucciones existentes. Si la validación falla, el agente Troubleshooter corrige directamente los datos extraídos sin modificar las instrucciones.
Cómo funciona
El siguiente diagrama muestra la arquitectura de infraestructura de la solución.
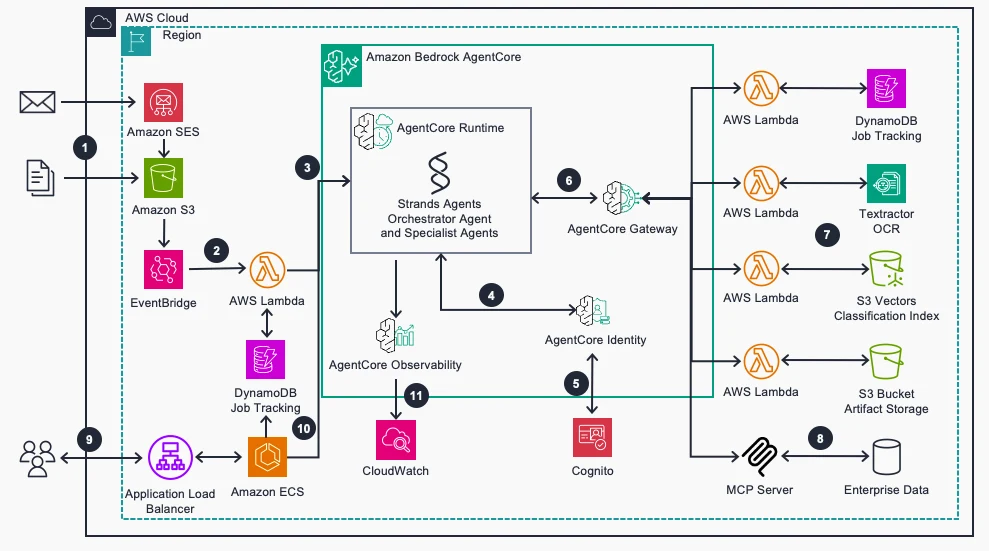
Figura 2: arquitectura de infraestructura de IDP agéntica en AWS
- Los documentos empresariales llegan a Amazon Simple Email Service (Amazon SES) o mediante carga directa a Amazon S3.
- Amazon EventBridge activa una función de AWS Lambda que crea un trabajo de seguimiento en Amazon DynamoDB e invoca AgentCore runtime, una capacidad de Amazon Bedrock AgentCore.
- AgentCore runtime orquesta el procesamiento de documentos a través de Strands Agents.
- Sus agentes acceden de forma segura a los recursos de AWS mediante credenciales de máquina a máquina gestionadas por AgentCore Identity, una capacidad de Amazon Bedrock AgentCore, y Amazon Cognito.
- Sus funciones de Lambda se convierten en herramientas compatibles con agentes mediante la interfaz Model Context Protocol (MCP) de AgentCore Gateway, una capacidad de Amazon Bedrock AgentCore.
- Los agentes extraen texto con Amazon Textract, clasifican documentos mediante incrustaciones vectoriales en S3 Vectors y validan datos contra reglas de negocio en Aurora DSQL.
- Los agentes acceden a los datos empresariales a través de servidores MCP para validar el contenido extraído contra reglas de negocio.
- Usted supervisa el estado y soluciona problemas mediante un panel con chat alojado en Amazon Elastic Container Service (Amazon ECS).
- Obtiene visibilidad del rendimiento de los agentes mediante AgentCore Observability, una capacidad de Amazon Bedrock AgentCore, y la telemetría de Amazon CloudWatch Despliegue de la solución
Siga estos pasos para desplegar la infraestructura de la solución y la interfaz web en su cuenta de AWS.
Requisitos previos
Para desplegar esta solución, debe tener:
Una
- cuenta de AWS Acceso a.
- Amazon Bedrock con los modelos Amazon Nova y Anthropic (Claude) habilitados. Para consultar la disponibilidad de modelos por región de AWS, consulte Supported models by AWS Region in Amazon Bedrock Acceso a Amazon Bedrock AgentCore (Runtime, Gateway, Identity), S3 Vectors y Amazon Aurora DSQL en una.
- Acceso a Amazon Bedrock AgentCore (Runtime, Gateway, Identity), S3 Vectors y Amazon Aurora DSQL en una AWS Cloud Development Kit.
- (AWS CDK) v2 instalado. (AWS CDK) v2 instalado.
- instalado y en ejecución (necesario para compilar y desplegar imágenes de contenedor). Python 3.11+ y Node.js 18+.
- Python 3.11+ y Node.js 18+.
- AWS Identity and Access Management (IAM) para crear buckets de S3, funciones de Lambda, tablas de DynamoDB, grupos de usuarios de Cognito, repositorios de Amazon Elastic Container Registry (Amazon ECR) y servicios de Amazon ECS.
- Clone el repositorio y configure el entorno:
git clone https://github.com/aws-samples/agenticidp-guidance.git cd agenticidp-guidance uv venv source .venv/bin/activate uv pip install -r requirements.txt cd ui/orchestrator npm install cd ../.. - Despliegue las pilas:
uv run deploy.py --admin-email your-email@example.com
Esto despliega seis pilas de AWS CloudFormation : Core (S3, Cognito, DynamoDB), Gateway (herramientas Lambda, AgentCore Gateway), Aurora (Amazon Aurora DSQL), Agent (runtime de AgentCore, contenedores), UI Orchestrator (endpoints de API) y Modern UI (aplicación React en Amazon CloudFront). El despliegue toma aproximadamente 15–20 minutos.
- Verifique el despliegue comprobando que cada pila muestre
CREATE_COMPLETEen la consola de CloudFormation.
Procese archivos y revise los resultados
Después del despliegue, recibirá un correo electrónico con la URL de CloudFront, el nombre de usuario y la contraseña temporal.
Procese un documento
- Inicie sesión en la interfaz web y elija Process Document.
- Cargue una orden de compra de ejemplo desde
infrastructure/sample_data/purchase_orders/training/. - El documento entra en el flujo de trabajo del agente:
- El agente Analyzer extrae el texto e identifica el remitente y el tipo de documento.
- El agente Matcher busca documentos similares en el almacén de vectores.
- Para un nuevo tipo de documento, el flujo de trabajo de entrenamiento genera instrucciones de extracción, extrae los datos, los valida y guarda las instrucciones para uso futuro.
- Para un tipo de documento conocido, el flujo de trabajo de automatización extrae los datos usando las instrucciones existentes y los valida.
- Revise los resultados en la pestaña Review Jobs and Instructions para verificar los datos extraídos, los resultados de validación y las instrucciones generadas.
Ejemplo: Un nuevo tipo de documento (flujo de trabajo de entrenamiento)
Suponga que sube la primera orden de compra de un nuevo minorista, Two Wheel Store. El agente Matcher busca en el almacén de vectores, no encuentra ningún documento similar y enruta el trabajo a través del flujo de trabajo de entrenamiento.
El agente Analyzer usa Amazon Textract para extraer el texto sin procesar del documento:
# PURCHASE ORDER
FROM: Two Wheel Store
Order #: PO-2026-0102-2584
Date: 2026-01-02

## Items Ordered
AC-021  Advanced Computer     Qty: 1   $75.61
        Colors: cr4321        @ $75.61
...
SB-004  Folding Classic       Qty: 8   $9634.32
        Colors: cb8901 I Sizes: S     @ $1204.29

TOTAL: $14931.54
El agente Instructions genera prompts de extracción a partir del esquema, y el agente Extractor produce JSON estructurado:
{
  "po_number": "PO-2026-0102-2584",
  "retailer_name": "Two Wheel Store",
  "order_date": "2026-01-02T00:00:00Z",
  "line_items": [
    { "sku": "AC-021", "product_name": "Advanced Computer", "quantity": 1, "unit_price": 75.61, "line_total": 75.61 },
    { "sku": "SB-004", "product_name": "Folding Classic",   "quantity": 8, "unit_price": 1204.29, "line_total": 9634.32 }
  ],
  "order_total": 14931.54
}
El agente Validator verifica el resultado contra el esquema y falla:
validation_status: INVALID
error: 'SB-004' does not match '^AB-[A-Z]{2}-\d{3}$'
El formato de SKU del proveedor (SB-004) no coincide con el formato interno de Acme Bikes (AB-SB-004). El agente Instructions Fixer diagnostica la discrepancia y agrega una regla explícita de transformación de SKU al prompt de extracción: anteponer a los SKU del proveedor AB-. En la segunda pasada, los siete artículos de línea se validan con éxito, y el agente Save Instructions guarda el prompt refinado en el almacén de vectores. Tiempo de extremo a extremo para esta primera ejecución: 3 minutos 49 segundos.
Ejemplo: Un tipo de documento conocido (flujo de trabajo de automatización)
Cuando llega una segunda orden de compra de Two Wheel Store, el agente Matcher encuentra las instrucciones almacenadas de la primera ejecución con una puntuación de confianza de 3.946 (umbral: 3.7) y enruta el trabajo a través del flujo de trabajo de automatización:
- El agente Extractor aplica las instrucciones almacenadas directamente, por lo que el orquestador omite la generación de prompts. La regla de transformación de SKU aprendida durante el entrenamiento se aplica automáticamente (
EL-002→AB-EL-002,HB-071→AB-HB-071,PD-002→AB-PD-002). - Los tres artículos de línea se validan en la primera pasada con un total de la orden de $5,979.19.
- El procesamiento de extremo a extremo se completa en 1 minuto 30 segundos, frente a los 3 minutos 49 segundos de la primera ejecución.
Use el chat interactivo
El panel incluye una interfaz de chat para la resolución de problemas:
- Pregunte
what tools do you havepara ver las capacidades disponibles de los agentes. - Pregunte
list instructionspara ver las instrucciones de extracción almacenadas. - Pregunte
what is the status of job XXXXpara consultar el progreso del procesamiento. - Pregunte
what went wrong with job XXXX, how can we update the instructions?para diagnosticar fallos.
Comprenda cómo mejora la precisión con el tiempo
El sistema mejora con el tiempo mediante dos bucles de retroalimentación:
- Bucle de entrenamiento: Cuando el agente Instructions Fixer refina los prompts de extracción tras fallos de validación, las instrucciones mejoradas se guardan y se reutilizan para documentos similares.
- Bucle de procesamiento: Cuando el agente Troubleshooter corrige errores de extracción, proporciona un análisis detallado que ayuda a identificar patrones en las variaciones del formato de los documentos.
Al cambiar de modelo, use AgentCore Evaluations, una capacidad de Amazon Bedrock AgentCore, para confirmar que la calidad de la extracción se mantiene aceptable. La solución ya utiliza AgentCore Observability, por lo que cuenta con la instrumentación necesaria.
Costo estimado
Solo paga por lo que utiliza, porque la solución se ejecuta en recursos serverless y bajo demanda sin costos de inactividad. Para una carga de trabajo de 10 documentos de entrenamiento y 1,000 documentos procesados cada mes en US East (N. Virginia), el costo estimado es de aproximadamente $58 al mes. La inferencia del modelo de base (FM) a través de Amazon Bedrock representa aproximadamente el 85 por ciento del costo total, alrededor de $0.055 por documento. El costo real depende en gran medida de los modelos asignados a cada agente. Las elecciones de modelos están centralizadas en agents/orchestratorgraph/utils/config.py, por lo que puede usar modelos de menor costo para tareas más simples y modelos más potentes donde sea necesario. Para obtener precios detallados, consulte la página de precios de Amazon Bedrock .
Personalice la solución para su caso de uso
Obtiene un caso de uso de procesamiento de órdenes de compra con un conjunto de datos sintético de una empresa de bicicletas, un esquema JSON preconstruido y una función Lambda de validación que verifica los datos extraídos contra los registros de productos y proveedores en una base de datos ERP simulada. Para procesar sus propios documentos, debe reemplazar los esquemas y la lógica de validación incluidos por los suyos.
Defina su esquema de documento
Cree un esquema JSON que defina los campos que desea extraer para cada tipo de documento. El esquema de ejemplo de orden de compra en agents/orchestratorgraph/doc_schema/purchase_order_schema.json sirve como referencia. Su esquema debe especificar los nombres de los campos, los tipos de datos y si cada campo se declara explícitamente en el documento o se infiere del contexto.
Construya su proceso de validación
El validador incluido comprueba los datos de la orden de compra contra tablas sintéticas de proveedores y productos en Aurora DSQL. Su implementación de producción requiere un proceso de validación adaptado a sus reglas de negocio. Por ejemplo:
- Un validador de facturas podría verificar los ID de proveedores contra su sistema de cuentas por pagar y comprobar que los totales de las partidas coincidan con el total de la factura.
- Un validador de contratos podría verificar que el documento contenga las cláusulas requeridas y que las fechas y los nombres de las partes coincidan con sus registros.
- Un validador de reclamaciones podría verificar números de póliza, límites de cobertura e información del reclamante contra su sistema de gestión de pólizas.
Para añadir un nuevo validador, cree una función de Lambda que acepte JSON extraído y devuelva un resultado de aprobación/rechazo con mensajes de error detallados, y luego regístrela como una herramienta en AgentCore Gateway. Consulte gateway/tools/po_validator_tool/ para conocer el patrón de implementación.
Actualice los prompts del agente
Los prompts del agente en agents/orchestratorgraph/prompts/ hacen referencia a terminología de órdenes de compra. Actualice estos prompts para reflejar sus tipos de documentos y requisitos de extracción. El agente Orchestrator, el agente Validator y el agente Instructions contienen cada uno lenguaje específico del tipo de documento que debe adaptar.
Buenas prácticas
Tenga en cuenta estas recomendaciones mientras entrena y opera su sistema IDP agéntico.
- Comience con muestras representativas: Cargue de 5 a 10 documentos por tipo durante el entrenamiento, incluidos casos límite con variaciones de formato, para crear instrucciones de extracción fiables.
- Use validación de reglas de negocio: Conecte los validadores a sus datos de referencia (listas de proveedores, catálogos de productos) en Aurora DSQL para detectar temprano los errores de extracción.
- Monitoree el rendimiento de los agentes: Use AgentCore Observability y CloudWatch para rastrear las rutas de ejecución, identificar cuellos de botella y medir la precisión de la extracción a lo largo del tiempo.
- Añada tipos de documentos de manera incremental: Cree un esquema JSON para cada nuevo tipo de documento y una función de Lambda de validación correspondiente. Los agentes se encargan del resto.
- Añada salvaguardas para producción: Aplique Amazon Bedrock Guardrails para imponer el filtrado de contenido y las comprobaciones de anclaje en las salidas de los agentes. Esto es especialmente importante cuando procesa tipos de documentos sensibles como reclamaciones de seguros o solicitudes de préstamos.
- Revise el OWASP Top 10 para LLMs: Consulte el OWASP Top 10 for LLMs and Generative AI Apps para conocer consideraciones de seguridad al crear aplicaciones que usan modelos de lenguaje de gran escala (LLMs).
Limpieza
Importante: Antes de ejecutar la limpieza, exporte los datos que desea conservar. El destroy.py script elimina permanentemente los documentos procesados (S3), el historial de trabajos (DynamoDB), los datos de validación (Aurora DSQL) y las instrucciones de extracción aprendidas (almacén de vectores).
Para evitar cargos continuos, elimine los recursos implementados:
uv run destroy.pyVerifique en la consola que las seis pilas de CloudFormation estén eliminadas: AgenticIDP-Core-Dev, AgenticIDP-Gateway-Dev, AgenticIDP-Aurora-Dev, AgenticIDP-Agent-Dev, AgenticIDP-UIOrchestr-Dev y AgenticIDP-ModernUI-Dev.
Conclusión
En esta publicación, aprendió a construir un sistema de procesamiento de documentos que se mejora a sí mismo usando Amazon Bedrock AgentCore, donde agentes de IA especializados colaboran para clasificar, extraer, validar y aprender de los documentos de negocio. Este enfoque agéntico se adapta automáticamente a nuevos formatos de documentos y mejora la precisión con el tiempo mediante bucles de retroalimentación, reemplazando la configuración manual de plantillas por aprendizaje autónomo.
Como próximos pasos:
- Despliegue el solución de muestra y pruebe con los ejemplos de órdenes de compra incluidos.
- Agregue sus propios tipos de documentos creando esquemas JSON y reglas de validación.
- Explore cómo integrar los datos extraídos con sistemas posteriores como ERP, CRM o herramientas de gestión de contenido.
Para obtener más información sobre los servicios y patrones utilizados en esta publicación, consulte los siguientes recursos:
- Para un análisis profundo del framework de agentes utilizado en esta solución, consulte Strands Agents SDK: Un análisis técnico profundo de las arquitecturas de agentes y la observabilidad.
- Para entender cómo AgentCore Gateway transforma las API en herramientas compatibles con agentes, consulte Introducing Amazon Bedrock AgentCore Gateway: Transforming enterprise AI agent tool development.
- Para obtener información de contexto sobre el Model Context Protocol y cómo se integra con los servicios de AWS, consulte Unlocking the power of Model Context Protocol (MCP) on AWS.
- Para aprender cómo los agentes pueden retener el contexto entre sesiones, consulte Amazon Bedrock AgentCore Memory: Building context-aware agents.
- Para obtener detalles sobre las capacidades de Amazon Bedrock AgentCore, consulte la documentación de Amazon Bedrock AgentCore.
Para recibir asesoría experta en la creación de soluciones de procesamiento de documentos, AWS Professional Services y AWS Partners pueden ayudar.