
vLLM es un motor de inferencia y servicio de código abierto para modelos de lenguaje de gran escala (LLMs). La inferencia de LLMs tiene dos fases distintas: prefill, que procesa el prompt de entrada y construye la caché de clave-valor (KV), y decode, que usa esa caché para generar la salida un token a la vez. Estas fases tienen características diferentes de cómputo, memoria y escalado. La desagregación prefill-decode (P-D) ejecuta ambas fases en instancias de motor separadas, lo que permite escalar y optimizar cada fase de forma independiente. Esto puede mejorar la utilización de recursos, el rendimiento y la latencia bajo carga. Sin embargo, también requiere transferir la caché KV de la instancia de prefill a la instancia de decode antes de que pueda comenzar la generación de tokens, haciendo que una transferencia KV eficiente sea crítica para el time-to-first-token (TTFT).
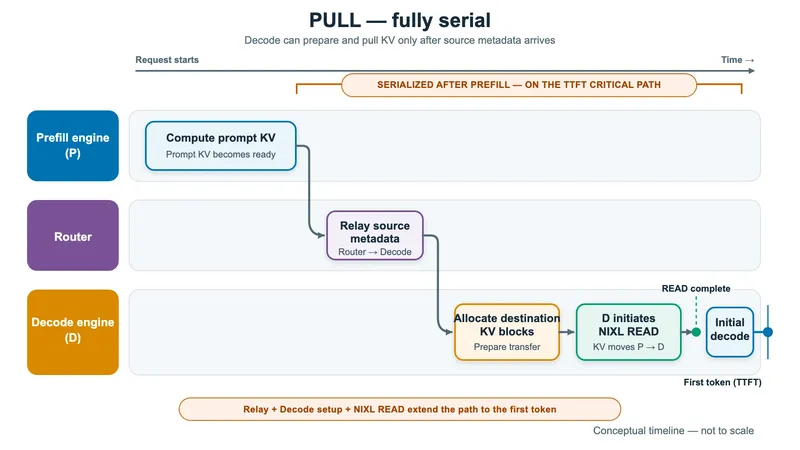
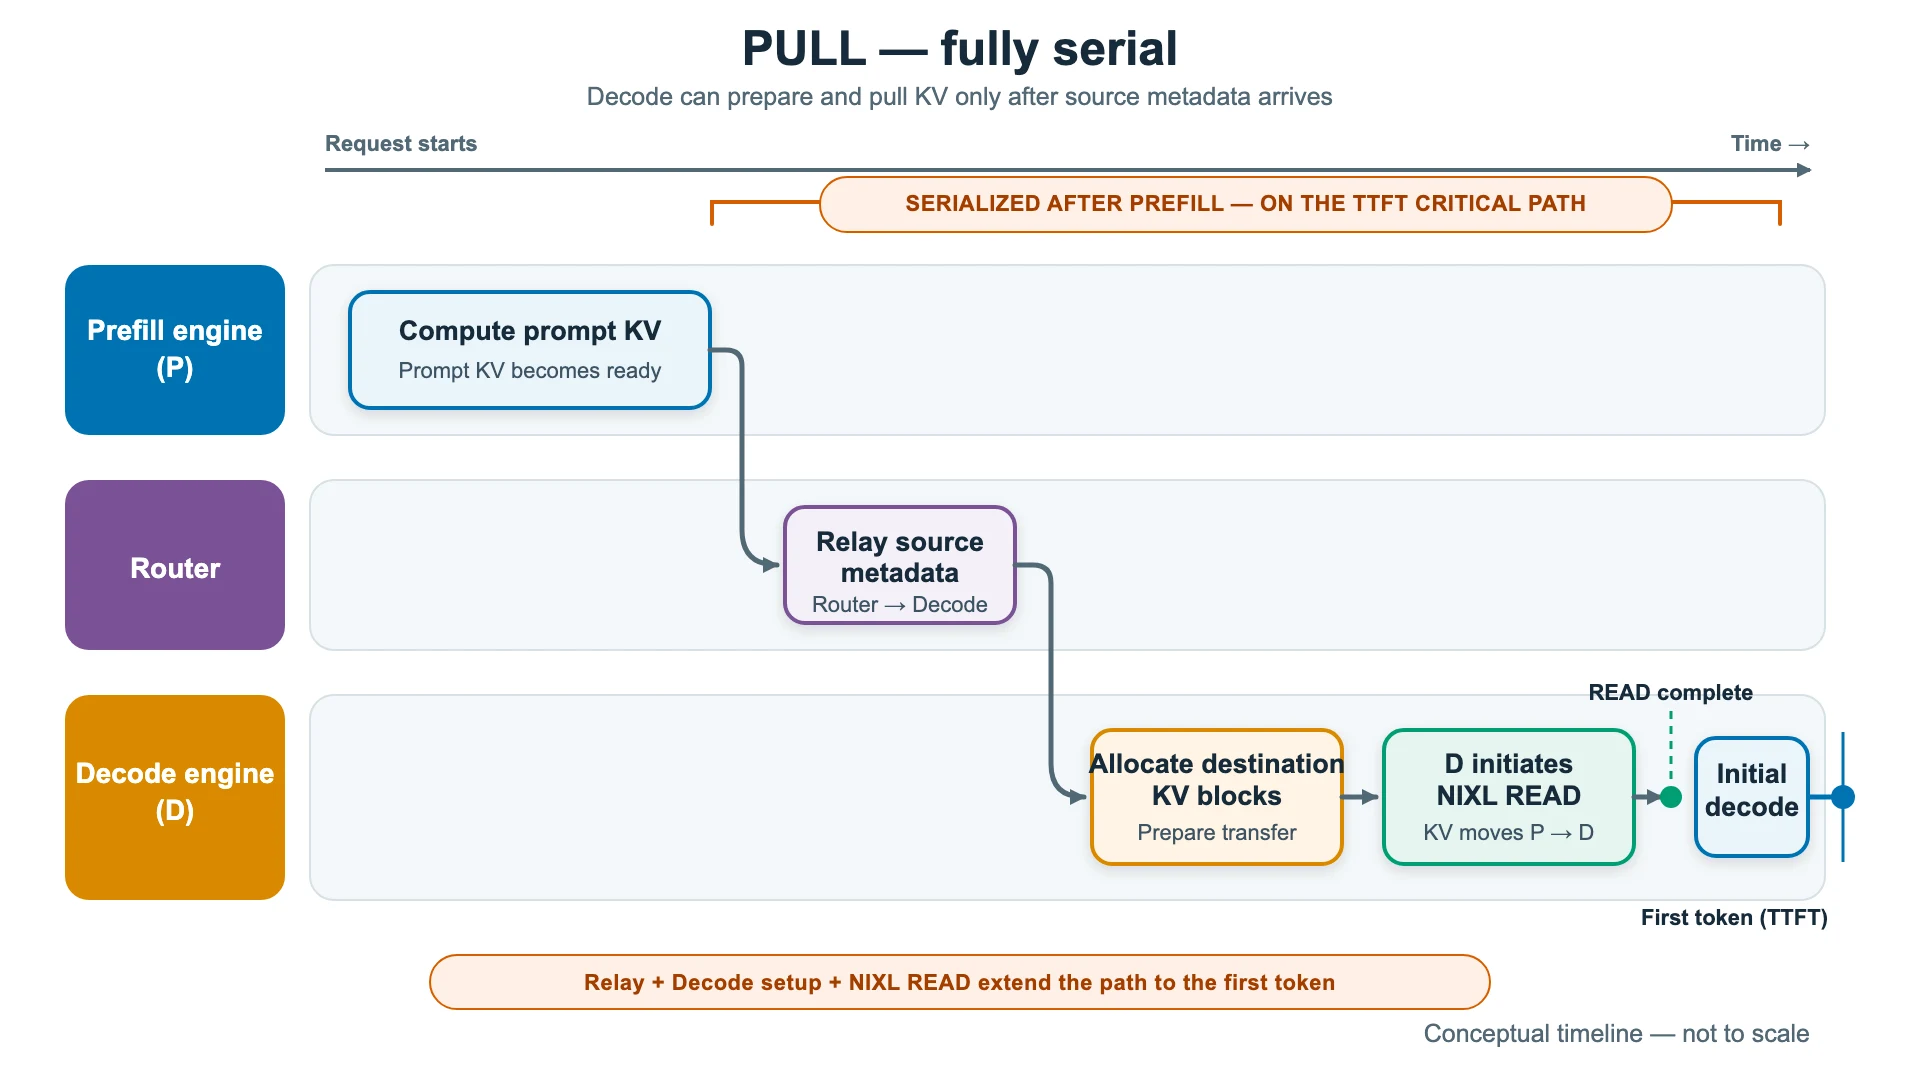
Una de las formas en que vLLM realiza esta transferencia es a través del conector de la NVIDIA Inference Xfer Library (NIXL) connector, que mueve bloques KV por interconexiones con capacidad RDMA como AWS Elastic Fabric Adapter (AWS EFA, la red RDMA de baja latencia utilizada entre servidores en AWS). En tipos de instancia compatibles, AWS EFA soporta GPUDirect RDMA y Neuron Direct RDMA, permitiendo a NIXL transferir bloques KV directamente entre memorias de dispositivo GPU o Trainium sin pasar por la memoria del host. El modo predeterminado del conector NIXL es pull-based: Después de que la instancia de prefill termina de calcular la caché KV del prompt, el router retransmite los metadatos de origen, incluidos los IDs de bloques de prefill, a la instancia de decode. La instancia de decode entonces asigna los bloques de destino, prepara la transferencia NIXL e inicia NIXL READ para extraer los bloques KV de la instancia de prefill. Como estos pasos de coordinación y configuración ocurren secuencialmente después del prefill y antes de que pueda comenzar el decode, prolongan el camino crítico del TTFT, como se muestra en la siguiente línea de tiempo.
Esta publicación presenta un conector NIXL basado en push que saca del camino crítico la coordinación y configuración de la transferencia posterior al prefill. Para los clientes que ejecutan inferencia desagregada prefill/decode con vLLM, esto puede mejorar la capacidad de respuesta de la aplicación al reducir TTFT y TPOT, particularmente a altas tasas de solicitudes.
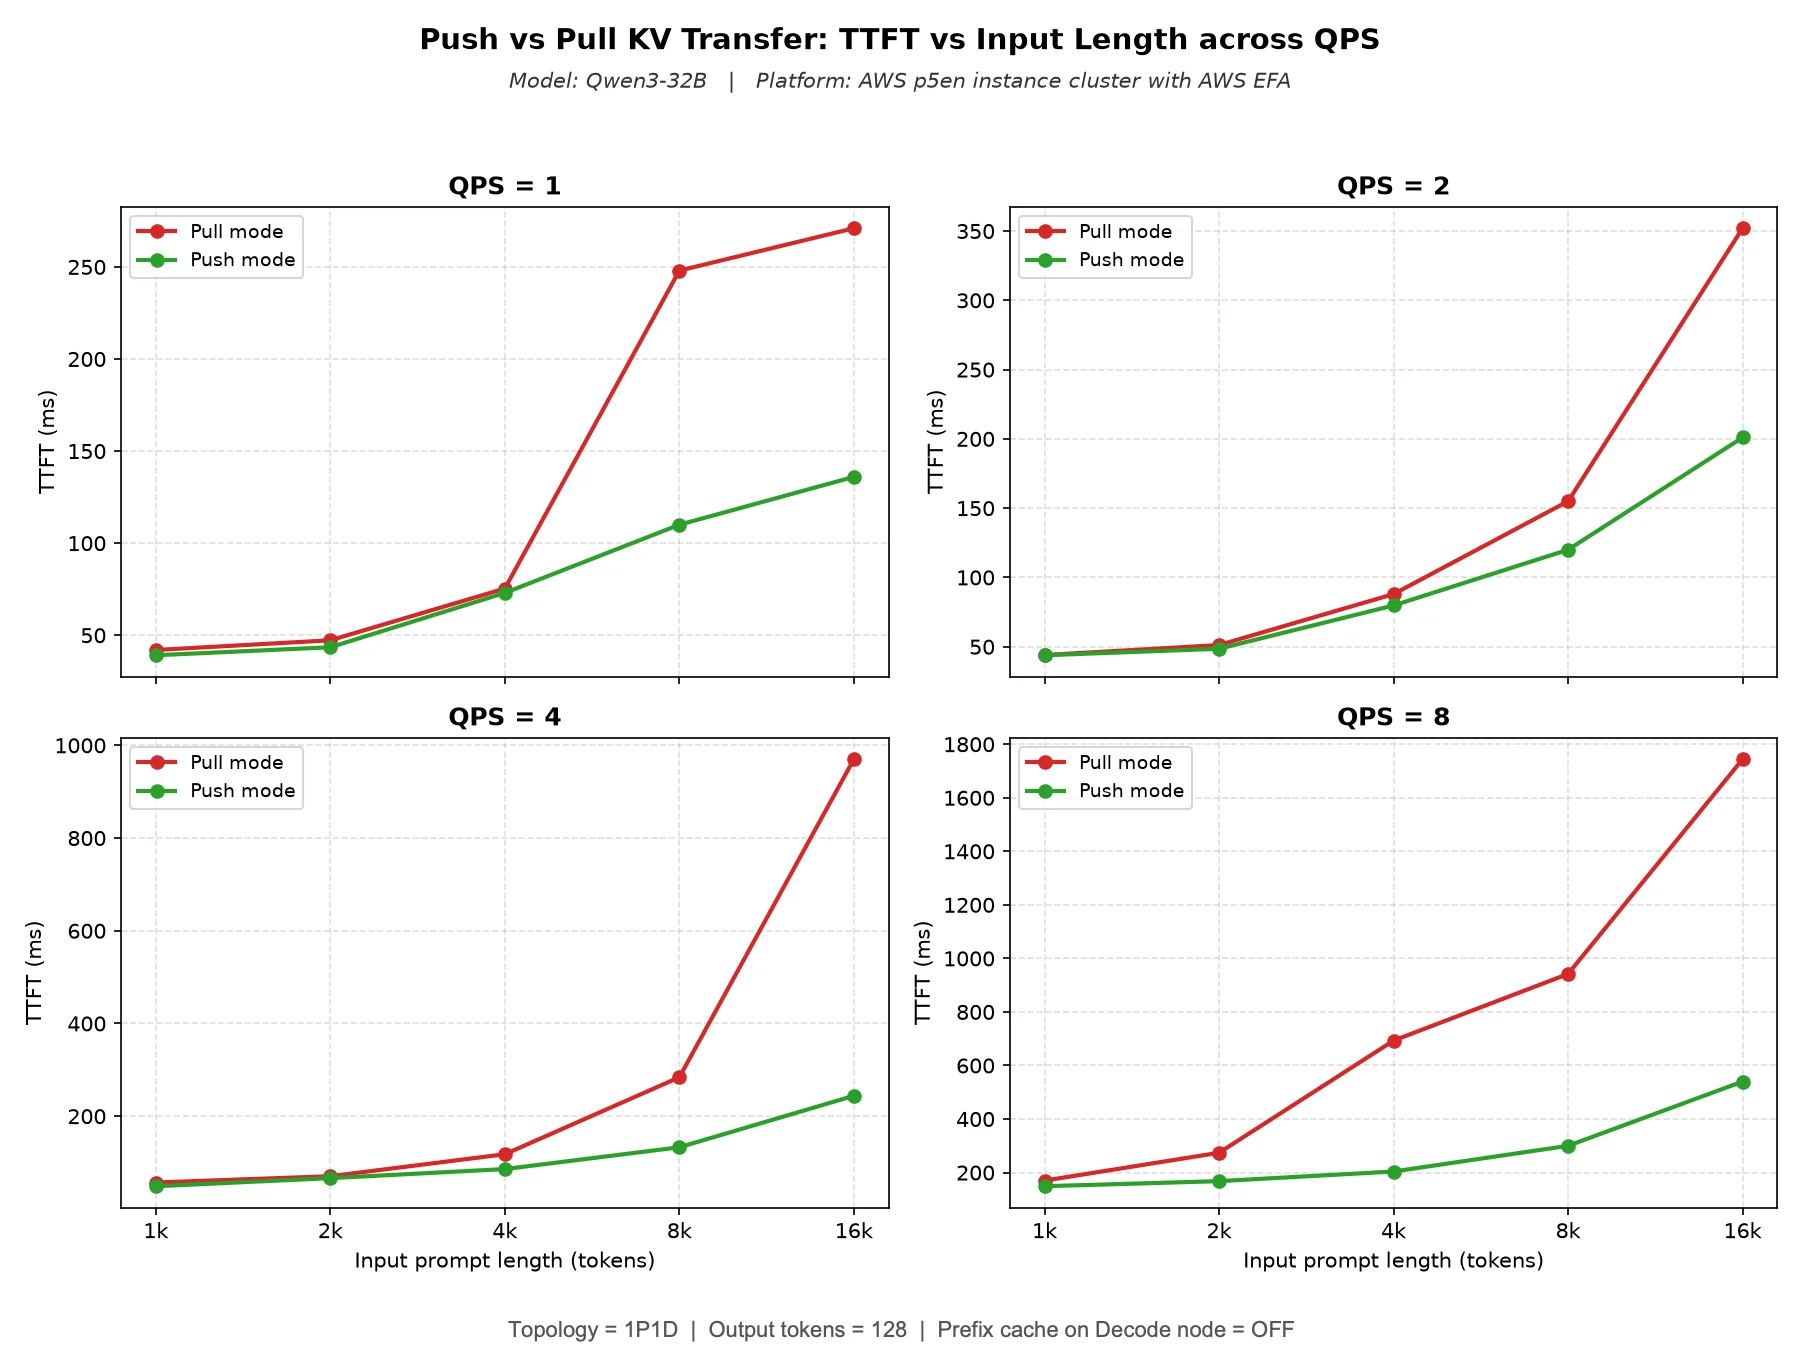
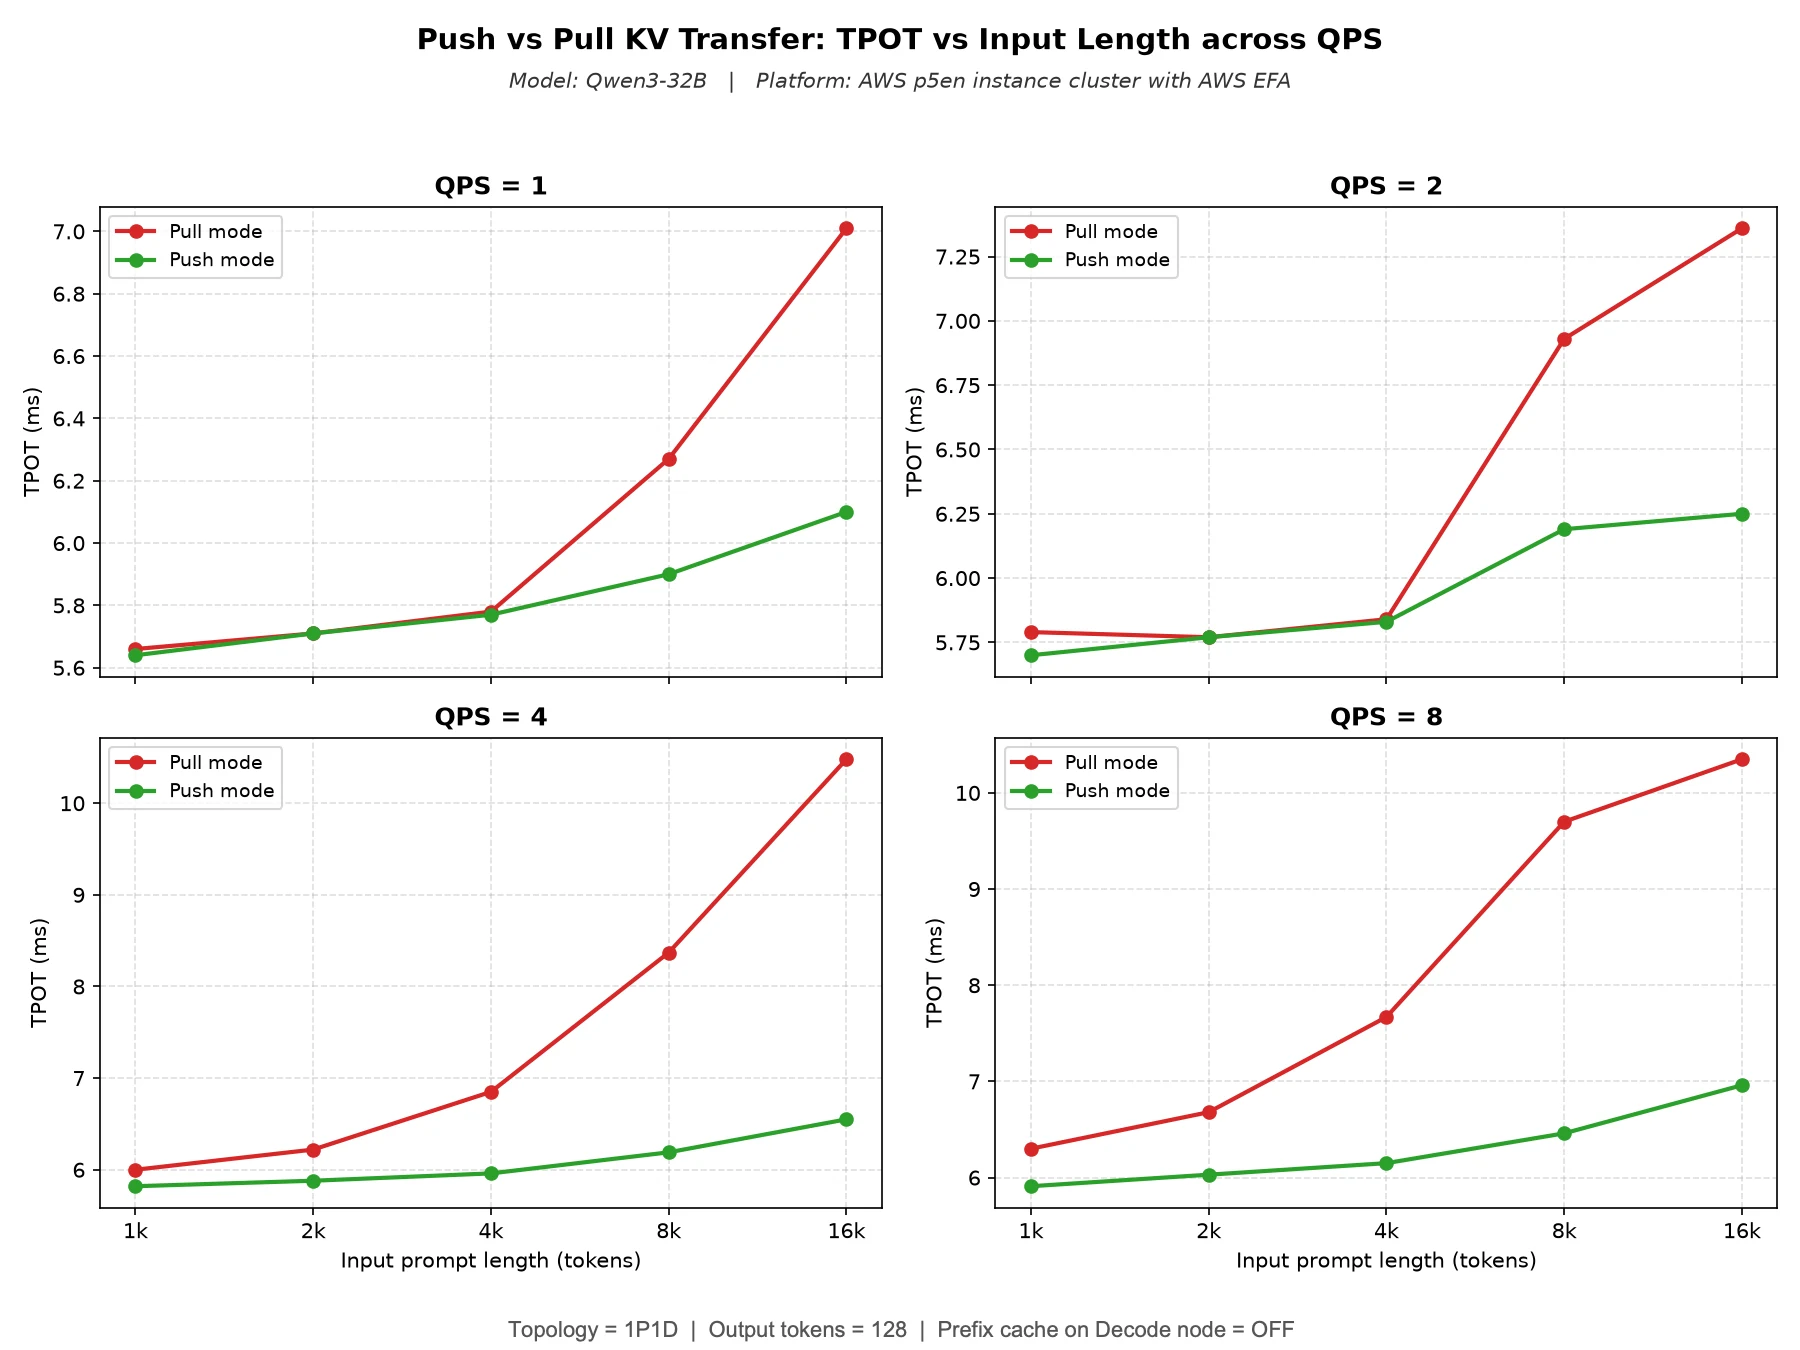
En nuestro benchmark en un despliegue 1P1D usando instancias Amazon EC2 P5en conectadas con EFA, el modo push entregó hasta 3x mejor TTFT y hasta 30% mejor tiempo por token de salida (TPOT) en comparación con el modo pull (ver la sección de datos de rendimiento ) para el modelo Qwen3-32B; los resultados dependen de la carga de trabajo y la configuración.
Construimos y validamos la función en clústeres de instancias AWS Trainium conectadas con EFA, y luego la contribuimos a vLLM como una función agnóstica del acelerador. Los resultados aquí provienen de un clúster AWS p5en (GPU) con EFA, mostrando que las ganancias se trasladan a las GPUs. Esta publicación explica la arquitectura basada en push, el flujo de transferencia, el modelo de hilos, los resultados de rendimiento y cómo reproducir el benchmark.
Transferencia KV basada en push
Descripción general de la arquitectura
La transferencia basada en push mejora el TTFT y el rendimiento de decode por dos razones:
- Elimina la serialización del modelo pull al superponer el trabajo del productor y del consumidor. La instancia de decode registra sus bloques de destino por adelantado mientras el productor todavía está calculando KV. La transferencia comienza tan pronto como los bloques del productor están listos, en lugar de después de un viaje de ida y vuelta de descubrimiento de identificadores en el lado del consumidor, eliminando ese viaje de ida y vuelta del camino al primer token.
- Mueve el tiempo de configuración de la transferencia fuera de la instancia de decode. Esa configuración —preparar los descriptores NIXL y enviar la transferencia— se ejecuta en el lado de prefill y en un hilo en segundo plano, de modo que la instancia de decode no gasta esos ciclos durante su fase crítica de latencia de generación de tokens.
El efecto neto es un TTFT más bajo y un mayor rendimiento de tokens de salida en la instancia de decode.
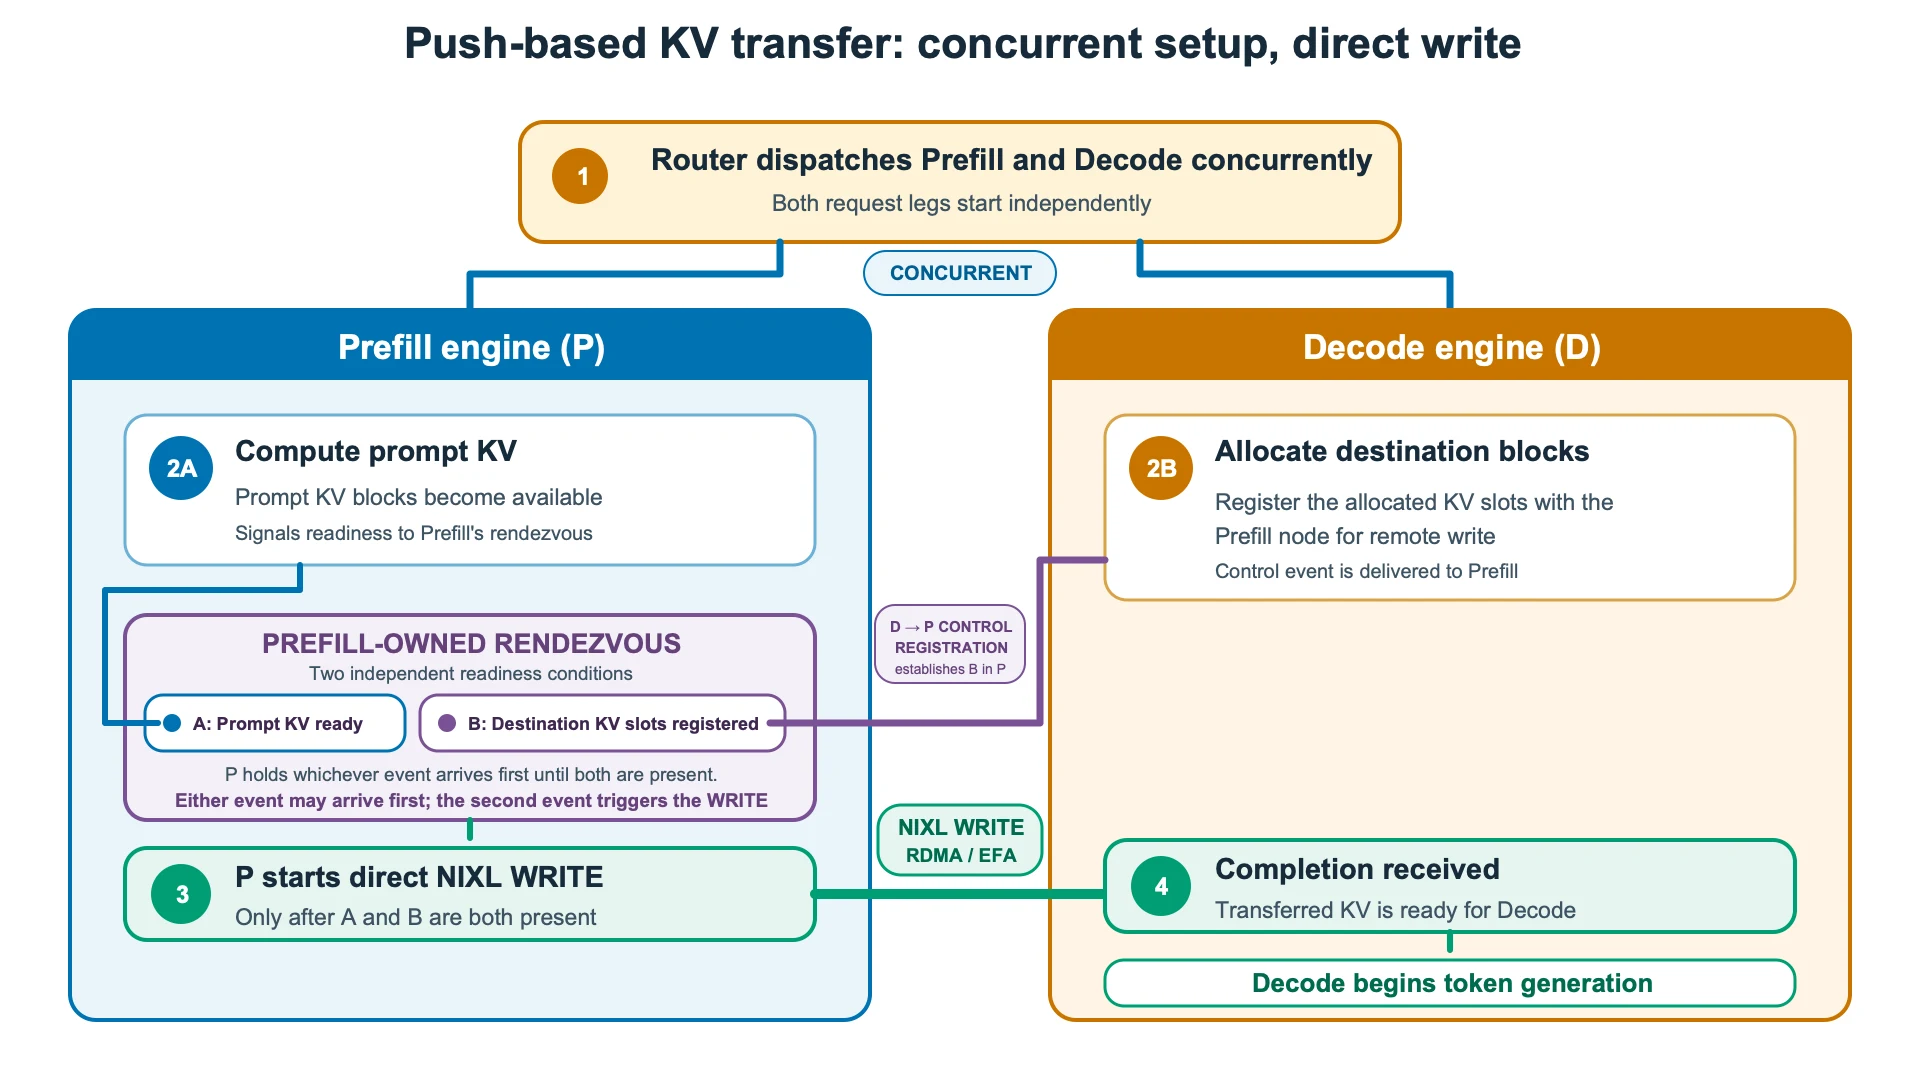
El conector push coordina tres actores: la instancia de decodificación, que registra sus bloques de destino por adelantado; la instancia de prefill, que empareja cada solicitud y emite la transferencia; y un hilo de fondo dedicado que saca la escritura del KV del bucle de pasada hacia adelante del motor. El siguiente diagrama muestra cómo encajan estas piezas.
Detalles de implementación
El protocolo tiene tres pasos lógicos.
1. Registro (lado del decode). Cuando la instancia de decode asigna bloques locales para una solicitud que requiere prefilling remoto, prepara un registro que describe dónde debe escribir el KV la instancia de prefill: su propia identidad y las ubicaciones de bloques que acaba de reservar. Dentro del mismo paso del motor, el worker transmite este registro a la instancia de prefill como una notificación NIXL. Debido a que el registro ocurre en el momento de la asignación, el conector conoce los bloques de destino antes de que la instancia de prefill complete el prefill.
2. Rendezvous (lado del prefill). El registro del decodificador y la finalización del prefill en el productor pueden llegar en cualquier orden, y el conector maneja ambos casos. Si el registro llega primero, el productor lo retiene hasta que su propio prefill termine. Si el prefill termina primero, el productor retiene los bloques de la solicitud hasta que llegue el registro. El evento que ocurra en segundo lugar activa la transferencia. El conector empareja las solicitudes por identificador, y la correspondencia tiene en cuenta las solicitudes reemitidas, asociando correctamente las solicitudes con preemption o reintentadas.
3. Transferencia (lado del prefill). Una vez que una solicitud se empareja, el productor establece una conexión con la instancia de decode (si aún no existe) y emite un NIXL WRITE que copia los bloques KV directamente en la memoria registrada del decodificador, dirigiéndose a cada rank de tensor-paralelismo de destino. El productor y el consumidor pueden usar disposiciones internas de bloques diferentes. Cada lado mapea las ubicaciones de bloques a su propia disposición física en el momento de la transferencia, lo que permite tamaños de bloque distintos en cada lado. Cada WRITE lleva una notificación de finalización que NIXL entrega a la instancia de decode una vez que los datos llegan. El decodificador cuenta estas notificaciones, una por cada rank del productor que escribe en él, y considera el KV recibido solo después de que hayan llegado todas las notificaciones esperadas, momento en el cual la solicitud pasa a decode.
Modelo de hilos
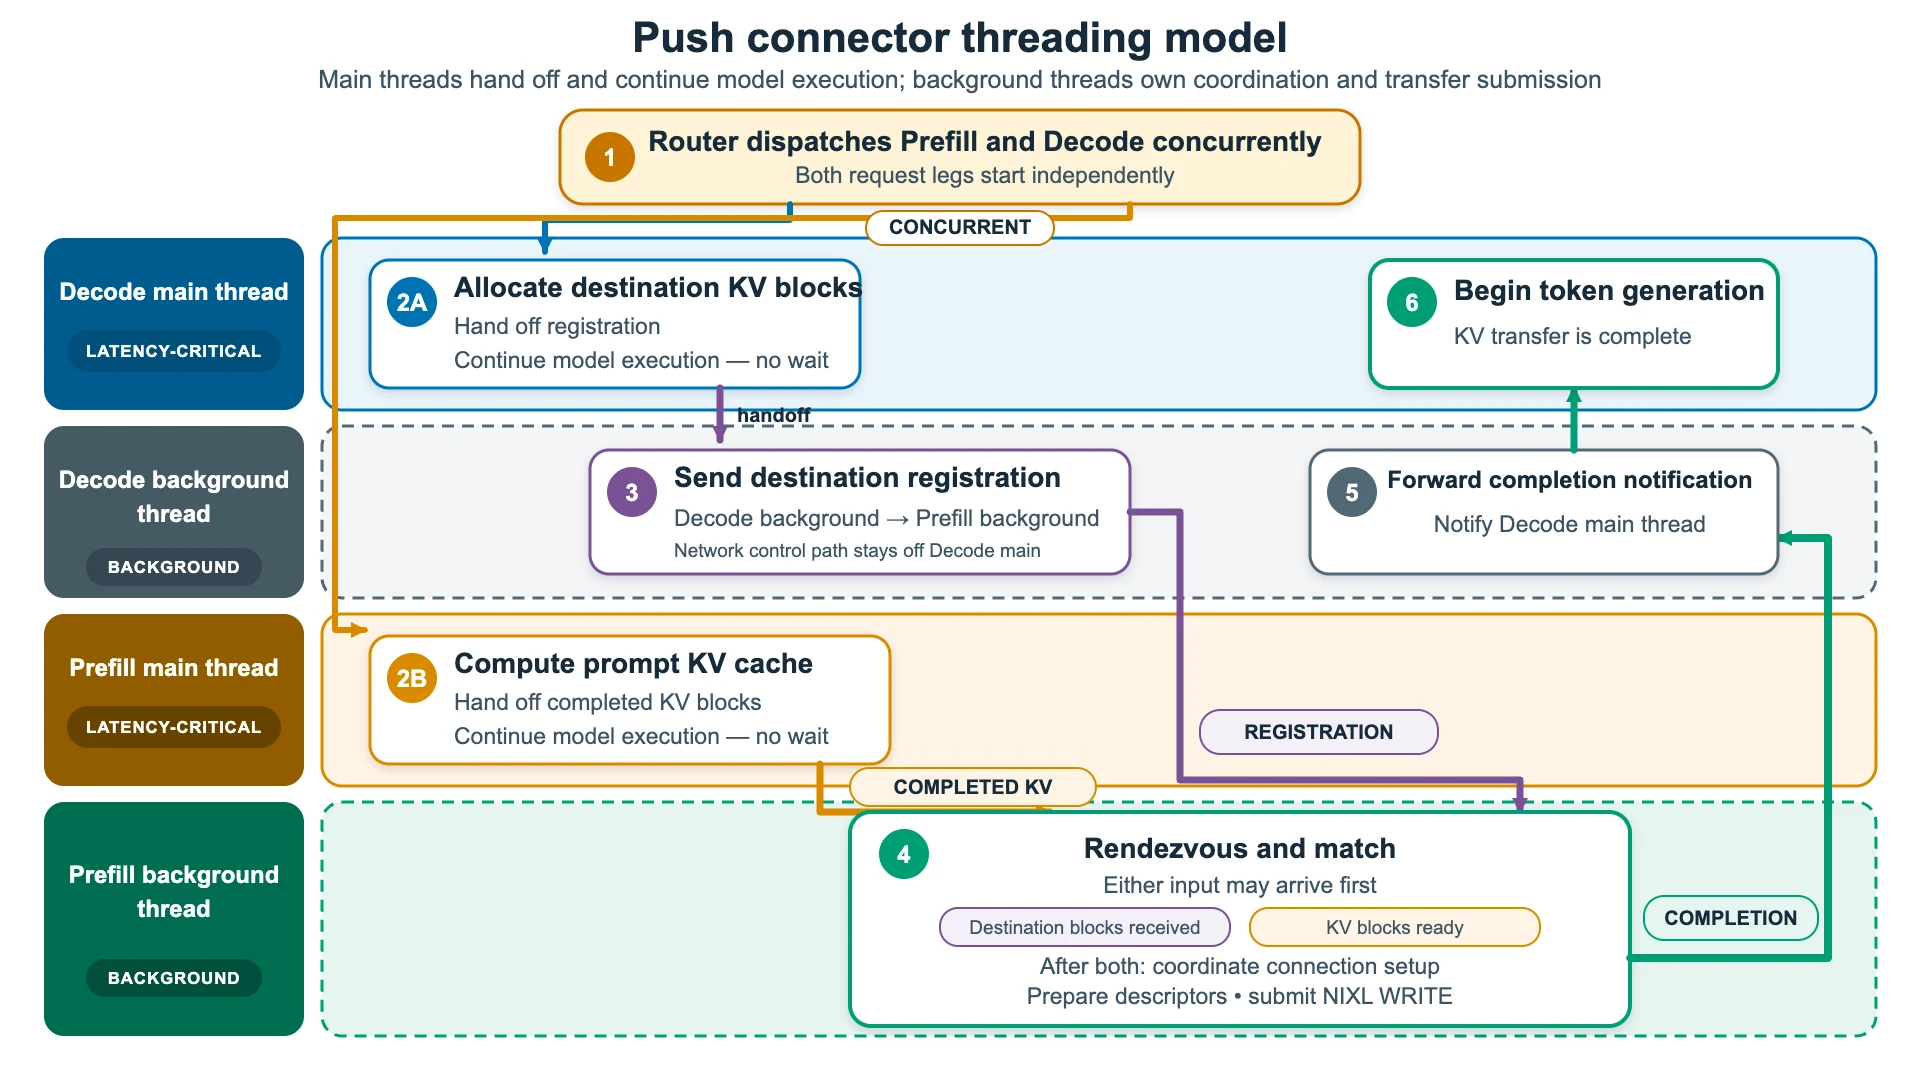
El conector push separa la ejecución del modelo de la preparación de la transferencia de KV mediante un hilo de transferencia dedicado en segundo plano en cada worker de prefill. Al inicio de una solicitud, el bucle principal de decode asigna sus bloques KV de destino y los registra con la instancia de prefill, mientras que el bucle principal de prefill calcula la caché KV del prompt. Después de que tanto el registro de destino como el KV del prompt estén listos, el bucle principal de prefill entrega los bloques KV al hilo en segundo plano y regresa rápidamente a la ejecución del modelo.
El hilo en segundo plano establece o reutiliza la conexión NIXL, mapea los IDs de bloques KV de la solicitud a descriptores de memoria, fusiona bloques contiguos en regiones de transferencia más grandes y envía el NIXL WRITE a la instancia de decode. Cuando NIXL completa la transferencia, envía una notificación de finalización a la instancia de decode, que entonces comienza la generación de tokens. Mantener la preparación de descriptores y el envío de la transferencia fuera de los bucles principales críticos para la latencia evita que este trabajo por solicitud retrase la ejecución del modelo. El siguiente diagrama muestra estos traspasos entre el bucle principal y el hilo en segundo plano para una única solicitud.
Comparación de tiempos: Pull vs push
El siguiente diagrama resume los flujos de transferencia pull y push descritos en las secciones anteriores y destaca su efecto en el TTFT. Aunque ambos modos usan la misma ruta de datos NIXL y EFA/RDMA, pull realiza la retransmisión de metadatos y la configuración del lado del decode después del prefill, mientras que push superpone la configuración del lado del decode con el prefill. Como resultado, push elimina estas operaciones de la ruta crítica posterior al prefill, permitiendo que la decodificación comience antes.
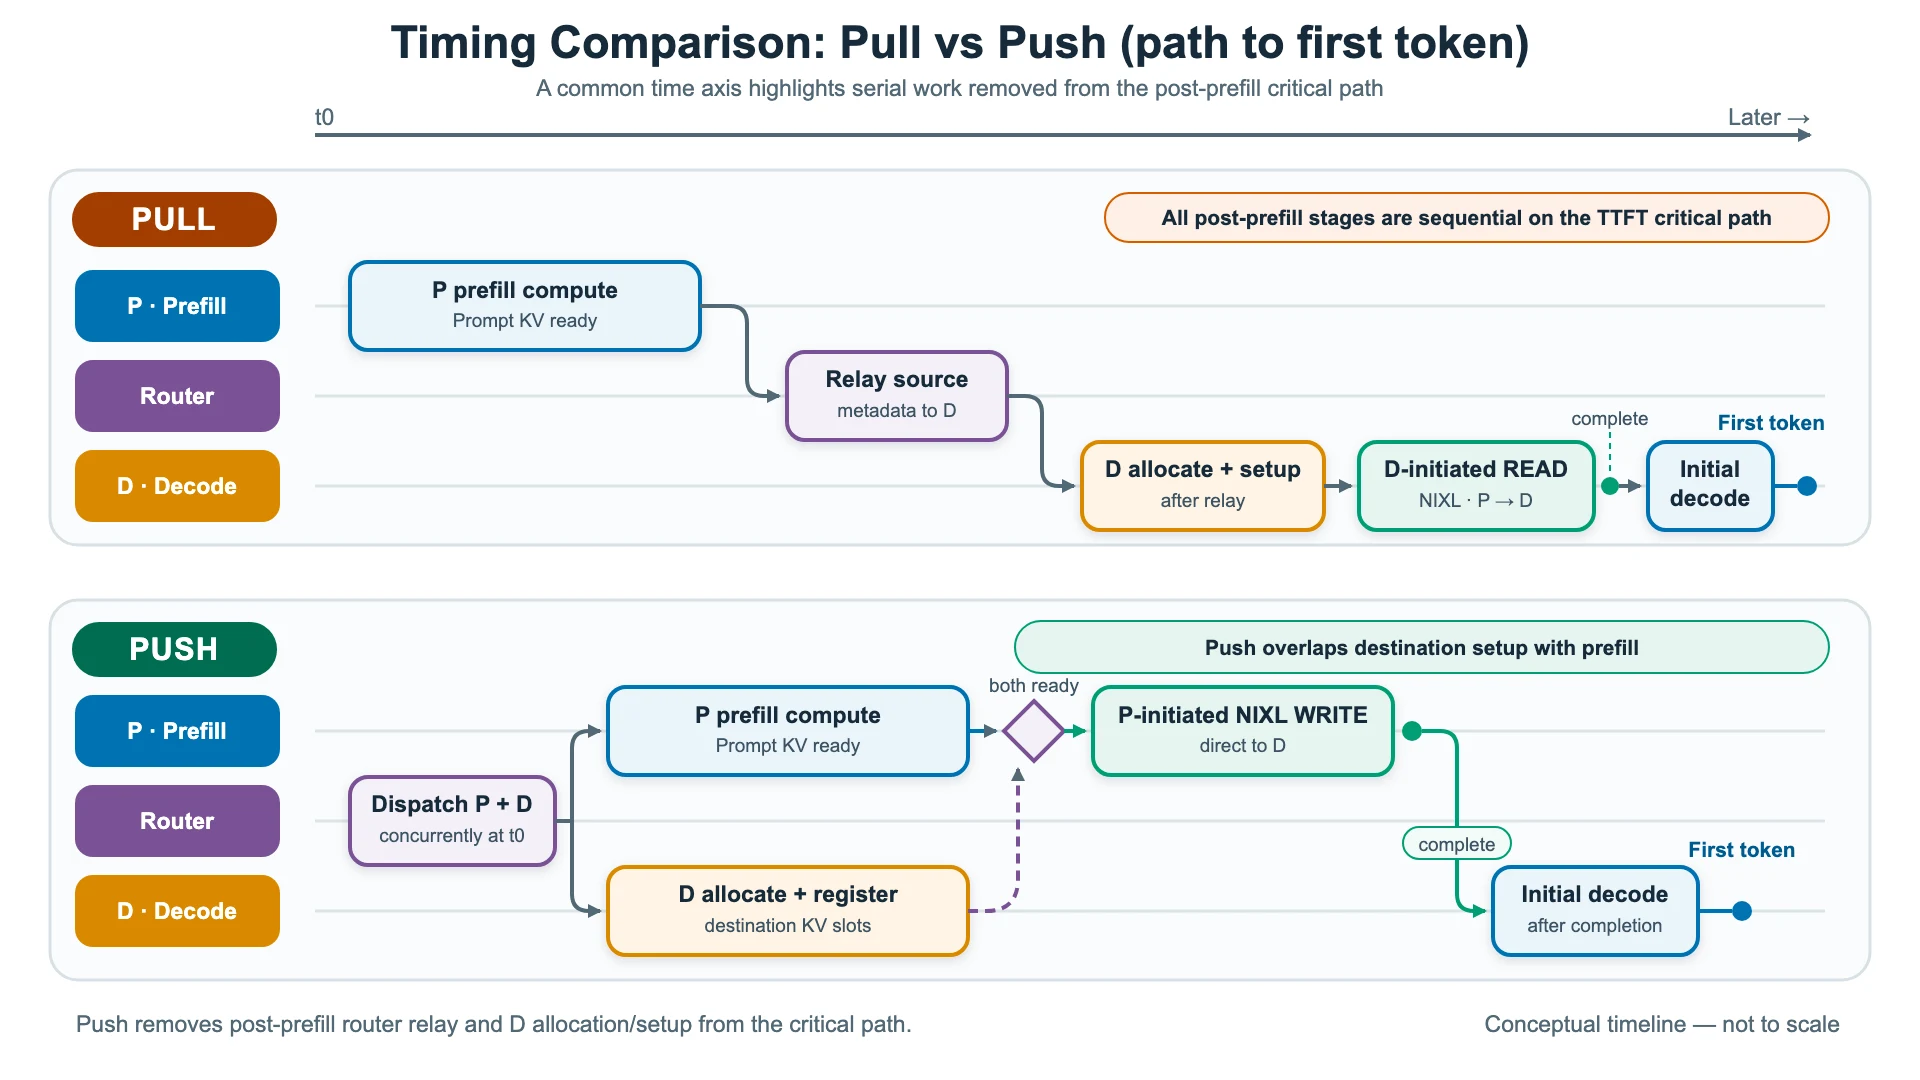
Los dos modos también implican una disyuntiva de enrutamiento. El modo pull permite al router seleccionar una instancia de decode después de que el prefill se complete, lo que ofrece mayor flexibilidad para el enrutamiento consciente de la carga y la gestión de la calidad de servicio. El modo push selecciona la instancia de decode antes, de modo que la configuración del destino pueda superponerse con el prefill. A cambio, bajo una carga comparable, la instancia de prefill puede liberar sus bloques KV antes porque la transferencia comienza tan pronto como el KV del prompt y el registro del destino están listos.
Datos de rendimiento
Para la evaluación, usamos el modelo Qwen3-32B en un despliegue 1P1D usando instancias Amazon EC2 P5en conectadas con EFA. Para aislar el rendimiento de la transferencia P→D, configuramos el benchmark para deshabilitar el prefix caching con --no-enable-prefix-caching. Esta configuración hace que el nodo de decode recupere la caché KV completa del nodo de prefill para cada solicitud. De lo contrario, los prompts superpuestos podrían reutilizar la caché local del nodo de decode y eludir la transferencia, lo que produciría resultados de comparación engañosos.
El siguiente gráfico compara el TTFT para la transferencia KV push y pull. Barremos longitudes de entrada de 1k–16k y tasas de solicitudes de 1–8 QPS. Con baja carga y prompts cortos, los dos modos se comportan de manera casi idéntica. A medida que crecen el QPS y la longitud de la entrada, el modo pull se degrada bruscamente, alcanzando aproximadamente 1,744 ms a 8 QPS y 16k. El modo push se mantiene mucho más bajo, en unos 540 ms, alrededor de una reducción de 3x. La brecha se abre porque el modo pull publica los descriptores NIXL en línea en el worker de decode, de forma síncrona dentro de su bucle del motor, de modo que ese trabajo detiene la generación de tokens. El modo push lo mueve a un hilo en segundo plano, fuera de la ruta crítica.
Este gráfico muestra el TPOT bajo las mismas condiciones. El patrón refleja el TTFT. Con carga ligera, push y pull están cerca, alrededor de 5.6–5.8 ms. A medida que aumentan la carga y la longitud de la entrada, pull sube a unos 10.4 ms a 4–8 QPS y 16k, mientras que push se mantiene cerca de 7 ms. La razón es que push descarga del worker de decodificación la preparación de descriptores y el envío de transferencias. La generación de tokens nunca se ve privada de recursos, por lo que la latencia por token se mantiene plana incluso con alta concurrencia y contextos largos.
Cómo ejecutar el benchmark
Para reproducir nuestra configuración de benchmark 1P1D, un nodo de prefill y un nodo de decode, usando instancias Amazon EC2 P5en conectadas con EFA, consulte las instrucciones detalladas en la guía Reproducing our results . La guía cubre la configuración del entorno, el lanzamiento de los servidores vLLM de prefill y decode, la ejecución del benchmark y la recolección de resultados. La funcionalidad puede ejecutarse en otras configuraciones soportadas, pero los resultados de rendimiento variarán según el hardware, el modelo, la carga de trabajo y la configuración de red.
Conclusión
En esta publicación, mostramos cómo el conector KV basado en push superpone el cálculo de prefill con la asignación y el registro de bloques del lado del decode, eliminando del camino crítico el viaje de ida y vuelta del router posterior al prefill y la configuración de transferencia del lado del decode. Esto reduce el TTFT y el TPOT, particularmente a altas tasas de solicitudes. En nuestro benchmark de Qwen3-32B en un despliegue 1P1D usando instancias Amazon EC2 P5en conectadas con EFA, el modo push proporcionó hasta una mejora de 3x en TTFT y una mejora del 30% en TPOT en comparación con el modo pull. Los resultados varían según la carga de trabajo y la configuración. Para usar el modo push, configure tanto los servidores de prefill como los de decode para usar NixlPushConnector en lugar de NixlConnector.
Elija el conector basado en push cuando la selección temprana del nodo de decode sea aceptable y una menor latencia TTFT sea la prioridad. El conector basado en pull sigue siendo la mejor opción para cargas de trabajo que requieren transferencia KV bidireccional o que difieren la selección de la instancia de decode hasta después del prefill para un enrutamiento consciente de la carga. vLLM admite conectores KV tanto basados en push como en pull, lo que permite a los usuarios seleccionar el enfoque que mejor se adapte a su despliegue.
Como mejora futura, estamos explorando llevar el modelo de subprocesos en segundo plano de NIXL al conector en modo pull, moviendo la configuración de NIXL fuera del camino crítico para que las cargas de trabajo en modo pull puedan beneficiarse de las mismas optimizaciones; hemos abierto un pull request (#45211) para explorar esto.
Recursos relacionados
Agradecimientos
Agradecemos a la comunidad de vLLM su apoyo en el mantenimiento de esta funcionalidad.
Apéndice: Reproducción de nuestros resultados
La topología es de dos nodos GPU p5en (prefill en :8100, decode en :8200) con EFA habilitada, más un tercer nodo más pequeño que ejecuta el proxy y el cliente del benchmark. Tres scripts se incluyen con esta publicación: serve_pd.sh lanza cualquiera de las dos partes en cualquiera de los modos, run_sweep.sh conduce el barrido, y cleanup.sh elimina todo. plot_push_vs_pull.py redibuja las dos figuras anteriores a partir de los JSON de resultados.
Entorno de prueba
Ambos nodos GPU se configuraron de manera idéntica:
| Tipo de instancia | p5en.48xlarge (8x NVIDIA H200), uno para prefill y otro para decode |
| Región / AZ | ap-south-1 (Mumbai), ap-south-1b (ID de AZ aps1-az3), ambos nodos en la misma AZ |
| Colocación | Sin grupo de colocación de clúster; ambas instancias lanzadas en una On-Demand Capacity Reservation específica, tenencia predeterminada |
| AMI | Imagen pública de AWS ParallelCluster 3.14.2 para Ubuntu 24.04 x86_64, aws-parallelcluster-3.14.2-ubuntu-2404-lts-hvm-x86_64-202602121713 (ami-0133f195033a4baae en ap-south-1; los IDs de AMI difieren según la región). Incluye el kernel 6.14.0-1018-aws, el controlador NVIDIA 570 y CUDA 12.8, por lo que hay que actualizar el controlador, el CUDA toolkit y el instalador de EFA a las versiones indicadas abajo. |
| SO / kernel | Ubuntu 24.04.4 LTS, 6.14.0-1018-aws |
| Controlador NVIDIA / CUDA | Controlador 580.126.16 (API de controlador CUDA 13.0); CUDA toolkit 13.0 |
| Interfaces EFA | 16 por instancia, una por tarjeta de red (tarjetas 0-15, todas de tipo de interfaz efa), 200 Gb/s cada una para un total de 3.2 Tb/s. 8 interfaces se sitúan en cada nodo NUMA, y cada GPU comparte un conmutador PCIe con 2 de ellas. |
| Software EFA | Instalador de EFA 1.50.0, módulo de kernel de EFA 3.3.0g, libfabric 2.6.0amzn1.0, rdma-core 64.0amzn0 |
Selección de dispositivos EFA por parte de NIXL. El backend LIBFABRIC abre los 16 dispositivos EFA como rails con el efa provider. Luego registra la caché KV de cada GPU únicamente en los 2 rails que comparten el conmutador PCIe de esa GPU, de modo que cada transferencia se mantiene local en PCIe. No se establecieron anulaciones de dispositivo de NIXL ni de libfabric; esta es la selección predeterminada. Para confirmarlo en sus propios nodos, lance los servidores con NIXL_LOG_LEVEL=DEBUG y verifique las líneas de registro:
grep -E "Created rail [0-9]+ \(device=|mapped to rail" server.log1. Aprovisionar los nodos
Instale la pila de espacio de usuario de EFA en ambos nodos de GPU y confirme que el provider está presente. Usamos el instalador 1.50.0:
curl -O https://efa-installer.amazonaws.com/aws-efa-installer-1.50.0.tar.gz
tar -xf aws-efa-installer-1.50.0.tar.gz && cd aws-efa-installer
sudo ./efa_installer.sh -y
fi_info --version         # libfabric 2.6.0amzn1.0
fi_info -p efa            # verify the EFA provider is present
Los dos nodos de GPU deben comunicarse entre sí en 8100/8200 y en el canal lateral de NIXL (5600).
2. Instalar vLLM y NIXL
En ambos nodos de GPU:
python3.12 -m venv ~/vllm_env && source ~/vllm_env/bin/activate
pip install --upgrade pip
pip install vllm==0.29.0      # any build that includes the NIXL push connector
pip install nixl==1.4.1       # NIXL with the libfabric/EFA backend
En el nodo proxy (no se necesita entorno de ejecución de GPU):
pip install vllm aiohttp fastapi uvicorn pandas datasets3. Descargar el modelo
export HF_HOME=/shared/huggingface     # a large shared volume
hf download Qwen/Qwen3-32B
4. Lanzar el par P/D
Ejecute serve_pd.sh una vez por cada nodo de GPU. La única diferencia entre los dos modos es kv_connector: NixlConnector para pull, NixlPushConnector para push. Los puertos, los engine IDs, los roles y los ranks se mantienen iguales.
# on the prefill node
PREFILL_IP=<PREFILL_IP> DECODE_IP=<DECODE_IP> ROLE=prefill MODE=pull ./serve_pd.sh
# on the decode node
PREFILL_IP=<PREFILL_IP> DECODE_IP=<DECODE_IP> ROLE=decode  MODE=pull ./serve_pd.sh
Que se expande a, en el lado de prefill:
vllm serve Qwen/Qwen3-32B --served-model-name Qwen --dtype bfloat16 \
  --tensor-parallel-size 8 --max-model-len 32768 --max-num-seqs 8 --port 8100 \
  --kv-transfer-config '{"kv_connector":"NixlConnector","kv_buffer_device":"cuda",
    "kv_role":"kv_producer","engine_id":"prefill-engine-001","kv_rank":0,
    "kv_parallel_size":2,"kv_connector_extra_config":{"backends":["LIBFABRIC"]}}'
El servidor de decode añade --no-enable-prefix-caching, lo que obliga a cada solicitud a obtener el KV completo del prefill — exactamente lo que estamos midiendo. Con el caching activado, los prompts superpuestos podrían alcanzar la caché local del nodo de decode y saltarse la transferencia P->D, dando números engañosos. Espere a que ambos endpoints /health devuelvan 200 antes de ejecutar el benchmark.
5. Ejecutar el barrido
El script del benchmark se encuentra en #57567; elige el proxy que coincide con el modo (disagg_proxy_demo.py para pull, disagg_proxy_pushconnector_demo.py para push) y lo controla con vllm bench serve.
git clone https://github.com/vllm-project/vllm.git ~/vllm && cd ~/vllm
git fetch origin pull/57567/head:pd-bench && git checkout pd-bench
export VLLM_SRC=~/vllm

VLLM_SRC=~/vllm PREFILL_IP=<PREFILL_IP> DECODE_IP=<DECODE_IP> \
  MODE=pull ./run_sweep.sh
Luego detenga ambos servidores, vuelva a lanzar el paso 4 con MODE=push en cada nodo, y volver a ejecutar el barrido con MODE=push. El modo push además necesita las coordenadas NIXL de la instancia de prefill (PREFILL_ENGINE_ID, PREFILL_KV_HOST, PREFILL_SIDE_CHANNEL_PORT, PREFILL_TP_SIZE, PREFILL_PP_SIZE) para que el proxy pueda indicar al nodo de decodificación dónde registrarse; run_sweep.sh los completa a partir de los valores predeterminados usados arriba. Mantenga QPS_LIST, INPUT_LENS, y OUTPUT_LENS idénticos entre las dos ejecuciones, y asegúrese de que PREFILL_TP_SIZE coincida con el tamaño tensor-parallel real del servidor de prefill.
results/ contiene <mode>_qps<q>_in<in>_out<out>_iter<i>.json (más .log) con TTFT, ITL, rendimiento y latencia de extremo a extremo por ejecución. Para volver a generar las figuras:
python plot_push_vs_pull.py --results-dir ./results --metric ttft
python plot_push_vs_pull.py --results-dir ./results --metric tpot
Solución de problemas
- El servidor se bloquea justo después de la primera solicitud — el modo no coincide con el conector. Pull necesita
NixlConnector; push necesitaNixlPushConnector, tanto en P como en D. Backend 404: model ... does not exist—SERVED_MODEL_NAMEno coincide con el de los servidores'--served-model-name(Qwen).- El readiness del proxy expira — confirme que el proxy para el modo elegido existe bajo
$VLLM_SRC/examples/disaggregated/disaggregated_serving/, y que tanto P como D/healthdevuelven 200. - Errores de handshake o transferencia de NIXL — verifique EFA (
fi_info -p efa), que el puerto del side-channel (5600) esté abierto entre P y D, y quePREFILL_TP_SIZEcoincida con el tamaño tensor-parallel del servidor de prefill.
Limpieza
./cleanup.sh proxy      # on the proxy / benchmark driver node
./cleanup.sh server     # on each GPU node
Luego siga la guía de usuario de AWS EC2 para finalizar las instancias.