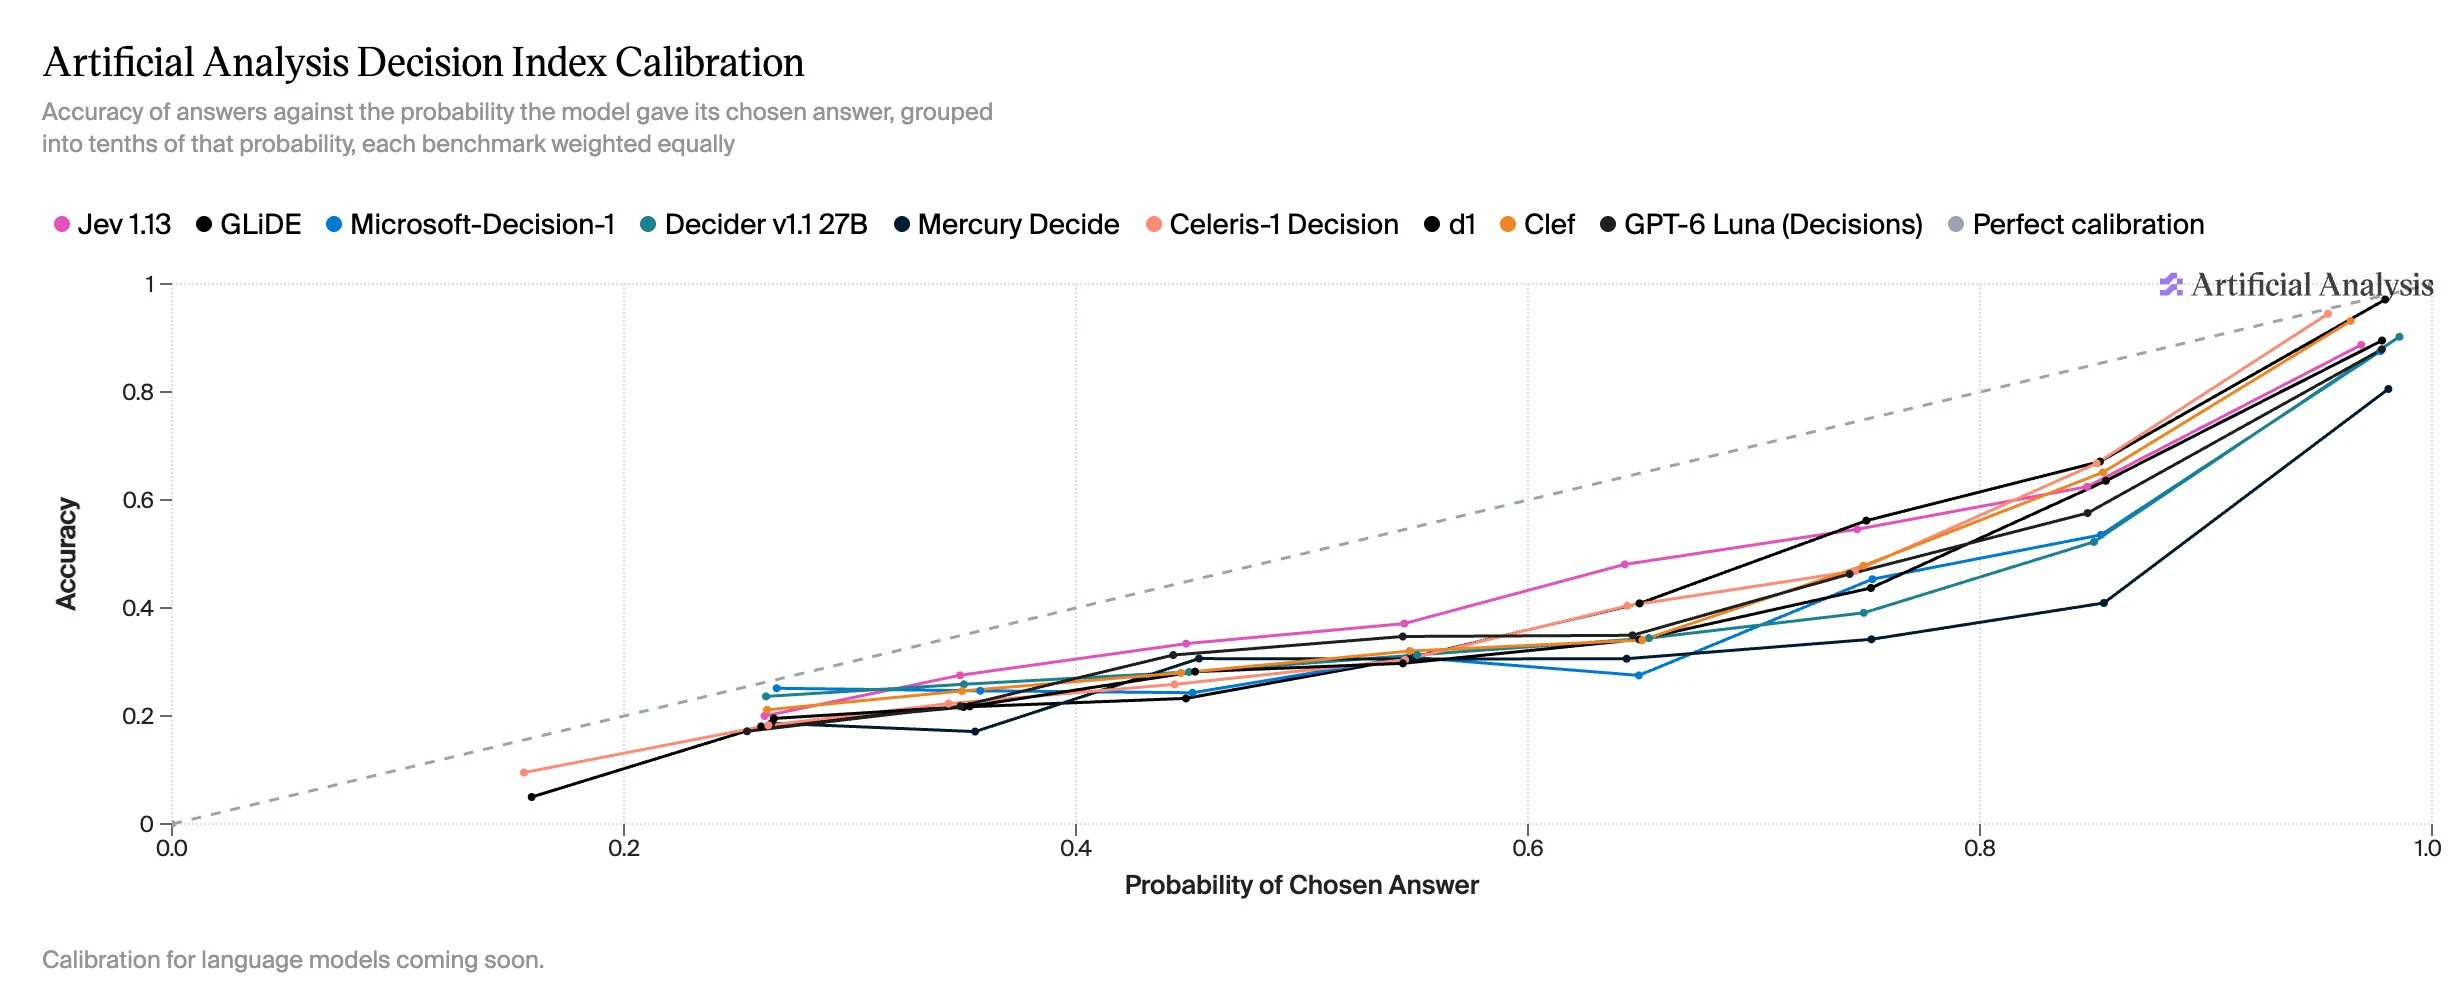
Los modelos de decisión están mal calibrados en tareas de conocimiento y razonamiento. En casi todos los niveles de probabilidad para las respuestas elegidas, la precisión queda por debajo de esa probabilidad para todos los modelos de decisión. Esta brecha es mayor en AA-Omniscience-Decision y HLE-MultiChoice, mientras que la mayoría de los modelos están relativamente bien calibrados en WildGuardTest (clasificación) y When2Call (llamada a herramientas)