
Conclusiones clave
- El "context rot" ocurre cuando los agentes de larga duración acumulan más contexto del que el modelo puede contener, lo que provoca caídas de precisión.
- Deep Agents, el harness de agentes de código abierto de LangChain, utiliza cinco técnicas para mover el contexto fuera de la ventana activa (sin eliminarlo) para prevenir el context rot.
- La memoria de un agente en Deep Agents se almacena como archivos planos en un almacenamiento que tú controlas, de modo que puedes cambiar de modelo o proveedor conservando todo lo que ha aprendido.
Si alguna vez has estudiando a destajo la noche antes de un examen, conoces la sensación: cuanto más estudias, más empiezan a olvidarse los primeros capítulos.
Los agentes tienen el mismo problema. A medida que asumen tareas más largas, asumen cada vez más información (instrucciones, resultados de herramientas, archivos, etc.); con el tiempo, esto se convierte en demasiado contexto para caber cómodamente en la ventana de contextode un modelo. Cuanta más historia, ruido y salida de herramientas lleva un modelo, peor tienden a ser su precisión y su razonamiento.
En el mundo de la ingeniería de agentes, a esto lo llamamos context rot. Este blog cubre técnicas para gestionar la ventana de contexto de tu agente y cómo el harness de Deep Agents utiliza un concepto llamado middleware para inyectarlas en la ejecución de tu agente.
Entendiendo las técnicas de ingeniería de contexto
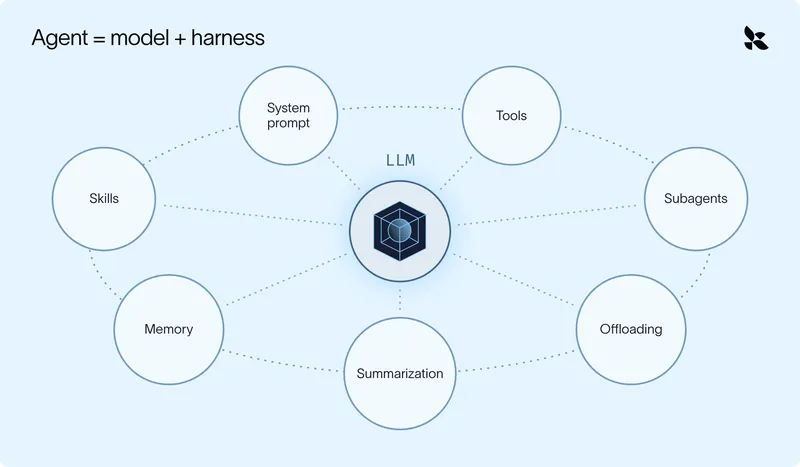
Para simplificar, un agente es solo un modelo con un harness a su alrededor.
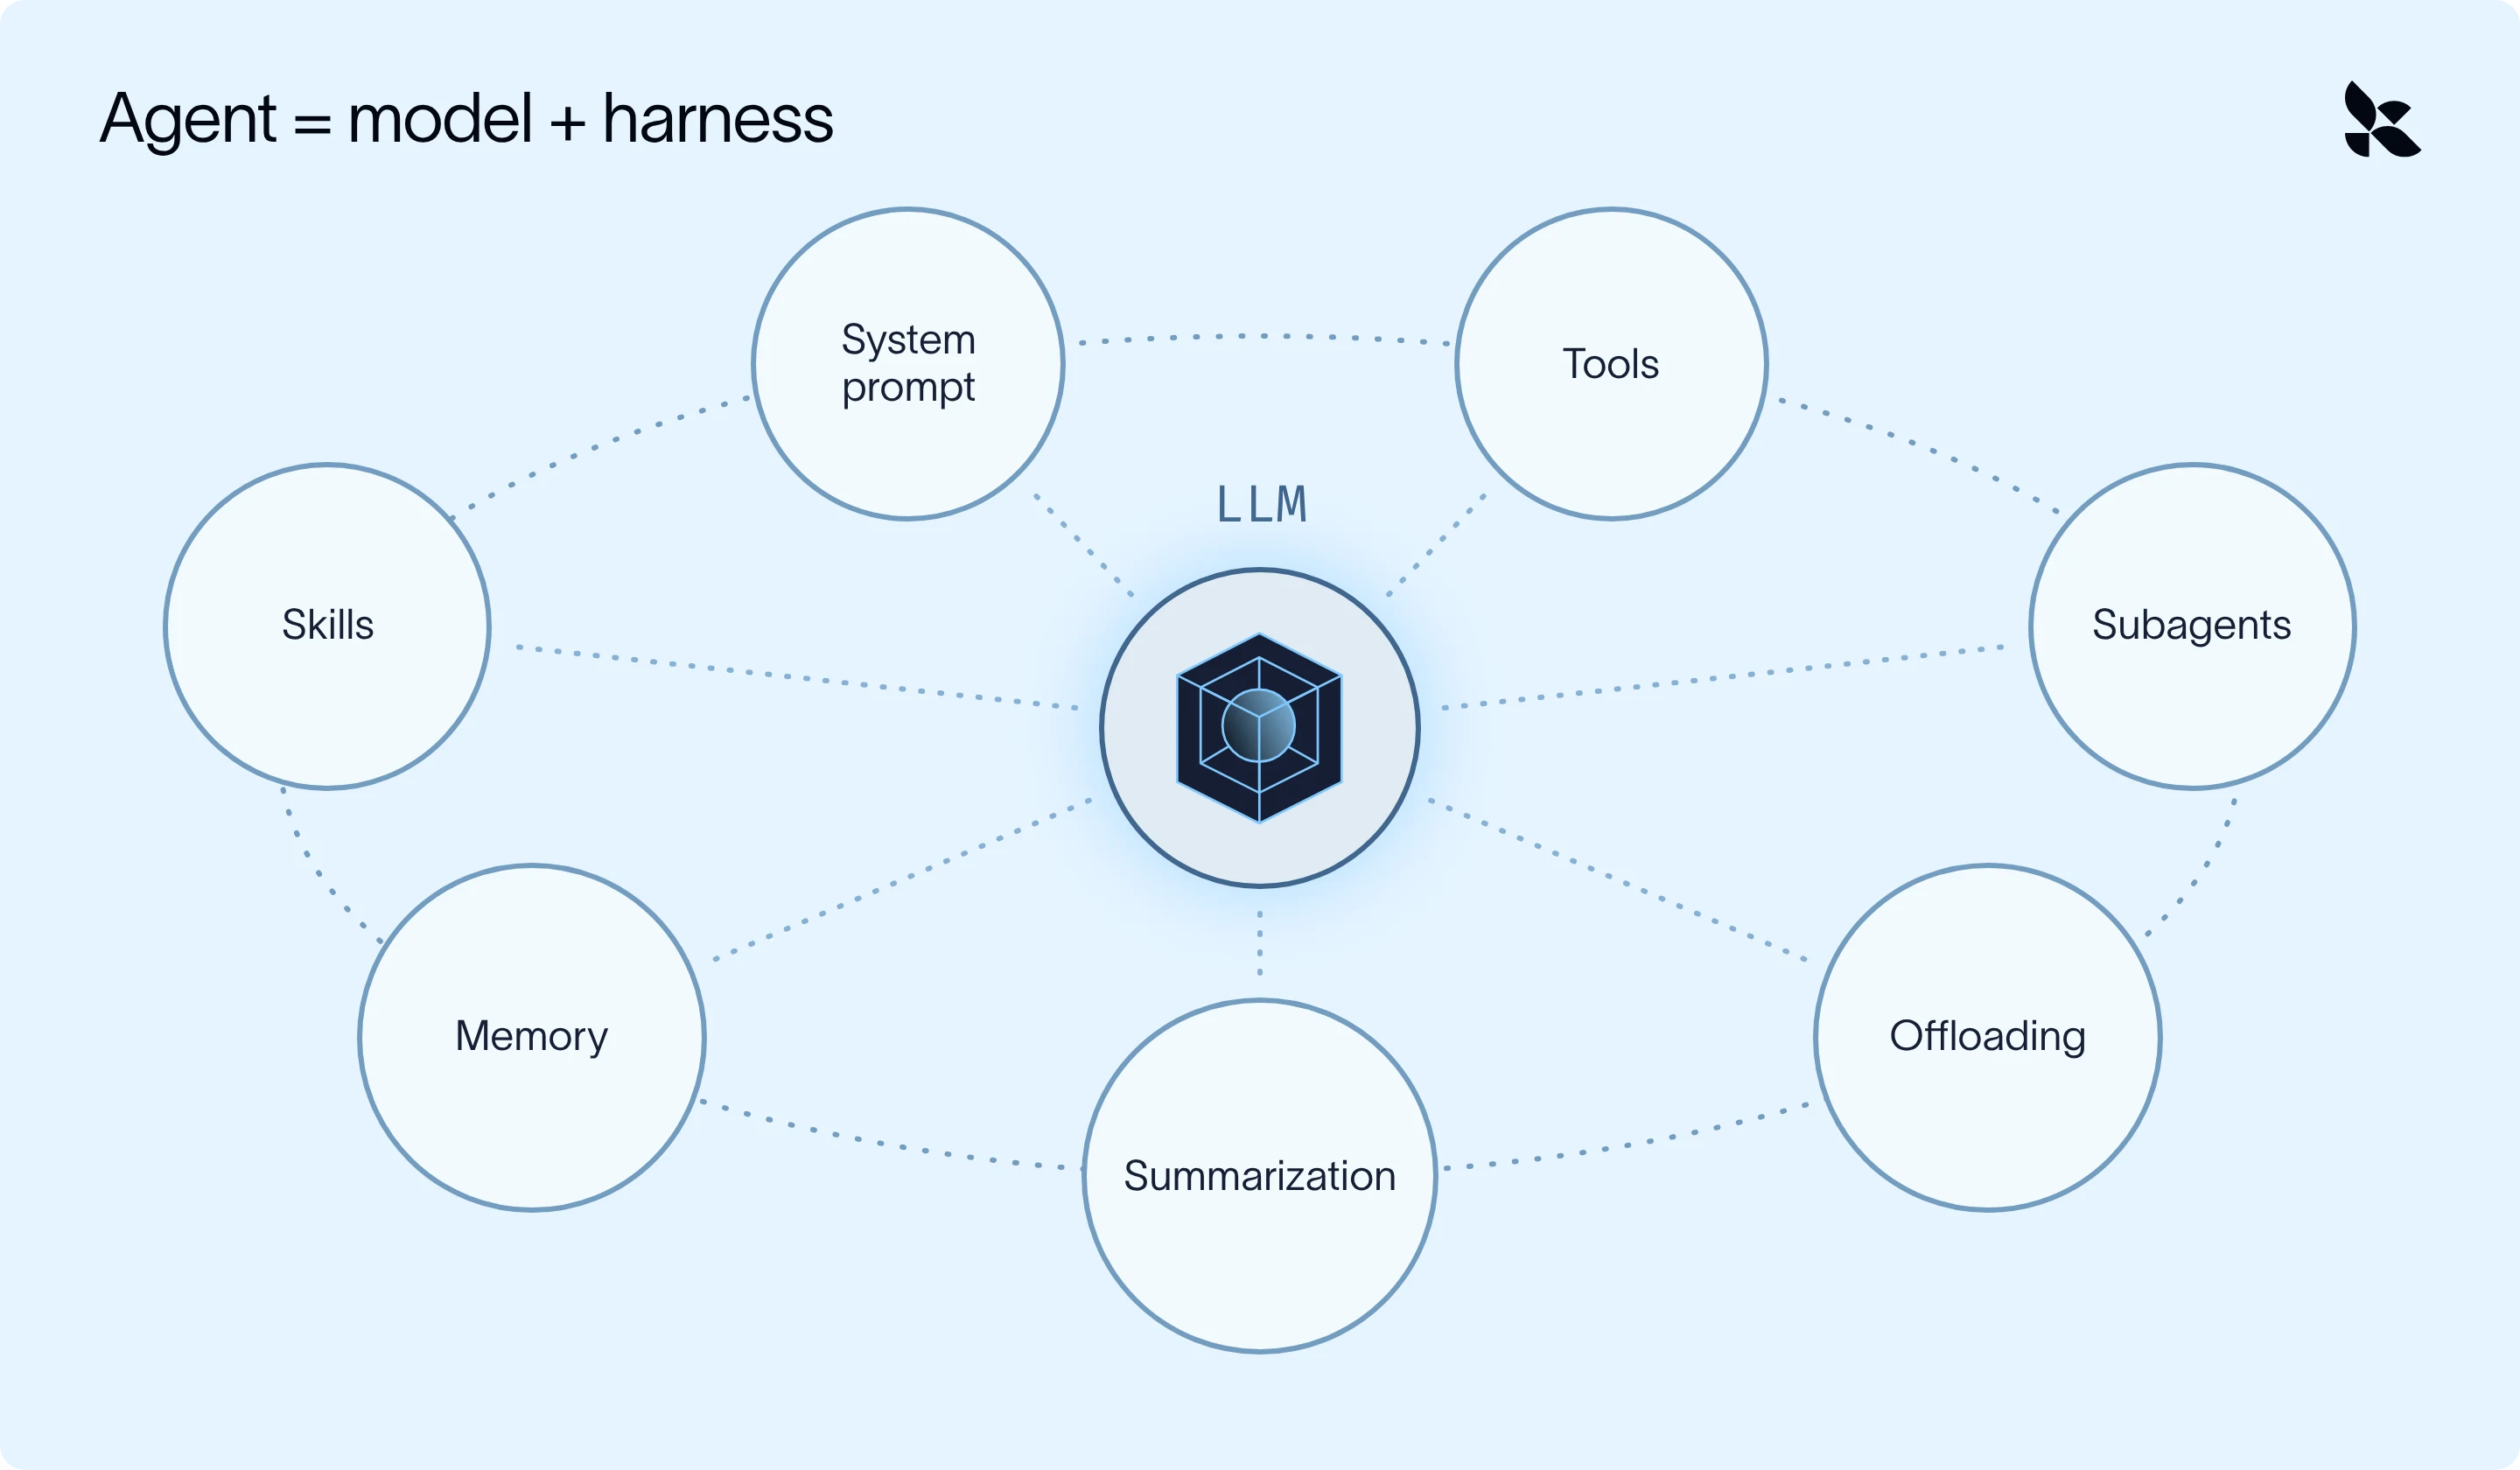
Las técnicas de ingeniería de contexto de las que dispone el agente para abordar el context rot caen principalmente en dos categorías:
- Prevenir que información innecesaria entre en la ventana de contexto
- Gestionar y filtrar lo que ya está en la ventana de contexto
El harness aplica estos métodos estratégicamente para darle al modelo el contexto correcto en el momento correcto para la tarea dada.
Ahora bien, montar un harness que haga esto bien es más fácil decirlo que hacerlo, y requiere mucho trabajo (quizás demasiado trabajo si eres del tipo de persona que estudia a última hora la noche anterior al examen).
Deep Agents es el harness de código abierto de LangChain. Envuelve el modelo que elijas con técnicas que mueven el contexto fuera de la ventana activa (hacia archivos, resúmenes o un agente separado), de modo que el agente principal solo lleva lo que necesita (y puede recuperar los datos sin procesar si los necesita más adelante):
- Offloading: los resultados grandes de herramientas y los mensajes del usuario se guardan en el sistema de archivos, y el modelo ve una vista previa.
- Summarization: cuando la conversación se acerca al límite de contexto, los mensajes más antiguos se condensan en un resumen.
- Skills: los conocimientos sobre tareas se cargan solo cuando el modelo decide que son relevantes.
- Subagents: el trabajo ruidoso se ejecuta en una ventana de contexto separada, y solo regresa el resultado.
- Long-term memory: lo que el agente aprende se guarda en un archivo que se traslada a la siguiente conversación.
Aplicar la ingeniería de contexto a casos de uso comunes
Veamos cómo se pueden aplicar las técnicas anteriores en un caso de uso del mundo real: un agente de análisis competitivo. Cada lunes, este agente investiga a cinco competidores y escribe un informe con la plantilla del equipo. Una ejecución individual se ve más o menos así:
- Extraer una exportación de datos de mercado de la Compañía A (decenas de miles de filas)
- Buscar noticias, leer algunos artículos y tomar notas
- Repetir para las Compañías B a E
- Redactar el informe, revisarlo según tus comentarios y darle formato
Para el paso 4, el agente ha llevado cinco exportaciones sin procesar, docenas de resultados de búsqueda y dos borradores obsoletos a través de cada llamada al modelo. La mayor parte es irrelevante para dar formato al informe final.
Los métodos de recuperación (RAG, o búsqueda en el sistema de archivos) ayudan al agente a incorporar solo lo que necesita, pero eso solo resuelve la mitad del problema. Incluso un agente preciso acumula mensajes innecesarios, resultados de herramientas y trabajo intermedio, por lo que el harness también tiene que gestionar lo que ya está dentro y alrededor de la ventana de contexto.
Cómo implementar estas técnicas: middleware
Un agente funciona en un bucle: el modelo decide qué hacer, llama a una herramienta, lee el resultado y repite hasta que la tarea está terminada. Middleware es código que se conecta en puntos específicos de ese bucle: por ejemplo, antes de que el agente comience, alrededor de cada llamada al modelo, o alrededor de cada llamada a una herramienta.
- En cada punto puede leer el contexto y modificarlo antes de que se ejecute el siguiente paso.
- Cada técnica de ingeniería de contexto en esta publicación es una pieza de middleware conectada a uno de esos puntos.
- La mayor parte de esto está integrado, por lo que no necesitas escribir ningún middleware para usar estas técnicas (a menos que quieras personalizar algo específico).
Descarga (offloading): mantener fuera de la ventana de contexto
Nuestro agente no siempre necesita ver todos los datos que se devuelven de cada llamada a una herramienta o mensaje humano, especialmente si se trata de un gran volumen.
Por ejemplo, cada llamada a la herramienta pull_market_report devuelve una exportación completa de datos (miles de filas); sin embargo, el agente solo necesita algunos números de ella, por lo que se puede restringir al modelo para que solo vea esas filas.
FilesystemMiddleware se ejecuta cada vez que se llama a una herramienta:
- Cuando el resultado de una herramienta supera aproximadamente 20,000 tokens, el resultado completo se escribe en /large_tool_results/{tool_call_id} antes de entrar en la conversación.
- El modelo solo ve una breve vista previa (las primeras y últimas líneas) además de la ruta del archivo.
- Cuando el agente luego necesita los ingresos trimestrales de la Compañía B, recorre el archivo con read_file.
Los mensajes de usuario/humanos demasiado grandes, como una transcripción de llamada pegada, reciben el mismo tratamiento con un umbral más alto (50,000 tokens) y se guardan en /conversation_history/.
Resumición: compactar lo que ya está ahí
Por más que intentemos descargar las llamadas verbosas a herramientas, el contexto comenzará a acumularse gradualmente durante una ejecución larga (por ejemplo, búsquedas, notas y borradores correspondientes a cinco empresas). La resumición se puede usar para condensar toda la ventana de contexto de nuestro agente en un resumen de lo que ha sucedido hasta ahora, permitiéndole continuar con sus tareas de investigación.
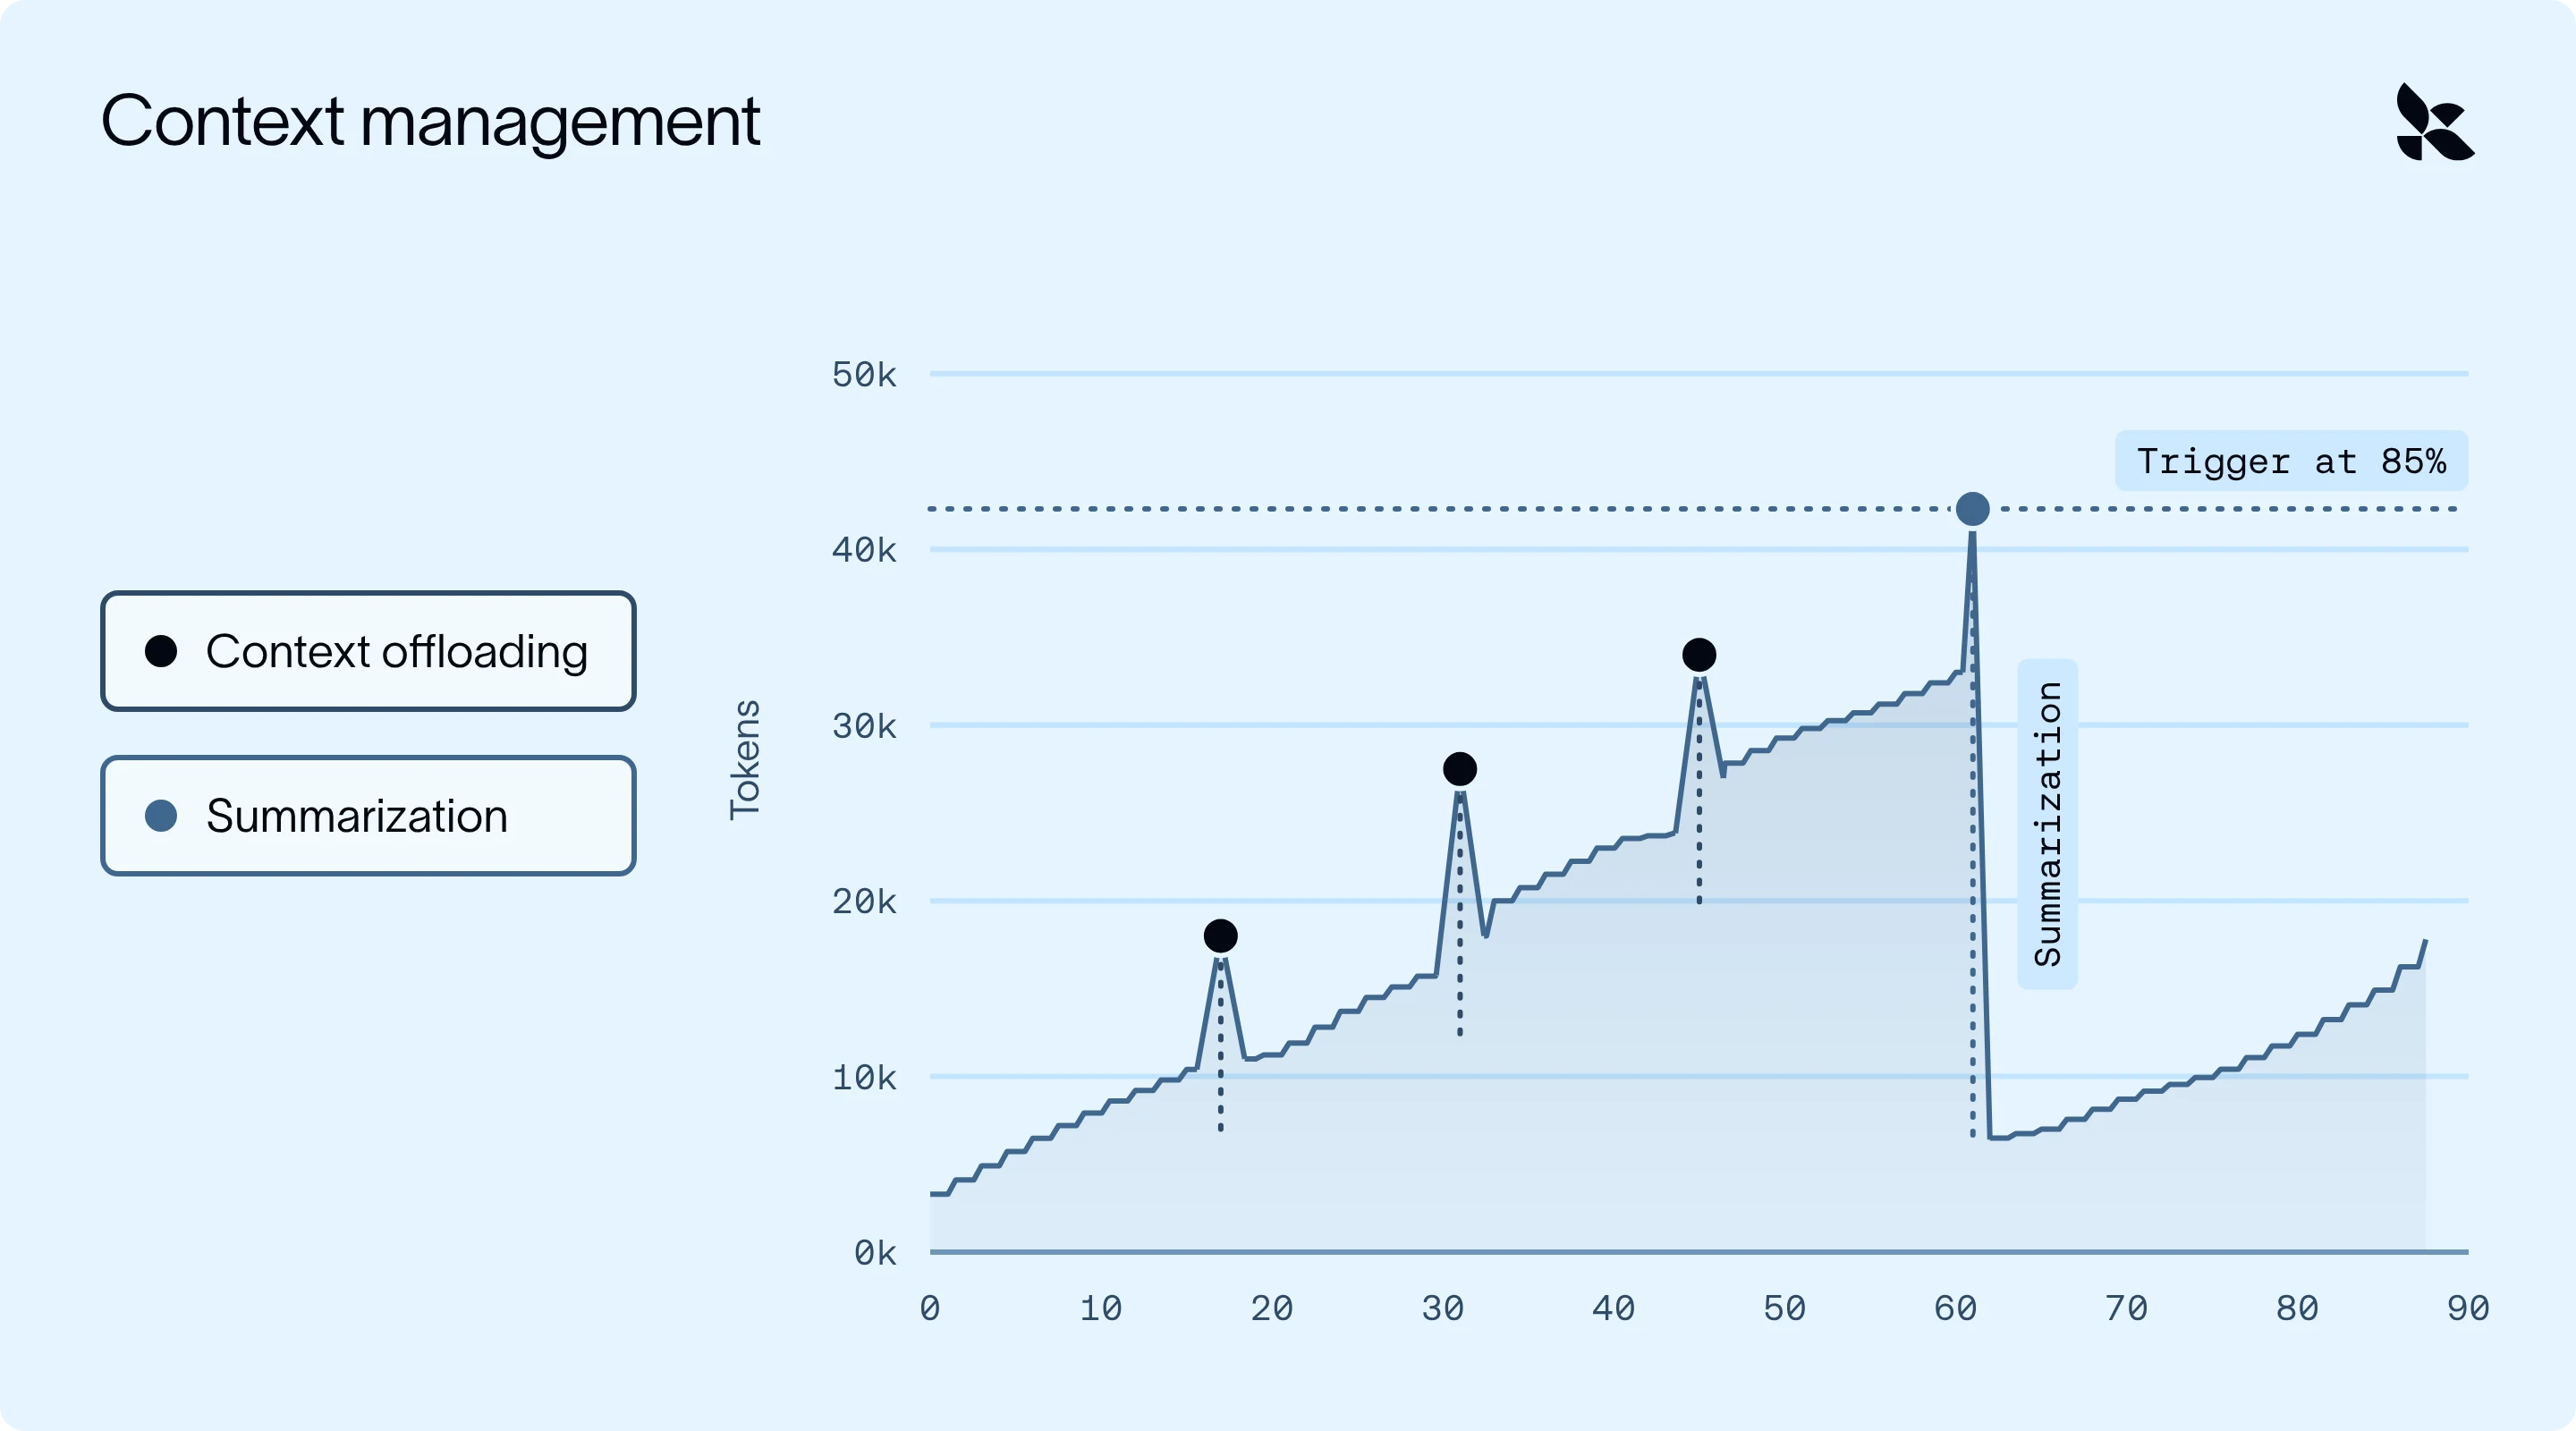
- Los picos son grandes resultados de herramientas/mensajes humanos que llegan; la descarga intercambia cada uno por una breve vista previa antes de que el modelo lo vea, por lo que el contexto solo crece un poco.
- La resumición maneja la subida lenta: una vez que el uso alcanza el 85%, los mensajes más antiguos se condensan en un resumen y el contexto vuelve a bajar.
SummarizationMiddleware verifica el uso de tokens justo antes de cada llamada al modelo:
- Una vez que el uso cruza un umbral (85% de la ventana de contexto del modelo por defecto), una llamada LLM separada condensa los mensajes más antiguos en un solo resumen
- Los mensajes más antiguos se eliminan de la ventana de contexto mientras que los mensajes más recientes se conservan textualmente.
- El modelo ahora ve primero el resumen, luego los mensajes recientes (para que nada reciente sea parafraseado).
Dos detalles importantes:
- Es recuperable. Los mensajes resumidos se escriben en /conversation_history/{session_id}.md. Si el agente necesita un detalle de la investigación de la Compañía A mientras redacta, puede volver a leerlo.
- Se cicla. A medida que la ejecución continúa, el uso vuelve a subir, y el siguiente resumen incluye el anterior.
También puedes resumir cuando cambia el tema, no solo en un cierto umbral de tokens. Puede ser útil personalizar el prompt de resumen.
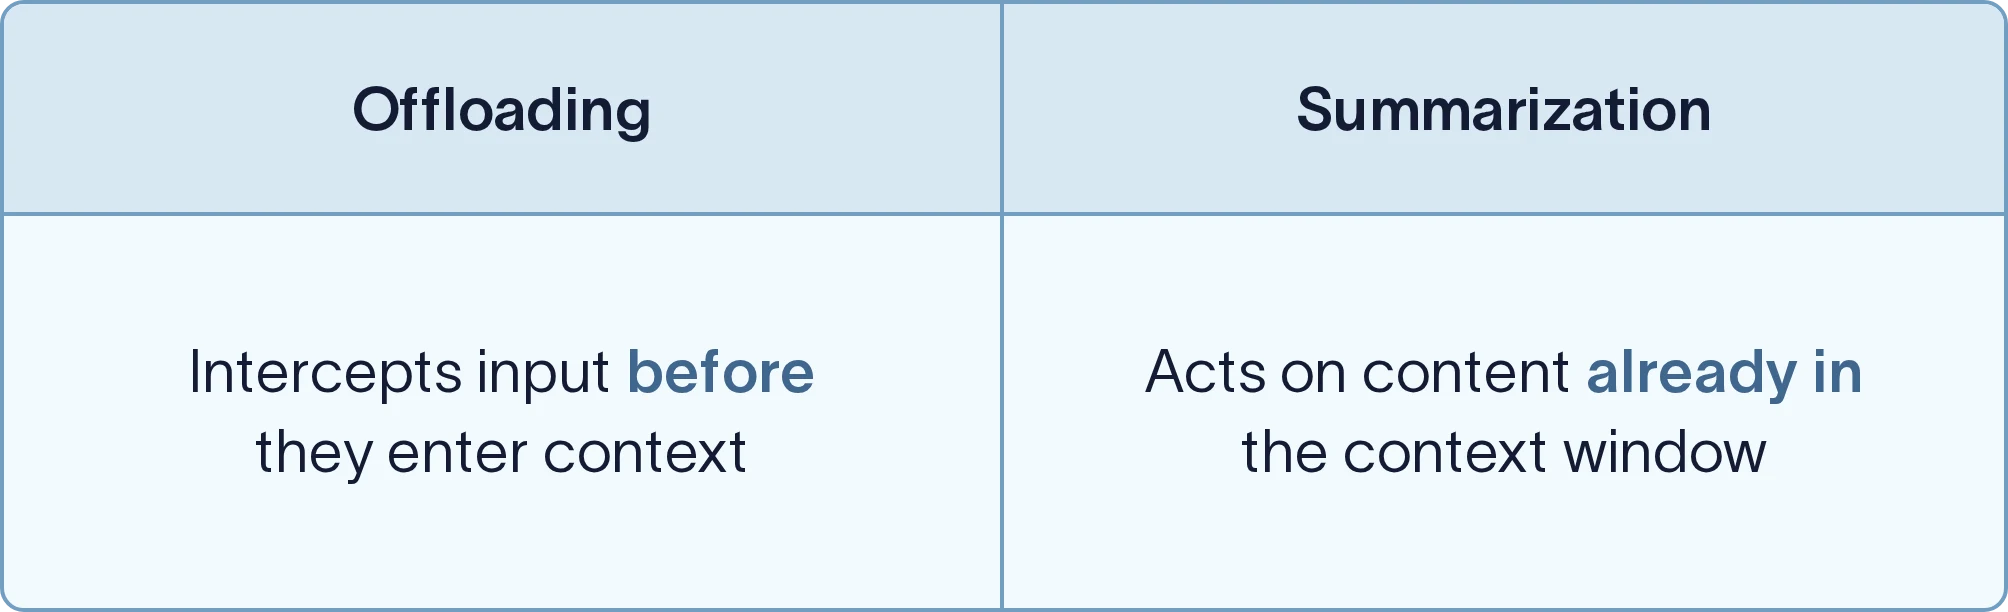
Nuestra publicación sobre gestión de contexto para Deep Agents cubre ambos temas con más detalle.
Skills: cargar información solo cuando se necesite
Supongamos que su equipo de ventas tiene un formato específico para las revisiones trimestrales de negocio. El agente solo necesita esas instrucciones una vez al trimestre, por lo que mantenerlas en el system prompt significa pagar por ellas (en tokens y tiempo de respuesta) en cada llamada. En cambio, puede empaquetar esta información como una skill.
Una skill es una carpeta de instrucciones (con scripts opcionales y documentos de referencia) que le dan a un agente lo que necesita para una tarea especializada.
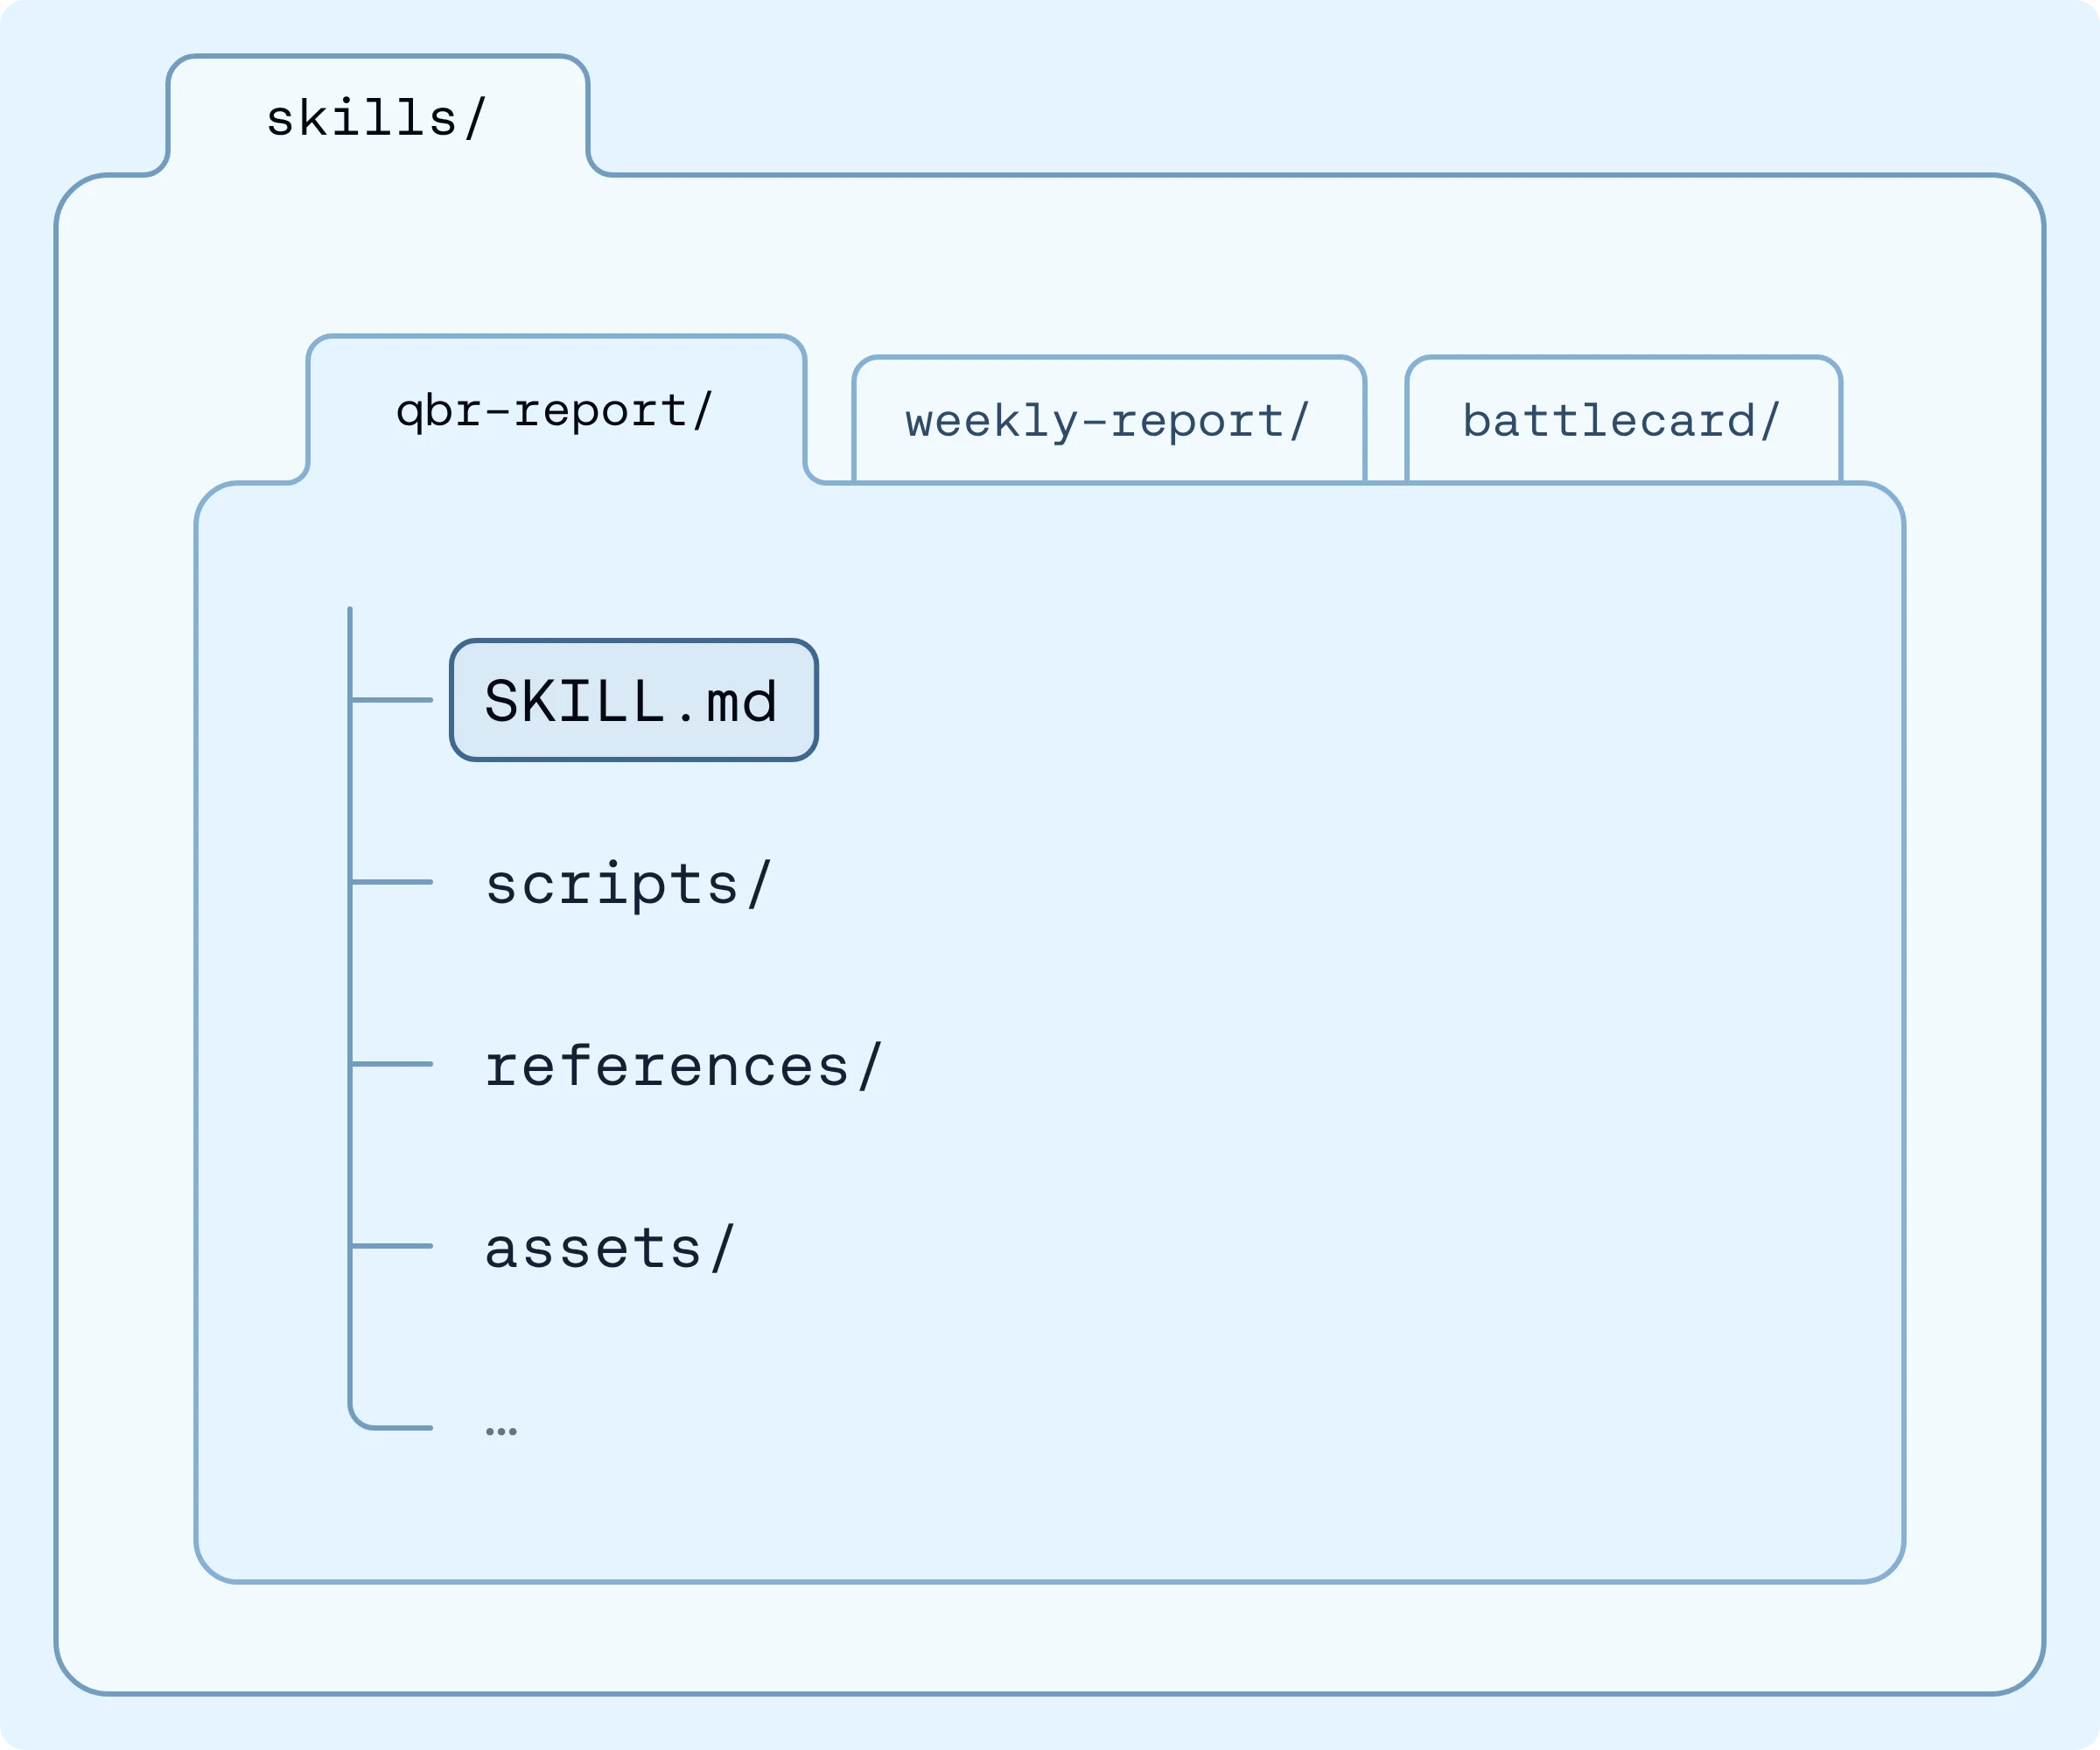
El agente ve una breve descripción al principio y carga las instrucciones completas de qbr-report solo cuando surge un QBR (las demás tareas nunca las llevan consigo).
Las skills cargan el contexto en capas, por lo que la ventana permanece pequeña hasta que algo es realmente relevante. Esto se llama divulgación progresiva: el modelo ve un "menú" al principio y extrae la receta completa cuando la necesita, así que diez skills cuestan aproximadamente el mismo contexto que diez frases de una línea.
Apuntas el agente a tus skills, y SkillsMiddleware usa dos hooks:
- Antes de que el agente comience, escanea la carpeta de skills y lee solo el encabezado de cada SKILL.md.
- En cada llamada al modelo, añade esos nombres y descripciones al system prompt.
Las instrucciones completas entran en el contexto solo cuando el modelo decide que una skill es relevante (y la lee con una herramienta read_file), de modo que nuestro agente investiga sin la plantilla y solo la carga cuando es momento de formatear un QBR.
Subagentes: aislar el trabajo ruidoso
La descarga (offloading) combate eficazmente los resultados demasiado grandes, pero los subagentes son una buena elección de diseño para trabajos que ya sabes que serán ruidosos (como investigar una empresa a través de docenas de búsquedas y páginas). El subagente hace ese trabajo en su propia ventana de contexto y devuelve solo el resultado final, de modo que el agente principal nunca ve el "ruido".
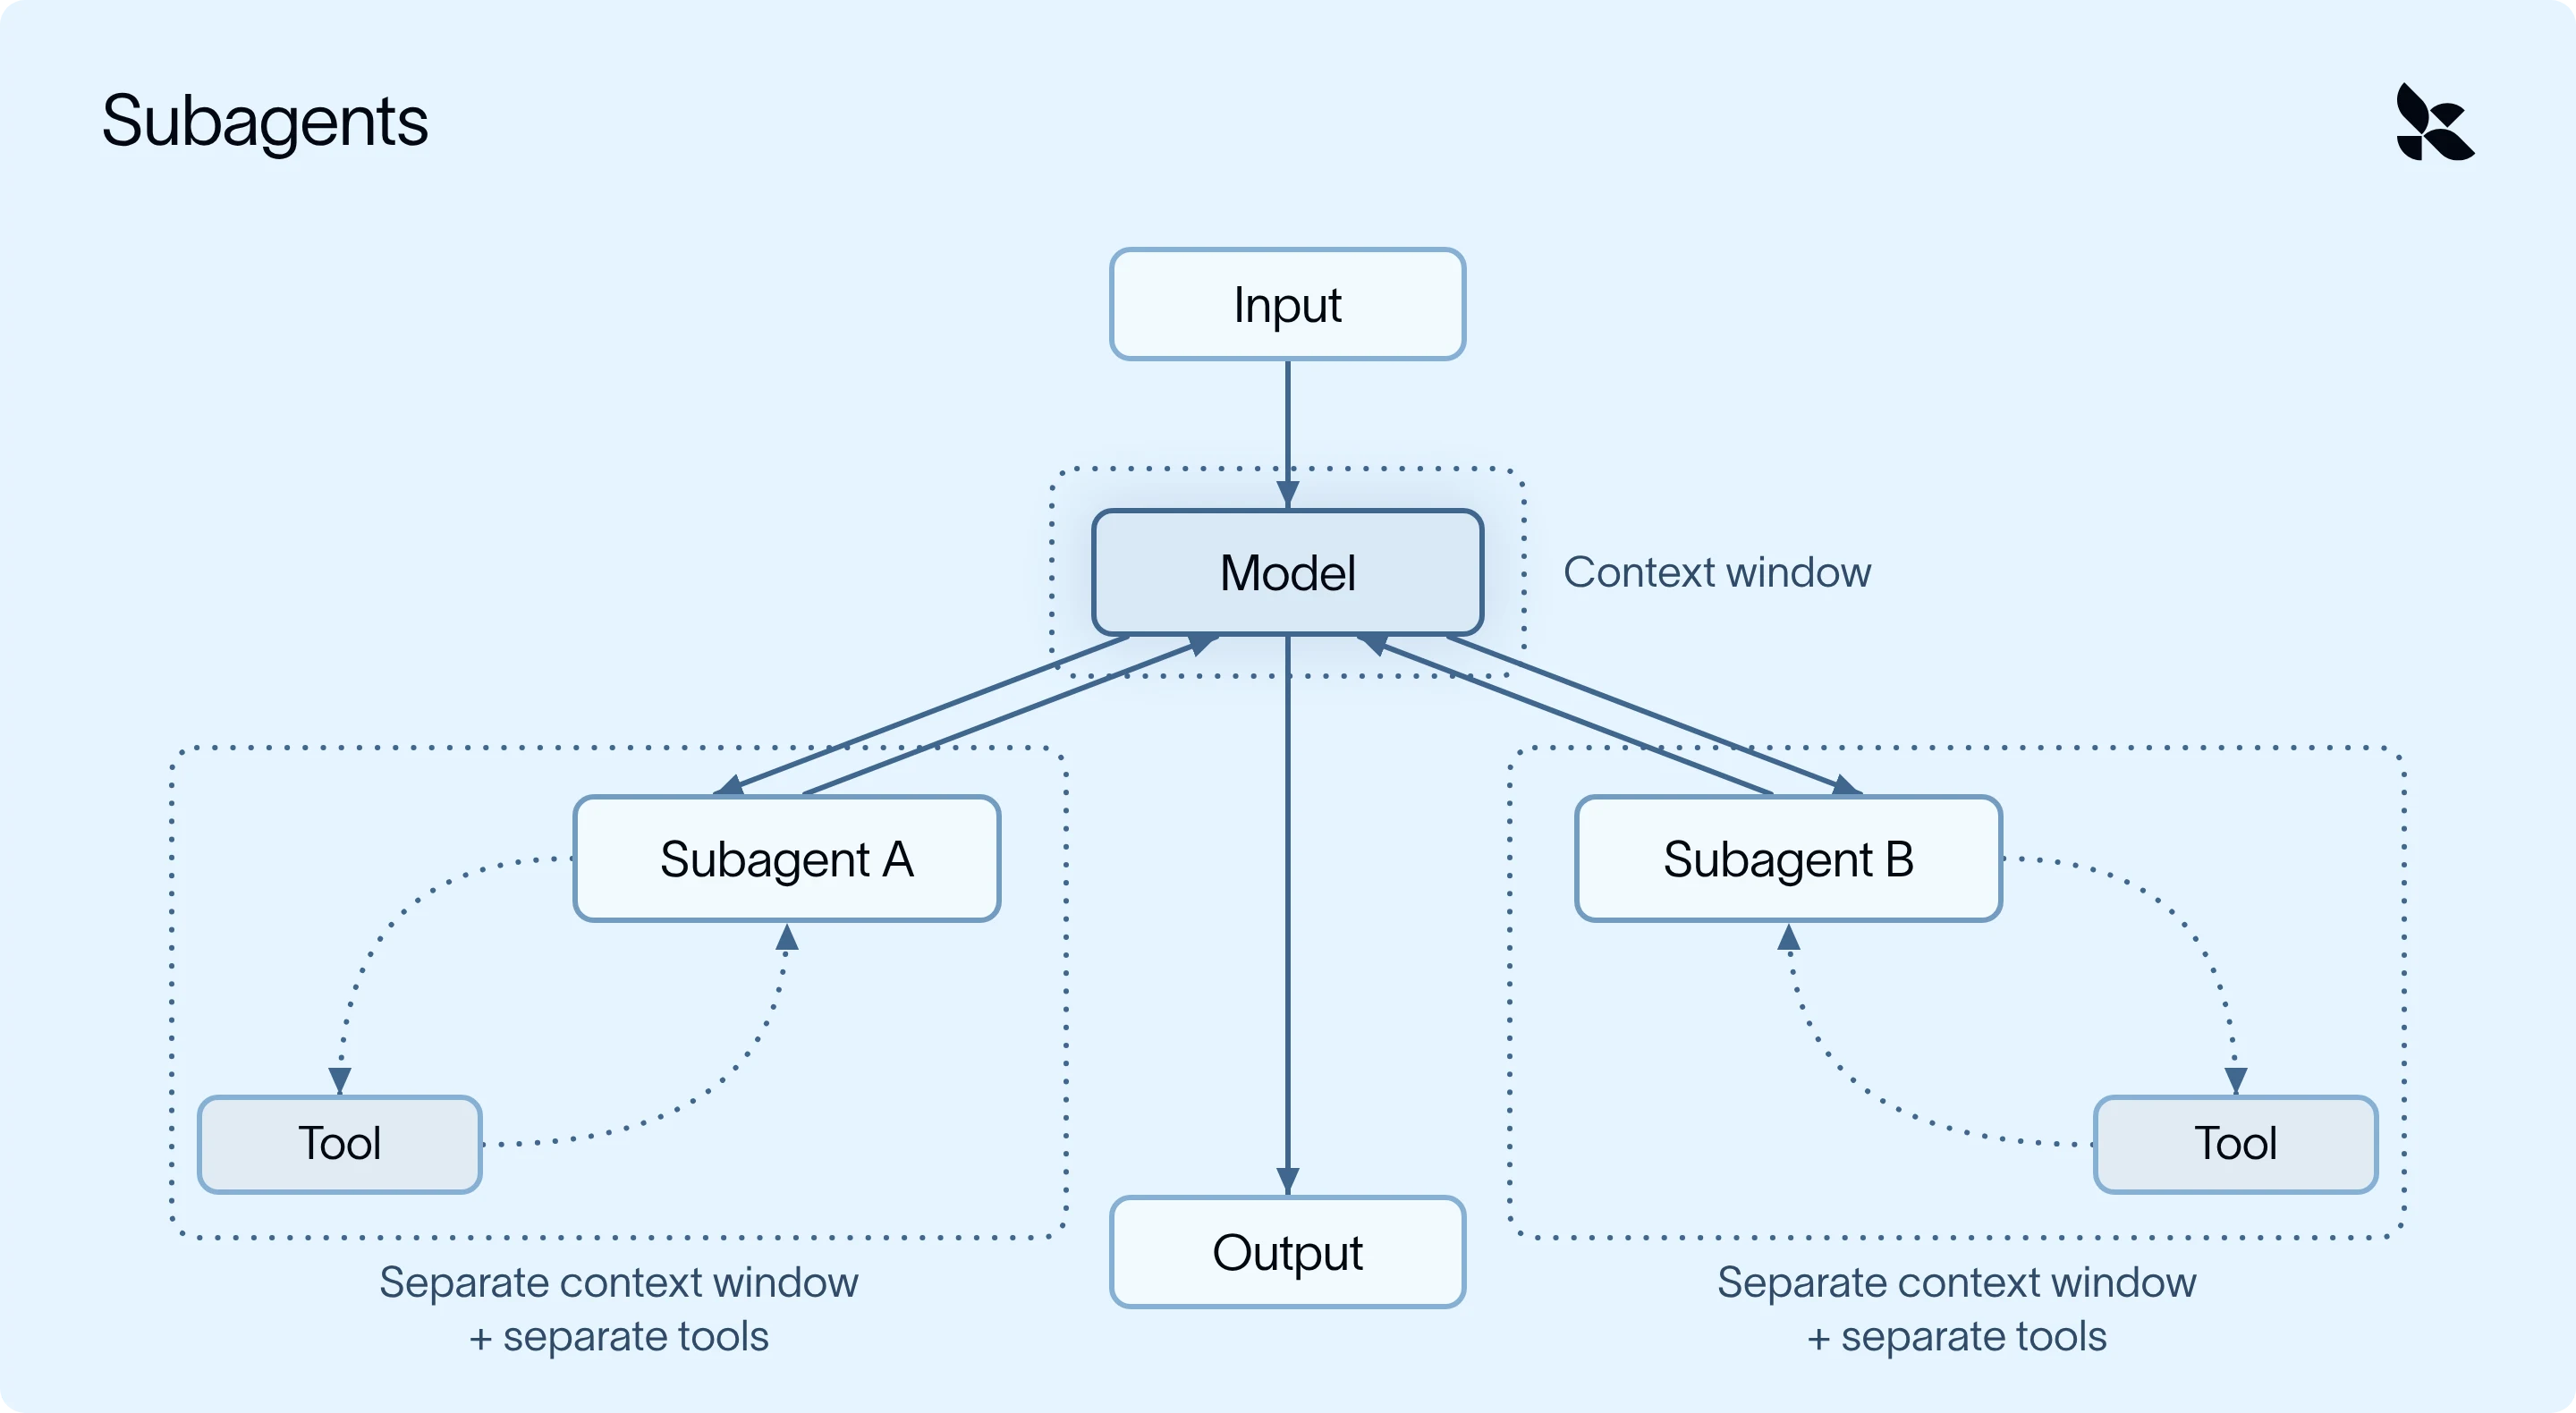
SubAgentMiddleware nos permite personalizar el system prompt y las herramientas disponibles para nuestros subagentes.
market_researcher = {
    "name": "market-researcher",
    "description": "Researches a company and returns the 3 most notable developments.",
    "system_prompt": "Use pull_market_report, then return 3 short bullet points. Do not return the raw report.",
    "tools": [pull_market_report],
}

agent = create_deep_agent(model=model, subagents=[market_researcher])
En nuestro caso, el agente principal le entrega cada empresa al subagente investigador de mercado.
El subagente investigador lee el informe completo en su propio contexto y devuelve solo tres puntos, de modo que el agente principal solo ve esos tres puntos (ni siquiera una vista previa del informe sin procesar). Además, dado que las tareas de los subagentes tienden a ser pequeñas y bien delimitadas, a menudo pueden ejecutarse en un modelo más barato y en paralelo.
Memoria a largo plazo: persistir entre conversaciones
Al final, tu agente habrá aprendido mucho. Parte útil, parte no.
Supongamos que le dices a tu agente: "Usa viñetas en el resumen, no párrafos". Sin memoria, podrías estar repitiendo eso cada semana. En Deep Agents, la memoria a largo plazo es un archivo markdown. Apuntas el agente a él con un argumento, y MemoryMiddleware se encarga del resto:
- Cargar: el archivo se lee al inicio de una ejecución.
- Inyectar: su contenido se añade al system prompt en cada llamada al modelo.
- Actualizar: cuando el agente aprende algo que vale la pena conservar, como tu preferencia de formato, actualiza el archivo.
Cambiar el modelo, conservar la memoria
Deep Agents es agnóstico respecto al proveedor, y eso se extiende a la memoria. Como la memoria es un archivo simple en tu propio almacén (no algo que un proveedor conserve), puedes apuntar el mismo backend a un modelo diferente:
agent = create_deep_agent(
    model="openai:gpt-6",  # different provider, same memory
    memory=["/memories/AGENTS.md"],
    backend=backend,
    store=store,
)
La próxima semana, un modelo diferente podría leer el mismo archivo y aun así escribir el resumen en viñetas.
Estrategias de ingeniería de contexto a tener en cuenta
Ya sea que construyas sobre Deep Agents, uses otro harness o construyas uno tú mismo, aquí hay algunas cosas a tener en cuenta:
- Las entradas grandes deben descargarse (offload), no truncarse. El truncamiento es con pérdida; la descarga lo mantiene recuperable.
- La compactación debe ser recuperable. Después de la summarización, el agente aún puede recuperar el detalle que necesita.
- El know-how debe cargarse bajo demanda. Las instrucciones de cada tarea en el system prompt consumen contexto en cada llamada.
- El trabajo ruidoso debe aislarse. Los subagentes con su propio contexto mantienen al agente principal enfocado.
- Tú deberías ser el dueño de la memoria. La memoria en almacenamiento que tú controlas sobrevive a un cambio de modelo o proveedor.
- Los valores predeterminados deberían ser personalizables. Los umbrales que funcionan para una tarea rara vez funcionan para todas.
Pruébalo
uv add deepagents¿Quieres aprender más con un instructor en vivo? Lo cubriré el 3 de noviembre: Regístrate AQUÍ!
Para profundizar en la ingeniería de contexto, consulta nuestro curso gratuito y a tu propio ritmo Deep Agents en LangChain Academy.