
Preparándonos para las elecciones legislativas de EE. UU. de 2026
14 de oct de 2026
A principios de este año, compartimos una actualización sobre nuestras salvaguardas electorales, que describía cómo medimos y prevenimos sesgos políticos, detectamos usos indebidos y dirigimos a las personas hacia información precisa sobre cómo votar.
A continuación, describimos cómo hemos desarrollado ese trabajo y continuado fortaleciendo nuestras salvaguardas electorales antes de las elecciones legislativas de este año en EE. UU.
Cómo las personas usan Claude para temas electorales y políticos
Nuestro objetivo es que Claude sea una herramienta útil para conversaciones políticas, al tiempo que se previene el abuso relacionado con elecciones. Eso comienza con entender cómo las personas realmente usan Claude en estos contextos. Para hacerlo, utilizamos Anthropic Insights para desarrollar un nuevo análisis de 250,000 conversaciones a lo largo de un período reciente de una semana.1
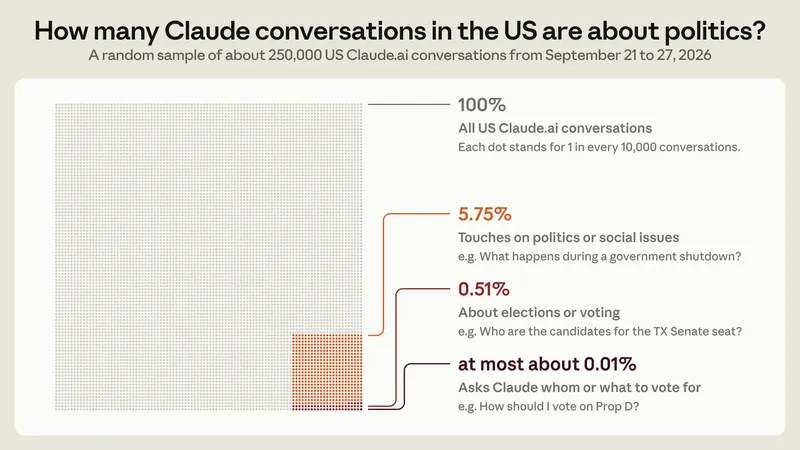
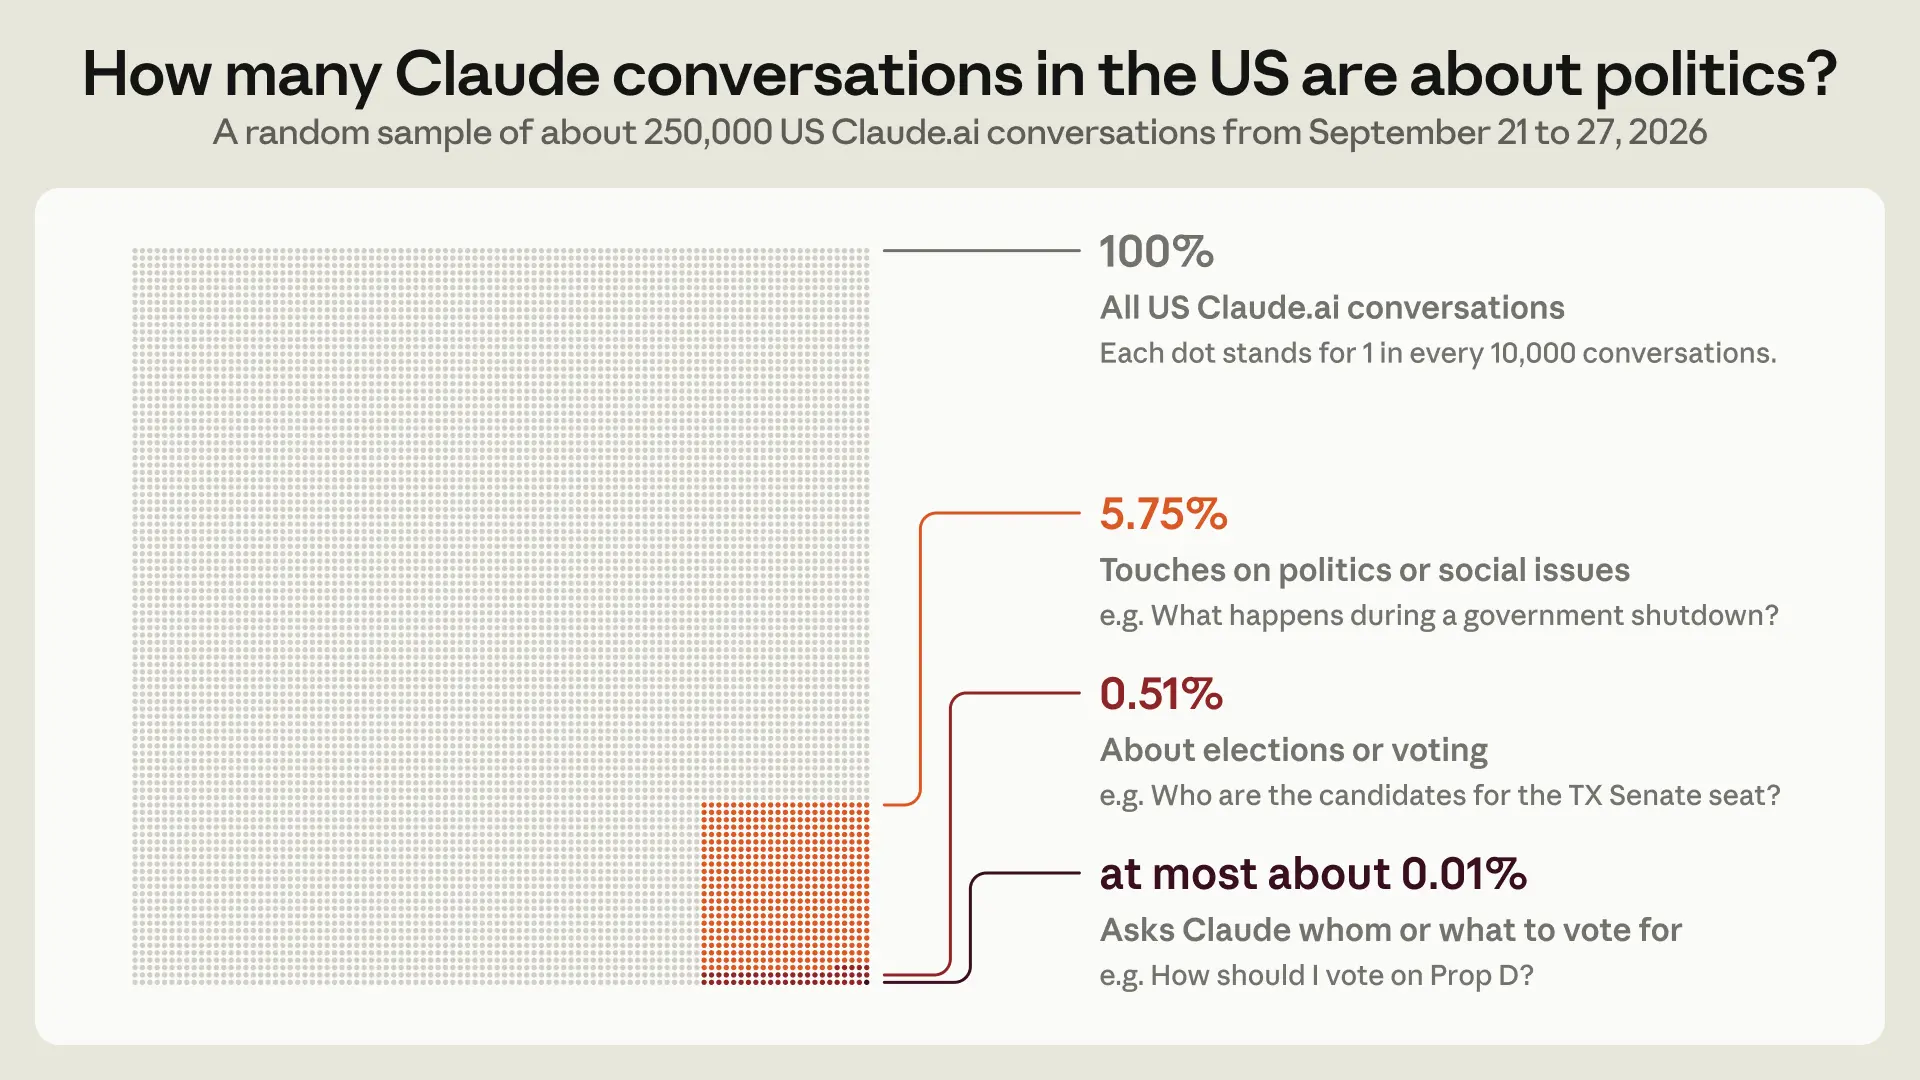
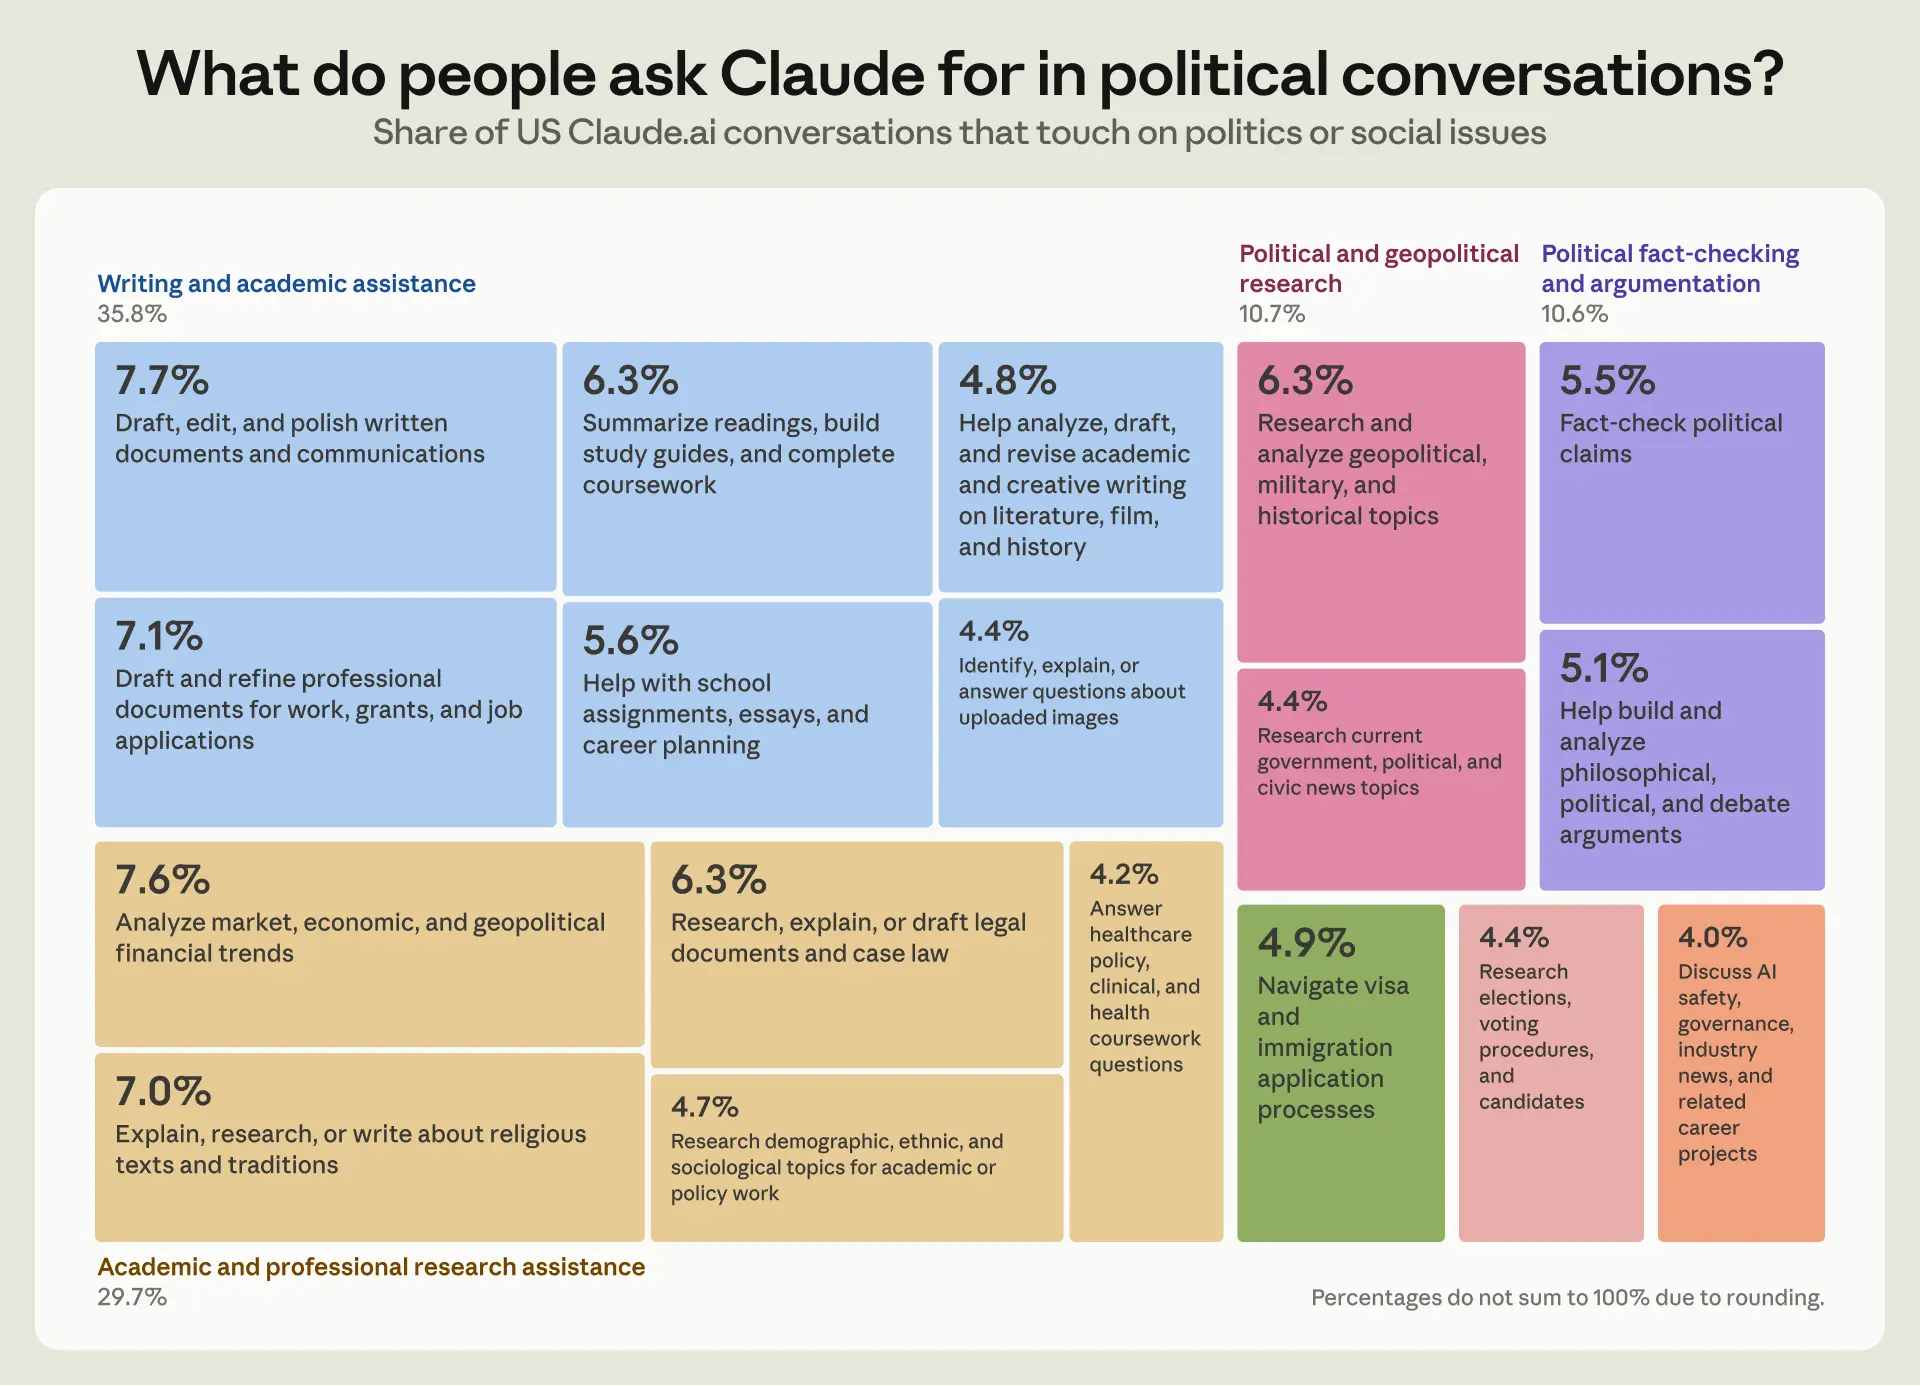
Hoy, las conversaciones que tocan de manera general temas de política, políticas públicas o cuestiones sociales representan alrededor del 5.75% de todas las conversaciones en Estados Unidos en Claude.ai, nuestra aplicación de consumo. Esto incluye a personas que recurren a Claude para seguir las noticias, realizar investigaciones académicas o profesionales sobre políticas públicas, informarse sobre candidatos y navegar servicios gubernamentales. Aproximadamente el 0.51% de todas las conversaciones tratan específicamente sobre elecciones o votación. A medida que nos acercamos al Día de la Elección, esperamos que la proporción de consultas políticas y relacionadas con elecciones aumente.
Esta muestra sugiere que las personas rara vez le preguntan a Claude por quién o qué votar. Este tipo de solicitudes aparecieron en aproximadamente el 0.01% de las conversaciones de Claude en EE. UU. Con más frecuencia, observamos que las personas hacían a Claude preguntas que podían ayudarles a llegar a sus propias conclusiones, como las posturas de los candidatos sobre un tema en particular. Las solicitudes que violaban nuestras políticas de integridad electoral eran aún menos comunes, apareciendo en aproximadamente el 0.002% de las conversaciones.2
Conectando a las personas con fuentes confiables
Antes del Día de la Elección, hemos añadido dos maneras para que las personas obtengan información confiable directamente en sus conversaciones con Claude. Como compartimos en abril, cuando las personas pregunten a Claude.ai sobre el registro de votantes, los lugares de votación o las fechas de las elecciones, continuaremos mostrando un banner con un enlace a TurboVote, un recurso no partidista de Democracy Works.
A finales de este mes, Claude comenzará a incorporar información oficial de votación de Democracy Works en sus respuestas en Claude.ai para los usuarios en EE. UU. Alguien que pregunte dónde votar o qué identificación llevar a su lugar de votación ahora obtendrá una respuesta específica para su estado, sin salir de la conversación. Estas respuestas se basan en información disponible públicamente que Democracy Works recopila de fuentes electorales estatales y locales.
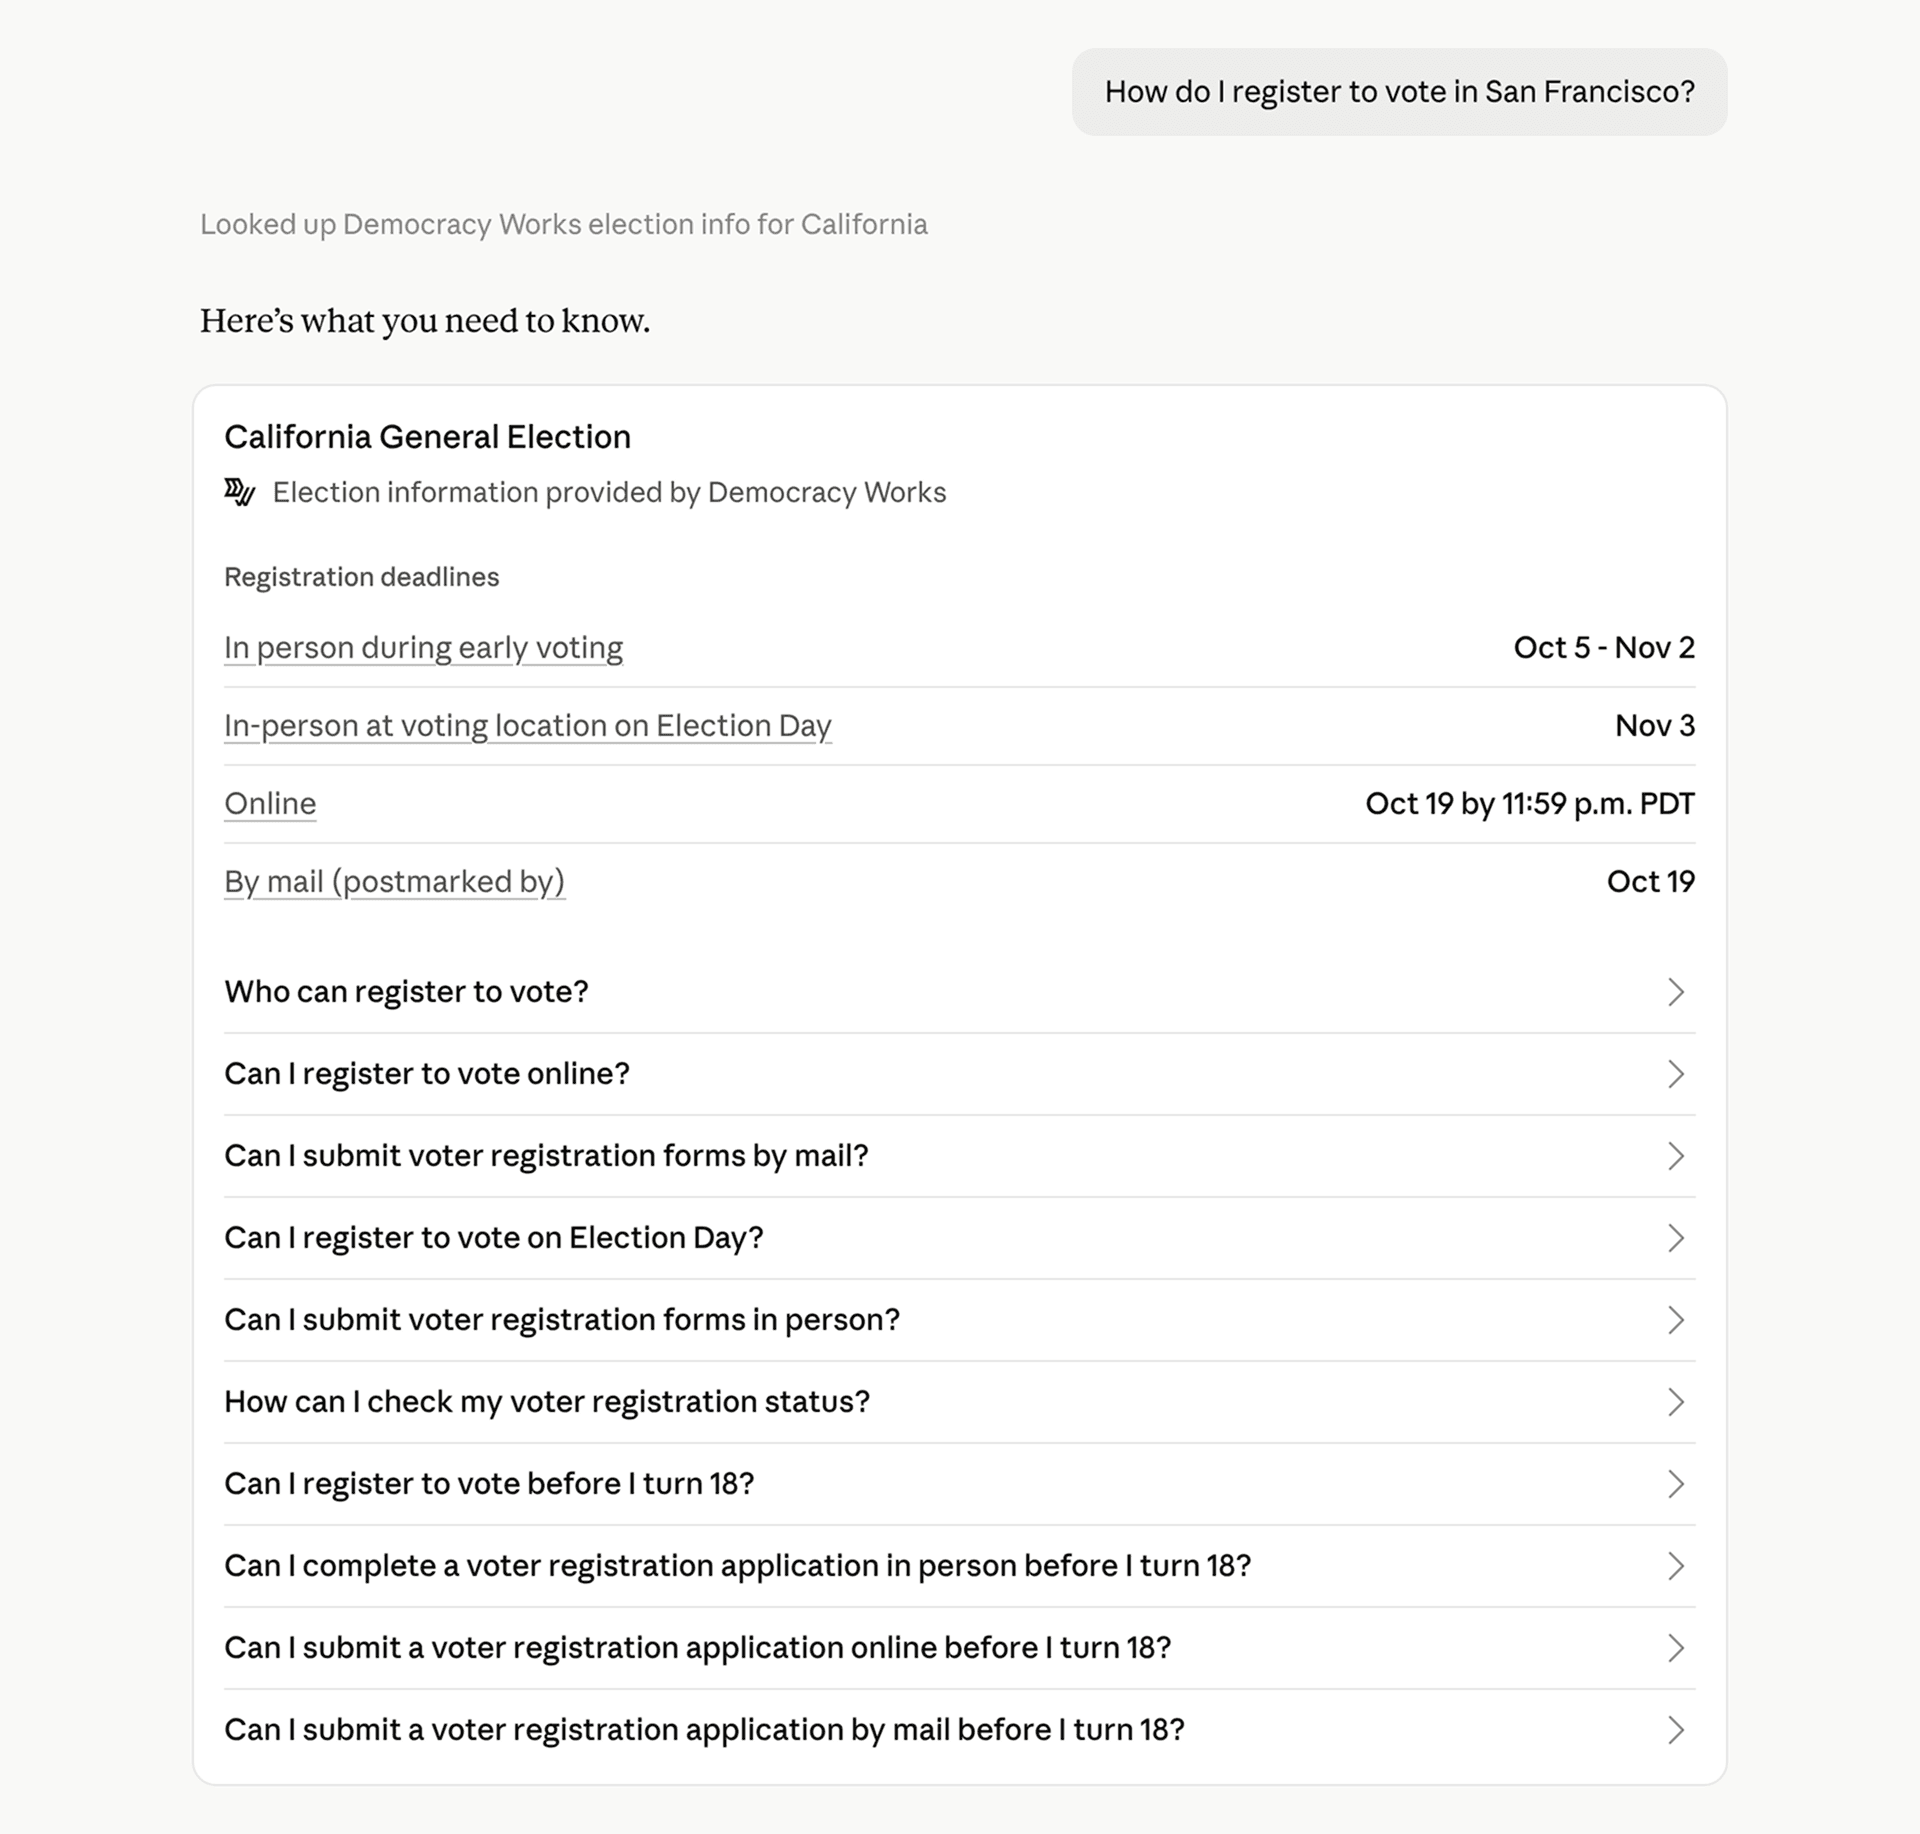
Además, Claude comenzará a mostrar resultados actualizados la noche de las elecciones y en los días siguientes, de modo que cuando las personas pidan recuentos de votos actuales o resultados electorales, se les mostrarán las últimas cifras oficiales directamente en su conversación.
Medición y prevención del sesgo político
Cuando las personas le preguntan a Claude sobre política, deberían recibir respuestas precisas e imparciales que no favorezcan ningún punto de vista político en particular. Por eso probamos exhaustivamente nuestros modelos en busca de sesgo político antes de cada lanzamiento de modelo. Claude Opus 5.5, Sonnet 5.5 y Haiku 5.5 son nuestros modelos más imparciales hasta la fecha, con una puntuación del 99% en nuestro evaluación de imparcialidad política. Nuestros últimos modelos también participan más fácilmente en discusiones políticas y rechazan menos solicitudes, para que las personas puedan obtener la información que buscaban. Seguimos refinando estas evaluaciones y también buscamos más allá de ellas nuevas formas de someter a prueba cómo nuestros modelos manejan los temas políticos.
Como parte de ese esfuerzo, pedimos a tres grupos independientes que revisaran cómo Claude maneja la libre expresión, cada uno desde un ángulo diferente con metodologías distintas. The Future of Free Speech, un think tank independiente de la Universidad Vanderbilt, probó a Claude con cientos de solicitudes sobre temas polémicos, y la Foundation for American Innovation comparó cómo Claude respondía a indicaciones equivalentes de izquierda y derecha, desde debates de políticas convencionales hasta escenarios más extremos. En ambas evaluaciones, la mayoría de las respuestas fueron calificadas como sólidas, abordando sustantivamente las solicitudes. El Collective Intelligence Project encuestó a más de 2,000 personas en EE. UU., Reino Unido e India para desarrollar una evaluación. Mediante un proceso de tres etapas, los participantes propusieron principios para manejar temas delicados, desde salud hasta política, identificaron temas para probar y ayudaron a desarrollar criterios para juzgar las respuestas del modelo. CIP sintetizó esta aportación y probó el acuerdo entre grupos demográficos y culturales para establecer principios compartidos.
Estas evaluaciones también identificaron áreas donde Claude todavía se queda corto. The Future of Free Speech y el Collective Intelligence Project encontraron que Claude rara vez rechazaba solicitudes, pero a veces añadía advertencias y contraargumentos no solicitados, como insertar un punto de vista opuesto en un correo de defensa de una causa. Y la Foundation for American Innovation encontró que Claude Sonnet 4.5 no siempre maticaba de manera equilibrada, y era más propenso a suavizar argumentos de posiciones de derecha.
Estamos abordando esto de varias maneras. Hemos mejorado cómo Claude responde a preguntas directas de sí o no y a solicitudes de respuestas más breves, donde encontramos que sus respuestas podían ser menos equilibradas. También estamos usando estos hallazgos para mejorar cuándo y cómo Claude añade advertencias o contraargumentos, de modo que trate las solicitudes de todo el espectro político de manera más consistente. Y seguimos mejorando cómo probamos los matices desiguales, basándonos en evaluaciones existentes que usan indicaciones equivalentes de izquierda y derecha. Más ampliamente, estamos trabajando para expandir nuestras evaluaciones de sesgo político para reflejar mejor conversaciones reales y cubrir candidatos y preguntas de votación además de temas de políticas.
Cómo definimos el mal uso
Nuestra Usage Policy prohíbe usar Claude para engañar a votantes o alterar elecciones, desde difundir información falsa sobre candidatos o cómo votar, hasta hacerse pasar por funcionarios electorales o intentar suprimir la participación. Cada año, actualizamos la política para reflejar las capacidades cambiantes de nuestros modelos y los comentarios de nuestros clientes. La actualización de este año, que anunciamos la semana pasada, aclara qué cubren nuestras reglas electorales y qué no, y añade nuevos ejemplos para ayudar a las personas a entender dónde están los límites.
Sabemos que muchas campañas políticas usan Claude para tareas legítimas y cotidianas, por lo que recientemente publicamos una guía para ayudarlas a entender dónde aplican estas políticas. Cubre las muchas maneras en que las campañas pueden poner a Claude a trabajar, como redactar declaraciones de prensa y correos de recaudación de fondos, prepararse para debates, analizar datos de participación y crear materiales de contacto con votantes. También especifica qué está prohibido, como usar Claude para crear perfiles falsos en redes sociales que se hagan pasar por personas reales, producir comentarios en masa para inflar la participación de una campaña, o escribir contenido para sitios y páginas de noticias que afirmen falsamente ser independientes.
Probar y fortalecer nuestras defensas
Desplegamos clasificadores automatizados entrenados para detectar abusos relacionados con elecciones. Para ver cómo se mantienen estas salvaguardas en la práctica, nos asociamos con el Institute for Strategic Dialogue (ISD) y el McCain Institute, ambas organizaciones de investigación independientes, para someter a prueba nuestras protecciones en EE. UU., Israel y Brasil. Los analistas probaron si Claude asistiría con campañas engañosas, desinformación y otras formas de abuso electoral. Comenzaron con solicitudes directas, luego descompusieron campañas completas en tareas más pequeñas que podían parecer inofensivas por sí solas, como investigación de audiencias, creación de sitios de noticias, redacción de contenido y planificación de su distribución. Descubrieron que Claude rechazaba de manera confiable una sola solicitud dañina, pero podía pasar por alto una campaña maliciosa cuando se distribuyaba entre muchas solicitudes individuales que parecían inofensivas por sí solas.
Sobre la base de estos hallazgos y los nuestros, hemos añadido nuevos clasificadores para identificar mejor usos indebidos novedosos y de múltiples pasos, incluidos intentos de crear cuentas falsas en redes sociales y sitios de noticias destinados a discusiones políticas, o de ejecutar esquemas electorales con motivación financiera. También mejoramos nuestra capacidad para detectar el uso indebido relacionado con elecciones por parte de actores estatales extranjeros, y fortalecimos nuestras protecciones cibernéticas para la infraestructura electoral y las campañas. Finalmente, construimos salvaguardas específicas para riesgos localizados identificados en EE. UU., Israel y Brasil, que todos tienen elecciones nacionales importantes este año.
Nuestros equipos de inteligencia de amenazas y de cumplimiento revisan la actividad marcada y toman medidas cuando confirman una violación, incluyendo la prohibición de cuentas. También compartimos habitualmente ejemplos de acciones o comportamientos no intencionados del modelo que hemos observado durante nuestras evaluaciones y el uso interno de Claude.
Lo que hemos encontrado
Nuestro reciente informe de inteligencia de amenazas refleja un cambio más amplio en las tendencias de abusos relacionados con elecciones. Los actores políticos, alineados con Estados y comerciales están incorporando ahora la IA en casi todos los aspectos de sus operaciones de influencia, desde la planificación y la creación de contenido hasta la construcción de plataformas utilizadas para difundir un mensaje. Debido a que vemos estas etapas tempranas de una operación ocurriendo en Claude, a menudo tenemos la oportunidad de detener estos esfuerzos antes de que lleguen al público.
Nuestros equipos han continuado investigando y previniendo el abuso coordinado en torno a las elecciones, incluidas las elecciones intermedias de EE. UU. En un caso, operadores con base en el extranjero de un sitio de noticias falsas usaron Claude para producir cobertura de las elecciones intermedias de EE. UU. favorable a narrativas rusas, iraníes y norcoreanas. También hemos observado actores de amenazas que buscan explotar las elecciones con fines de lucro, usando Claude para producir noticias fabricadas y otro contenido diseñado para atraer a audiencias estadounidenses y generar ingresos publicitarios. Prohibimos las cuentas involucradas en estos casos y mejoramos nuestra capacidad para detectar este tipo de abuso.
Mirando hacia el futuro
Más personas recurren a Claude para obtener información sobre las elecciones de este año que nunca antes. Tenemos la responsabilidad de asegurarnos de que las respuestas que obtengan sean precisas y equilibradas, y de que Claude no se use para socavar el proceso democrático. Seguiremos invirtiendo en hacer que Claude sea más imparcial, en prevenir y abordar el uso indebido, y en ser transparentes en nuestras acciones. Este trabajo será fundamental en las próximas elecciones intermedias de EE. UU. y se extiende también a las elecciones de todo el mundo. En los próximos meses, también esperamos compartir una visión más completa de cómo las personas usaron Claude a lo largo del ciclo electoral, con el objetivo de fortalecer nuestras evaluaciones y salvaguardas relacionadas con las elecciones.
Notas al pie
- Tomamos una muestra aleatoria de 250,000 conversaciones de consumidores estadounidenses en Claude.ai del 21 al 27 de septiembre de 2026 y las analizamos de una manera que preserva la privacidad.
- Esta cifra se generó a partir de un análisis separado de 250,000 conversaciones de Claude.ai, que fueron revisadas contra nuestra política de integridad electoral.
Contenido relacionado
Una actualización sobre los evaluadores independientes
Para evaluar la seguridad de nuestros sistemas, Anthropic está otorgando acceso similar al de empleados a un equipo de METR, una organización sin fines de lucro que evalúa modelos de IA de frontera, y estamos en conversaciones preliminares con varias otras organizaciones, incluida Hugging Face.
Leer másAnthropic abre una oficina en Singapur y firma un memorando de entendimiento con el Gobierno de Singapur
Anthropic ha abierto una oficina en Singapur y firmó un memorando de entendimiento con el gobierno del país para impulsar una adopción de IA segura y responsable.
Leer másActualización de la Política de Uso de 2026
Publicamos una nueva versión de nuestra Política de Uso. En esta publicación, resumimos los cambios que hemos realizado.
Leer más