
Resumen
La puntuación de confianza ahora es compatible con todos los tipos de especuladores basados en modelos draft. En ausencia de una cabeza de confianza, un estimador ajustado en línea deriva una característica de los logits del draft para predecir la probabilidad de que el modelo objetivo lo acepte, la cual se usa directamente como puntuación de confianza para la Verificación Adaptativa. Los coeficientes del estimador se ajustan continuamente, adaptándose al tráfico de datos entrante. Esta función llegó en el PR #52228, y se habilita con enable_adaptive_verification para modelos draft sin una cabeza de confianza.
Antecedentes
El Adaptive Verification (AV) de vLLM permite verificar un subconjunto de los tokens borradores durante la decodificación especulativa. Los tokens borradores con baja probabilidad de aceptación se recortan del lote antes de ejecutar el paso hacia adelante del modelo objetivo, ahorrando cómputo. Esta optimización es especialmente beneficiosa al atender tamaños de lote grandes, porque en ese régimen la GPU se vuelve limitada por cómputo. Véase esta publicación del blog de vLLM para más detalles.
El AV necesita una estimación por token de la probabilidad de aceptación, razón por la cual, hasta ahora, solo admitía drafters DSpark. Los modelos DSpark suelen incluir una cabeza de confianza: una pequeña capa lineal sobre el estado oculto del draft para cada posición, entrenada como un clasificador binario para "¿aceptará el objetivo este token?"
Problema
Los modelos draft que carecen de una cabeza de confianza, como EAGLE, MTP, DFlash y algunos checkpoints DSpark, quedan completamente fuera del AV. Para usarlo, estos drafters necesitan una estimación de aceptación por token, y añadir una cabeza de confianza implica reentrenar el draft, lo cual no es una opción para los muchos checkpoints existentes que la gente ya sirve.
Trabajo previo
Usar la propia confianza del draft como proxy de la aceptación está bien establecido. EAGLE-2 demostró que las probabilidades del draft de EAGLE siguen de cerca las tasas de aceptación, y las usó para hacer crecer y reordenar un árbol de draft dinámico. Draft & Verify y varios trabajos posteriores dejan de redactar una vez que la probabilidad del draft cae por debajo de un umbral fijo. SpecDec++ en cambio, entrena una cabeza dedicada a la predicción de aceptación, similar en espíritu a la cabeza de confianza de DSpark. En cada caso, el mapeo de la confianza del draft a la aceptación se usa tal cual o se aprende fuera de línea.
El AV necesita algo más que un buen ordenamiento. Su decisión de presupuesto suma las probabilidades de aceptación predichas y las pondera frente a los costos medidos, por lo que las predicciones deben estar calibradas para el par de modelos y la carga de trabajo específicos que se atienden, que es precisamente lo que proporciona el estimador ajustado en línea de la siguiente sección.
Solución: Estimador de aceptación ajustado en línea
Añadimos una regresión logística ligera que estima la probabilidad de aceptación de cada token borrador a partir de un único escalar derivado de la distribución del draft: los log-odds del token más probable del draft. Tiene una pendiente compartida y un intercepto por posición de draft, de modo que un draft de Ktokens necesita un total de K + 1 parámetros. Esos parámetros se ajustan en línea a partir de las decisiones de aceptar/rechazar que el modelo objetivo ya produce durante la verificación normal. Cualquier checkpoint de borrador existente obtiene AV de forma gratuita.
El resto de esta sección cubre las dos mitades del diseño: qué cantidad puntúa el estimador y cómo se ajustan sus coeficientes durante el servicio.
Puntuar la Distribución
La puntuación de confianza para un token de borrador dado se estima mediante una regresión logística por posición:
donde ω es la pendiente ajustada compartida entre todas las posiciones de borrador, βi es el intercepto ajustado por posición, y q es la distribución del borrador. La forma alternativa de log-odds deja clara la relación:
logit(qmax) es la característica del estimador, y es el log-odds del token más probable del borrador. Intuitivamente, representa cuán seguro está el modelo de borrador en sus predicciones. Se transforma linealmente mediante los coeficientes ω y βi para predecir el log-odds de la aceptación del borrador por parte del modelo objetivo. La sigmoide de eso es p, la tasa de aceptación estimada, que se usa como la puntuación de confianza para AV.
Otras Características Consideradas
Se consideraron y rechazaron varias características alternativas por una razón u otra. Los cuatro ejes principales que más nos importaban al evaluar una característica eran:
- Sin pérdida — Si la característica sesga la distribución de salida durante la decodificación especulativa.
- Área Bajo la Curva (AUC) — La probabilidad de que un borrador aceptado elegido al azar puntúe más alto que uno rechazado seleccionado al azar. Esto mide la discriminación entre borradores que deberían ser aceptados vs rechazados. Un valor más alto indica una mejor capacidad de discriminación, y 0.5 es azar puro.
- Log-loss — La log-verosimilitud negativa media de la probabilidad de aceptación predicha, que penaliza las respuestas seguras incorrectas y recompensa la calibración. Un valor más bajo indica una mejor capacidad para predecir la probabilidad de aceptación verdadera de un borrador dado.
- Error de Calibración Esperado (ECE) — Agrupar cada borrador según su probabilidad de aceptación predicha, y luego medir el error entre la predicción media frente a la frecuencia media observada dentro de cada grupo, ponderado por la ocupación del grupo. Esto mide calibración, y un valor más bajo indica una mejor capacidad de asignar a un borrador una probabilidad que coincida con la frecuencia real entre borradores puntuados de forma similar.
La pérdida de información (losslessness) es una propiedad innegociable que deben tener las características. De lo contrario, rompemos la garantía fundamental del decoding especulativo de producir exactamente la distribución del modelo objetivo. Tanto el AUC como el ECE importan para la decisión de recorte de AV, pero de maneras diferentes. El AUC es importante para el ordenamiento local de las probabilidades de supervivencia:
survival = confidence_probs[idx_mapping].cumprod(dim=1)
...
winners = flat.topk(draft_budget).indices
El AUC garantiza que un token borrador con mayor probabilidad de ser aceptado sea admitido antes que uno con menor probabilidad. Por otro lado, el ECE es importante para la global decisión de presupuesto:
num_tokens_to_estimated_accepted_tokens = np.concatenate(
    ([num_sampling_requests], num_sampling_requests + np.cumsum(scores))
)
costs = draft_cost_ms[...] + verify_cost_ms[...]
...
draft_budget = int(np.argmax(num_tokens_to_estimated_accepted_tokens / costs))
Las probabilidades se suman y luego se dividen por la tabla de costos medida. El ECE garantiza que el número estimado de tokens aceptados coincida con la realidad.
A continuación se muestra una tabla de las diversas características experimentadas, junto con sus puntuaciones para las cuatro categorías. Se midieron sobre ~4.5M borradores etiquetados recopilados durante el servicio de DeepSeek-V4-Flash + DSpark (temp=1, top-p=0.95, conc=64), sin AV, a través de cinco conjuntos de datos: SPEED-Bench 2k low/high-entropy, GSM8K, HumanEval y MT-Bench. Las dos últimas filas son referencias en lugar de características ajustadas: el qmax del borrador usado directamente como probabilidad de aceptación sin ajuste, y las puntuaciones del cabezal de confianza entrenado.
| característica | sin pérdida | AUC | log-loss | ECE |
|---|---|---|---|---|
| log(qmax) | sí | 0.8069 | 0.4813 | 0.0592 |
| log(qmax) − log(q2nd) (margen top-2) | sí | 0.8156 | 0.4437 | 0.0105 |
| H(q) (entropía) | sí | 0.8321 | 0.4577 | 0.0638 |
| −log(−log(qmax)) | sí | 0.8336 | 0.4289 | 0.0103 |
| logit(qmax) (enviado) | sí | 0.8336 | 0.4284 | 0.0100 |
| logit(qsampled) | no | 0.8553 | 0.4040 | 0.0152 |
| −log(−log(qsampled)) | no | 0.8554 | 0.4075 | 0.0193 |
| qmax (sin ajuste, usado directamente como la probabilidad) | sí | 0.8259 | 0.4880 | 0.0736 |
| cabeza de confianza entrenada | sí | 0.8191 | 0.4449 | 0.0052 |
logit(qsampled) y −log(−log(qmuestreada)) superan claramente a la característica elegida en la tabla en términos de AUC, pero no se usaron porque el recorte basado en ellas produce una distribución de salida sesgada. Ambas leen qmuestreada, la probabilidad del token que el redactor realmente extrajo. Recortar un borrador basándose en una función de este valor hace que la decisión de verificar en la posición i dependa de xi en sí mismo, por lo que los borradores que sobreviven al recorte ya no están distribuidos como q. El muestreo por rechazo estándar acepta un token con probabilidad min(1, p/q), esperando que q sea la distribución de la cual se muestreó el token del borrador. Pero recortar basándose en qmuestreada sesga la distribución emitida hacia los tokens de mayor confianza del redactor.1
La fila qmax "no fit" muestra por qué ajustamos en absoluto, en lugar de usar directamente la propia probabilidad del redactor, como hace EAGLE-2 al construir su árbol de borradores. Usada directamente, la probabilidad del token principal del redactor en realidad clasifica los borradores mejor que el cabezal de confianza entrenado (0.8259 frente a 0.8191 de AUC). Sin embargo, no está bien calibrada. Su predicción media sobre los borradores etiquetados es 0.784 frente a la tasa de aceptación observada de 0.723, y su ECE es 7 veces peor que la del logit(qmax) enviado (0.0736 frente a 0.0100). La probabilidad del token principal del redactor refleja únicamente la confianza del redactor en su propia predicción, no si el modelo objetivo estará de acuerdo. Este acuerdo se ve influido además por la configuración de muestreo y la carga de trabajo. Un ajuste en línea aprende este mapeo directamente de las decisiones de aceptar/rechazar del objetivo, lo que arroja una mejor calibración, que es de lo que depende la decisión de presupuesto.
Finalmente optamos por la característica logit(qmax), que tiene un buen equilibrio entre AUC y ECE a un costo razonable. También fue una elección natural, ya que comparte tanto la escala log-odds como la resolución de la cantidad que intentábamos estimar.
Frente a un cabezal de confianza entrenado
Como se muestra en la tabla anterior, para DeepSeek-V4-Flash + DSpark, el estimador supera a la cabecera de confianza tanto en AUC como en la pérdida de log-verosimilitud, pero queda por debajo en ECE. La siguiente tabla resume la diferencia:
| AUC ↑ | log-loss ↓ | ECE ↓ | |
|---|---|---|---|
| estimador logit(qmax) | 0.8336 | 0.4284 | 0.0100 |
| cabecera de confianza entrenada | 0.8191 | 0.4449 | 0.0052 |
| Δ (estimador − cabecera) | +0.0146 | −0.0166 | +0.0048 |
Sin embargo, una vez que excluimos el primer borrador de los promedios, el panorama cambia sustancialmente:
| AUC ↑ | log-loss ↓ | ECE ↓ | |
|---|---|---|---|
| estimador logit(qmax) | 0.8352 | 0.4420 | 0.0103 |
| cabecera de confianza entrenada | 0.8075 | 0.4743 | 0.0090 |
| Δ (estimador − cabecera) | +0.0278 | −0.0323 | +0.0013 |
La cabecera y el estimador están ahora virtualmente empatados en calibración. El desglose de AUC por posición ayuda a explicar por qué:
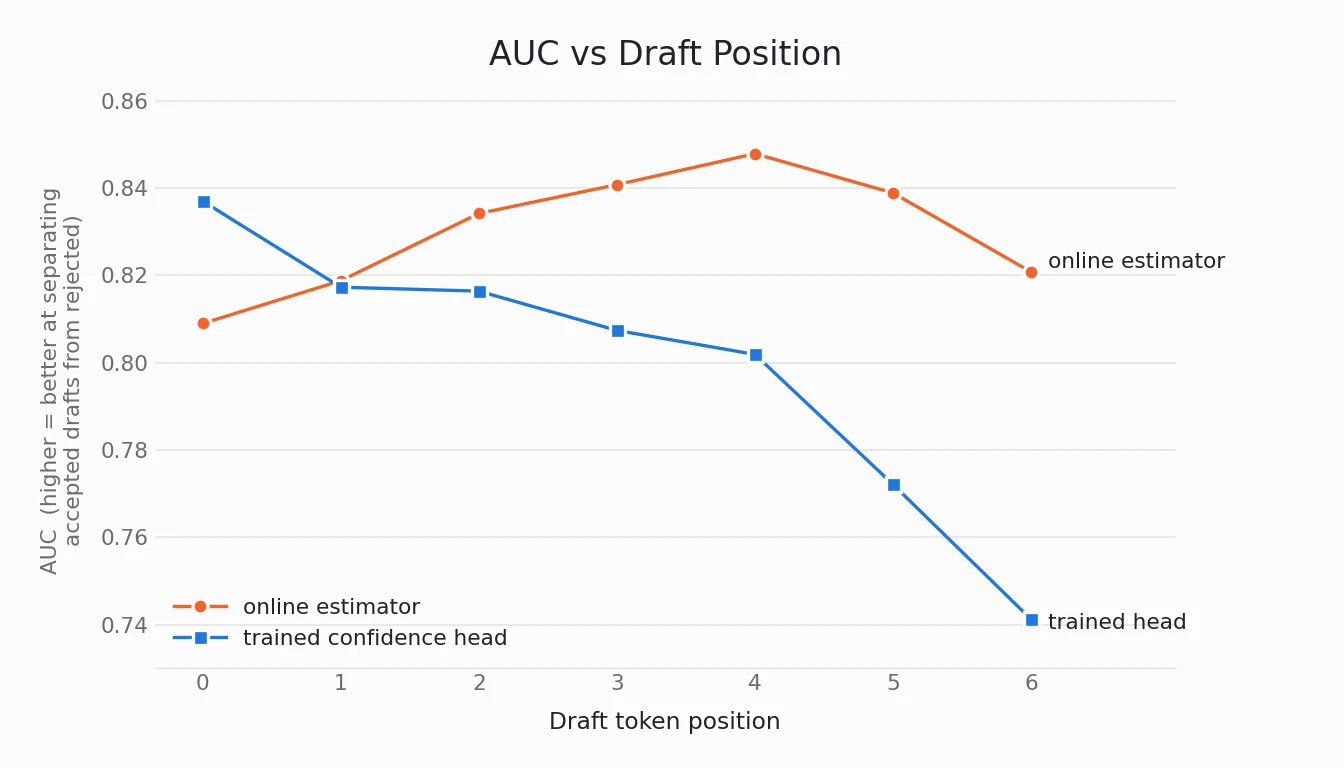
La cabecera de confianza es el mejor predictor en la primera posición del borrador, pero el estimador toma la delantera a partir de la segunda posición. La brecha se amplía con la profundidad, con el estimador liderando por 0.08 de AUC en la última posición. Ambos predictores también caen después de la quinta posición. Esto probablemente se debe a que el DSpark de DSV4-Flash declara un tamaño de bloque de 5 y el borrador nunca fue entrenado más allá de eso, por lo que los propios borradores empeoran allí.
Dado que la supervivencia es un producto acumulativo, y la primera posición del borrador siempre lleva la puntuación más alta de una solicitud, con menos frecuencia es el token que recorta el presupuesto. La ventaja del estimador está justo donde ocurre el recorte, y explica por qué el estimador puede igualar a la cabecera de confianza en rendimiento de extremo a extremo.
Ajuste de los Coeficientes
Los coeficientes ω y βi se reajustan continuamente durante el servicio en vivo de solicitudes. Los tokens de borrador propuestos durante el paso de decodificación anterior son verificados por el modelo objetivo en el siguiente paso de decodificación. Solo los tokens de borrador hasta el primer rechazo (si lo hay) son elegibles para el entrenamiento, porque el modelo objetivo los ha etiquetado explícitamente (aceptar o rechazar).
Usamos Mínimos Cuadrados Reponderados Iterativamente (IRLS) para minimizar la pérdida de log-verosimilitud de las predicciones frente a las etiquetas. Esta minimización se realiza sobre una aproximación de Taylor de segundo orden de la pérdida de log-verosimilitud. El paso de optimización para ω y βi se obtiene resolviendo el sistema de ecuaciones
donde Δθ es el delta para la pendiente compartida ω y los interceptos por posición βi, H es la hessiana de la función de pérdida con una forma de (K + 1) × (K + 1), y g es el gradiente de la función de pérdida, con un tamaño de K + 1.
Se realiza un reajuste después de cada ronda fija de N pasos de decodificación. Durante cada paso de decodificación en ese intervalo, acumulamos los valores de la hessiana y del gradiente, que se derivan de los coeficientes, las características y las etiquetas recopiladas durante la ronda. Hacer esto acota la memoria superiormente a O(K²) a lo largo de una ronda, en contraste con O(N × B × K) si en su lugar recopiláramos las etiquetas en bruto. En el último paso de la ronda, se resuelve el sistema y se actualizan los coeficientes.
Como cabría esperar, los borradores más profundos se aceptan con menos frecuencia que los borradores más superficiales. En consecuencia, las posiciones más profundas del borrador pueden quedarse sin etiquetas durante una ronda. Se tomaron dos decisiones de diseño para mitigar el impacto de esto en el proceso de reajuste:
- Pendiente compartida: La pendiente se comparte entre todas las posiciones del borrador para evitar actualizaciones ruidosas causadas por el adelgazamiento de datos en profundidad. Las predicciones son mucho más sensibles a errores de pendiente que a errores de intersección, por lo que compartirla hace que el paso de Newton esté bien determinado. Además, mediciones empíricas muestran que compartir la pendiente prácticamente no cuesta nada en términos de precisión (solo 0.0002 AUC y 0.0003 log-loss).
- Amortiguación del paso: La actualización de cada coeficiente se escala según la cantidad de evidencia de soporte mediante la fórmula n / (n + constante), donde n es el recuento de borradores calificados. Esto garantiza que las posiciones más profundas con menos etiquetas se muevan de manera más conservadora, evitando actualizaciones basadas en ruido.
Pendiente frente a intersección: roles
Los coeficientes ajustados se rastrearon en varias combinaciones de modelo/conjunto de datos, y los dos tipos de parámetros se comportan de manera muy diferente.
Fija el par de modelos y varía la carga de trabajo: Ajustando DSV4-Flash + DSpark de forma independiente en cada una de las cinco cargas de trabajo, la pendiente apenas se mueve (0.51 a 0.55), sin correlación con la dificultad de la carga de trabajo (r = −0.08 frente a la entropía media del borrador). Las intersecciones hacen lo contrario: la intersección de la primera posición del borrador se correlaciona con la entropía del borrador con r = −0.89, y va de ~0.5–0.6 en las cargas más predecibles hasta por debajo de 0 en la menos predecible.
| Conjunto de datos | Tasa de aceptación | Entropía media del borrador | Pendiente ω | Intersección β0 |
|---|---|---|---|---|
| gsm8k | 0.781 | 0.562 | 0.5365 | +0.478 |
| humaneval | 0.751 | 0.669 | 0.5135 | +0.486 |
| speed-bench 2k baja entropía | 0.755 | 0.703 | 0.5087 | +0.610 |
| mt-bench | 0.714 | 0.800 | 0.5495 | +0.181 |
| speed-bench 2k alta entropía | 0.642 | 1.077 | 0.5197 | −0.089 |
Ahora varíemos el par de modelos: La pendiente varía de 0.45 a 0.59 entre pares, pero se mantiene ajustada dentro de cada uno. Las intersecciones también difieren entre pares, por lo que, a diferencia de la pendiente, no son una propiedad de un solo eje.
| Modelo | nspec | Pendiente ω | ω sd | Intersección β0 |
|---|---|---|---|---|
| DeepSeek-V4-Flash + DSpark | 5 | 0.5013 | 0.0250 | +0.279 |
| MiMo-V2.5-Pro-FP4 + DFlash | 8 | 0.5197 | 0.0415 | −1.000 |
| Inkling-NVFP4 + MTP | 8 | 0.5859 | 0.0349 | −0.572 |
| Muse-Glimmer-30B + DFlash2 | 7 | 0.4450 | 0.0323 | +0.167 |
Leídas en conjunto, las dos tablas sugieren una división del trabajo. La pendiente mide qué tan bien el modelo borrador sabe cuándo está en lo correcto. Esta es una propiedad del par objetivo/borrador y del método de muestreo del borrador, razón por la cual apenas cambia cuando solo varía la carga de trabajo. Las intersecciones absorben el resto: la tasa de aceptación base en cada posición del borrador, que disminuye con la profundidad y cae aún más en contenido menos predecible. Esa tasa de aceptación base depende del par de modelos así como de la carga de trabajo, razón por la cual las intersecciones se mueven a lo largo de ambos ejes mientras que la pendiente se mueve a lo largo de solo uno.
Benchmarks
Hicimos benchmark de tres checkpoints (MiMo-V2.5-Pro-FP4 + DFlash, Inkling-NVFP4 + MTP y Muse-Glimmer-30B + DFlash2) que anteriormente no podían usar AV en absoluto, junto con DSV4-Flash + DSpark + el estimador y DSV4-Flash + DSpark + la cabeza de confianza, como referencia. Las ganancias siguientes se capturaron con AV apagado vs encendido, temperature 1.0, top-p 0.95 y concurrencia 64, sobre cuatro conjuntos de datos.
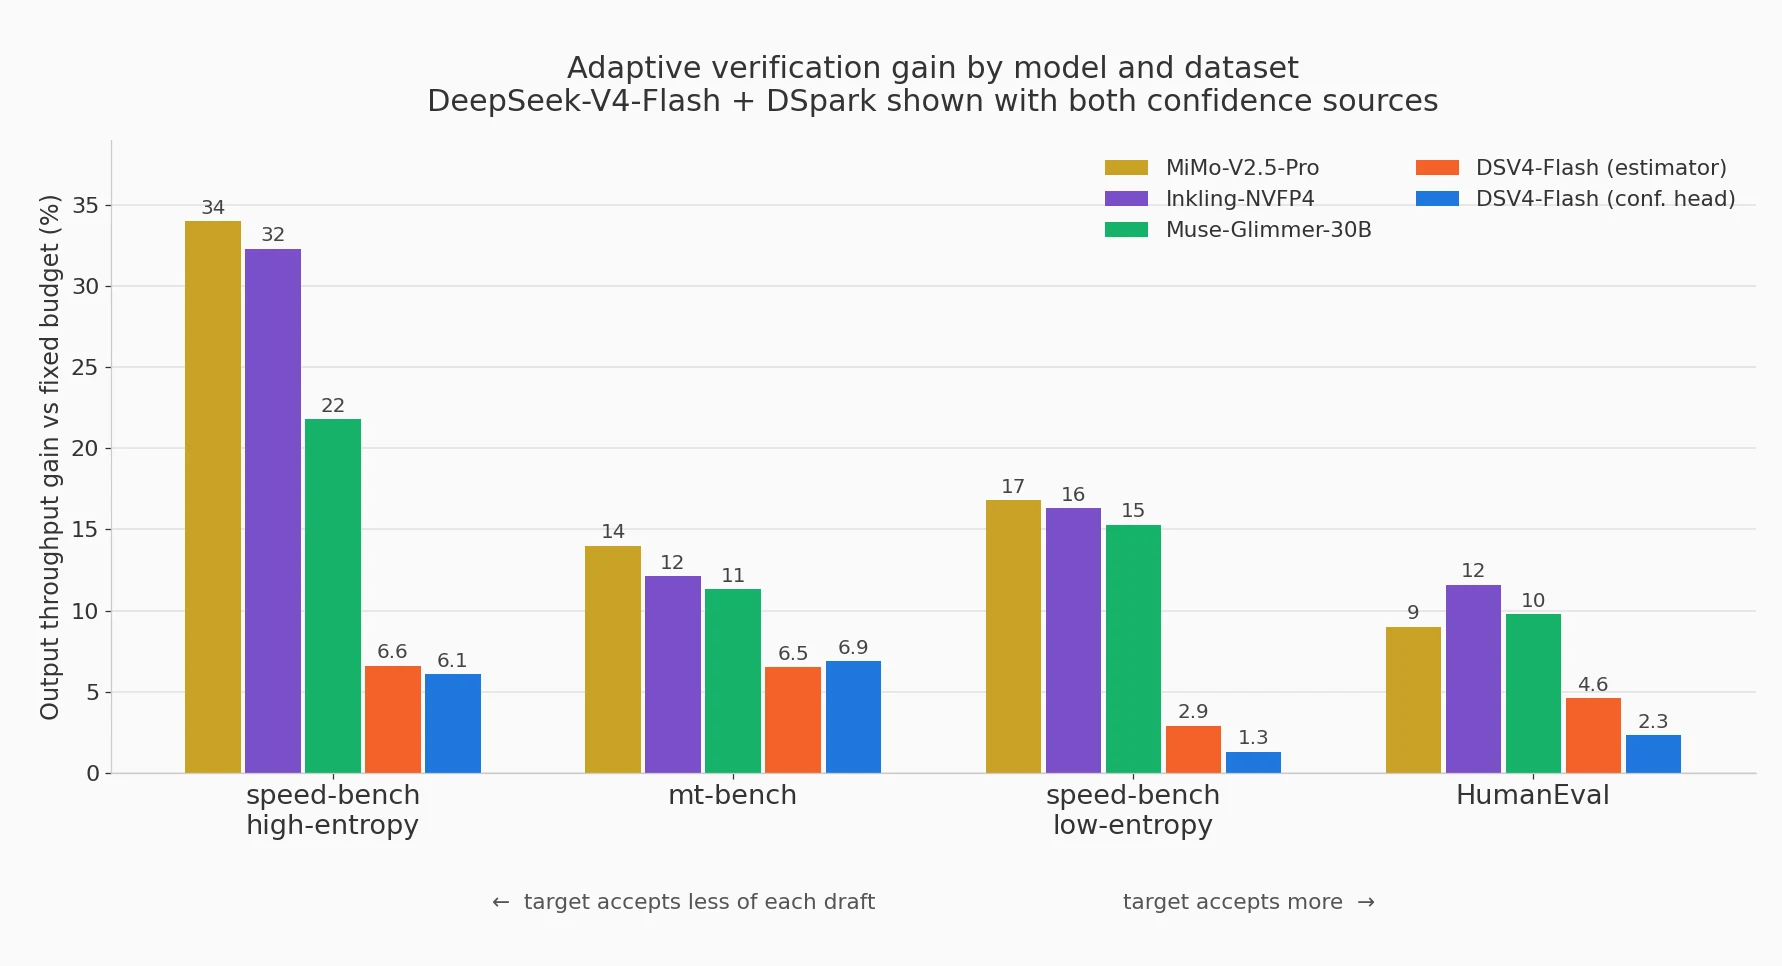
En comparación con la verificación fija, el estimador en línea con la misma longitud especulativa gana en todos los conjuntos de datos evaluados. Sin embargo, esa ganancia por sí sola no cuenta toda la historia. A menudo, se puede encontrar una longitud fija menor que supere a AV en la longitud especulativa máxima en concurrencias específicas. La curva de Pareto siguiente se capturó con DSV4 + DSpark en un barrido de longitudes especulativas fijas y AV en la longitud especulativa máxima:
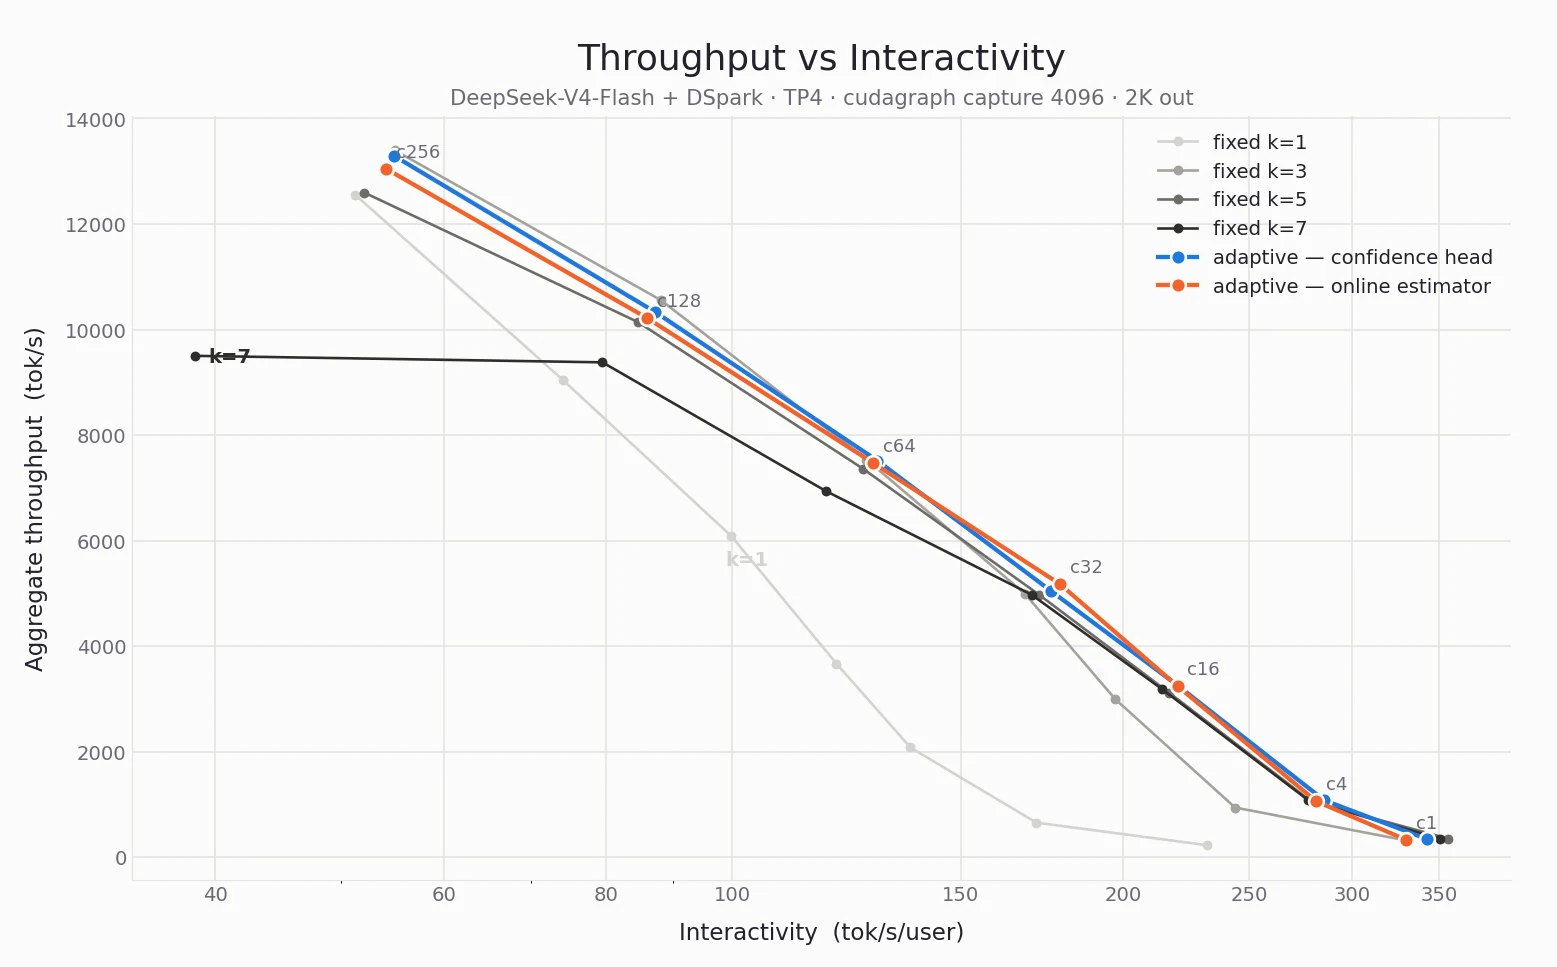
El estimador en línea y la cabeza de confianza están aproximadamente a la par en cuanto a rendimiento, en todas las concurrencias medidas. Sin embargo, el estimador en línea no está pensado para reemplazar a la cabeza de confianza, sino como una alternativa lista para usar en su ausencia. Veamos cómo se desempeña en un par de modelos que actualmente carece de cabeza de confianza. A continuación está la curva de Pareto para MiMo-V2.5-Pro-FP4 + DFlash en un barrido de longitudes especulativas fijas y AV:
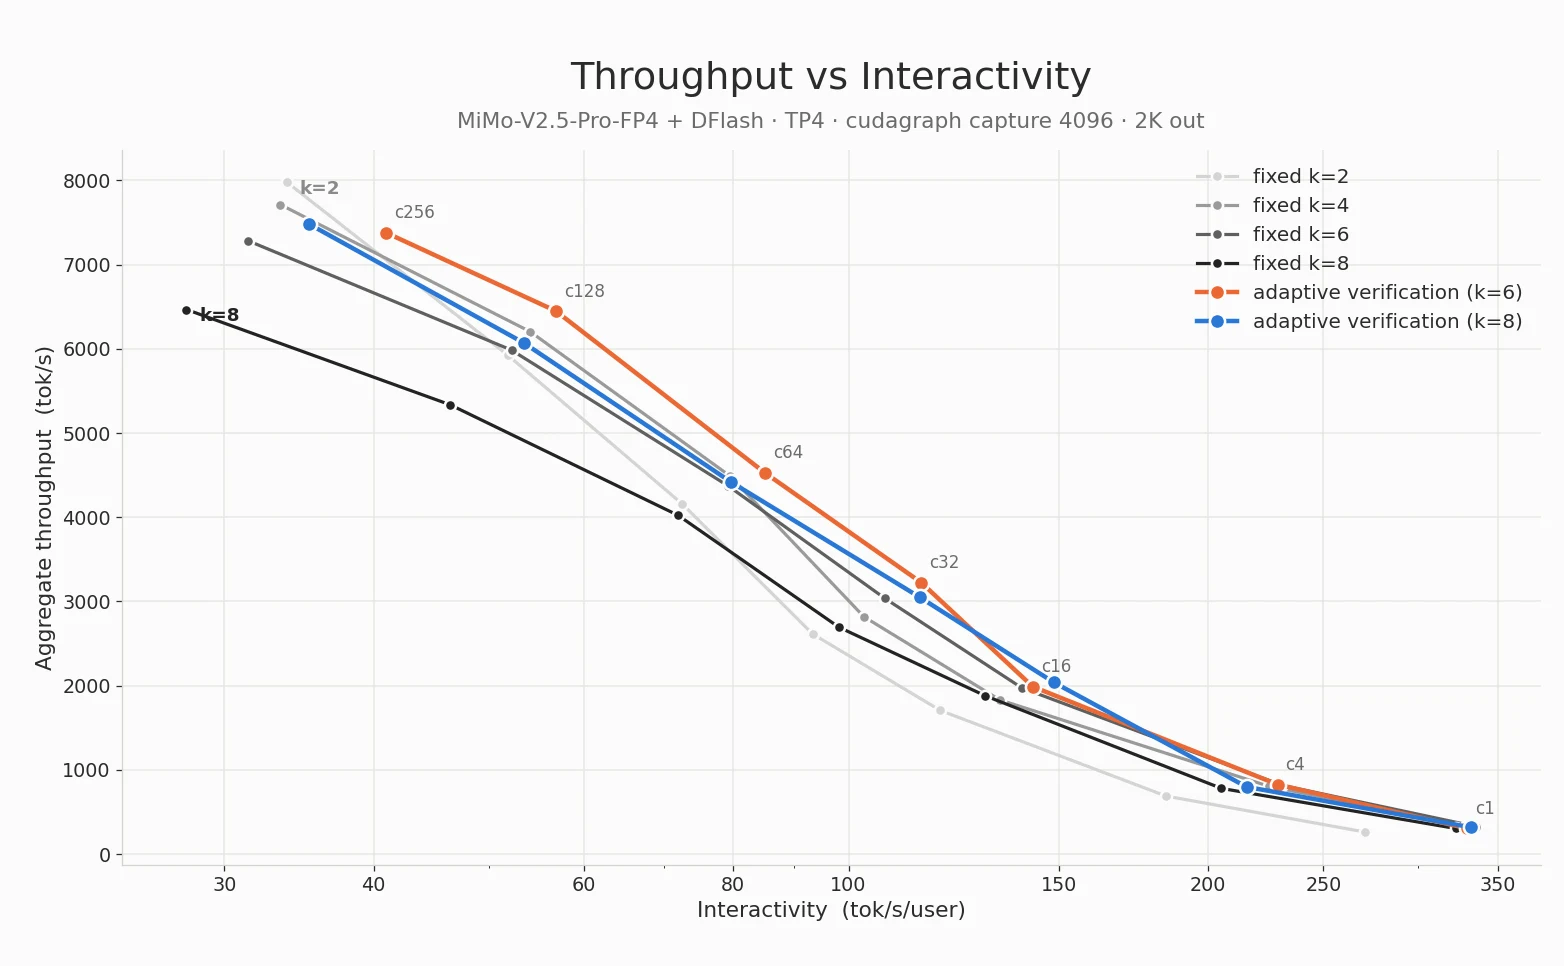
AV se sitúa en la frontera throughput-interactividad en 5 de 7 concurrencias.
Limitaciones
- El backend de atención del modelo objetivo debe admitir verificación de longitud variable. Este es el mismo prerrequisito que DSpark AV ya tiene.
- MTP y EAGLE se benefician menos de AV que DFlash y DSpark. Esto se debe a que esos especuladores autorregresivos pagan un costo proporcionalmente mayor por generar tokens que pueden recortarse antes de la verificación.
Uso de vLLM
AV se habilita a través de la configuración especulativa. En un modelo borrador que (1) no tiene cabeza de confianza y (2) admite atención de longitud variable en todos sus backends, el estimador en línea se selecciona automáticamente:
vllm serve <target_model> \
  ...
  --speculative-config '{
    "model": "<draft_model>",
    "method": "<method>",
    "num_speculative_tokens": <num_speculative_tokens>,
    "draft_sample_method": "probabilistic",
    "enable_adaptive_verification": true
  }'
Agradecimientos
Este trabajo fue realizado por Giancarlo Delfin (Inferact), y se basa directamente en Adaptive Verification de Lucas Wilkinson (Red Hat) y Benjamin Chislett (NVIDIA).
Notas al pie
-
Un ejemplo con un vocabulario simple de dos tokens [a, b] puede usarse para ilustrar este sesgo. Supongamos p = [0.5, 0.5], q = [0.2, 0.8], y que un token borrador se recorta de la verificación si q(x) < 0.5. Extraer a resulta en el recorte, y el objetivo muestrea un token de su propia distribución, p(x). Sin embargo, extraer b resulta en verificación: el token se acepta con probabilidad min(1, p(b)/q(b)) = 0.625, y en caso contrario se rechaza y se remuestrea de la norma residual max(0, p − q)) = [1, 0], produciendo a. Durante el muestreo por rechazo obtenemos pout(a) = q(a)·p(a) + q(b)·(1 − 0.625) = 0.4 y pout(b) = q(a)·p(b) + q(b)·0.625 = 0.6. Esto difiere de la distribución del objetivo de [0.5, 0.5] y viola la garantía de pérdida cero de la decodificación especulativa. ↩