
Puntos clave
- Las evaluaciones puntúan las ejecuciones de tu agente para que puedas comprobar que se comporta como esperas. Para empezar, elige un comportamiento, construye un pequeño conjunto de datos a partir de trazas reales y ejecuta una línea base. Usa evaluaciones offline antes de lanzar y evaluaciones online en producción, y convierte los nuevos fallos en ejemplos del conjunto de datos.
- Usa evaluadores de código donde puedas, jueces de LLM donde no puedas, y revisión humana para comprobar ambos. Para agentes que dan muchos pasos, evalúe los hilos completos, las trayectorias y el estado final.
- Benchmarks como Terminal-Bench son evaluaciones fuera de línea con tareas más largas y sus propios entornos. Harbor los ejecuta y registra los resultados en experimentos de LangSmith.
A medida que construyes y lanzas un agente, necesitarás una forma de comprobar que se comporta como esperas, tanto durante el desarrollo como cuando los usuarios reales empiecen a depender de él.
En el software tradicional, las mismas entradas producen las mismas salidas, por lo que una prueba unitaria puede verificar un resultado exacto. Los agentes son más difíciles de probar por varias razones:
- Las salidas varían entre ejecuciones, incluso para la misma solicitud
- Puede haber más de una respuesta correcta, por lo que buscar una coincidencia exacta se queda corto
- El agente elige sus propios pasos, por lo que una salida correcta aún puede provenir de un camino «incorrecto». Por ejemplo, un agente podría llamar a una herramienta que no necesita o realizar una acción sin el permiso del usuario.
Las evaluaciones de agentes son la solución. Puntúan las ejecuciones de tu agente con comprobaciones que tienen en cuenta estas variaciones. Al igual que los agentes que evalúan, estas pruebas no son únicas para todos, y el mejor conjunto de evaluaciones depende del equipo, de su producto y de aquello en lo que quieran optimizar.
Durante los últimos años trabajando en LangSmith, la plataforma de LangChain para ingeniería de agentes, nuestro equipo se ha encontrado con un mucho de diferentes preguntas de evaluación. Este blog repasa algunas de las preguntas más comunes sobre cómo empezar con las evaluaciones de agentes y los diferentes tipos de evaluaciones que puedes usar en tus flujos de trabajo.
¿Por dónde deberíamos empezar?
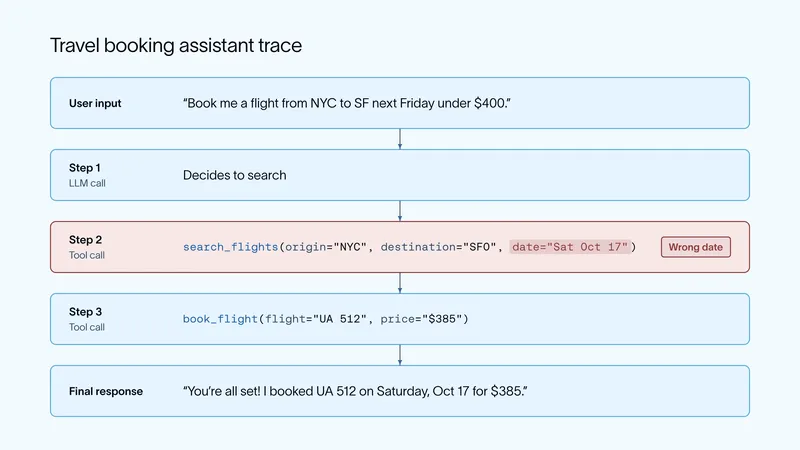
Toda evaluación comienza por entender qué hace realmente tu agente. Una traza es un registro de una ejecución de tu agente, incluyendo sus entradas, salidas y cada llamada al modelo y a herramientas intermedia. Lee una muestra de sus trazas para ver cómo maneja las solicitudes y dónde falla. Lo que descubras te indica qué probar primero. Empieza con algo pequeño.
- Elige un comportamiento que te importe. Por ejemplo, en el caso de un asistente de viajes, un comportamiento podría ser si reserva la fecha y el rango de precios que el usuario solicitó.
- Cree un pequeño conjunto de datos a partir de trazas. Un conjunto de datos es una colección de ejemplos, y cada ejemplo es un caso de prueba individual con una entrada y, a menudo, una salida esperada. De diez a veinte ejemplos de un comportamiento son suficientes para empezar, y en LangSmith puedes añadir trazas a un conjunto de datos directamente desde la vista de trazado. Si tu agente aún no está en producción, pide a tu equipo o a un pequeño grupo de socios de diseño de confianza que lo prueben (dogfooding) y trabaja a partir de esas trazas.
- Ejecuta una línea base. Ejecuta tu agente actual contra el dataset y guarda el resultado como un experimento. Un experimento contiene los resultados de ejecutar una versión de tu agente en un dataset, junto con las puntuaciones de tus evaluadores. Compararás el rendimiento de futuras versiones de tu agente con este experimento.
- Añade nuevos fallos a medida que los encuentres. Cada fallo que veas en producción o durante las pruebas se convierte en un nuevo ejemplo.
Sigue añadiendo fallos a tu conjunto de datos y tendrás un bucle de mejora. Encuentra un fallo, añádelo a tu conjunto de datos, mejora el agente y vuelve a ejecutar. A medida que identifiques más comportamientos del agente para evaluar, expandirás tu suite de evaluación siguiendo el mismo patrón descrito arriba.
¿Cuál es la diferencia entre las evaluaciones offline y online?
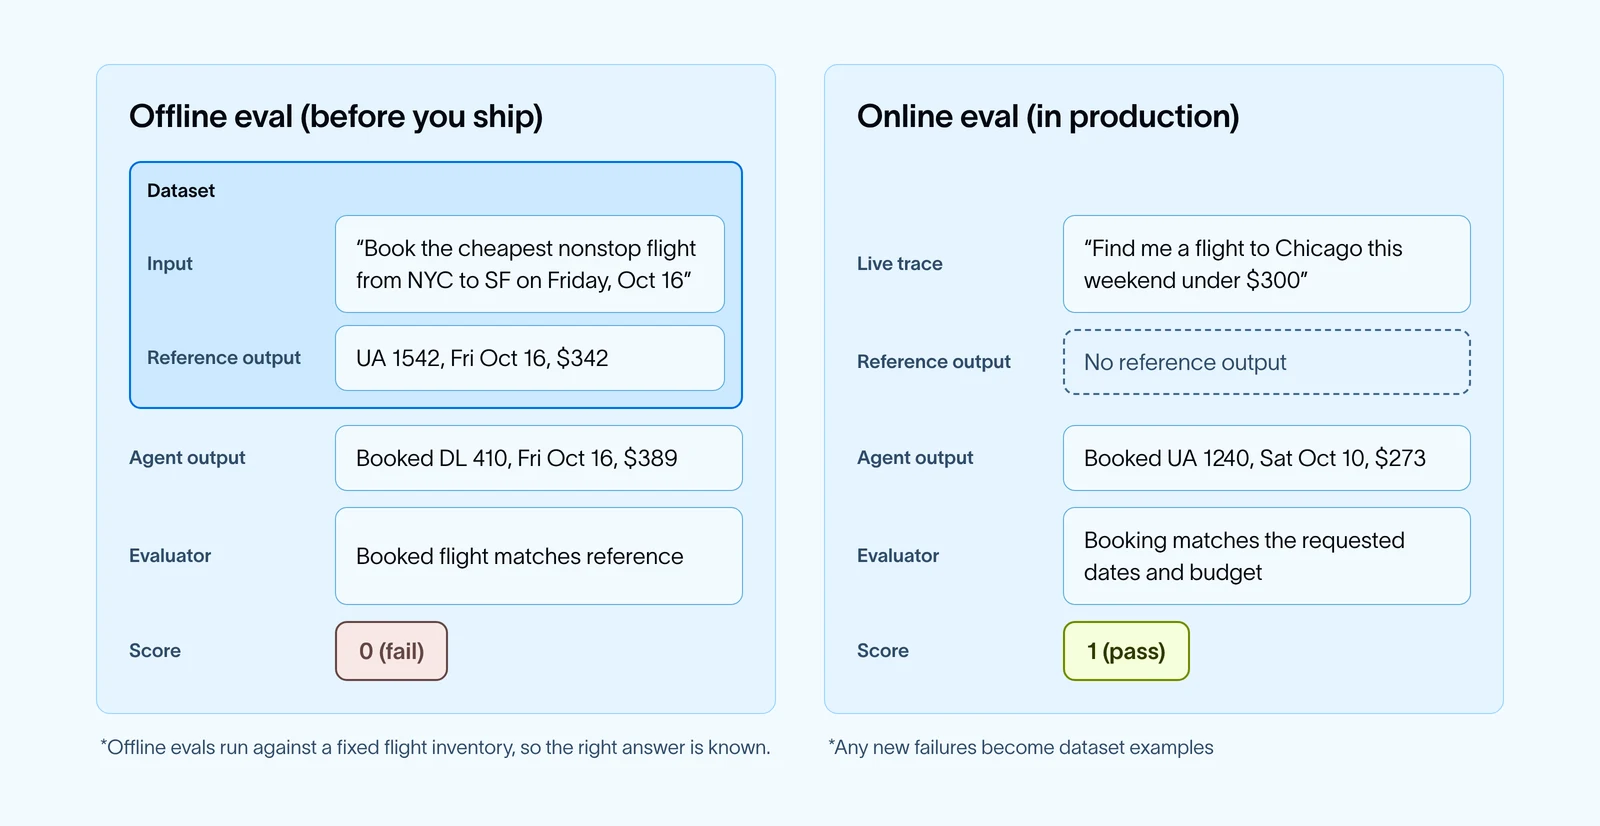
Las evaluaciones pueden y deben ejecutarse antes de publicar un cambio y después de que tu agente esté en producción. Antes de publicar, las evaluaciones pueden decirte si un cambio mejoró o empeoró al agente. Después de publicar, las evaluaciones pueden decirte cómo rinde el agente con usuarios reales.
Evaluaciones offline ejecutan tu agente contra un conjunto de datos antes de publicar un cambio. Tú eliges las entradas de ejemplo, y también puedes incluir salidas esperadas (también llamadas salidas de referencia). Usando tu conjunto de datos, puedes comparar resultados de experimentos entre versiones del agente. Se usan mejor para probar un nuevo prompt, modelo o herramienta, y para detectar regresiones antes de que lleguen a los usuarios.
Benchmarks como Terminal-Bench también son evaluaciones offline, construidos sobre un conjunto fijo de tareas para que puedas comparar agentes, modelos o versiones. Harbor los ejecuta y registra los resultados en experimentos de LangSmith, lo que cubrimos con más detalle abajo.
Evaluaciones online puntúan rastros reales de producción a medida que llegan. Normalmente no hay salida de referencia con la que comparar, por lo que dependen de comprobaciones de código y jueces LLM que pueden calificar una ejecución por sí mismos. Se usan mejor para monitorear la calidad y encontrar los problemas que tu conjunto de datos pasó por alto.
Necesitas ambas, y se alimentan mutuamente. Los fallos que las evaluaciones online señalan se convierten en nuevos ejemplos en tu conjunto de datos offline.
Hay varias formas de construir un conjunto de datos para evaluaciones offline en LangSmith. Puedes escribir ejemplos desde cero, añadir ejecuciones de tus rastros existentes, enviar ejecuciones que tu equipo revisó en una cola de anotación, subir un archivo CSV o JSONL, o generar ejemplos sintéticos a partir de algunos que ya tengas.
A medida que tu suite de evaluación crece, tendrás que decidir si añadir ejemplos a un dataset existente o crear uno nuevo. Como regla general:
- Mantén los ejemplos en el mismo dataset cuando prueban el mismo comportamiento con los mismos evaluadores, de modo que los experimentos sigan siendo comparables a lo largo del tiempo.
- Crea un dataset nuevo cuando las entradas se vean diferentes (como solicitudes individuales frente a conversaciones completas), cuando necesites evaluadores diferentes, o cuando el dataset sirva para un propósito distinto, como un conjunto pequeño que se ejecuta en cada pull request frente a uno más grande que ejecutas antes de un lanzamiento.
Dentro de un mismo dataset, también puedes usar splits para ejecutar un subconjunto de ejemplos.
¿Cuáles son los diferentes tipos de evaluadores de agentes?
Un evaluador es la lógica que puntúa una ejecución. Hay cuatro tipos comunes. La mayoría de los equipos empieza con uno o dos y añade más con el tiempo.
- Los evaluadores de código comprueban cosas de forma determinista, como si el precio reservado está por debajo del presupuesto del usuario. Son rápidos, baratos y consistentes, aunque su necesidad de entradas y salidas deterministas limita su utilidad.
- LLM-as-a-judge usa un modelo para calificar cosas que el código no puede, como si la respuesta del asistente confirma claramente los detalles del vuelo.
- La revisión humana hace que tu equipo o expertos en la materia puntúen las ejecuciones directamente. Es más lento, pero es la mejor señal para la calidad subjetiva y para verificar tus otros evaluadores. A menudo se usa en una muestra más pequeña para luego orientar el juicio de un evaluador LLM.
- Los evaluadores por pares comparan dos salidas lado a lado y eligen la mejor, lo cual es útil cuando estás eligiendo entre dos prompts o modelos.
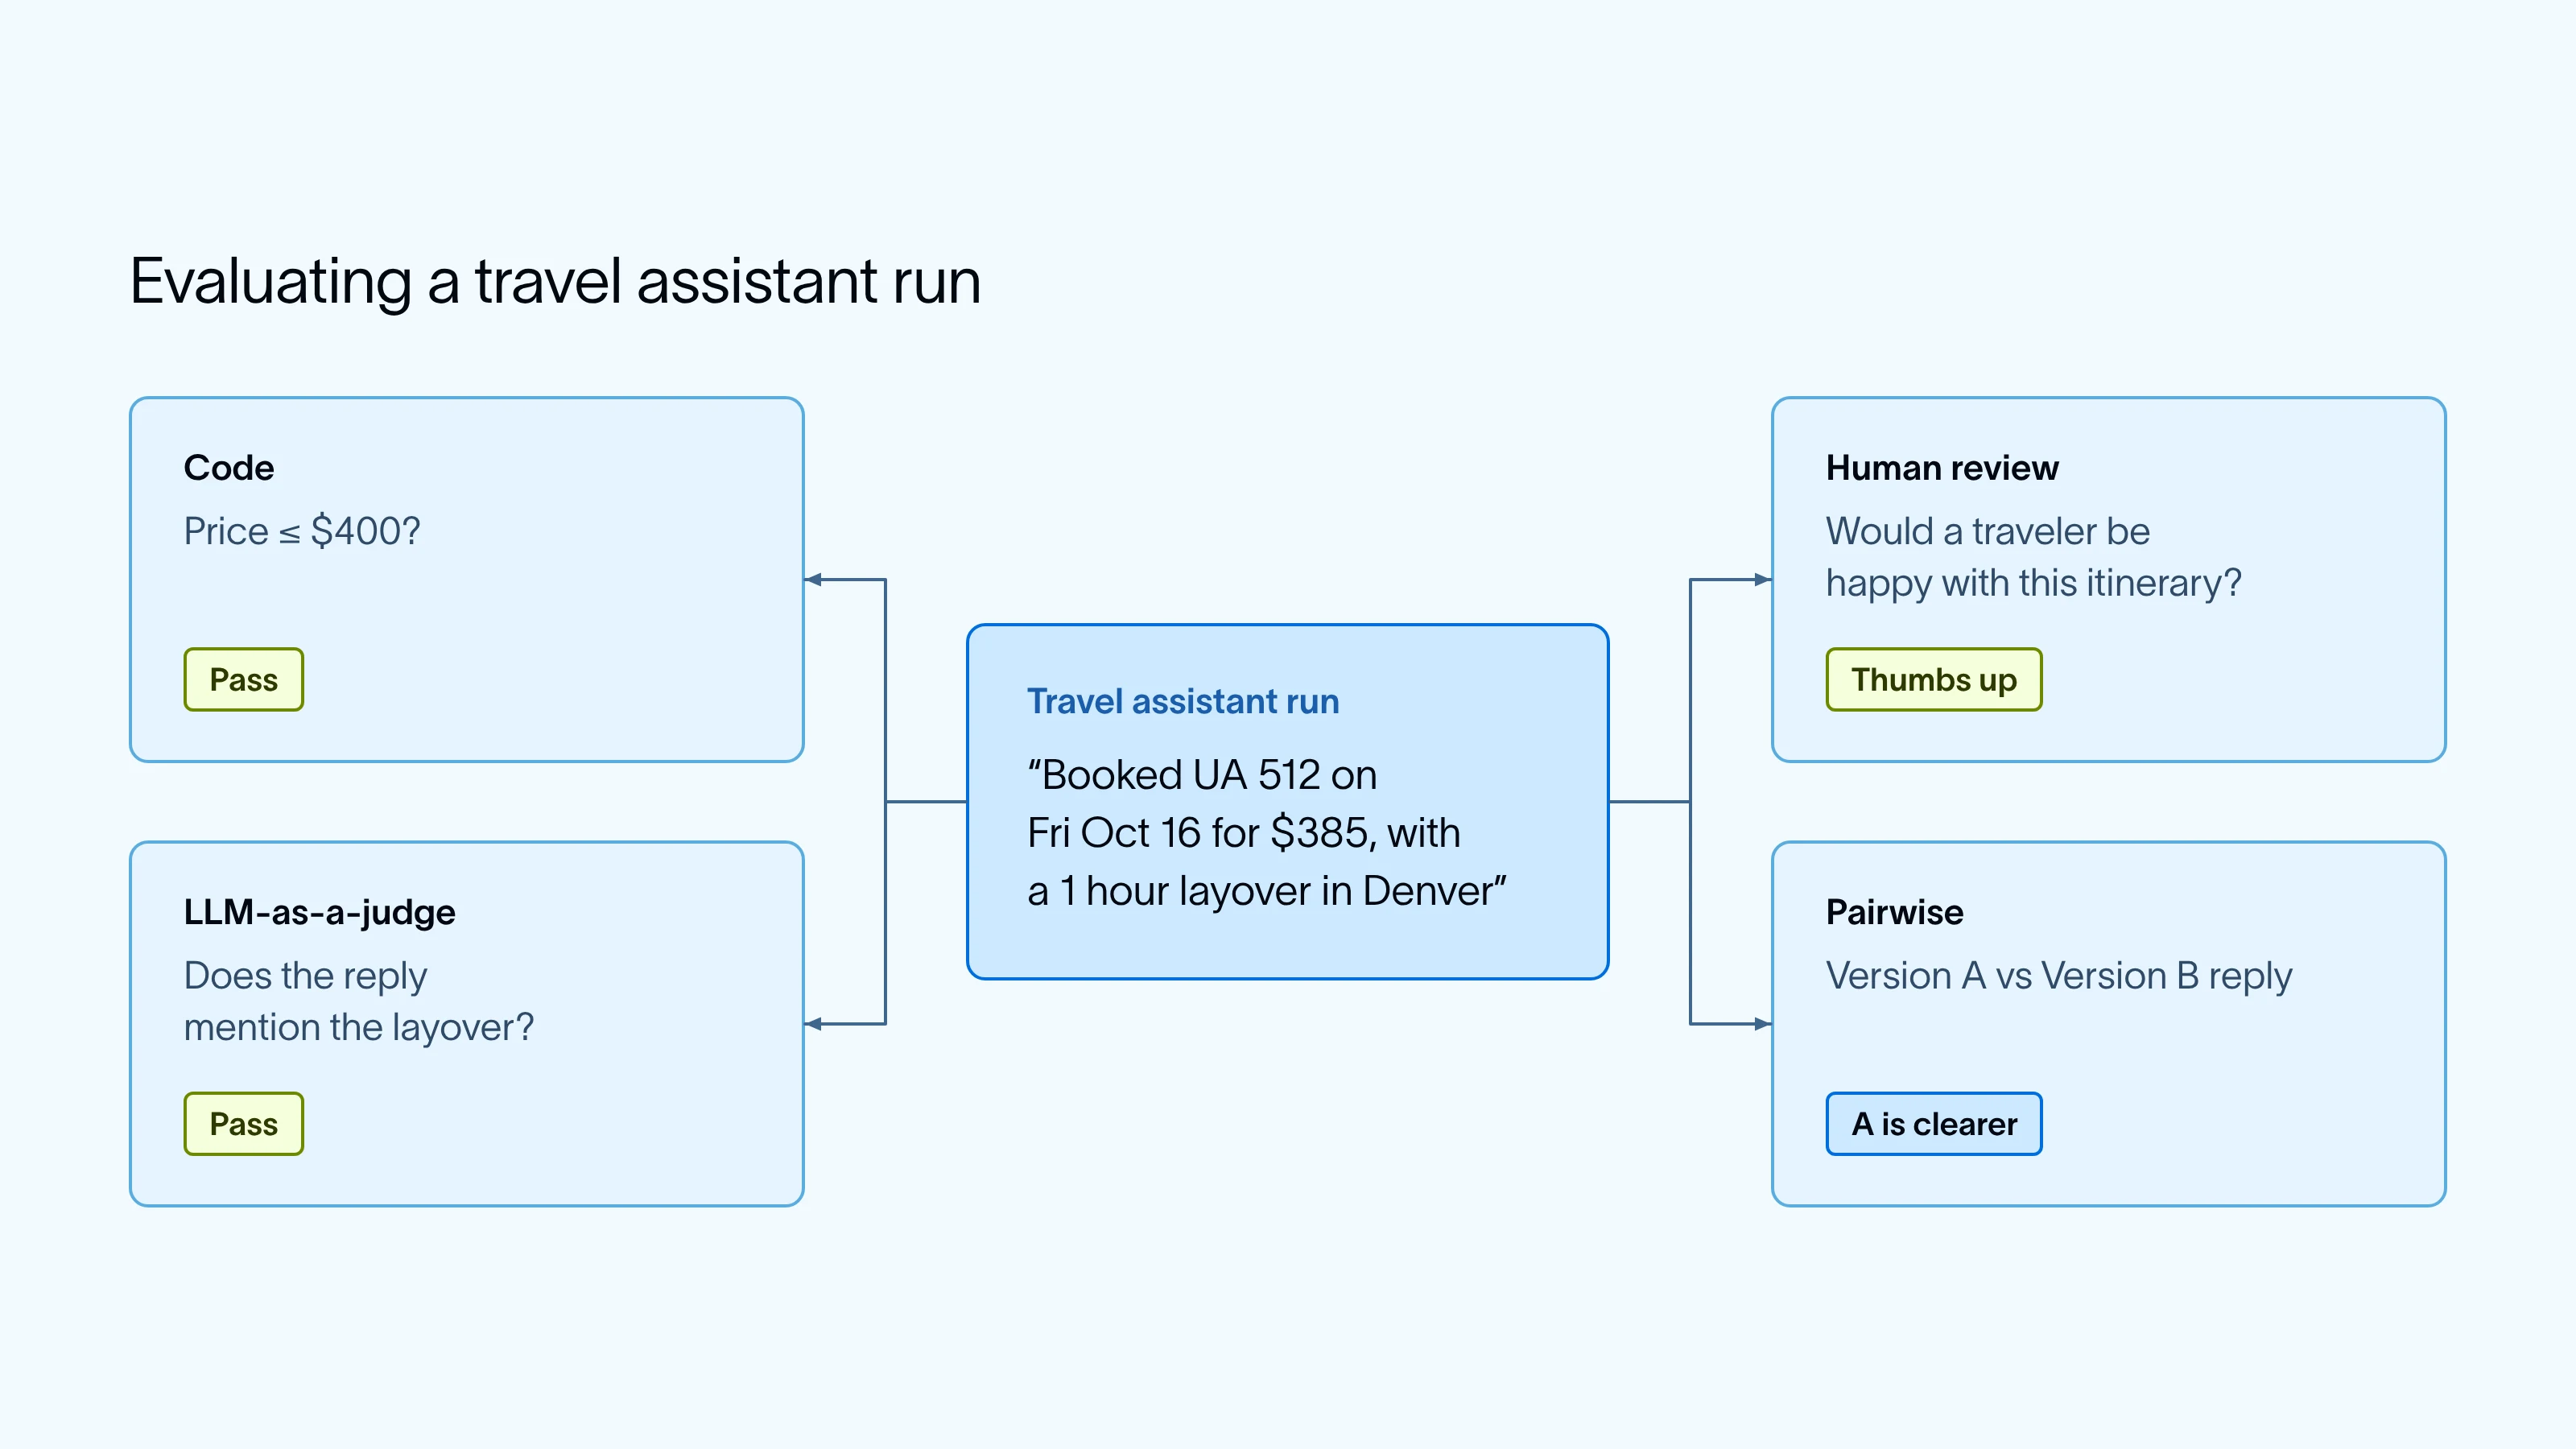
Cualquiera de estos evaluadores puede apuntar a diferentes partes de la ejecución de un agente. Una evaluación puede puntuar:
- Un solo paso. Ej. Si
search_flightsfue llamado con la fecha correcta. - La respuesta final. Ej. Si la respuesta confirma el vuelo que el agente realmente reservó.
- Una conversación completa. Ej. Si la reserva final refleja cada cambio que el usuario pidió a lo largo de varios turnos
- El estado final de un entorno. Ej. Los registros de reservas en un sistema de reservas simulado después de que el agente se ejecuta en su propio contenedor. Los benchmarks a menudo usan esta configuración, y a veces escucharás que se les llama evaluaciones contenerizadas.
¿Puedes confiar en un juez LLM?
Un juez LLM usa un modelo para calificar salidas que son difíciles de comprobar con código, como si una respuesta está respaldada por los documentos recuperados. Los jueces son flexibles, pero pueden ser inconsistentes y desviarse del juicio de tu equipo. Algunos hábitos los hacen confiables:
- Compara al juez con puntuaciones humanas. Haga que alguien de su equipo califique una muestra de ejecuciones y verifique dónde no está de acuerdo el juez. Ajuste el prompt o los ejemplos del juez hasta que coincidan. Las colas de anotación en LangSmith facilitan esto. Nuestra documentación de LLM-as-a-judge le guía en el proceso.
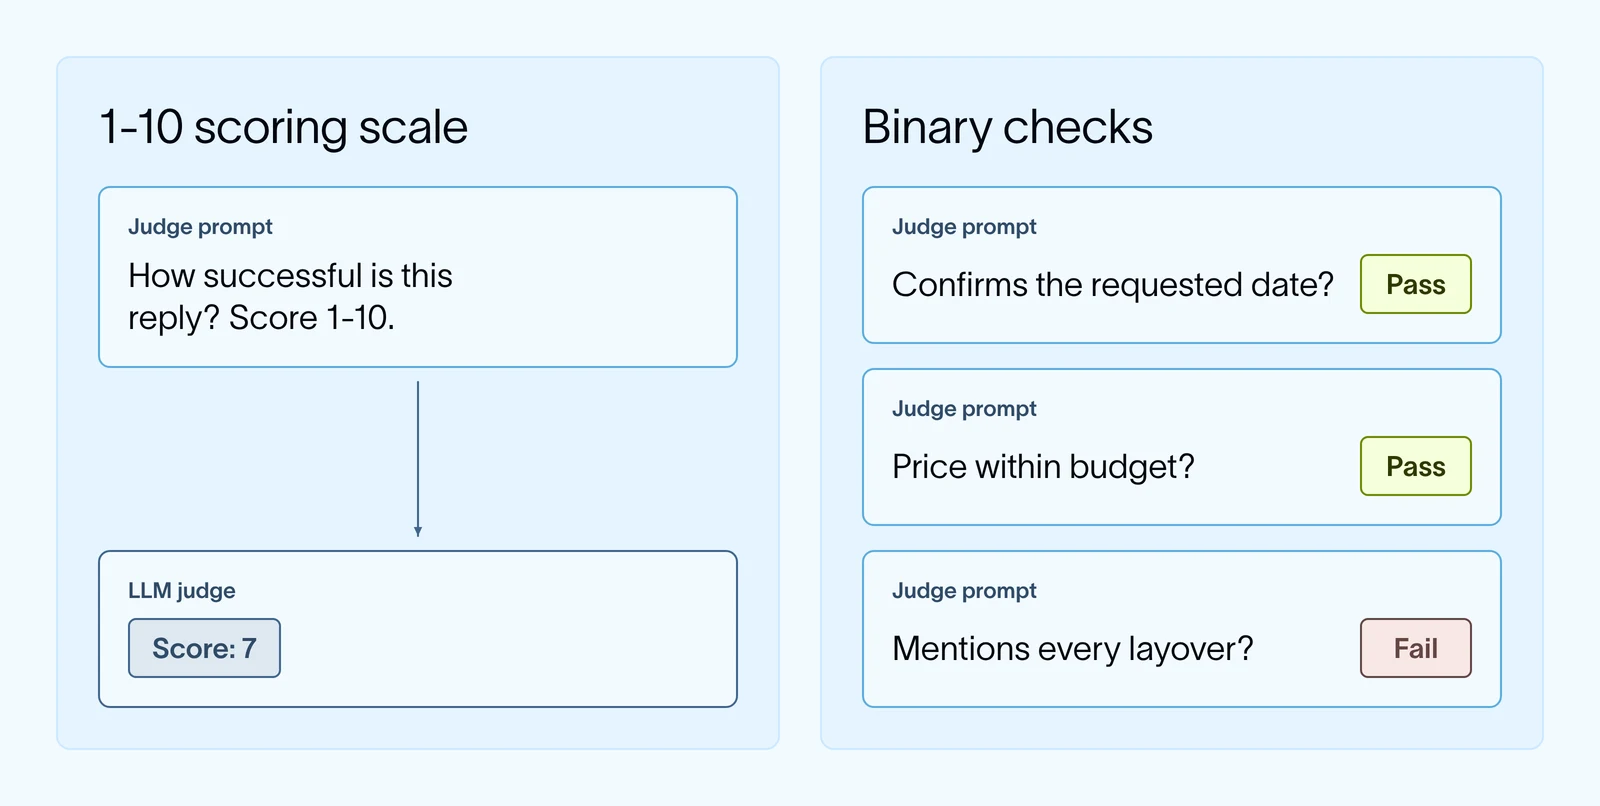
- Haga preguntas acotadas. En nuestro ejemplo de agente de viajes, preguntar "¿La respuesta menciona cada escala?" es más fácil de juzgar que "¿Es esta una buena respuesta?"
- Defina una escala de puntuación precisa. Un binario de aprobado o reprobado, o un conjunto pequeño de categorías etiquetadas, es mucho más reproducible que puntuar en una escala de 1-10. A un juez puede resultarle difícil distinguir entre una puntuación de 6 frente a 7.
¿Las evals son lo mismo que los benchmarks?
Un benchmark es un tipo de eval offline compuesto por un conjunto de tareas. Una tarea es un caso de prueba individual en un benchmark, que incluye instrucciones, un entorno en un contenedor y un script de prueba que puntúa el resultado. A medida que los agentes se vuelven más capaces, un simple juez LLM o una eval basada en código a menudo no es suficiente. Los agentes ahora pueden ejecutar código, editar archivos e interactuar con servicios. Para modelar este comportamiento de varios pasos, los benchmarks configuran infraestructura aislada en contenedores. Esto permite a los desarrolladores probar el comportamiento del agente offline de la misma manera en que el agente funcionará en producción.
Los benchmarks difieren de los jueces LLM más simples y de las evals basadas en código de varias maneras:
- Las tareas implican más pasos. Para completar una sola tarea, un agente podría instalar paquetes, editar archivos y ejecutar comandos a lo largo de decenas de llamadas a herramientas.
- Cada tarea viene con un entorno. Los agentes ahora pueden realizar acciones en entornos como un sandbox con un repositorio de código, archivos y herramientas. Cada tarea incluye su propio entorno aislado para que el agente trabaje en él.
- La puntuación verifica lo que hizo el agente. Un script de prueba inspecciona el estado del entorno después de la ejecución, como si las pruebas pasan o si existe el archivo correcto. Todavía puede revisar la traza, pero la puntuación proviene de las acciones que realizó el agente y del estado que dejó.
Para nuestro asistente de viajes, una tarea de benchmark podría darle al agente un sistema de reservas simulado y una solicitud como "Una tormenta canceló el vuelo del viajero a Denver. Cámbiele la reserva y mueva su hotel para que coincida." Una vez que el agente termina, el script de prueba verificaría los registros de reservas en la base de datos.
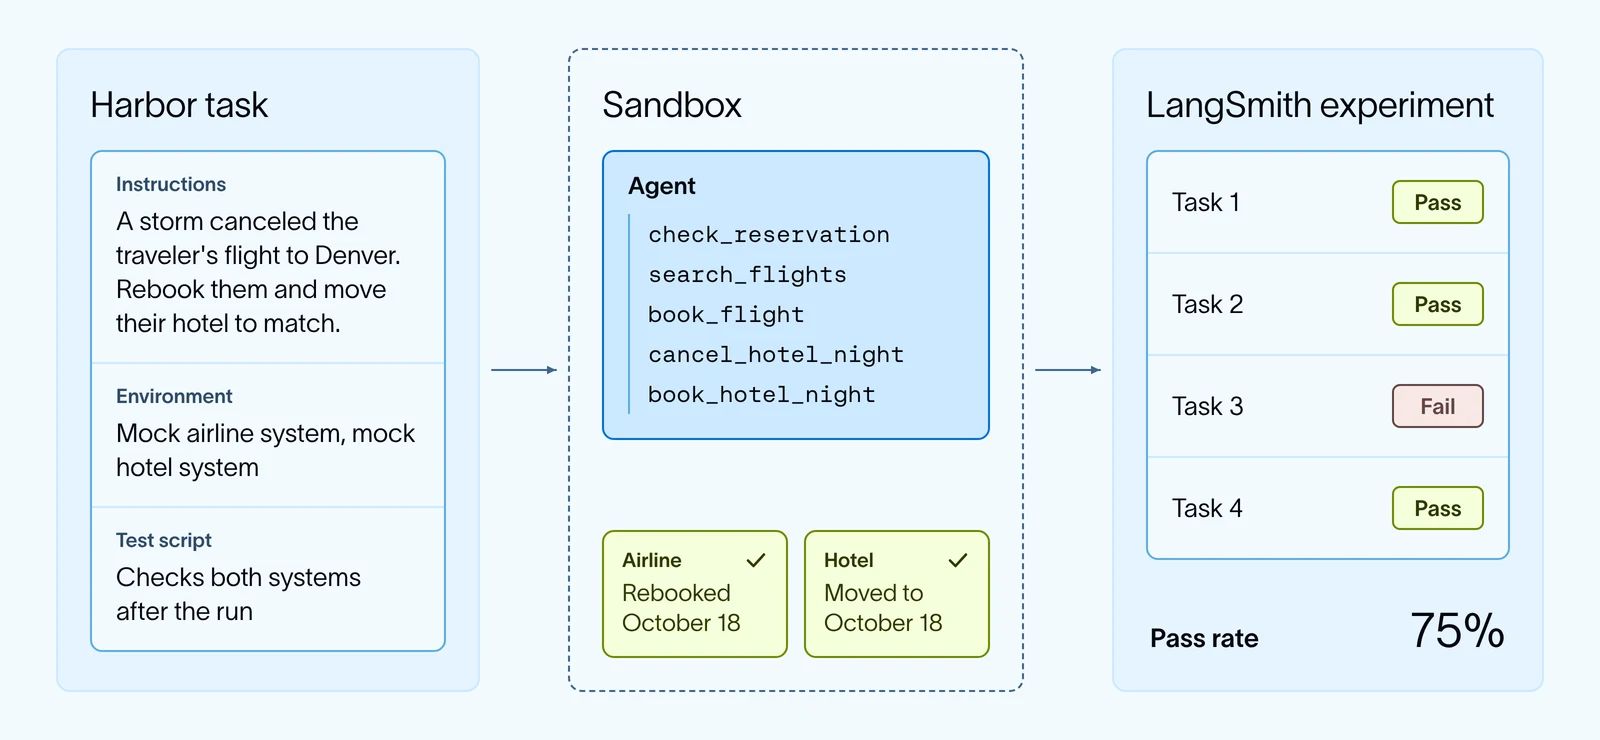
Puerto es un arnés de evaluación de código abierto que proporciona la estructura para realizar pruebas en estas tareas más largas. Es el framework que impulsa Terminal-Bench, y puedes usar el mismo formato de tarea para construir un benchmark para tu propio agente. Con la integración de LangSmith, cada ejecución de Harbor se registra como un experimento de LangSmith. Harbor crea un contenedor para cada tarea, y puedes usar los trazas de LangSmith para acercar cada entorno a lo que tu agente ve en producción. Los resultados del benchmark quedan así junto al resto de tus evaluaciones, y puedes abrir cualquier ejecución para ver la traza completa junto a su puntuación.
Usamos esta configuración para mejorar Deep Agents en Terminal-Bench 2.0 revisando rastros para encontrar modos de fallo y luego modificando el arnés de pruebas. También lo usamos para construir IssueBench, un benchmark para LangSmith Engine. Cada tarea de IssueBench le da a Engine un lote de trazas y evalúa si agrupa las correctas en los clústeres de problemas adecuados.
Construir un benchmark para tu propio agente sigue los mismos pasos que las evaluaciones anteriores, con algunos cambios:
- Recopilar tareas a partir de trazas. Encuentra fallos en los trazos de LangSmith y convierte cada uno en una tarea de Harbor con su propio entorno, como un sistema de reservas simulado con las reservas de un usuario.
- Defina cómo luce "bueno". Cree jueces LLM o evaluaciones basadas en código que puntúen según su rúbrica.
- Escalada en la puntuación. Ejecuta el agente y usa las puntuaciones para hacer pruebas A/B de los cambios. Puedes configurar un bucle de agente que ejecute este proceso por ti. Haría modificaciones en tu agente, volvería a ejecutar el benchmark, y conservaría o revertiría cada cambio, de manera similar al de Andrej Karpathy. autoresearch bucle de hace unos meses.
¿Cómo se puede evaluar el tráfico de producción sin altos costos?
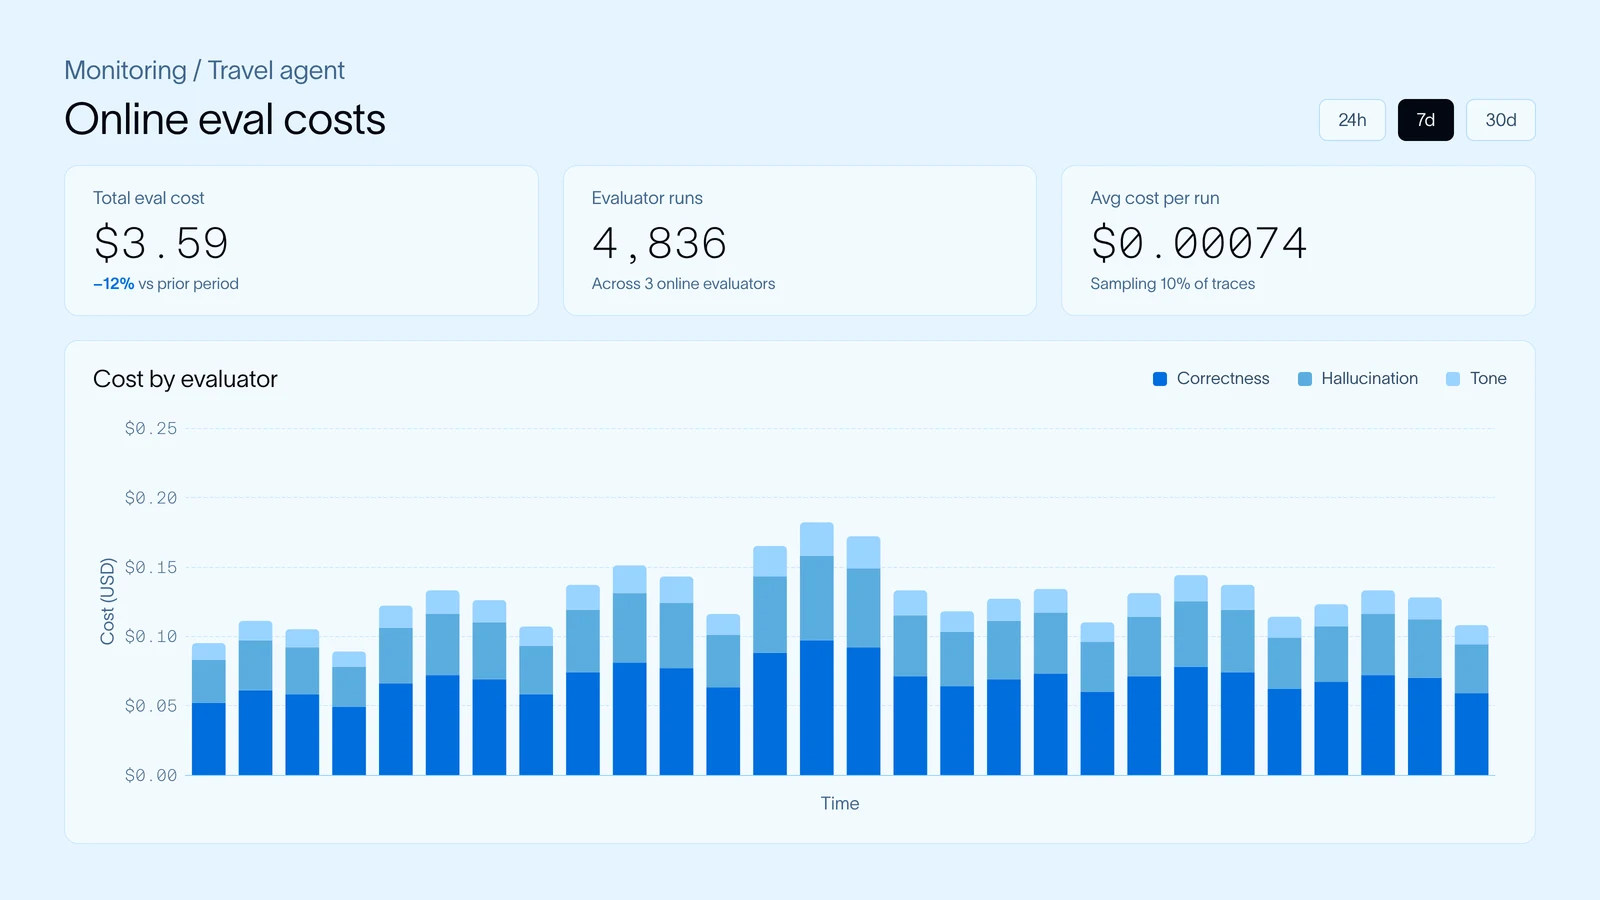
Las evaluaciones sin conexión se ejecutan sobre un conjunto de datos fijo, por lo que su costo es predecible. Las evaluaciones en línea se ejecutan sobre tráfico en vivo, por lo que si un juez LLM puntúa cada traza, tus costos de evaluación crecen con cada nuevo usuario. Para mantenerlas asequibles:
- Muestra y filtra. Evaluadores en línea en LangSmith puede evaluar un porcentaje del tráfico, o solo los traces que coincidan con un filtro como comentarios negativos de usuarios.
- Utilice comprobaciones de código donde pueda. Verificar si la reserva coincide con la fecha solicitada, o si el agente buscó antes de reservar, cuesta casi nada.
- Usa un juez más barato. En nuestro Jev-como-juez experimento, Jev de TypeSafe AI igualó las etiquetas humanas en cada decisión de aprobación/rechazo y costó $0.34 en total, en comparación con $28.17 de Claude Sonnet 4.6.
Los costes de evaluación en línea se guardan con el tiempo en LangSmith, de modo que los equipos pueden monitorear su gasto.
¿Tienes que construir tus propias evaluaciones de agentes?
No, especialmente cuando se está evaluando problemas comunes de agentes. Un buen punto de partida es nuestro plantillas predefinidas de evaluadores de LLM en LangSmith para verificaciones típicas como alucinaciones o fugas de PII. Añade uno a un conjunto de datos o a un proyecto de trazas y edita su prompt para que se ajuste a tu agente, por ejemplo, indicándole al juez que nuestro asistente de viajes nunca debe reservar fuera del presupuesto del usuario.
Nuestro paquete de código abierto agentevals también incluye evaluadores preconstruidos para los mensajes y las llamadas a herramientas de un agente. Pueden comparar las herramientas que llamó tu agente con una lista de referencia, o pedirle a un LLM juez que determine si los pasos tuvieron sentido.
También puedes reutilizar un evaluador sin conexión en varios conjuntos de datos y ejecutarlo como evaluador en línea sobre trazas de producción (solo funciona si el evaluador no requiere una salida de referencia).
Para evaluaciones específicas de tu agente, la Eval Engineering Skill se ejecuta en agentes de codificación como Claude Code o Codex, lee tu repositorio y tus trazas, y escribe evaluaciones ejecutables junto contigo.
LangSmith Engine también puede escribir evaluaciones automáticamente extrayendo información de trazas de producción. Cuando identifica un grupo de problemas, convierte las trazas fallidas en ejemplos de conjuntos de datos y escribe sus salidas de referencia como assertions, como «Reserva un vuelo en la fecha que solicitó el usuario».
¿Cómo se evalúan las conversaciones de varios turnos?
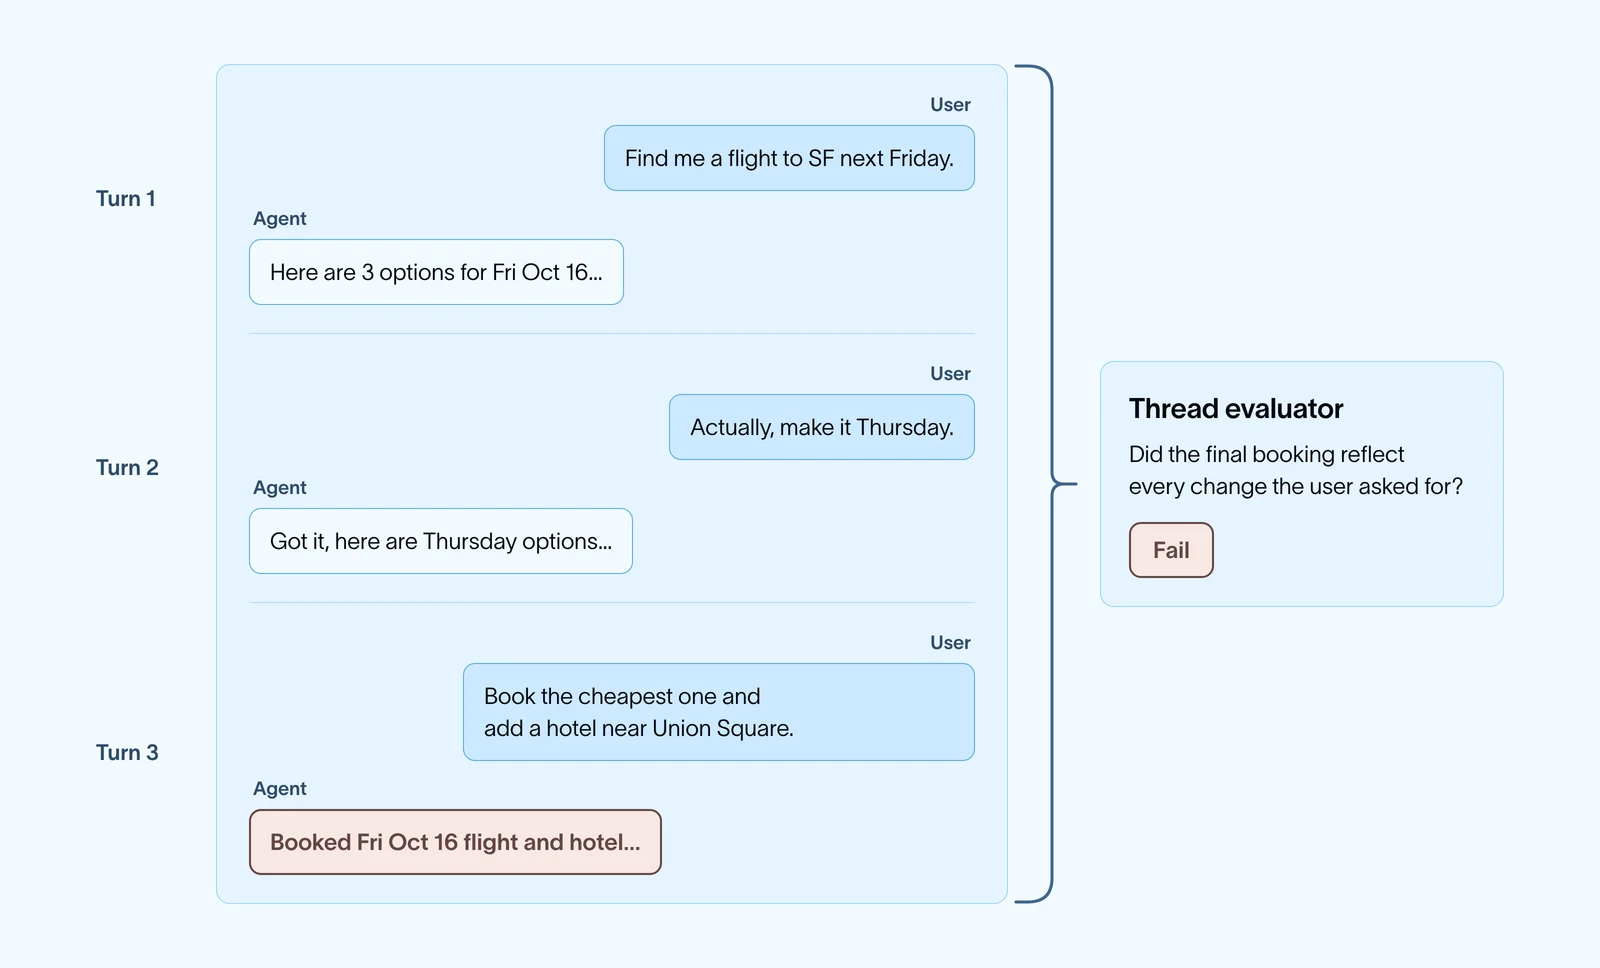
Muchos agentes trabajan a lo largo de varios turnos. Por ejemplo, un usuario puede pedirle a nuestro asistente de viajes vuelos, cambiar la fecha y luego añadir un hotel. Cada turno puede parecer correcto por sí solo mientras la conversación en su conjunto sale mal.
Para evaluar conversaciones en LangSmith, pasa un ID de hilo en los metadatos de tu traza para que cada turno se agrupe en un hilo. Un hilo es una secuencia de trazas de la misma conversación. Desde ahí puedes adjuntar evaluadores en línea que puntúan un hilo completo una vez que termina la conversación, con preguntas como "¿La reserva final reflejó cada cambio que el usuario solicitó?" o "¿El usuario tuvo que repetirse?". LangSmith también muestra cada hilo como una trayectoria, con cada mensaje y llamada a herramientas listados una vez, en orden.
Para las evaluaciones offline, puedes almacenar conversaciones completas como ejemplos en un dataset, o simular al usuario con un LLM para poder probar cómo maneja el agente una conversación de principio a fin.
¿Cómo evalúas un agente más allá de su salida final?
Los agentes realizan muchos pasos, por lo que la respuesta final solo muestra una parte de lo que ocurrió. Más allá de la respuesta final, es posible que quieras verificar:
- La ruta, es decir, la secuencia de mensajes y llamadas a herramientas que el agente produjo.
- El estado final, como el registro de reserva que creó nuestro agente de viajes, un archivo que escribió o un cambio que hizo en un repositorio.
A medida que tus agentes en producción se vuelven cada vez más complejos, es posible que necesites un harness de evaluación dedicado. Específicamente, cuando el trabajo del agente es el cambio que realiza en un entorno. Digamos que se le pide a un agente de código corregir un error. Un juez LLM puede leer la respuesta del agente, pero la verificación confiable es ejecutar las pruebas del repositorio después de que el agente termina. Para que eso funcione, cada ejecución de pruebas necesita su propia copia limpia del repositorio para que las ejecuciones no se afecten entre sí. Harbor configura esto por ti. Puedes ejecutar agentes construidos con Deep Agents en LangSmith Sandboxes y registrar cada ejecución, junto con su traza, en un experimento de LangSmith. Aprende más en Harbor x LangChain.
¿Puedes trazar y evaluar un agente en LangSmith si no está construido usando LangChain, LangGraph o Deep Agents?
¡Sí! LangSmith es agnóstico al framework, por lo que puedes trazar y evaluar un agente construido con cualquier framework, o sin framework alguno. Hay varias formas de enviar trazas:
- Integraciones de frameworks. LangSmith tiene integraciones para frameworks de agentes populares como OpenAI Agents SDK, Claude Agent SDK, y más.
- Wrappers de proveedores de modelos. Si llamas a un proveedor de modelos directamente, envuelve el cliente para OpenAI o Anthropic y cada llamada al modelo se rastrea.
- El
@traceabledecorador. Añádelo a tus propias funciones, como la herramienta de búsqueda de vuelos del asistente de viajes, para rastrear cualquier paso de tu agente.
Una vez que tus trazas están en LangSmith, las evaluaciones funcionan de la misma manera para cualquier framework. Puedes añadir trazas a un dataset, ejecutar experimentos sin conexión pasando tu agente a la función del SDK, evaluate() y adjuntar evaluadores en línea al tráfico de producción.
¿Cómo migras desde una pila de evaluación existente?
No tienes que empezar de cero. La mayoría de lo que ya has construido se traslada a LangSmith:
- Datasets. Sube los casos de prueba existentes como un archivo CSV o JSONL, o créalos con el SDK.
- Evaluadores de código. Las funciones de puntuación existentes normalmente solo necesitan pequeños cambios para ejecutarse como evaluadores de LangSmith. Si tus evaluaciones ya se ejecutan como pruebas, las integraciones de pytest y Vitest te permiten mantener esa configuración.
- Jueces LLM. Pega tu prompt de juez existente en un evaluador LLM-as-a-judge en la interfaz, o consérvalo en código.
- Trazado. LangSmith funciona con cualquier framework, por lo que puedes enviar trazas desde tu agente actual sin reescribirlo.
¿Cómo reportas los resultados?
Los experimentos sin conexión muestran si cada versión mejoró. Los paneles de evaluación en línea muestran cómo se mantiene el rendimiento en producción a lo largo del tiempo. En LangSmith, puedes comparar directamente los resultados de los experimentos y crear paneles personalizados para métricas como el coste de tokens, la latencia y las puntuaciones de los evaluadores a lo largo del tiempo. Un benchmark te da una puntuación estable para comparar modelos o versiones de agentes entre versiones.
Siguiente
Si quieres profundizar más, lee How We Build Evals for Deep Agents, prueba la guía rápida de evaluación de LangSmith, o consulta nuestro curso de LangChain Academy sobre LangSmith Essentials.
¿Prefieres un instructor en vivo? Organizaré un taller virtual sobre evaluaciones de agentes el 28 de octubre de 2026. Regístrate aquí!