
Por Jay desde QbitAI de Feisitemplo | Cuenta pública QbitAI
No er... ¿Acaso volviste del futuro?
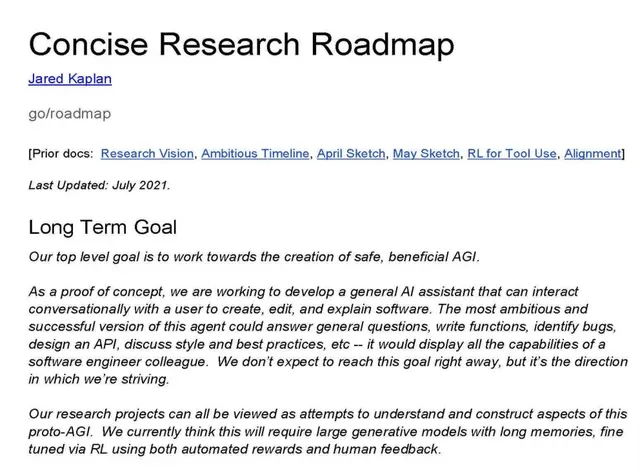
Recientemente, a causa de una demanda por derechos de autor, se expuso accidentalmenteHoja de ruta de investigación interna del mes 7 de 2021de Anthropic.
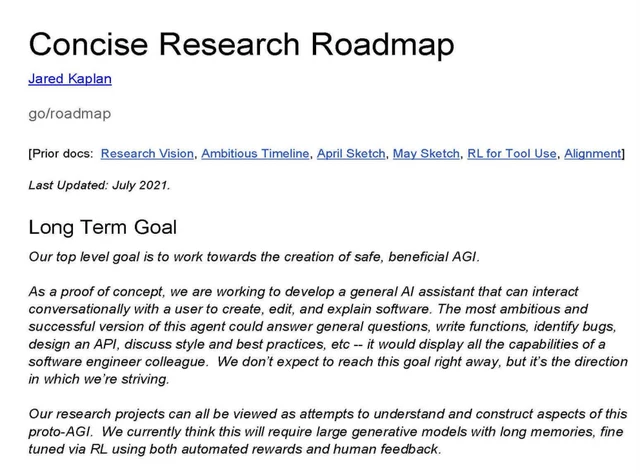
Es muy breve: el cuerpo del PDF son solo dos o tres páginas.
Pero al leer de principio a fin este documento que en su momento estaba marcado como «ultrasecreto», me quedé sin fuerzas.
El Claude Code de hoy, la invocación de herramientas (Tool Use), la autoevaluación de la IA (Self-Judging), el cómputo en tiempo de prueba (Test-time compute), e incluso billones de parámetros y contextos ultralargos…
Hace cinco años, cuando esta empresa apenas llevaba unos meses separada de OpenAI y tenía poco más de una docena de empleados, todo eso ya estaba escrito negro sobre blanco.
El mapa de ruta de hace 5 años
Mucha gente cree que el paso de los grandes modelos de chatbots a agentes que escriben código y operan sistemas fue algo que surgió por inercia estos dos últimos años, una vez madurada la tecnología.
Error.
Al comienzo de este mapa de ruta de 2021, Anthropic fijó para su objetivo final (Safe, beneficial AGI) una posición de prototipo muy clara:
crear un asistente de IA general capaz de interactuar con los humanos mediante lenguaje natural para crear, editar y explicar software.
¿Qué significa un asistente de IA general?
Capaz de responder preguntas generales, escribir funciones, encontrar bugs, diseñar API y debatir sobre estilo de código y mejores prácticas.
Lo más impactante es la frase que viene después:
debe demostrar toda la capacidad de uncolega ingeniero de software.
O sea, dejadme pensar... ¿esto no es exactamente Claude Code??
En aquel entonces, cuando GPT-3 apenas llevaba poco tiempo en auge y todos seguían asombrados de que la IA pudiera escribir acrósticos, Anthropic se saltó directamente la simple lógica de autocompletado de código y apuntó a un agente completo de ingeniería de software.
Y no solo eso: en cuanto a la vía de implementación concreta, internamente se desarrolló un debate sumamente apasionante.
El investigador Andy Jones planteó en un comentario la divergencia central: ¿deberíamos primero construir un asistente de programación verdaderamente útil, o demostrar primero la viabilidad de la invocación de herramientas?
En ese momento el equipo se enfrentaba a dos caminos:
Vía práctica: desarrollar la búsqueda en repositorios de código (Repo Search), para que la IA pudiera revisar las definiciones de tipos de los proyectos.
Tom Brown, primer autor del artículo de GPT-3, también participó en este debate y sugirió empezar por la exploración de repositorios de código (Repo Browsing).
Vía de investigación: hacer depuración con printf y operaciones de editor, para demostrar primero que el modelo puede invocar herramientas.
Al final, el CEO Dario tomó la decisión:
A corto plazo, primero validar la viabilidad de las llamadas a herramientas; a largo plazo, evolucionar hacia un asistente de programación súper útil.
Mirando ahora hacia atrás en el proceso de evolución de Claude Code, se está siguiendo exactamente, paso a paso, aquella frase de Dario de aquella época.
Autoevaluación (Self-judging), billones de parámetros y memoria ultralarga
Además de los Coding Agent, esta hoja de ruta también contiene previsiones sobre las tecnologías de base.
Por ejemplo, en la parte de preentrenamiento, ya en 2021 dejaron por escrito que iban a entrenar1T (1 billón de parámetros) o modelos superiores aún más grandes, y explorar contextos ultra largos (Very large contexts), u otros mecanismos capaces de albergar enormes cantidades de memoria y experiencia.
En una época en la que 175B seguía siendo un coloso, ellos ya consideraban los billones de parámetros y la memoria ultralarga como infraestructura básica.
Aún más sorprendente es la parte sobre retroalimentación humana y alineación (Alignment).
El documento dice claramente:
el modelo se juzga a sí mismo.
En 2021, ya investigaban cómo hacer que el modelo evaluara su propio comportamiento y la calidad de sus salidas, y cómo usar el juicio del propio modelo como señal de retroalimentación. Esta es precisamente la idea central del AI Feedback de hoy y de la autocorrección de los modelos de razonamiento.
Aún más interesante es que el documento incluso menciona un concepto que luego resultó sumamente importante en la investigación de grandes modelos:
Test-time compute (cómputo en tiempo de prueba).
Por supuesto, en aquel momento esta investigación se ubicaba en el contexto de los estudios de alineación y discriminadores, todavía bastante lejos de la expansión de cómputo de razonamiento estilo o1.
Pero al menos demuestra que ya en 2021, la visión de investigación de Anthropic abarcaba la inversión de cómputo más allá del entrenamiento del modelo.
Es decir, Neo Lab sí tenía cosas que ofrecer, no es de extrañar que Ilya quedara desmayado.
No sé qué estarán experimentando a diario los laboratorios de frontera actuales.
Momentos de sudor frío internos
Claro que, siendo una A\, no se puede evitar hablar de seguridad.
Pero al revisarlo descubrí que a esta gente de verdad le encanta debatir sobre seguridad, le dedicaron un espacio larguísimo.
Como una empresa que vive de la seguridad, Anthropic ya en 2021 previó la pesadilla a la que se enfrentaría hoy cuando los Agent corren por todas partes.
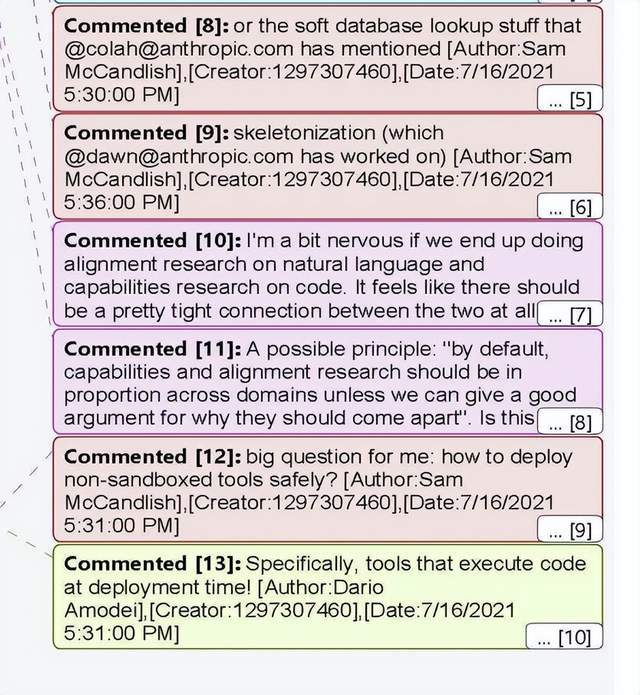
El cofundador Sam McCandlish planteó en sus anotaciones una pregunta existencial:
¿cómo desplegar de forma segura herramientas sin aislamiento de sandbox?
Dario respondió de inmediato rematando el golpe:
Concretamente, ¡las Tool que ejecutan código al desplegarse!
(pd: el original realmente tiene signo de exclamación, así de apasionado es tu Dario)
Increíble.
Cuando la IA realmente puede ejecutar código directamente en el entorno anfitrión, invocar la Shell y modificar archivos, si pierde el control o sufre una inyección de Prompt, las consecuencias son impensables.
La escalada de privilegios de Agent, la fuga del entorno y la contaminación de datos que hoy se debaten en toda la red, ellos ya discutían los límites del sandbox en 2021.
Quizás sea precisamente porque desde el principio querían tomar este camino.
Ah, Amanda también aparece en este informe; es esa filósofa interna de la empresa A que hace poco se hizo bastante popular.
Ella señala con mucha seriedad:
Si hacemos investigación de alineación sobre lenguaje natural, pero avanzamos principalmente en las capacidades del modelo sobre código, me preocupa un poco. Estos dos tipos de investigación deben mantenerse estrechamente vinculados en todo momento.
Si no hacemos investigación de alineación en los ámbitos donde se mejoran las capacidades, limitaremos la eficacia de las pruebas de alineación. Esto podría generar un efecto dominó, por ejemplo, que por no haberse integrado desde el principio, la investigación de alineación acabe convirtiéndose en una isla aislada.
Incluso propuso directamente establecer un principio de empresa:
La investigación de capacidades en todos los campos y la investigación de alineamiento deberían avanzar de manera proporcional y sincronizada, a menos que podamos dar razones sólidas de por qué separarlas.
One More Thing
Ay, yo ya decía que A\ por qué siempre les lleva la delantera a OpenAI, resulta que era la ventaja de llegar primero.
En estos cinco años, Anthropic se ha mantenido firme como una roca, obsesionada con señales de código de alta calidad, aprendizaje por refuerzo y flujos de trabajo empresariales;
mientras que OpenAI ha luchado en múltiples frentes: generación de imágenes a partir de texto, videos con Sora, asistentes de voz, búsquedas, lo que tanto dispersó sus fuerzas.
Sin embargo, justo cuando todos todavía analizábamos las diferencias en las rutas tecnológicas de ambas compañías, del lado de OpenAI estalló de repente un escándalo más descabellado que una película de Hollywood——
Gente, ¡OpenAI tiene un topo!!!
Según la acusación revelada por los fiscales federales de Estados Unidos, el exingeniero del equipo de producto de OpenAI de 35 años, Abdulrahman Alfozan, ya ha sido formalmente despedido y enfrenta cargos penales federales.
¿Y qué hizo este señor?
En la sala de reuniones principal reservada para los altos ejecutivos en la sede de OpenAI en San Francisco, un dispositivo de escucha con cifrado avanzado y funciones de transmisión de datosenvuelto en papel higiénicolo conectó discretamente en el puerto USB de la parte trasera del televisor.
Cabe señalar que esta sala de reuniones es el lugar donde Sam Altman y otros ejecutivos celebran reuniones principales a puerta cerrada, donde normalmente se habla de secretos del desarrollo de superinteligencia, planes de productos no revelados e informes sobre colaboraciones con el gobierno.
Y así, tan fácilmente fue hackeada.
El mundo de verdad es un circo de aficionados...