
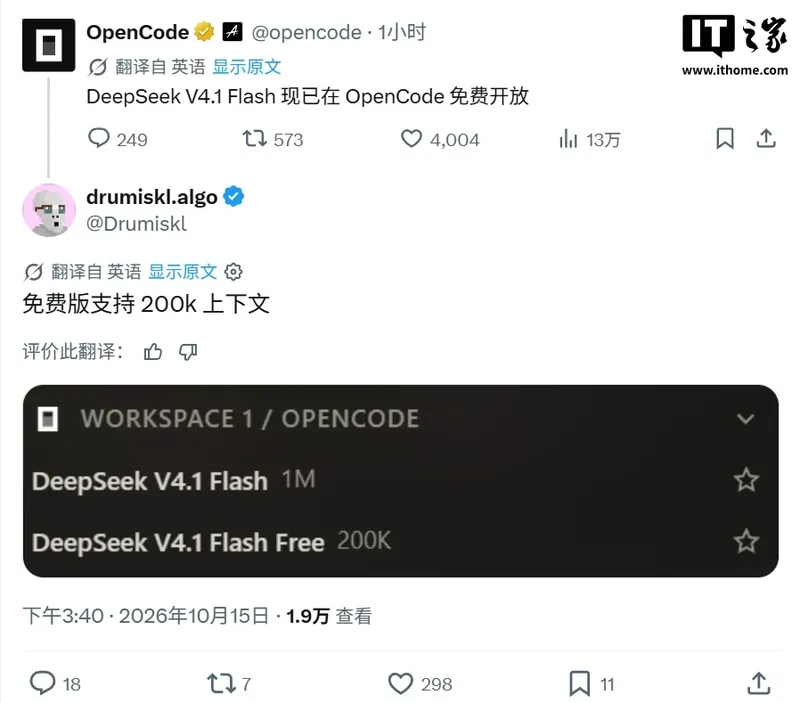
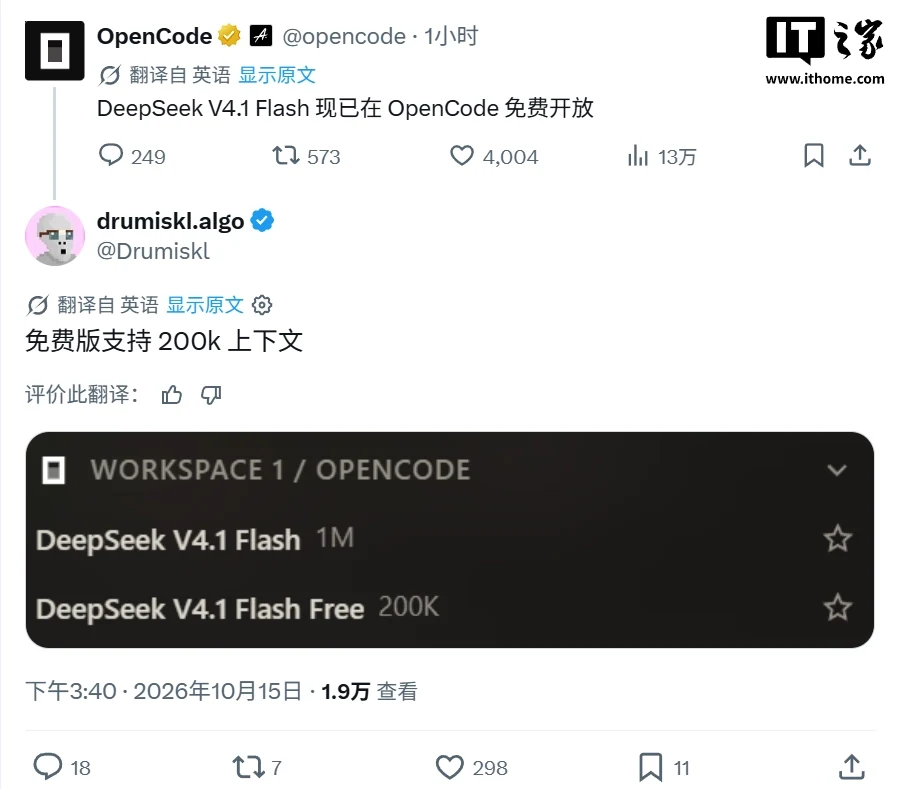
IT之家 El 15 de octubre, OpenCode anunció que DeepSeek V4.1 Flash ya está disponible gratuitamente. La versión gratuita soporta 200K ventanas de contexto, lo cual es un ajuste en comparación con la versión de 1M ventanas de contexto.
Esta apertura gratuita es una medida adicional basada en el programa “Operation Cheepseek” anteriormente implementado. En septiembre de este año, OpenCode aumentó temporalmente la cantidad de uso de DeepSeek V4.1 Flash en el paquete OpenCode Go de 15 dólares a 60 dólares, y posteriormente, el 12 de octubre, la cantidad se ajustó a 80 dólares. Después de esta apertura gratuita, el uso del modelo en la plataforma OpenCode ya no se cuenta como consumo de cupos.
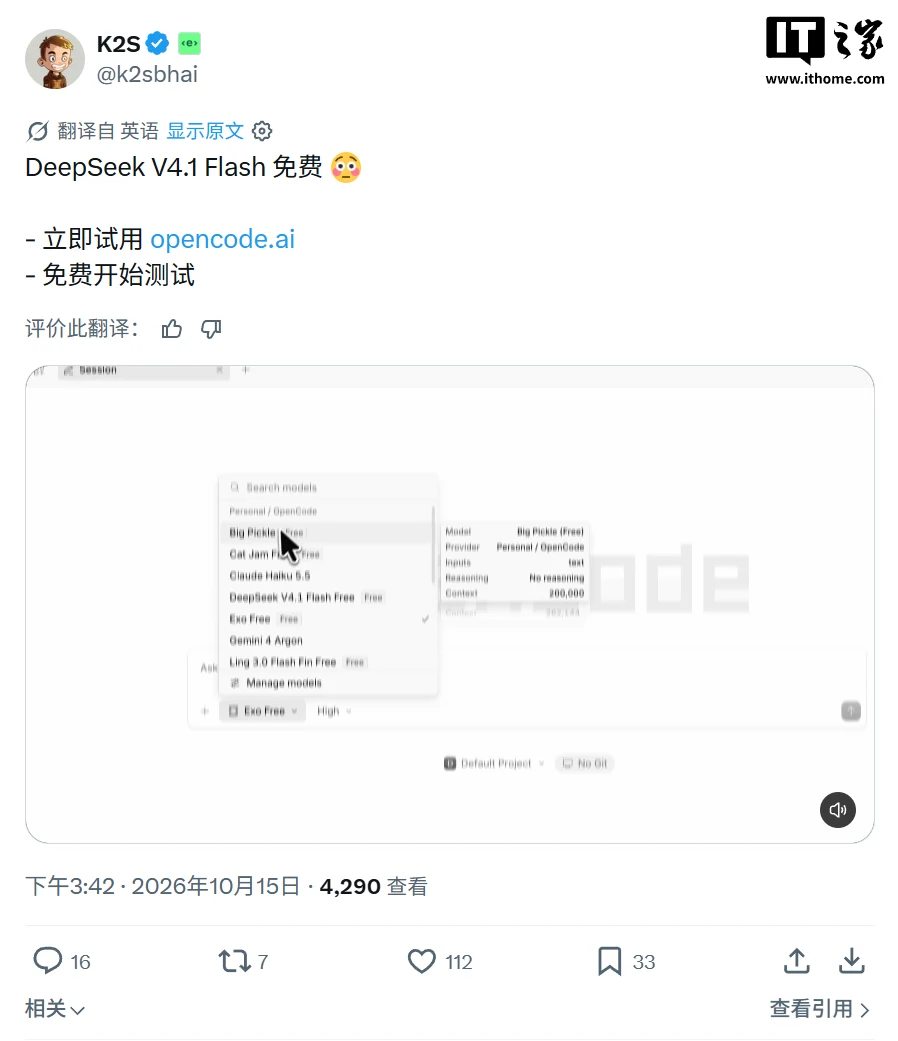
DeepSeek V4.1 Flash fue lanzado oficialmente el 10 de septiembre de 2026. Se trata de un modelo MoE multimodal nativo con un tamaño de parámetros principal de 552B, además de 196B de parámetros de memoria condicional Engram. IT Home observó que su arquitectura utiliza un diseño de codificador-codificador causal; en los 40 niveles del eje lingüístico, los primeros 20 son codificadores causales y los últimos 20 son decodificadores, lo que reduce el volumen de cálculo de Prefill a casi la mitad. Este modelo no cuenta con un nivel de API gratuito en la plataforma oficial de DeepSeek, y el pago se realiza mediante tarifas por uso con prepago.
En cuanto a las observaciones de los usuarios, la velocidad de generación (TPS) es el tema central de los debates en la comunidad. Muchos usuarios han reportado grandes fluctuaciones en la velocidad. Algunos usuarios indicaron que en la plataforma en la nube de ollama se observó una velocidad de salida de aproximadamente 490 tokens/s, pero en general es inestable; la velocidad puede bajar hasta cinco o sesenta tokens/s durante el mediodía al atardecer.
En el paquete OpenCode Go, algunos usuarios han reportado que el TPS cae por debajo de 100. Además, las pruebas en la comunidad muestran que la velocidad disminuye a medida que aumenta el contexto; algunos usuarios informan que cuando el contexto supera los 100K, el TPS caiga por debajo de 100, y cuando alcanza los 200K, será de aproximadamente 50 tokens/s.
Leer también: