
TL;DR
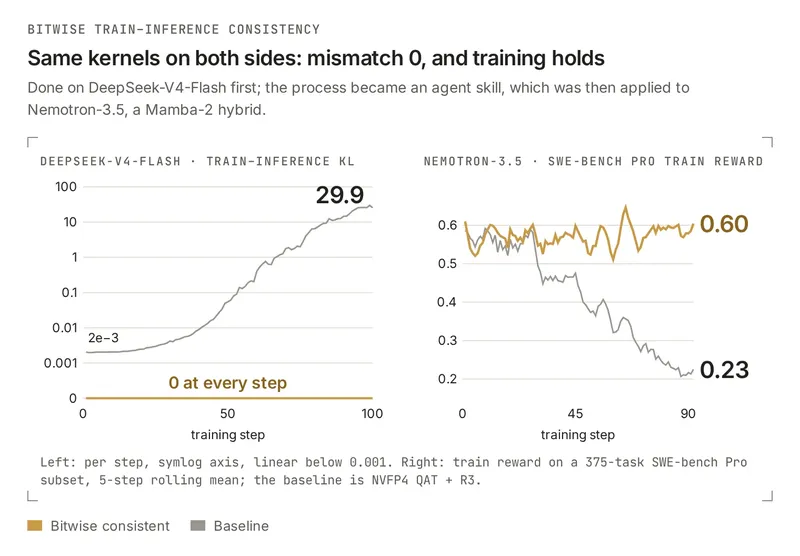
- Problema: las optimizaciones del lado de inferencia en RL de alto rendimiento cambian la numeración, de modo que el entrenamiento optimiza una política distinta de la que muestreó. En DeepSeek-V4-Flash, la KL entrenamiento-inferencia del baseline de alto rendimiento subió de 2e-3 a 29.9 mientras la recompensa retrocedió.
- Enfoque: el forward de entrenamiento llama directamente a los kernels de inferencia de vLLM, y esos kernels de alto rendimiento se modifican para que rollout y entrenamiento produzcan logprobs idénticos bit a bit para cada token muestreado (diff = 0).
- Resultados: a lo largo de 100 pasos de entrenamiento de DeepSeek-V4-Flash, diff es 0 en cada paso al 91.3% del throughput de rollout del baseline. Trasladado a Nemotron (híbrido Mamba + NVFP4), el puntaje de SWE-bench Pro de la ejecución consistente se mantiene mientras el del baseline cae de 0.56 a 0.22.
- Código abierto: el proceso se empaqueta como una skill de agente y se libera junto con las recetas y el código, reduciendo el costo de hacer esto en un modelo nuevo.
- En progreso: DeepSeek-V4.1 ha alcanzado 0 de diff; el trabajo de rendimiento está por finalizarse y tendrá su propia publicación.
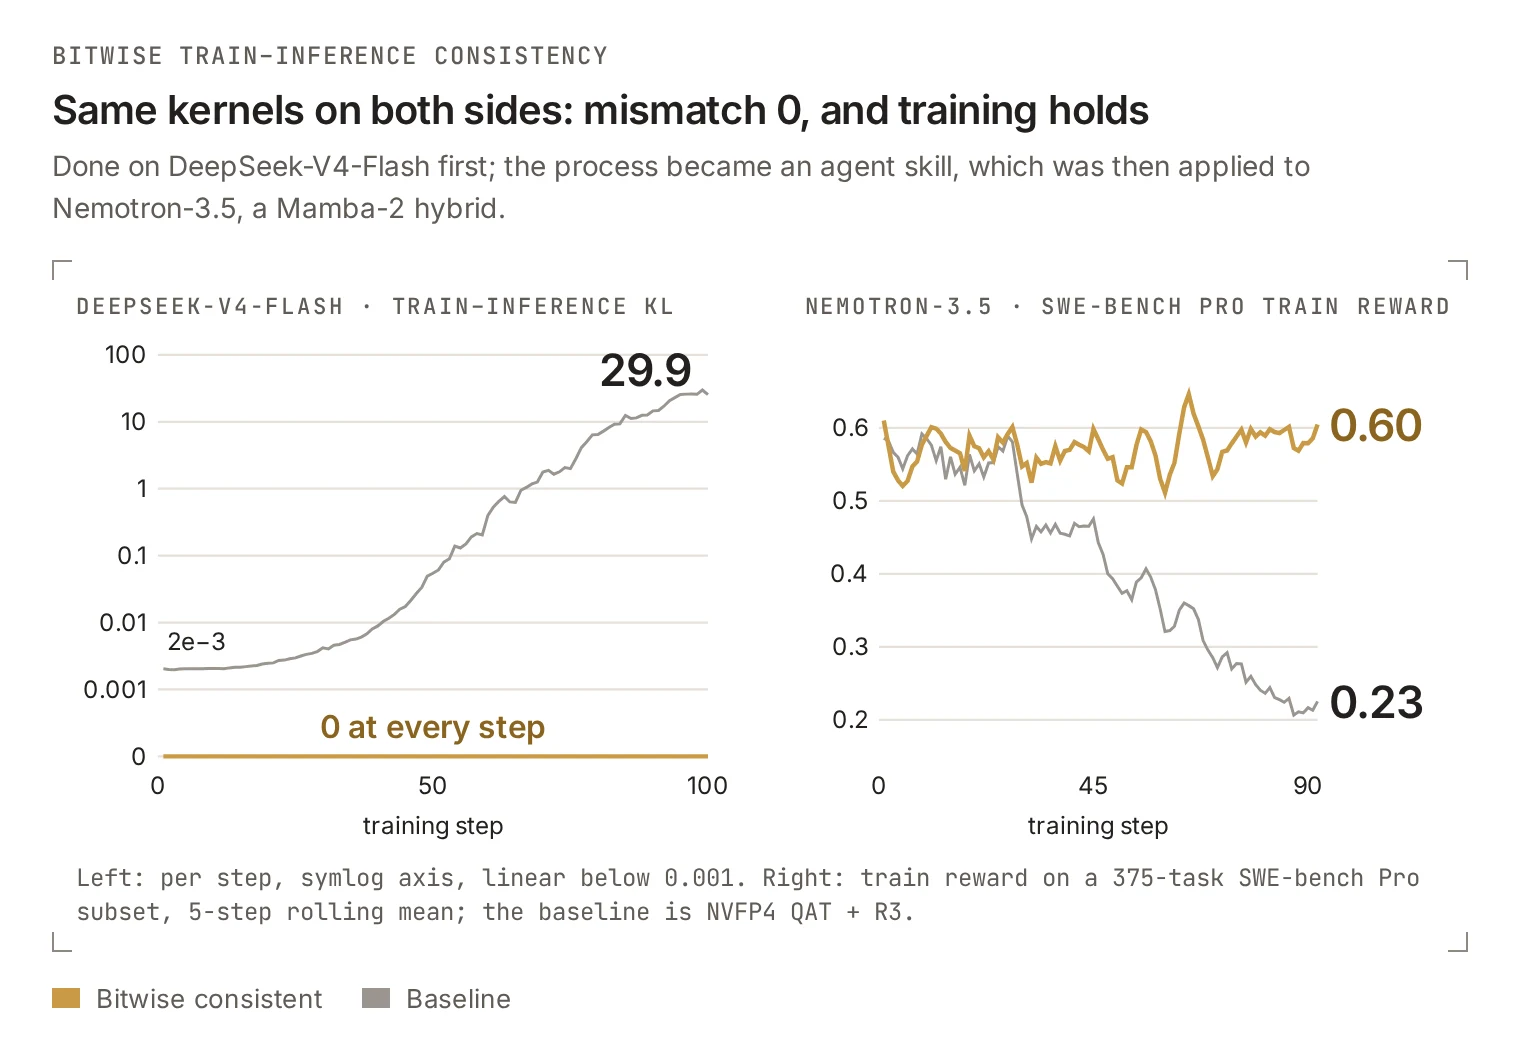
DeepSeek-V4-Flash alcanzó 0 de diff primero; el proceso se convirtió en una skill de agente, que luego se aplicó a Nemotron-3.5 (un híbrido Mamba-2). Izquierda: KL entrenamiento-inferencia de DeepSeek-V4-Flash; el baseline sube de 2e-3 a 29.9 y la ejecución consistente es 0 en cada paso. Derecha: puntaje de entrenamiento de Nemotron-3.5 en SWE-bench Pro (media móvil de 5 pasos); la ejecución consistente se mantiene alrededor de 0.6 mientras el baseline cae a 0.23.
El rollout domina el tiempo de entrenamiento RL, por lo que los sistemas de entrenamiento adoptan cómputo de baja precisión, caché KV de baja precisión, y optimizaciones de comunicación y de kernels. Estas cambian la numeración del lado de la inferencia. El motor de inferencia genera una respuesta; el motor de entrenamiento recalcula sus probabilidades y actualiza el modelo. Con pesos idénticos, ambos lados ahora asignan probabilidades diferentes al mismo token, de modo que el entrenamiento optimiza una política distinta de la que muestreó. La brecha puede crecer con las actualizaciones y desestabilizar el entrenamiento. En nuestro experimento con DeepSeek-V4-Flash-Base (sin corrección algorítmica como TIS), la KL entrenamiento-inferencia del baseline de alto rendimiento subió de 2e-3 a 29.9 mientras la recompensa retrocedió.
Un entrenamiento inestable significa más crashes, rollbacks y reejecuciones, una menor proporción de entrenamiento efectivo y más tiempo total para llegar al mismo resultado. Nuestro objetivo es terminar el entrenamiento RL efectivo más rápido: al reducir crashes y reejecuciones, alcanzar un resultado en menos tiempo de extremo a extremo.
Nuestro enfoque: en la trayectoria numérica de alto rendimiento, entrenamiento e inferencia producen un logprob idéntico bit a bit para cada token muestreado (diff = 0; la Sección 2 lo define con exactitud), lo cual es RL on-policy verdadero. Lo logramos haciendo que el forward de entrenamiento llame directamente a los kernels de inferencia de vLLM y modificando esos kernels de alto rendimiento para que los resultados no cambien según la composición del batch, la fase de prefill o decode, o la distribución paralela (Secciones 3 y 4). Una skill de agente reduce luego el costo de hacer esto en un modelo nuevo y hace que el proceso sea transferible: le dice a un agente cómo encontrar el primer operador donde ambos lados divergen, reducirlo a un repro mínimo, corregirlo y volver a ejecutar las regresiones. En DeepSeek-V4-Flash alcanzamos 0 de diff al 91.3% del throughput de rollout del baseline de alto rendimiento, y trasladamos el método a Nemotron, un híbrido Mamba con NVFP4.
Esta publicación mide consistencia numérica, curvas de entrenamiento y throughput de rollout. La ganancia de extremo a extremo proviene de menos crashes y reejecuciones, lo cual solo se observa en ejecuciones largas; esa comparación de tiempo de reloj queda para más adelante. Además, ninguno de los dos baselines fue ajustado ni explorado a fondo: cada uno ejecutó una única configuración, con R3 pero sin correcciones algorítmicas como TIS o MIS. Los colapsos del baseline que se muestran aquí reflejan solo esa receta; con ajuste, el baseline puede no colapsar tan fácilmente.
1. Enfoques existentes: cómo comprometen las tres propiedades
Terminar el entrenamiento RL efectivo más rápido requiere tres propiedades a la vez:
- A, alto rendimiento: rollout y entrenamiento rápidos, con cómputo de baja precisión, caché KV de baja precisión y optimizaciones de comunicación todas utilizables;
- B, alta consistencia: entrenamiento e inferencia computan la misma política para los mismos pesos;
- C, bajo costo y generalidad: lograr A y B en un modelo, precisión o hardware nuevos toma un tiempo de desarrollo aceptable.
Estos rara vez se mantienen unidos. Si se elimina B, se optimiza libremente pero se arriesga un entrenamiento inestable. Si se elimina A, se pueden usar kernels consistentes, pero la inferencia se vuelve mucho más lenta (números en la tabla siguiente). Mantener A y B significa alinear modelo por modelo y operador por operador, por lo que C falla.
El desajuste entre entrenamiento e inferencia no es nuevo; los enfoques existentes compensan A, B y C de manera diferente:
| Enfoque | Qué conserva | Qué sacrifica o qué paga |
|---|---|---|
| Corrección algorítmica: TIS, MIS, FlashREINFORCE, Score Centering | A y C: deja el motor de inferencia intacto, es agnóstico al modelo y barato de adoptar | B: la diferencia numérica persiste; solo se limita su efecto sobre la actualización. Costes: sesgo, muestras descartadas, y la corrección se vuelve más difícil a medida que la baja precisión amplía la brecha |
| R3 (enrutamiento de expertos con replay rollout) | A, además de B para el enrutamiento MoE | Elimina solo los volteos de enrutamiento; las demás diferencias numéricas persisten |
| QAT (el paso hacia adelante del entrenamiento simula la cuantización del despliegue) | A: el rollout puede usar con seguridad baja precisión; reduce la parte de la diferencia inducida por la cuantización (mejora B) | El entrenamiento debe simular la cuantización, y el backward usa el estimador straight-through (STE: el backward trata la cuantización como identidad); simular solo los pesos deja diferencias provenientes de las activaciones, KV, kernels y la reducción |
| Alineación numérica estricta (Thinking Machines, slime, IsoExec, esta publicación) | B | A o C: los kernels genéricos invariantes por batch cuestan A (workload de Thinking Machines: de 26 s a 55 s, 42 s con un kernel de atención mejorado); alinearse en el camino de alto rendimiento mantiene A y cuesta C (slime, IsoExec, esta publicación: alineación y verificación por modelo y por operador) |
La corrección algorítmica cubre varios mecanismos:
- TIS (Truncated Importance Sampling, Yao et al.): pondera el gradiente por la razón de probabilidades entrenamiento/rollout, truncada en un límite superior, intercambiando un poco de sesgo por varianza acotada;
- MIS (Masked Importance Sampling, When Speed Kills Stability): sin truncamiento; descarta secuencias completas cuya razón de probabilidad a nivel de secuencia supera un umbral;
- FlashREINFORCE (Hu, Zhang et al.): para RL agéntico asíncrono; el filtrado de deriva a nivel de trayectoria (sequence trust region) elimina las trayectorias que se desvían demasiado;
- Score Centering (Marek & Ryabinin): cancela la deriva entrenamiento-inferencia acumulada en cada actualización mediante un término de corrección aditivo; se combina con importance sampling.
Estos métodos reducen el efecto del desajuste pero no lo eliminan: el desajuste convierte el entrenamiento on-policy en entrenamiento off-policy (Yao et al.); cuando es grande y tiene varias fuentes, el importance sampling a nivel de token está sesgado y el entrenamiento es más propenso al colapso (Li & Liu); en P1-VL, el truncated importance sampling solo retrasó el colapso. R3 (Rollout Routing Replay, Ma et al.) registra el enrutamiento de expertos del rollout y lo reproduce en el entrenamiento, eliminando solo la parte de los cambios de enrutamiento (routing flips).
En la última fila, Thinking Machines Lab logra RL verdaderamente on-policy con kernels invariantes por batch (Defeating Nondeterminism in LLM Inference) al costo en tiempo de inferencia en la tabla, buena parte proveniente de una integración de FlexAttention aún no bien optimizada; vLLM y TorchTitan reutilizan los kernels forward de vLLM en el entrenamiento, y su ejecución bit a bit consistente alcanzó una recompensa mayor en menos pasos; slime alinea los logprobs en la arquitectura GLM-5 (MLA + DSA, la misma estructura que DeepSeek-V3.2); y IsoExec por Alexander Jiang y el equipo SkyRL cubre la atención lineal (Sección 6).
La mayoría de estos enfoques se apilan: algunos apuntan a la diferencia numérica entre motores en una misma versión de pesos, otros a la diferencia de política entre versiones de pesos. En el entrenamiento asíncrono, el off-policy proveniente de pesos obsoletos sigue pasando por TIS, MIS o Score Centering, pero los motores pueden seguir alineados numéricamente sobre esos pesos, y la ejecución bit a bit consistente se convierte en la línea base para medir dichas correcciones. QAT también pertenece a la alineación estricta: el rollout y el entrenamiento en baja precisión coinciden bit a bit solo si el forward del entrenamiento aplica la misma cuantización; nuestro backward usa STE.
Tomamos el camino de la última fila que mantiene A, con esta barra para A: throughput de rollout de al menos el 70% de una línea base de alto rendimiento igualmente optimizada (el rollout es la parte más lenta del entrenamiento RL; el overhead del lado del entrenamiento no se midió por separado, ver 3.2). C es el punto débil de este camino; la Sección 5 cubre cómo Agent + skill lo compensa.
2. Qué exige la consistencia entrenamiento-inferencia
En esta publicación, diff es la diferencia, antes de cada actualización con la misma versión de pesos y prefijo de tokens, entre el logprob del rollout para cada token válido (tokens muestreados dentro de la máscara de respuesta) y el old-logprob recomputado por el lado del entrenamiento. La aceptación exige que el máximo, la media y la desviación estándar de la diferencia por token |p_rollout − p_train|, y el k3 KL, sean todos exactamente 0. Esto es igualdad exacta, no un umbral, comprobada antes de cada actualización; una actualización de mini-batch cambia la política de todos modos, lo cual la definición excluye. Se cumple en nuestras tareas aceptadas (razonamiento matemático, llamadas a herramientas multi-turno) y disposiciones en paralelo, incluidas disposiciones diferentes por lado.
"Entrenamiento e inferencia calculan lo mismo" se descompone en cuatro dimensiones más un contrato numérico compartido:
train-inference consistency ⇐ kernel determinism + batch independence + phase consistency + cross-GPU consistency + same numerical contract on both sides
Determinismo de kernels (una sola GPU). El mismo kernel con la misma entrada siempre da la misma salida. Las GPU no lo garantizan por defecto. Un ejemplo es la multiplicación de matrices split-K: un orden de acumulación diferente da un resultado diferente porque la suma en punto flotante no es asociativa.
Independencia de lotes. El resultado de una solicitud no debe depender de sus compañeros de lote. Durante la inferencia, el motor fusiona y divide lotes dinámicamente para el rendimiento. En el entrenamiento, el tamaño de micro-lote, el empaquetado y los recuentos de tokens por experto en MoE también cambian la ruta. Varias optimizaciones (elección de kernel según el tamaño del lote, número dinámico de divisiones) hacen que una solicitud determinada dependa de otras en su lote.
Coherencia entre fases. Un token debe obtener el mismo resultado en prefill (muchos tokens a la vez) y en decode (uno a la vez). Los motores de inferencia dan a cada fase su kernel más rápido; forzar una ruta compartida es la principal fuente de la desaceleración de la versión coherente y un foco de optimización.
Coherencia entre GPUs. Las reducciones entre GPUs (AllReduce, reduce-scatter, y la fusión de salidas de expertos tras el all-to-all del MoE) también deben fijarse, en dos niveles.
- Con el mismo diseño paralelo en ambos lados, los resultados de la comunicación no deben variar con el tiempo ni la planificación (fijar el algoritmo de la biblioteca de comunicación, el fragmentado y la precisión de la reducción, y el orden de fusión de expertos).
- Con diseños paralelos diferentes (p. ej. distintos grados de TP/EP), los resultados también deben permanecer iguales a medida que cambia el grado de paralelismo, lo que requiere un árbol de reducción fijo y cuesta más. La receta de DeepSeek-V4 en cambio saca la reducción entre GPUs de la ruta comparada (4.5).
Cada dimensión protege contra una de dos causas raíz: un orden de operaciones diferente (el orden de acumulación o reducción paralela sigue la planificación) o una ruta de cálculo diferente (los dos lados, o distintas formas de lote, ejecutan kernels o ramas distintas). Alcanzar 0 de diferencia significa primero eliminar las diferencias estáticas, y luego fijar la selección dinámica de rutas para que ignore la carga.
Además de estas cuatro dimensiones, alcanzar diff = 0 requiere algunas cosas más:
- El mismo contrato numérico en ambos lados: misma cuantización y redondeo, misma precisión de acumulación, misma aritmética de kernel. Dos motores pueden satisfacer las cuatro dimensiones y aun así discrepar si calculan de forma distinta.
- Las mismas decisiones discretas: Top-K y el enrutamiento de MoE convierten una diferencia de un ulp aguas arriba (una unidad en el último lugar de un número en coma flotante) en un conjunto de tokens o una combinación de expertos diferente. Una vez que aguas arriba coincide, el desempate, el orden de salida y las reglas de fusión también deben coincidir.
- 1 actualización por paso (el lote del paso es igual al mini-lote): con varias actualizaciones de mini-lote por paso, a partir de la segunda, los pesos de entrenamiento difieren de los pesos de muestreo, algo que diff = 0 no cubre, por lo que el entrenamiento deja de ser estrictamente on-policy (en una tarea de matemáticas con 4 actualizaciones por paso, alrededor del 7% de los tokens cambiaron de combinación de expertos tras cada actualización).
- Un backward y una restauración correctos: las cuatro dimensiones dan solo un forward coherente. El backward debe seguir siendo correcto, y el primer paso tras la restauración de un checkpoint debe seguir siendo coherente.
Los operadores principales de la Sección 4 satisfacen cada uno uno de estos requisitos: la GEMM densa fija la selección de kernel para la independencia de lotes (4.1); la caché KV FP8 unifica las lecturas de prefill y decode para la coherencia entre fases (4.2); Top-K fija los empates y el orden para que las decisiones discretas coincidan (4.3); la GEMM de expertos mantiene un único contrato numérico entre dos diseños (4.4); y la reducción entre GPUs se saca de la ruta comparada para la coherencia entre GPUs (4.5).
diff = 0 dice que ambos lados calculan lo mismo, no que resulte adecuado para el entrenamiento: con varias actualizaciones por paso, diff = 0 se mantiene mientras el enrutamiento deriva entre actualizaciones. diff = 0 es nuestro objetivo de ingeniería, no una condición suficiente para la calidad del entrenamiento, que necesita una aceptación separada.
3. Receta de referencia: DeepSeek-V4-Flash
DeepSeek-V4-Flash combina cómputo de baja precisión, atención dispersa y paralelismo de expertos multinodo, lo que lo hace una configuración desafiante. A partir de la base FP8 entrenamos dos ejecuciones de 100 pasos en GB200: una línea base optimizada de alto rendimiento y una versión coherente con diff = 0.
Tarea: razonamiento matemático con datos en formato DAPO, GRPO y una recompensa con penalización por exceso de longitud (de modo que puede ser negativa). Cada ejecución usa 8 máquinas (32 GPUs), 128 prompts × 8 respuestas por paso, y 1 actualización por paso (lote del paso = mini-lote). Ninguna ejecución usa TIS, MIS ni correcciones similares, exponiendo directamente la diferencia entre motores.
Paralelismo: DP de datos, EP de expertos, CP de contexto (división de secuencia), TP de tensores. El rollout de la versión coherente ejecuta 4 motores vLLM, cada uno DP8/EP8, TP=1; el entrenamiento usa EP32, CP4, TP=1. Ambos lados usan diseños paralelos diferentes (4.5).
Estructuras relevantes: MLA (atención latente multi-cabeza, que comprime KV antes de almacenarlo en caché); DSA (atención dispersa de DeepSeek: un indexador ligero puntúa las posiciones del historial, Top-K conserva como máximo 2048, y MLA atiende solo a ellas); el compresor CSA (comprime el KV del historial en menos filas); mHC (mezcla entre flujos residuales, con la matriz de mezcla normalizada mediante iteraciones de Sinkhorn); y 43 capas MoE. SM100 es Blackwell (el GB200 usado aquí); SM90 es Hopper.
3.1 Decisión central: los kernels de inferencia definen los valores, el entrenamiento añade el backward
Dos motores coinciden más fácilmente ejecutando el mismo código; la cuestión es qué lado se adapta. El rollout domina el tiempo de RL, con cada operador ajustado para el rendimiento; hacer que el entrenamiento sea la referencia renunciaría a esas optimizaciones. Por lo tanto, los kernels de inferencia son la referencia numérica: el forward del entrenamiento llama a los mismos kernels de vLLM para sus valores, y el entrenamiento solo añade el backward. La inferencia tampoco cambia a kernels genéricos invariantes por lotes: conserva los kernels de despliegue de alto rendimiento y los modifica para cumplir los requisitos de la Sección 2. Cada operador de la Sección 4 sigue este equilibrio.
El desafío de esta decisión es que los kernels de inferencia no tienen backward, y la cuantización FP8 no es diferenciable. Así que forward y backward se manejan por separado, y los valores de forward siempre provienen del kernel de vLLM. Cada módulo envuelve el kernel en una autograd.Function cuyo backward se diferencia respecto de los pesos maestros BF16, con la cuantización FP8 tratada como identidad (el estimador de paso recto, STE). El backward reutiliza mayormente kernels existentes: GEMMs BF16 de Transformer Engine para las capas lineales y los GEMMs de expertos, el backward DSA del frontend de cuDNN para la atención dispersa, y el backward de DeepEP para el all-to-all; solo pequeños operadores como mHC, RMSNorm y SwiGLU tienen derivadas FP32 escritas a mano. Algunos kernels fusionados tienen salidas que no pueden diferenciarse de esta manera (attention q/k, KV comprimido, pesos de enrutamiento, el logprob final); para estos volvemos a ejecutar el mismo cálculo en PyTorch solo para su gradiente y conservamos los valores del kernel: visible + (graph - graph.detach()). Cada backward verifica primero que los pesos maestros no hayan cambiado desde el forward, de modo que la recomputación o las actualizaciones asíncronas no puedan mezclar versiones de pesos.
Todos los costos recaen en el entrenamiento, de dos tipos. Ingeniería y verificación: el gradiente es un sustituto, no la derivada exacta del operador cuantizado, por lo que un forward bit a bit idéntico no prueba nada sobre los gradientes, y la habilidad verifica el backward contra una referencia independiente (Sección 5); el backward solo tiene que ser correcto, no determinista. Cada punto de entrada de layout (p. ej. masked / contiguous en 4.4) también necesita su propia verificación. Rendimiento y memoria: el forward de entrenamiento debe guardar las entradas y salidas de los kernels de inferencia para el backward; la presión de memoria es la razón por la que la receta habilita la recomputación completa, que ejecuta el forward dos veces.
3.2 Resultados y quién paga
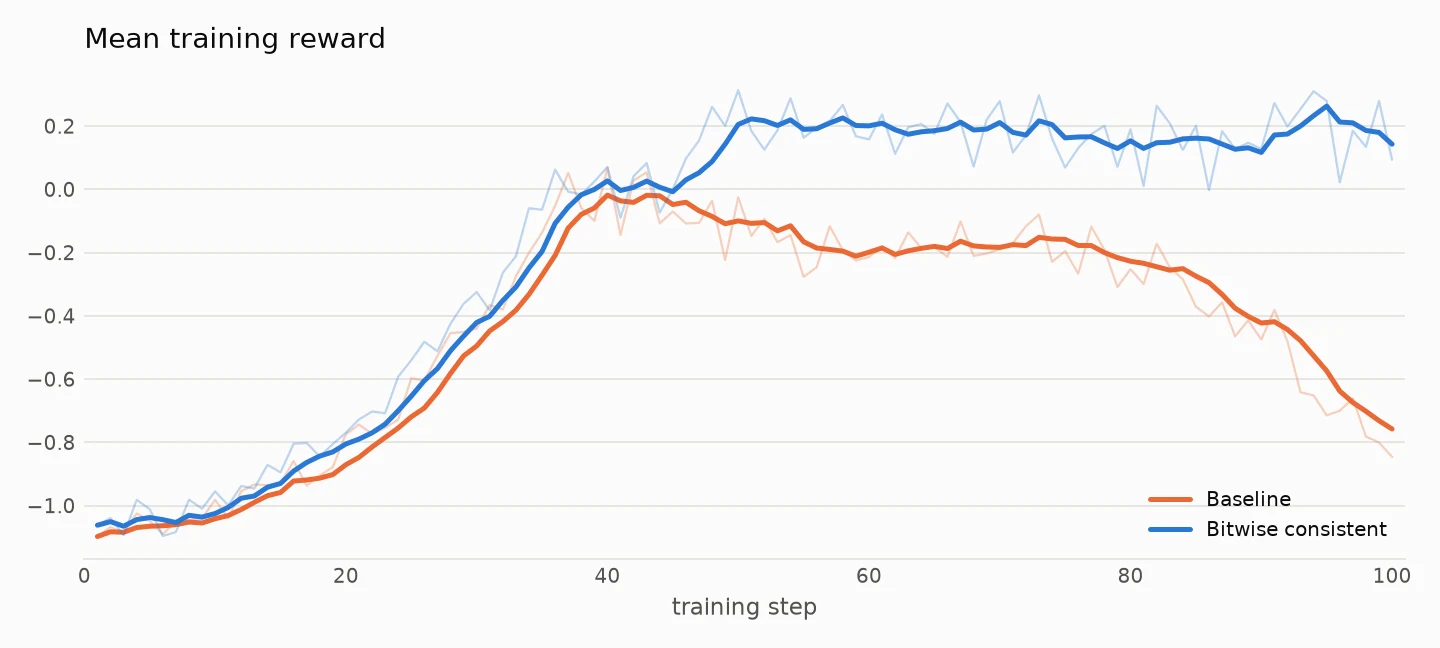
Recompensa de entrenamiento por paso. Naranja: línea base; azul: versión consistente. Línea gruesa: media móvil de los 4 pasos actual y anteriores; línea fina: valor bruto.
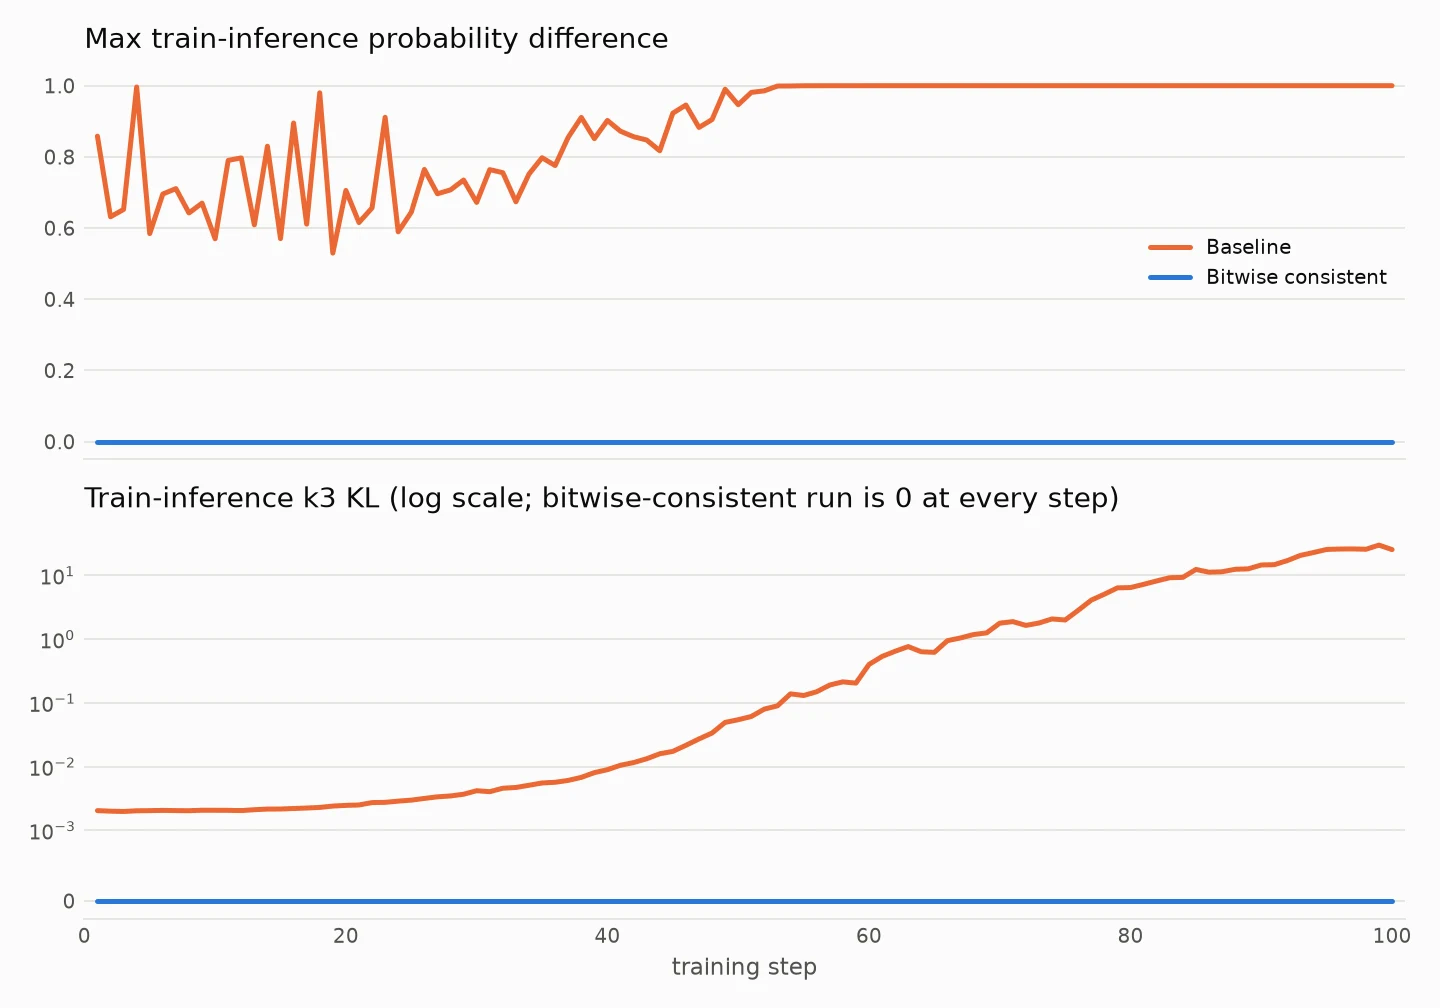
Arriba: diferencia máxima de probabilidad entre entrenamiento e inferencia por paso; abajo: KL entrenamiento-inferencia (estimador k3 r − 1 − log r, usado en todo el documento; escala logarítmica simétrica, lineal cerca de cero). La diferencia máxima reacciona a un cambio de enrutamiento o a un intercambio de Top-K, por lo que es considerable desde el paso 1 de la línea base; la KL muestra el nivel general. Naranja: línea base; azul: versión consistente. Ambas métricas de la versión consistente son 0 en cada paso.
A lo largo de 100 pasos, el rollout de la versión consistente promedia 24.22 token/ms, el 91.3% de la línea base (26.53):
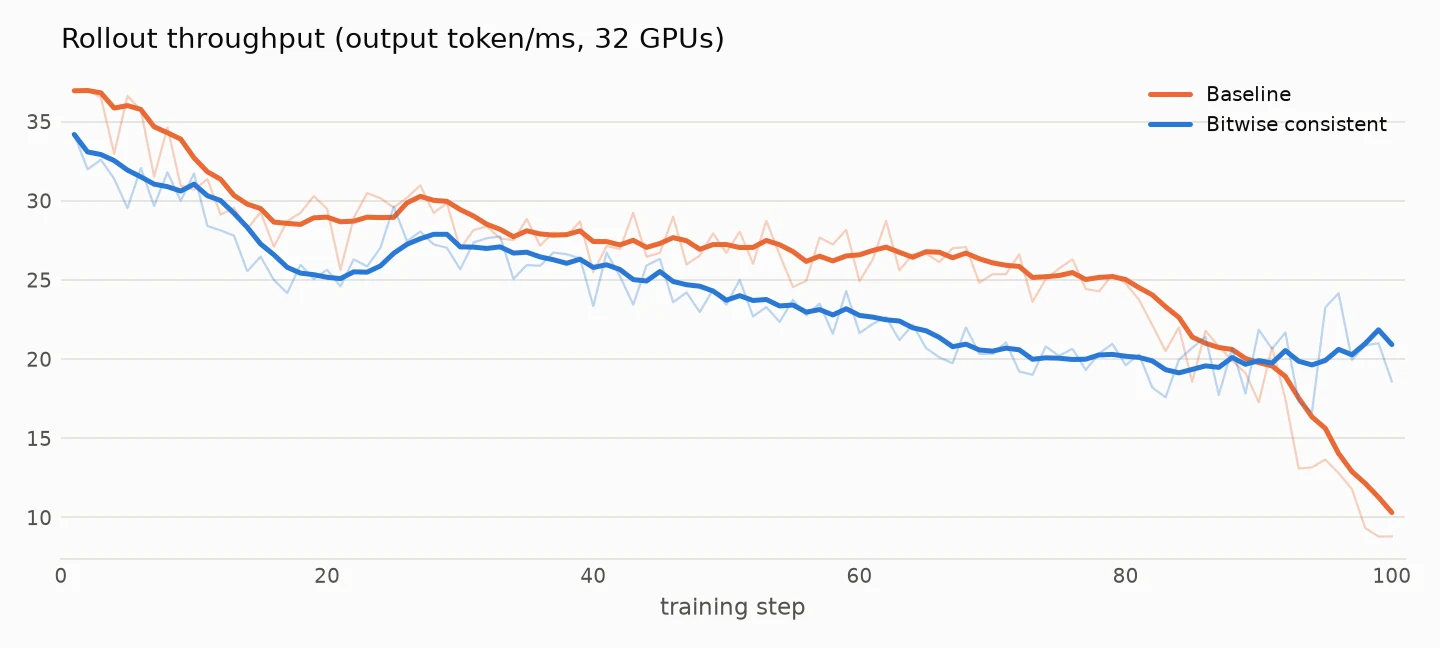
Throughput de rollout por paso (token/ms de salida, sumado sobre 32 GPUs). Naranja: línea base; azul: versión consistente. Línea gruesa: media móvil de los 4 pasos actual y anteriores; línea fina: valor bruto.
La KL entre entrenamiento e inferencia de la línea base crece (de 2e-3 a 29.9) mientras su recompensa retrocede; la versión consistente se mantiene en diff 0 y su recompensa se sostiene. Otra ganancia potencial es un forward menos: recomputamos old-logprob en cada paso solo para medir diff; tras la aceptación, el entrenamiento puede usar el logprob del rollout en su lugar.
Lado del rollout, medido en esta ejecución: el throughput promedio es el 91.3% de la línea base (alrededor de un 9% menor), por encima del piso del 70% de la Sección 1. Después del paso 90 el throughput de la línea base cae, lo que infla la proporción; en los mismos pasos su longitud media de respuesta cae de unos 3,000 a unos 1,600 tokens. los primeros 89 pasos dan el 88.6%. Las longitudes de respuesta de las dos ejecuciones difieren durante todo el entrenamiento, así que la proporción también refleja cargas de trabajo distintas, no solo los motores.
Esta brecha aún no se atribuye a operadores; la Sección 4 señala la comunicación MoE LL y el backend, el gather de atención y la dequantización, y los lanzamientos por solicitud.
Lado del entrenamiento, no medido por separado: según la Sección 4, la sobrecarga es recuantizar los pesos FP8 en cada forward, la atención y el Top-K por solicitud en serie, un dispatch adicional de metadatos de enrutamiento, y la recomputación completa (3.1), que ejecuta el forward dos veces.
Una vista previa de un PR de receta de verl por separado en 32 GB200 GPUs reporta alrededor del 10% de sobrecarga de extremo a extremo: el rollout cerca de la paridad, la brecha está mayormente en el entrenamiento. La optimización del lado del entrenamiento es lo siguiente.
4. Operador por operador: decisiones técnicas en la receta de DeepSeek-V4
Cada subsección cubre qué se conserva, qué se sacrifica, cómo se recupera velocidad y qué costo queda. Qué kernel usa cada lado por operador, y cómo se escribe el backward, están en la habilidad.
Tabla maestra por operador
El costo se sitúa mayormente en la comunicación y el backend de MoE (4.4, 4.5), luego en el gather de atención y la dequantización (4.2, 4.3); el denso es barato.
| Módulo | Se conserva | Se sacrifica | Costo |
|---|---|---|---|
| GEMM densa (4.1) | Despliegue W8A8 y DeepGEMM; un orden de acumulación por salida | Rama FlashInfer en M<32, kernel de puerta para lotes pequeños, kernel mHC fusionado | rollout: sin kernel más rápido para lotes pequeños; entrenamiento: pesos re-cuantificados en cada forward |
| Caché KV FP8 (4.2) | Almacenamiento FP8 | Kernel de decodificación que lee FP8 directamente | rollout: recolección y descuantización adicionales en la decodificación; entrenamiento: una caché privada |
| Top-K (4.3) | Atención dispersa de DSA | Desempate Top-K por defecto y orden de salida | Una ordenación adicional por lado, recuperada mediante fusión; múltiples lanzamientos de prefill por solicitud; entrenamiento: atención y Top-K en serie por solicitud |
| GEMM de expertos (4.4) | GEMM agrupada en FP8; el enrutamiento coincide por construcción, sin R3 | FlashInfer TRT-LLM MoE | rollout: una brecha principal de rendimiento; entrenamiento: relleno de alineación |
| Reducción entre GPU (4.5) | Diferentes disposiciones paralelas para entrenamiento y rollout | TP>1 | rollout: la comunicación LL no puede solaparse con el cómputo; entrenamiento: un despacho adicional de metadatos de enrutamiento |
| CUDA Graph (4.6) | Graphs | Ramas de atajo solo de rendimiento | Espacios de trabajo reservados en su límite superior |
| Otros (embedding, RMSNorm, o_proj, lm_head + logprob) | Kernels existentes, orden de reducción fijo | — | Pequeño |
4.1 GEMM denso: mantener FP8, un orden de acumulación para cada M
Se mantiene. DeepSeek-V4-Flash-Base se entrega en block-FP8, y la ruta de despliegue es W8A8 con DeepGEMM. La versión consistente lo usa en ambos lados: cada pasada hacia adelante del entrenamiento cuantiza los pesos maestros BF16 a block FP8 según la regla de despliegue y llama al GEMM de inferencia. Un rollout en BF16 costaría cómputo y ancho de banda; un esquema separado en el lado del entrenamiento como MXFP8 solo se acerca a la numérica desplegada, la limitación de la fila QAT en la Sección 1.
Se renuncia. El motor de inferencia elige kernels según la forma: la capa lineal FP8 usa FlashInfer cuando M<32 y DeepGEMM en otro caso; la puerta del router cambia a un kernel de lotes pequeños con 16 tokens o menos; el número de divisiones de mHC crece con el número de tokens. La adición en punto flotante no es asociativa, por lo que cada uno hace que el resultado de una solicitud dependa de sus vecinos. La versión consistente elimina estas ramas: la capa lineal FP8 siempre usa DeepGEMM en modo batch-invariant, la puerta del router usa un GEMM con salida FP32 en cada tamaño de lote, las pequeñas multiplicaciones de matrices BF16 usan un kernel Triton con orden de suma fijo, y la división de mHC se fija en 1. Unificamos en DeepGEMM en lugar de FlashInfer porque DeepGEMM tiene un modo batch-invariant, ya es el kernel de despliegue, y el M de entrenamiento es grande.
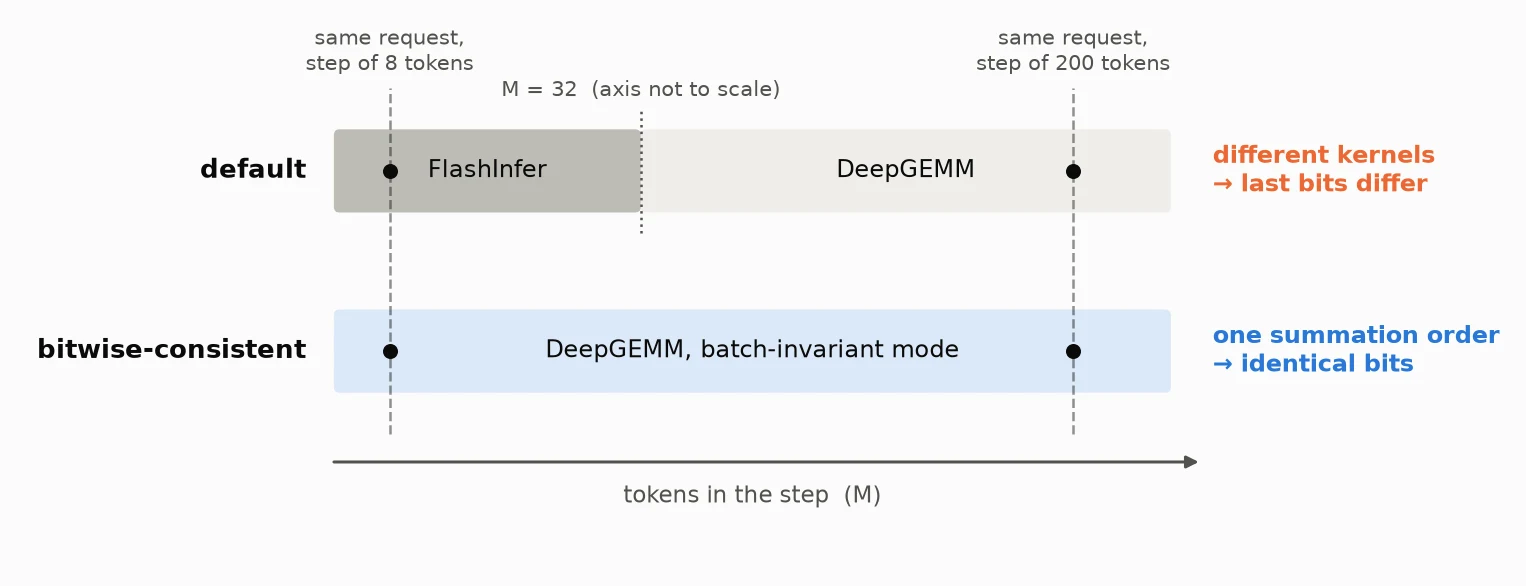
Eje horizontal: tokens por paso (esquemático). La ruta por defecto cambia de kernel en 32, por lo que la misma solicitud en un paso de 8 tokens y en uno de 200 tokens pasa por FlashInfer y DeepGEMM y difiere en el último bit. El modo batch-invariant tiene un solo orden de suma.
Costo. El rollout pierde kernels más rápidos para lotes pequeños y una fusión de mHC, pero los Tensor Cores siguen en uso. El entrenamiento requantiza los pesos en cada pasada hacia adelante, incluida la recomputación; almacenar en caché los pesos FP8 ahorra ese tiempo a cambio de una copia residente adicional.
4.2 Caché KV FP8: mantener el almacenamiento FP8, unificar la ruta de lectura
Se mantiene. La caché KV se almacena en FP8, alrededor del 57% de BF16, lo que establece directamente la concurrencia. Ambas ejecuciones comparten la ruta de escritura.
Se renuncia. El decode por defecto usa un kernel FlashMLA que lee FP8 directamente y particiona el trabajo por lote; el prefill desquantiza a BF16 y ejecuta atención dispersa. Las dos fases ejecutan algoritmos diferentes, y la partición del decode depende de su lote. La versión consistente enruta el decode a través de la ruta de prefill: desquantizar y reunir el KV seleccionado en un espacio de trabajo BF16, y luego llamar al mismo flash_mla_sparse_fwd. El espacio de trabajo es por solicitud y su tamaño está limitado únicamente por los límites del modelo. Este kernel de decodificación debe seleccionarse explícitamente; el interruptor de consistencia por sí solo no lo cambia.
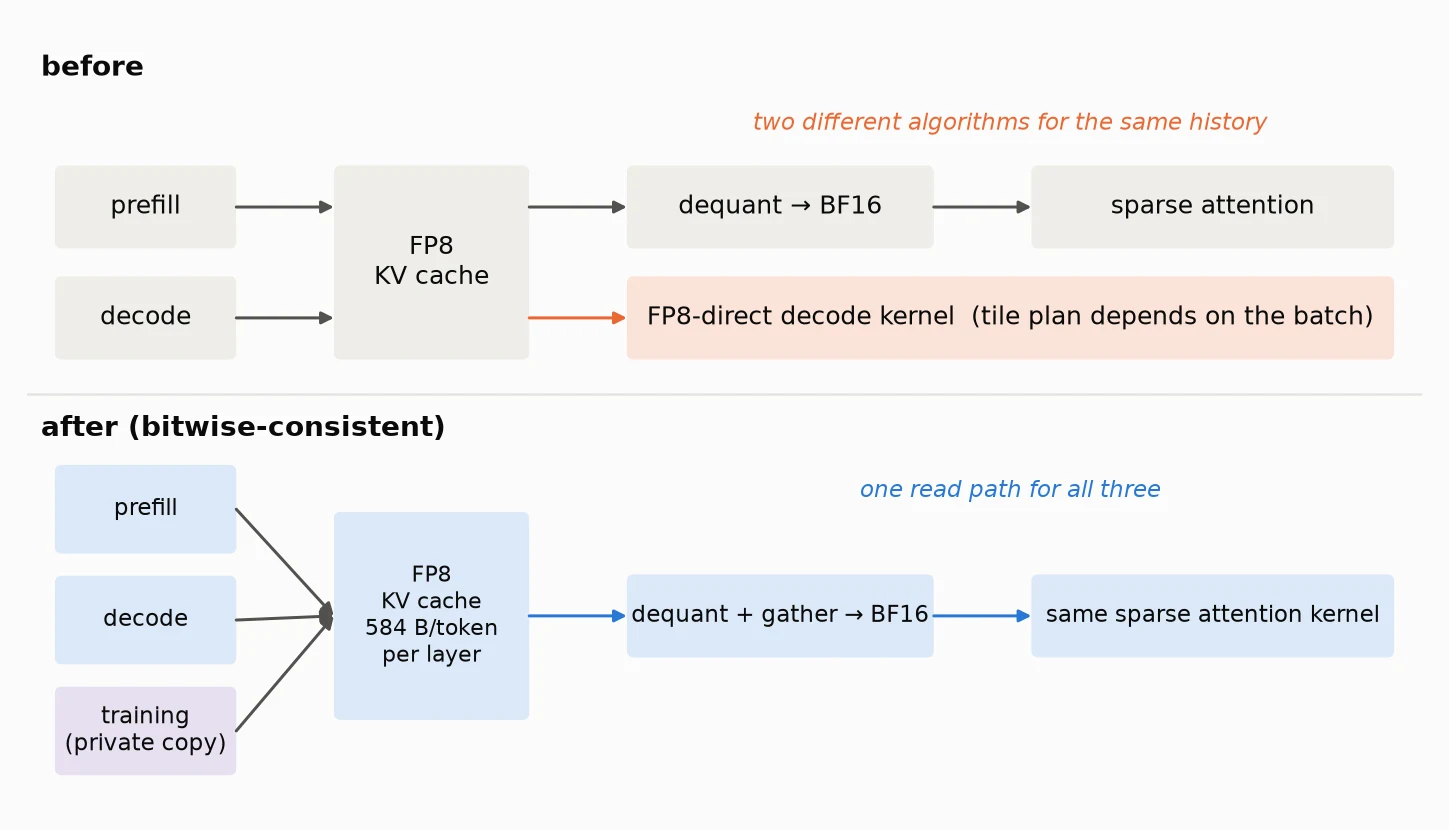
Arriba: antes, prefill y decode leían el mismo historial FP8 con dos algoritmos, y la partición de decode dependía del batch. Abajo: prefill, decode y entrenamiento (con una copia privada de la caché) comparten una ruta de lectura.
El entrenamiento no tiene una caché real, pero K debe realizar el mismo viaje de ida y vuelta en FP8: el mismo kernel fusionado lo escribe en una caché privada FP8, y la misma desquantización lo lee de vuelta.
Costo. Decode añade gather y desquantización, y el entrenamiento añade una caché. Este es el precio de la consistencia entre fases; la precisión de almacenamiento no se ve afectada. Actualmente cada solicitud genera un token por paso; la predicción multi-token (MTP) y la decodificación especulativa no están cubiertas.
4.3 Top-K en atención dispersa: corregir empates y orden
Problema. El indexador DSA puntúa cada posición del historial, y Top-K selecciona como máximo 2048 para la atención. Esta elección discreta convierte una diferencia de un ulp aguas arriba en un contexto diferente. La puntuación está alineada primero: el indexador usa el mismo kernel de DeepGEMM, el prefill lee KV contiguo y el decode lee KV paginado, y las dos lecturas son bit a bit idénticas.
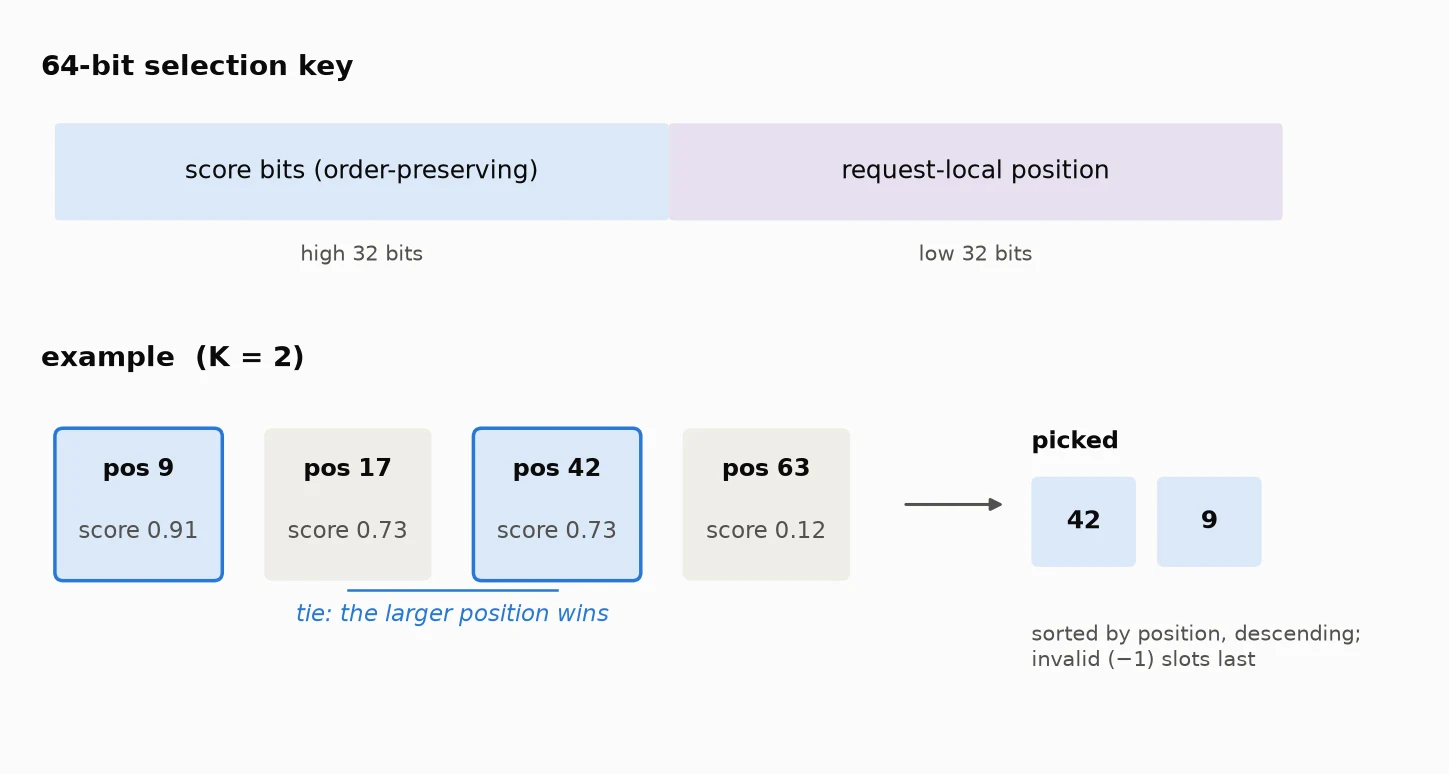
Arriba: disposición de la clave de selección de 64 bits. Abajo: un ejemplo con K = 2 donde las posiciones 17 y 42 empatan y los bits de posición en la clave seleccionan 42; las posiciones seleccionadas se ordenan luego por posición descendente, con las entradas inválidas al final.
Fijar la selección y el orden. El Top-K por defecto resuelve los empates según la planificación de hilos. La versión consistente combina la puntuación y la posición dentro de la solicitud en una clave única, de modo que los empates se resuelven a favor de la posición mayor. Usa la posición dentro de la solicitud, no la posición global del lote; de lo contrario, mover una solicitud dentro del lote cambiaría los resultados de los empates. El mismo conjunto no es suficiente: el orden de los índices determina el orden de acumulación de la atención, por lo que los índices seleccionados se ordenan por posición descendente, con las entradas inválidas al final.
La alternativa estilo R3 registra los índices del rollout y los reproduce en el entrenamiento, pero eso son hasta 2048 índices por token por capa: escala de GB por secuencia para respuestas largas.
Lado del entrenamiento. El forward del entrenamiento selecciona las mismas posiciones con la misma puntuación y el mismo Top-K, pero el indexador no se entrena, principalmente por simplicidad. Esto coincide con la práctica existente: DeepSeek-V3.2 desacopla la entrada del indexador al entrenar DSA, de modo que la pérdida de RL nunca le llega, y GLM-5 congela el indexador por defecto en RL.
Costo y recuperación. Cada lado hace una ordenación adicional. El Top-K determinista toma alrededor de 5.9 µs por llamada; fusionarlo con la ordenación de índices aumenta el rendimiento del benchmark de inferencia de la versión consistente en 6.7% (configuración en 4.4). El costo restante son múltiples lanzamientos por solicitud en el prefill.
4.4 GEMM de expertos: dos disposiciones, mismo resultado por fila
Mantenido. El GEMM agrupado FP8 de los expertos enrutados domina la capa MoE, y los dos lados le alimentan disposiciones diferentes. El rollout usa DeepEP en modo de baja latencia (LL) (por qué: 4.5), lo que da una disposición enmascarada dividida en bloques por experto con capacidad fija por bloque. El entrenamiento procesa muchos tokens con DeepEP en modo normal, lo que da una disposición contigua empaquetada por experto.
Elección del backend. Ambos lados consistentes usan DeepGEMM en modo invariante al lote: es de código abierto, tiene un modo invariante al lote y es el kernel de despliegue de alto rendimiento. El MoE FlashInfer TRT-LLM del baseline se distribuye como cubins precompilados, por lo que no podemos modificarlo ni verificar si es invariante al lote; cutlass carece de block-FP8, y triton cae en una implementación por lotes que no declara invariancia al lote. Un solo GEMM de experto toma aproximadamente el mismo tiempo en ambos; el baseline es más rápido porque el MoE TRT-LLM superpone la comunicación con el cómputo en un pipeline multi-stream.
Mismo resultado por fila desde dos disposiciones. Deben cumplirse tres condiciones:
- Los expertos reciben la misma entrada FP8. LL cuantiza en el dispatch y el modo normal después, originalmente con distinto redondeo; unificamos ambos en redondeo al más cercano por elemento.
- El resultado de cada fila es independiente de la disposición. La cuantización es por token y el DeepGEMM invariante al lote acumula cada fila de forma fija, por lo que el resultado de una fila no depende de sus vecinas. Las pruebas bit a bit de router + MoE lo confirman.
- La activación se redondea una sola vez. SiLU(gate) × up entre los dos GEMM se calcula en FP32 y solo el producto se redondea a BF16, y luego se cuantiza a FP8. Redondear SiLU a BF16 antes de la multiplicación puede diferir en un ulp, lo que la cuantización FP8 amplifica hasta un cambio de código.
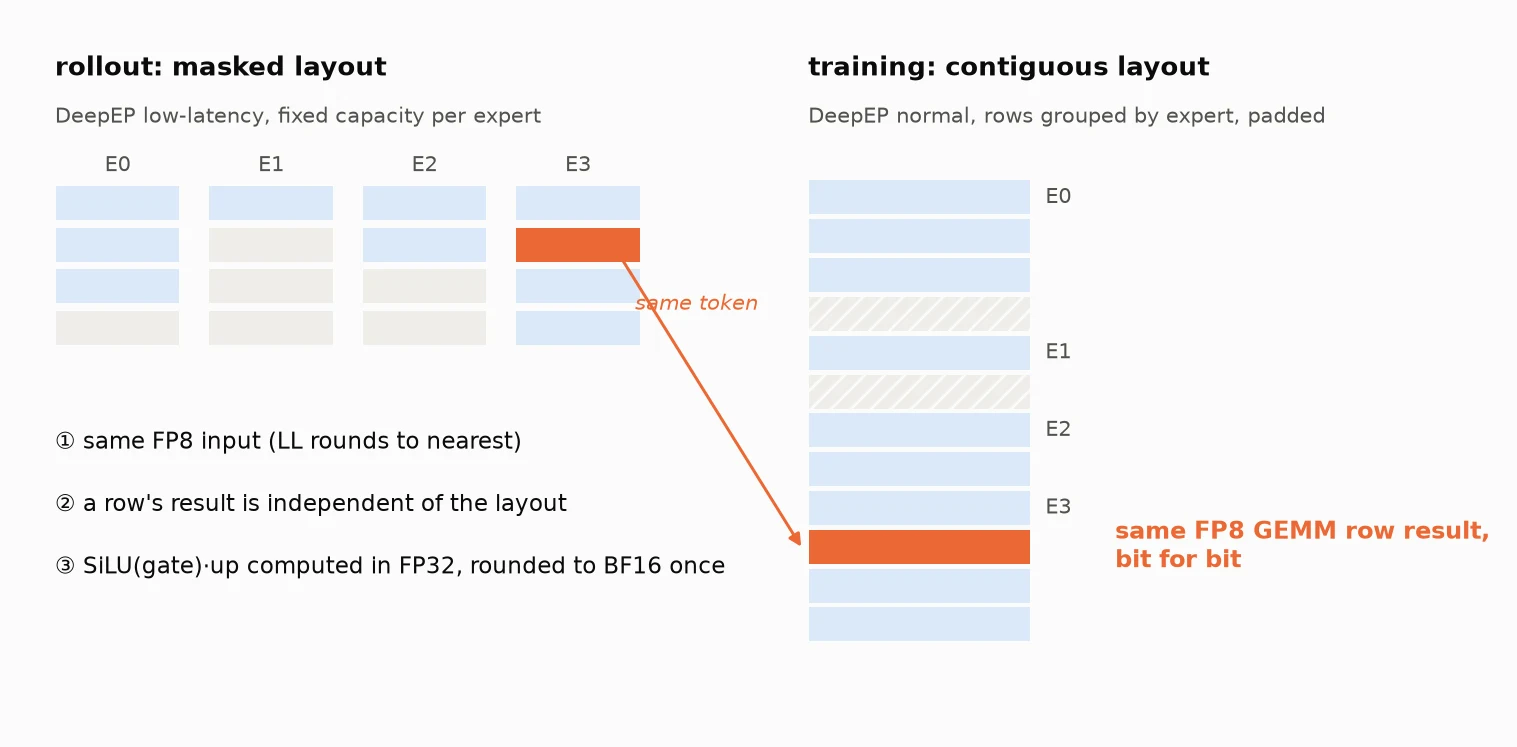
El mismo token (naranja) está en posiciones diferentes en la disposición enmascarada del rollout y la contigua del entrenamiento, y aun así las tres condiciones hacen que su resultado del GEMM de experto sea bit a bit idéntico. Gris: espacios vacíos; rayado: relleno de alineación.
No se necesita R3. El GEMM de puntuación del router usa un kernel con salida FP32 en cada tamaño de lote sobre entradas bit a bit idénticas, por lo que el enrutamiento recomputado coincide con el rollout. Esto asume 1 actualización por paso (Sección 2).
Costo. El rollout renuncia al MoE de TRT-LLM, pero el GEMM no es la mayor parte de la brecha. En el benchmark de inferencia (GB200, DP8/EP8, 256 de concurrencia, 150 de entrada / 3000 de salida por solicitud), la versión consistente partió 33% más lenta que la línea base, aproximadamente 83% de ello por comunicación LL no solapable (4.5). El entrenamiento guarda intermedios para el backward y rellena las filas de cada experto. Los números del benchmark de inferencia siguientes provienen de diferentes etapas de optimización; compáralos solo dentro de una misma oración.
Antes de comparar el rendimiento, confirme también qué kernel ejecuta la línea base: vLLM habilita el kernel de cuantización batch-invariant SiLU·mul siempre que su biblioteca compartida esté presente, ignorando el interruptor de consistencia, por lo que cualquier imagen que incluya la biblioteca también lo ejecuta en la línea base.
4.5 Reducción entre GPUs: fuera del camino comparado
Problema. El rollout quiere baja latencia y usa DP8/EP8; el entrenamiento debe acomodar activaciones de secuencias largas y usa EP32 más CP4. Como se señaló en la Sección 2, los diferentes diseños requieren resultados invariantes al grado de paralelismo, generalmente mediante un árbol de reducción fijo y costoso.
Elección. Esta receta mantiene la reducción entre GPUs fuera del camino numérico que se compara, y la comunicación restante mueve datos sin cambiar los valores:
- TP=1. Las capas lineales no tienen all-reduce. El all-reduce de vLLM elige algoritmos según el tamaño del mensaje, por lo que TP traería de vuelta esa dependencia; la receta rechaza TP>1 al arrancar.
- La fusión EP es local. El all-to-all solo mueve datos. Las salidas de los expertos regresan al rank propietario del token y se acumulan en FP32 en orden de slot top-k, independientemente de EP=8 frente a 32 o de qué rank responda primero.
- CP no hace reducción. Los ranks vecinos intercambian solo los hidden states de frontera, y el KV comprimido se hace all-gather en el grupo CP: concatenación, no sumatoria.
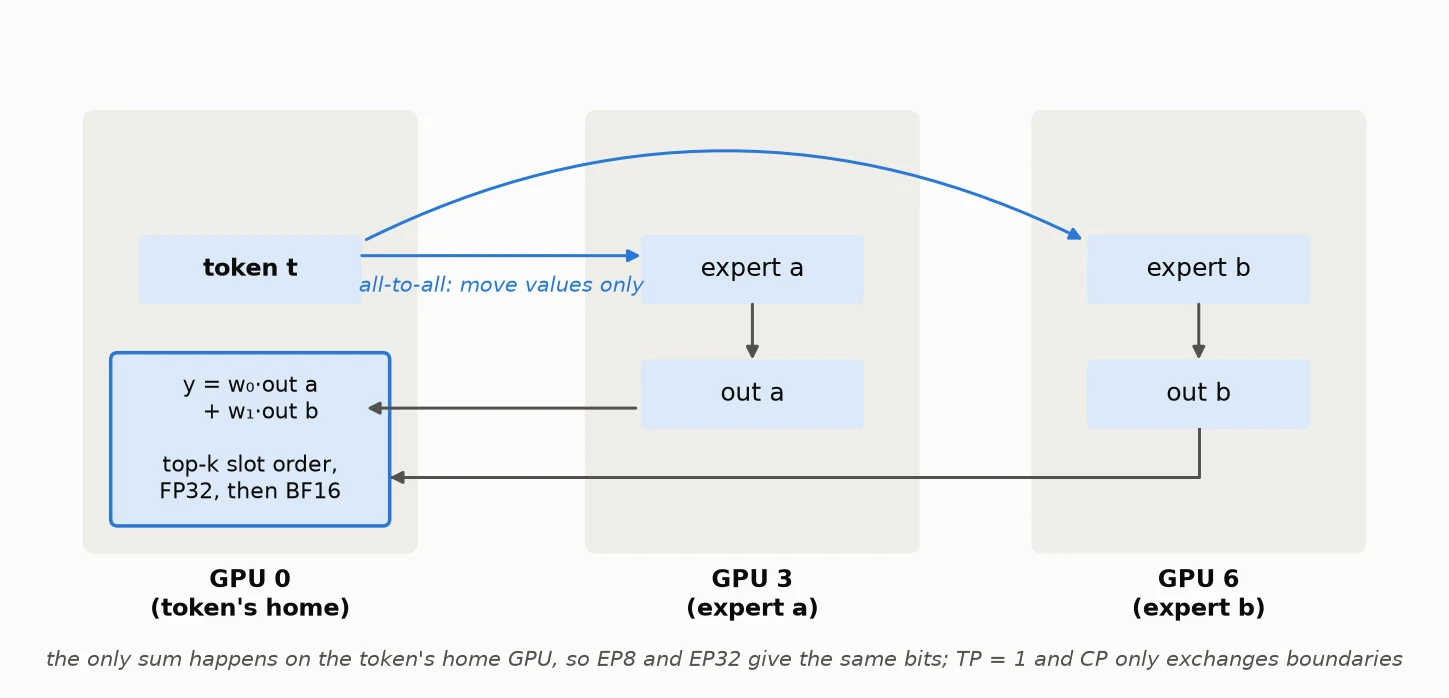
La ruta de un token: el all-to-all solo mueve datos, y la única sumatoria ocurre en la GPU propietaria del token, en FP32 en orden de slot top-k, por lo que EP8 y EP32 dan el mismo resultado.
Hacer el movimiento de datos determinista. En rollout, cada rank envía como máximo un número fijo de tokens por llamada y todos los ranks segmentan en lockstep, por lo que la forma de la comunicación es fija. Solo LL implementa esto, y el modo normal de DeepEP deshabilita CUDA Graph cuando DP>1, por lo que rollout debe usar LL. En entrenamiento, el modo normal no tiene un orden de llegada fijo, por lo que los metadatos de enrutamiento se despachan una vez más y un hash bit a bit empareja cada salida de experto con su token y slot.
Costo y recuperación. El modo LL ejecuta 43 capas × 2 = 86 all-to-alls en serie por paso que no pueden solaparse con el cómputo. Los esquemas de solapamiento entre capas que probamos computan antes de que las entradas estén listas y rompen la independencia de los lotes. Intercalar dos micro-lotes (DBO) fue 39% más lento: los pesos de los expertos de cada capa se leen dos veces, y las lecturas de pesos ya usan el 84% del ancho de banda de HBM.
Finalmente cerramos la brecha de comunicación en el benchmark de inferencia. Confirme primero que ambas ejecuciones usan el mismo transporte: perdimos dos días porque un script fijó el DeepEP de la versión consistente a Ethernet RDMA (RoCE) mientras el baseline usaba el mucho más rápido MNNVL. Con el transporte igualado y el experto compartido en un stream auxiliar, la versión consistente fue 3.2% más rápida que el baseline (16834 frente a 16313 tok/s).
TP>1 y el decode context parallel devolverían la reducción entre GPUs a la ruta comparada y aún no están soportados.
4.6 CUDA Graph: conservar los grafos y hacer que coexistan con la consistencia
Por qué conservarlos. El decode ejecuta decenas de kernels pequeños por capa por paso con un token por solicitud, por lo que la sobrecarga de lanzamiento dominaría; conservamos CUDA Graph para alcanzar el objetivo de rendimiento. Los grafos entran en conflicto con la consistencia bit a bit en tres lugares.
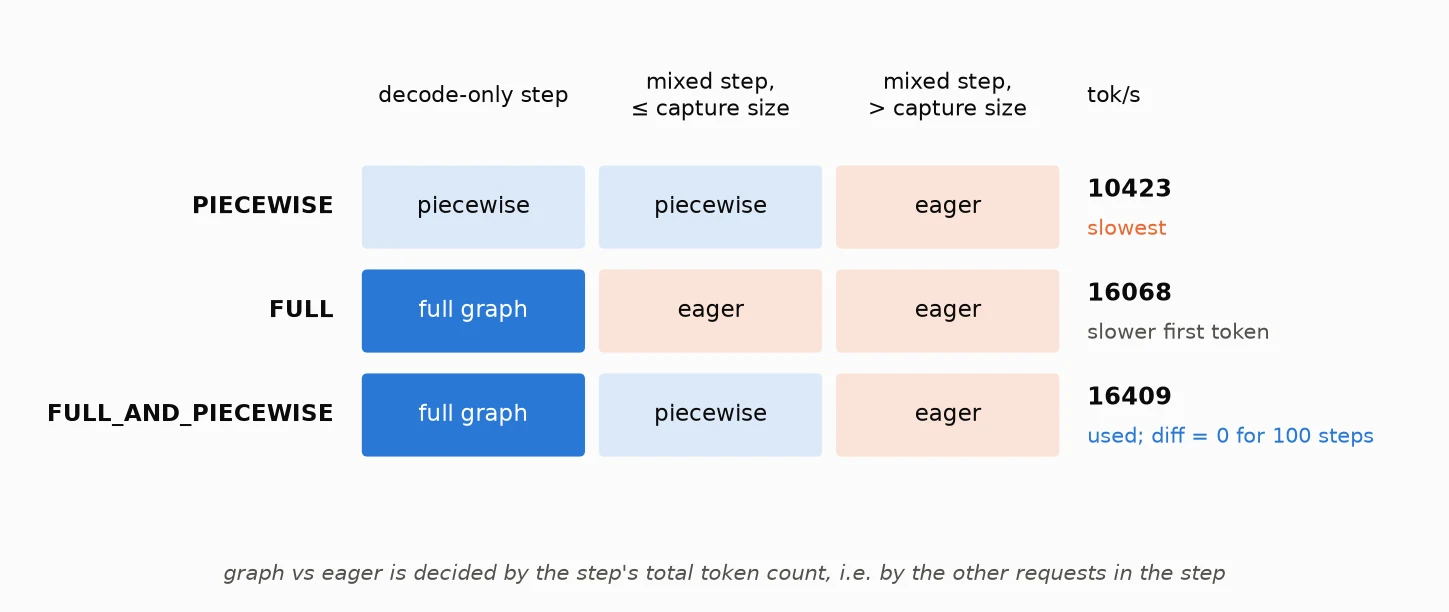
La ruta que toma cada modo para tres tipos de paso, con el rendimiento del benchmark de inferencia a la derecha. Una solicitud cambia entre grafo y eager según su lote, por lo que ambas rutas deben ser bit a bit idénticas.
Conflicto 1: grafo o eager. Un paso se ejecuta en el grafo si su conteo total de tokens cabe en el tamaño máximo de captura y en eager de lo contrario, lo que depende de los demás tokens del paso, por lo que ambas rutas deben ser bit a bit idénticas. Ese fue nuestro primer desajuste: un atajo de contexto corto del indexer quedó incrustado en el grafo en la captura según la longitud de la entrada ficticia. Hacer que la verificación dependiera solo de un límite estático superior lo corrigió.
El modo también importa. PIECEWISE no captura la atención, y FULL en DeepSeek-V4 captura solo pasos de decode puro. En el benchmark de inferencia FULL_AND_PIECEWISE da 16409 tok/s, FULL 16068 y PIECEWISE 10423; FULL ejecuta cada paso mezclado con prefill en eager, aumentando el tiempo hasta el primer token de 764 ms a 1792 ms. Usamos FULL_AND_PIECEWISE: grafos completos para pasos de decode puro, captura por partes para pasos mixtos; el diff se mantiene en 0 durante la ejecución de 100 pasos.
Conflicto 2: sin sincronización con el host ni formas dependientes del lote dentro del grafo. Esto se alinea con la consistencia, y muchos diseños sirven a ambos: la pista de planificación del MoE usa capacidad estática en lugar de leer los conteos de tokens por experto de vuelta al host (4.4); LL fija la forma de la comunicación (4.5); los workspaces se dimensionan solo por los límites del modelo, se asignan antes de la captura y luego se bloquean; las ramas de atajo solo de rendimiento se deshabilitan al momento de la captura.
Conflicto 3: los grafos capturan direcciones, los pesos cambian en cada paso. Rollout debe copiar los nuevos pesos a su almacenamiento original y recomputar en su lugar los parámetros derivados de los pesos, en lugar de asignar nueva memoria que dejaría al grafo en direcciones antiguas. Emparejar en el primer paso no es suficiente, por lo que la habilidad compara de nuevo después de la actualización, la exportación y la recarga.
Costo. Los workspaces reservados en su límite superior cuestan algo de memoria. Otras recuperaciones de velocidad (eliminar el padding de depuración innecesario y el arranque en frío de rollout, un zeroing más rápido del caché KV) aplican a ambas ejecuciones; el baseline también debe recibirlos, o el número de pérdida de rendimiento no tiene sentido.
5. Reducir el costo de ingeniería con Agent + skill
A y B pueden coexistir, pero la tabla maestra de la Sección 4 y las decisiones clave en ella requieren criterio experto: qué backend es batch-invariant, que las elecciones discretas necesitan empates y orden alineados, cómo alinear la cuantización y el orden de fusión entre diferentes modos de comunicación, y que una brecha de comunicación primero requiere descartar una diferencia de transporte. Un modelo, precisión o hardware nuevo significa empezar de cero, por lo que C no se cumple.
Después de DeepSeek-V4-Flash, vimos que la mayor parte de este trabajo cae en dos categorías, cada una con una meta medible:
- Llevar el diff a 0. Fijar pesos e entrada, encontrar el primer operador donde ambos lados divergen, reducirlo a un repro mínimo reejecutable, corregirlo y luego verificar en entrenamiento real. Las salidas se comparan directamente.
- Optimizar el rendimiento manteniendo el diff en 0. Perfila los puntos críticos, opera los operadores A/B individuales y vuelve a verificar la consistencia después de cada cambio. Las aceleraciones que cambian los resultados o que aparecen solo en micro benchmarks, no en un despliegue real, no cuentan; ralentizar el caso base para reducir la brecha no está permitido.
Leer código, trazar cadenas de llamadas, localizar divergencias, escribir repros, modificar kernels y volver a ejecutar las regresiones es un trabajo de larga duración adecuado para un agente, con el éxito decidido por la comparación de consistencia y la medición del rendimiento.
Lo empaquetamos como la skill train-inference-consistency: le dice a un agente qué hacer y en qué orden, y qué debe alcanzar cada paso para aprobar, de modo que el proceso se traslade a otros modelos.
La skill tiene 11 gates (C0–C10) con condiciones de aprobación explícitas. Para acelerar el arranque en frío, primero recortamos unas pocas capas del modelo completo en un modelo pequeño, resolvemos la mayoría de los problemas ahí y luego pasamos al modelo completo. Cinco pasos:
- Fijar el objetivo y la línea base (C0–C1). Listar los módulos del modelo con su precisión y paralelismo. Ajustar la versión ordinaria, no consistente (la línea base) hasta un rendimiento alto normal para revisión humana. Es el denominador de «cuánto más lenta es la versión consistente».
- Hacer la inferencia autoconsistente en un modelo pequeño (C2–C4). El modelo pequeño (normalmente 4–6 capas escogidas del modelo completo) debe contener cada clase de operador, conservar la interacción entre capas adyacentes y coincidir en tamaño por capa y cuantización, de modo que reproduzca la mayoría de los problemas numéricos locales. La profundidad completa, el contexto largo, la distribución multi-GPU y la presión de memoria aún deben aceptarse en el modelo completo. Primero, hacer que el motor de inferencia sea internamente consistente: una petición da el mismo resultado sola y en un lote, y el procesamiento de la entrada completa coincide con el token a token. Mientras tanto, buscar problemas estructurales que ralenticen la versión consistente.
- Conectar el entrenamiento (C5–C7). El entrenamiento llama a los mismos operadores que la inferencia, recalcula los datos generados por la inferencia y compara token a token; ante una discrepancia, compara capa por capa para encontrar la primera capa divergente. Luego añadir el backward y comprobar los gradientes contra una implementación de referencia independiente del código bajo prueba: un forward consistente no implica gradientes correctos.
- Ejecutar RL y luego cambiar al modelo completo (C8–C9). En el modelo pequeño, ejecutar dos actualizaciones consecutivas en el framework de entrenamiento real, comparando bajo la misma versión de pesos antes y después de cada una. Tras la revisión humana, cambiar al modelo completo y escalar por pasos, incluyendo la comprobación del primer paso tras restaurar un checkpoint.
- Recuperar el rendimiento (C10). Optimizar los operadores más costosos uno por uno, volviendo a comprobar la consistencia cada vez, y luego ejecutar una comparación pareada contra la línea base en la imagen de entrega.
Dos decisiones de diseño importan más que ninguna otra. Primera, dos agentes avanzan en paralelo la línea base y la consistencia: uno hace rápida la línea base, el otro construye la versión consistente. La línea base ajustada se congela para revisión humana, de modo que el agente no pueda ralentizarla para estrechar la brecha. Segunda, nuestros errores están escritos en el proceso: el programa en ejecución debe coincidir con el código fuente que se está leyendo; los checkpoints requieren verificar el primer paso posterior a la restauración, no solo un guardado; toda conclusión de rendimiento necesita una línea base justa y datos brutos trazables; antes de comparar cuellos de botella de comunicación, confirmar que ambas ejecuciones usan el mismo transporte (la lección de 4.5).
La skill reduce el coste de la localización y la regresión (el ahorro aún no se ha cuantificado aquí); no sustituye el juicio humano: los humanos siguen revisando la línea base, los compromisos de precisión y la receta. Un ejemplo es la deriva de enrutamiento con varias actualizaciones por paso: el agente construyó un repro a pequeña escala a partir del síntoma, ejecutó experimentos discriminantes y eliminó hipótesis, y un humano decidió pasar a 1 actualización por paso.
6. Transferencia: Nemotron, una arquitectura híbrida Mamba + NVFP4
Luego probamos la receta de referencia y la skill en un modelo estructuralmente muy diferente.
Nemotron-3.5-Lightning-30B-A3B (NVFP4) es un híbrido Mamba-2 / attention / MoE (expertos enrutados NVFP4 W4A16, proyecciones Mamba en FP8, caché KV FP8 para attention) sobre GB200. La línea base usa entrenamiento NVFP4 QAT (regla de cuantización y exportación de NVIDIA ModelOpt) + R3 route replay; la versión consistente comparte el forward de vLLM, sin route replay. Ambas ejecuciones usan pesos maestros BF16 y 1 actualización por paso.
Las estructuras recurrentes tienen precedentes. En la comunidad de vLLM, Alexander Jiang y el equipo de SkyRL diseñaron el recurrente paralelo por chunks (CPR) en IsoExec para el Gated DeltaNet (GDN) en Qwen3.5-35B-A3B: mantiene la forma recurrente pero computa en paralelo por chunks, de modo que entrenamiento, prefill y decode comparten un único orden de redondeo, y su modelo unificado da a entrenamiento e inferencia una sola definición de modelo y un solo conjunto de kernels alineados. El «zero mismatch» de IsoExec se mantiene dentro de su contrato de ejecución; de extremo a extremo sigue reportando una pequeña diferencia de logprob distinta de cero (diferencia absoluta media de alrededor de 1e-7), a diferencia del «bitwise identical» de esta publicación. Mamba-2 es el mismo tipo de recurrencia lineal. Hacemos que el decode reproduzca exactamente la aritmética por chunks del prefill en lugar de su propia recurrencia de un paso, y el entrenamiento importa los mismos operadores que la inferencia, como en el modelo unificado. Agente + skill hicieron esta alineación.
En vLLM, cada operador que pueda depender de la composición del lote tiene una implementación batch-invariant, y el entrenamiento (un fork ligero de Megatron-LM) los importa:
| Operador | Versión consistente |
|---|---|
| Scan SSD de Mamba-2 | decode repite exactamente la aritmética por chunks del prefill, configuración de autotune fija, estado en fp32 |
| Atención | FlashAttention con split-KV fijo, número de splits independiente del batch |
| Expertos enrutados (NVFP4 W4A16: pesos de 4 bits, activaciones de 16 bits) | GEMM agrupado en CuTe-DSL, una sola táctica, sin split-K, fusión en fp32 en orden de slot |
| MoE all-to-all | comunicación unidireccional, orden de fusión fijo |
| Router GEMM | Matmul persistente invariante al batch, salida en fp32 |
| Norma / cuantización FP8 | Kernels unificados invariantes al batch; prohibidas las fusiones que cambian valores |
Resultados: entrenamiento en SWE-bench Pro
Ejecutamos RL agéntico en SWE-bench Pro en sandboxes remotas: 32 tareas × 8 trayectorias por paso, unos 57K tokens por trayectoria de media, GRPO, 8 nodos GB200 por ejecución. El conjunto de entrenamiento son las 375 tareas de SWE-bench Pro en las que los 4 intentos muestreados del modelo base no fueron ni todos correctos ni todos incorrectos y el parche gold pasa en nuestra sandbox, por lo que las puntuaciones siguientes son recompensas de entrenamiento en este subconjunto. Ambas ejecuciones usan la misma imagen y receta, sin correcciones como TIS o MIS. Con 1 actualización por paso, la KL entre los logprobs del rollout previo a la actualización y la recomputación del lado del entrenamiento es la KL entrenamiento-inferencia de ese paso.
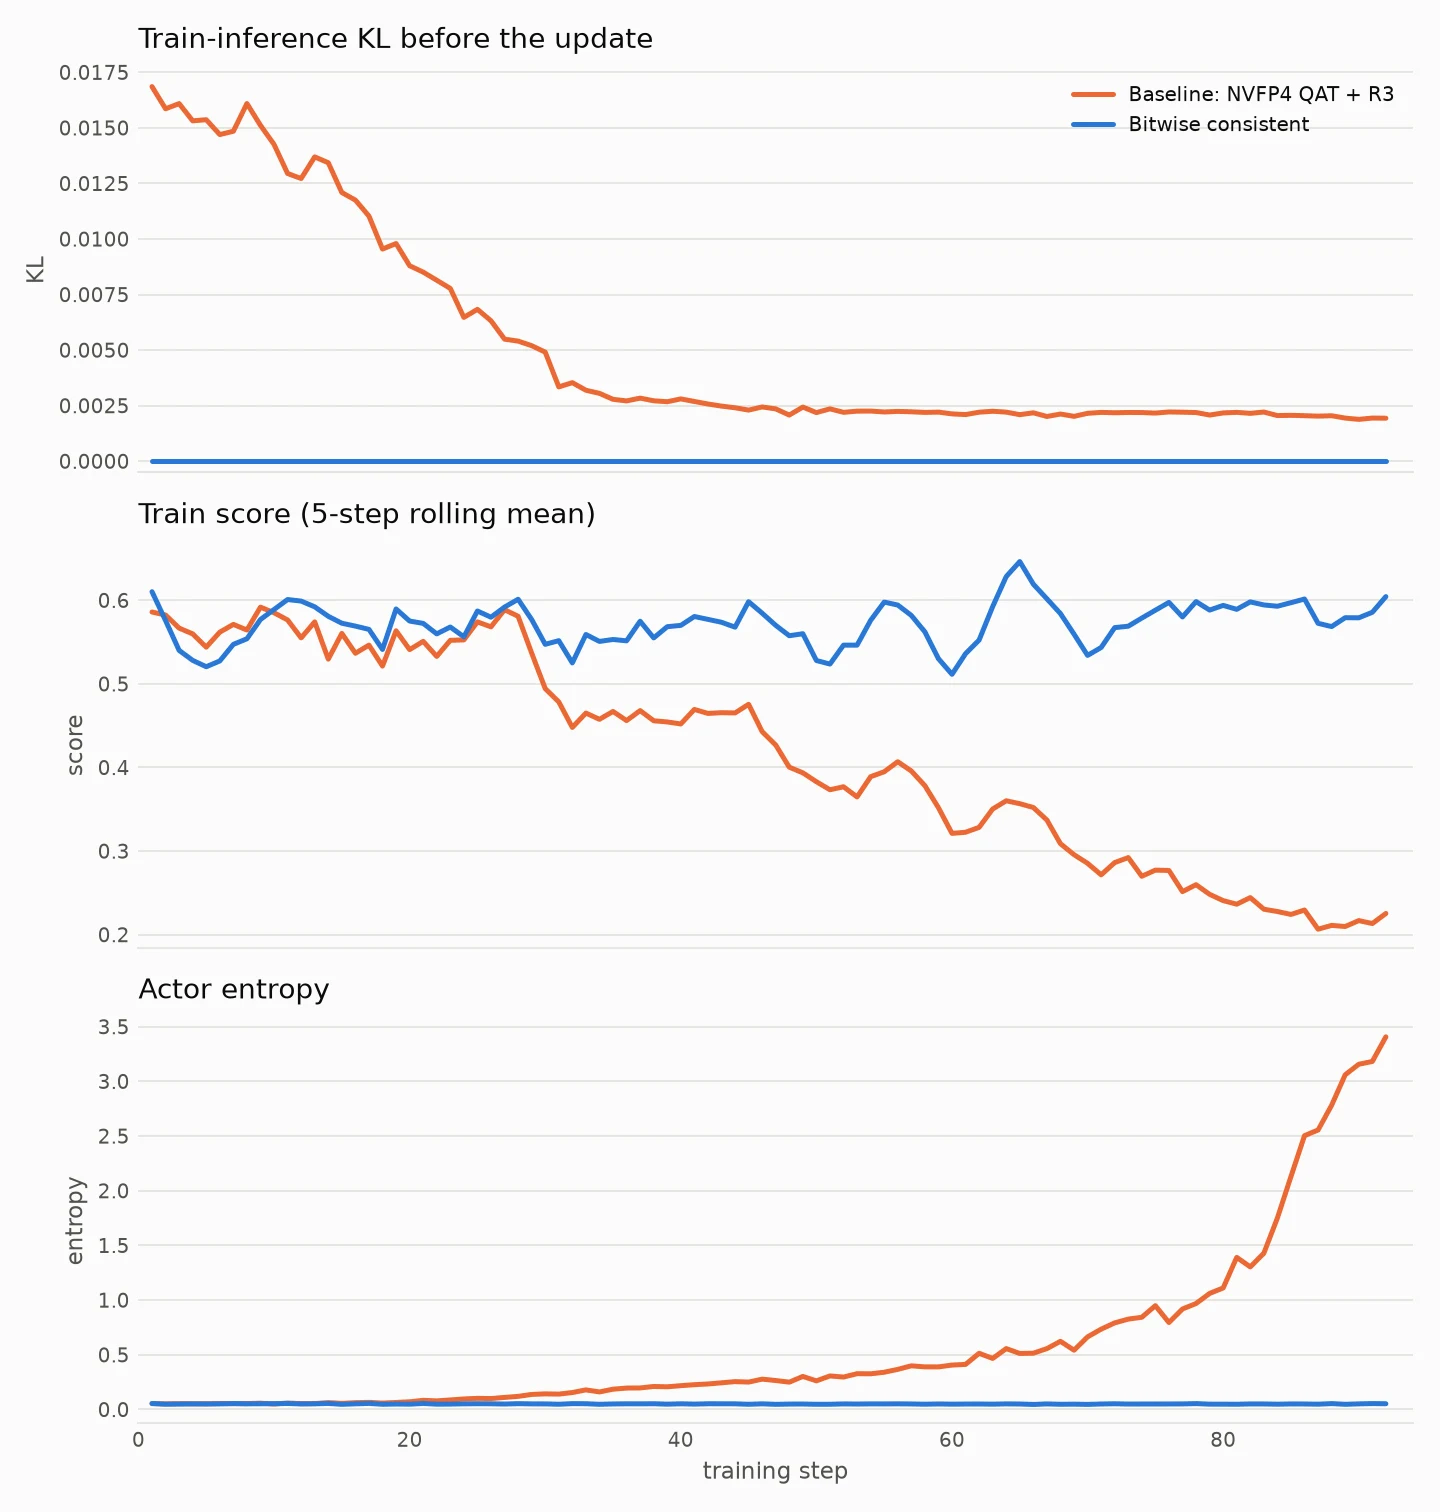
Arriba: KL entrenamiento-inferencia por paso; medio: puntuación de entrenamiento (media móvil sobre el paso actual y los 4 anteriores); abajo: entropía del actor. Naranja: baseline; azul: versión consistente. En el paso 10 de la versión consistente solo regresaron unas pocas trayectorias de la sandbox, por lo que su puntuación se excluye.
- Versión consistente: la KL entrenamiento-inferencia es exactamente 0 en cada paso, la entropía se mantiene en torno a 0.05, y la puntuación pasa de 0.56 (primeros 10 pasos) a 0.59 (últimos 10), sin caídas.
- Baseline: la KL entrenamiento-inferencia cae de ~0.015 a ~0.002, pero la entropía sube de 0.05 a 2.6 y la puntuación baja de 0.56 a 0.22 (primeros 10 pasos frente a los últimos 10).
- Velocidad de rollout: durante los primeros 30 pasos, mientras ambas ejecuciones están sanas, el throughput de rollout de la versión consistente es el 87.5% del del baseline, solo un 12.5% más lento.
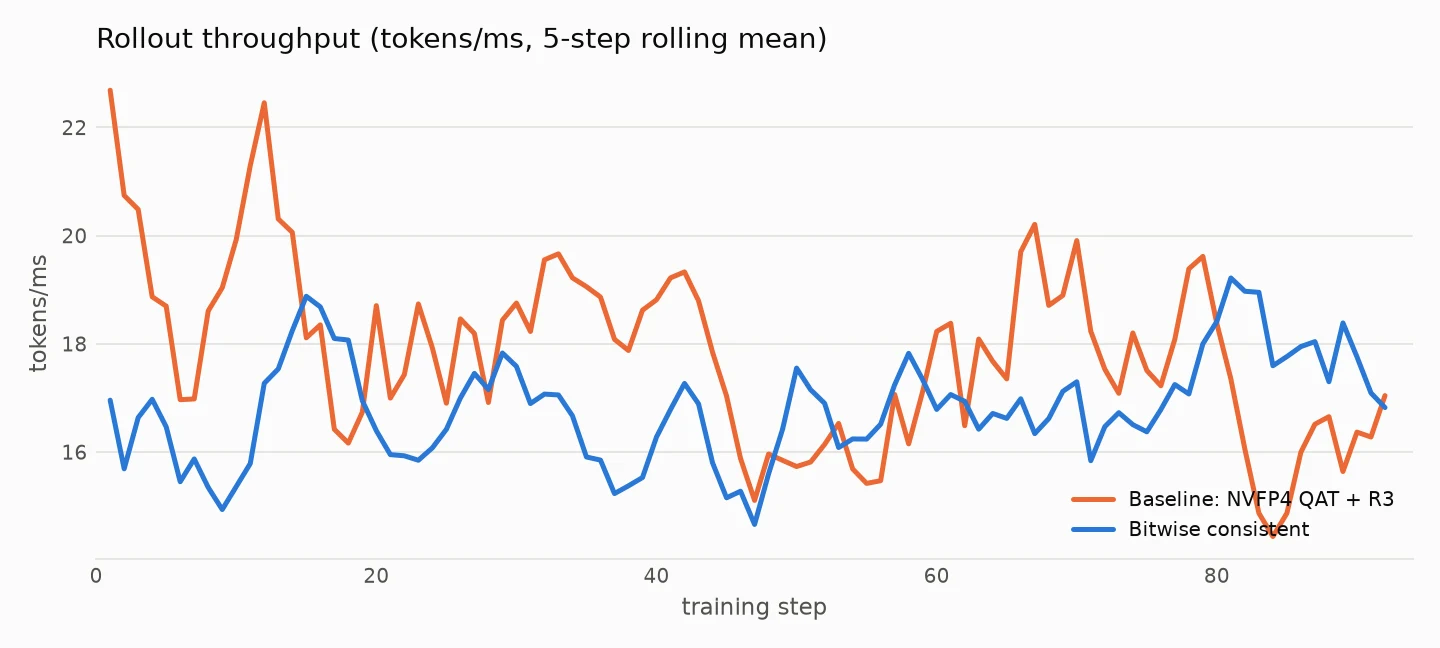
Throughput de rollout por paso (token/ms, media móvil sobre el paso actual y los 4 anteriores). Naranja: baseline; azul: versión consistente.
7. Código abierto
Hacemos esto de código abierto para que otros puedan alcanzar la consistencia entrenamiento-inferencia con menos dependencia de ingenieros senior que revisen operador por operador, usando el skill, el código listo para usar y un agente sobre su propio modelo. La publicación incluye:
- skill de consistencia entrenamiento-inferencia: el flujo de trabajo completo (C0–C10), diez guías y prácticas clave como la comparación de logprobs y la verificación cruzada de gradientes;
- DeepSeek-V4: una receta de RL verdaderamente on-policy que alcanza 0 diff en Megatron y vLLM, verl-project/verl#7688;
- Nemotron-3.5-Lightning-30B-A3B (pesos maestros BF16, cuantizados al NVFP4 de despliegue en el forward de entrenamiento y en la sincronización de pesos):
- Inferencia de vLLM bit a bit consistente con el entrenamiento: aoshen02/vllm#85;
- Un actor de entrenamiento alineado con vLLM: aoshen02/Megatron-LM#7;
- Dos cambios en verl: aoshen02/verl#11;
- Receta de consistencia entrenamiento-inferencia y Dockerfile de imagen unificada: aoshen02/verl#12.
Se agradecen los issues, PRs y comentarios derivados de usar el skill sobre su propio modelo.
Siguiente paso: la consistencia entrenamiento-inferencia para DeepSeek-V4.1 ha alcanzado 0 diff; la optimización de rendimiento está en curso y tendrá su propia publicación.
Agradecimientos
Gracias a (organizaciones en orden alfabético):