
Nuestra última versión, Apertus 1.5, amplía los modelos Apertus 1.0 de 8B y 70B con comprensión de imagen/audio, un modo de pensamiento opcional, una ventana de contexto cuatro veces más larga, mejor seguimiento de instrucciones y un mejor uso de herramientas. El los pesos de los modelos de 8B y 70B fueron publicados en Hugging Face el 24 de julio de 2026 bajo una licencia Apache 2.0. Ahora hay más detalles disponibles del proyecto Informe técnicoy se resume aquí.
Apertus 1.5 es un preentrenamiento continuado del modelo de primera generación: se añadieron 4 billones de tokens de datos de entrenamiento de texto y multimodales al modelo de 8B y 2 billones de tokens al modelo de 70B, para un total de 19T y 17T, respectivamente. Como en cada versión de Apertus, los modelos son completamente abiertos: abiertos pesos, abre datos, abrir valores`, y formación completa` detalles.
Mejoras clave
- Comprensión multimodal nativa: Apertus 1.5 acepta imágenes y audio junto con texto, incorporando documentos, diagramas y fotos a la conversación. Los modelos también pueden procesar el habla, aunque esto sigue siendo experimental.
- Modo de pensamiento: Los modelos se pueden cambiar a un modo de pensamiento para razonar sobre la entrada antes de responder, lo que mejora el rendimiento en problemas de razonamiento.
- Contexto largo: La ventana de contexto crece a 262,144 tokens, un aumento de 4x respecto a Apertus 1.0.
- Seguimiento mejorado de instrucciones: Mejor adherencia a las instrucciones que Apertus 1.0 proporciona respuestas más predecibles y precisas.
- Uso mejorado de herramientas: Los modelos se entrenan para lograr una mejor integración de herramientas, lo que permite un uso más eficaz de herramientas externas y APIs.
- Valores Abiertos: Mayor adherencia a la Carta de Apertus, que aporta transparencia a los valores y principios del modelo.
Proceso de entrenamiento
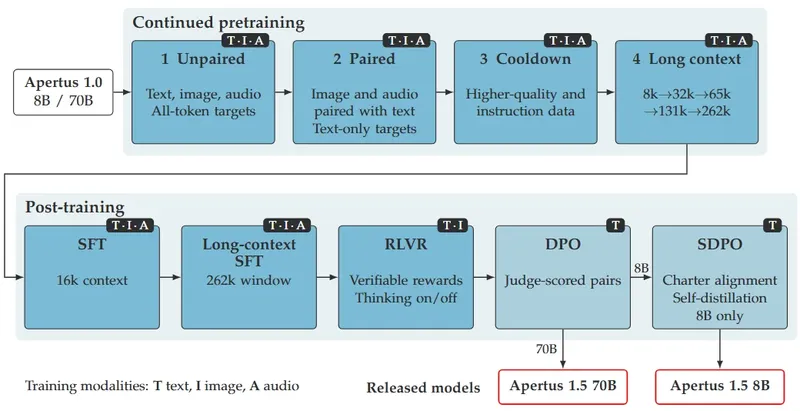
 El pipeline completo de entrenamiento de Apertus 1.5
Multimodalidad a través del tokenizador
Introducimos la multimodalidad en los modelos v1.5 de manera de fusión temprana, donde las imágenes y el audio entran en Apertus como tokens discretos en la misma secuencia que los tokens de texto, en lugar de usar un codificador de visión separado. Las imágenes se tokenizan con el Emu3.5 tokenizer (una imagen de 512×512 se convierte en 1,024 tokens) y audio con WavTokenizer (40 tokens por segundo). Solo ampliamos el vocabulario, así que la arquitectura permanece sin cambios y el entrenamiento corre a la velocidad de solo texto. Los modelos comprenden imágenes y audio pero generan únicamente texto.

Preentrenamiento
Partiendo de Apertus 1.0, continuamos el preentrenamiento en cuatro etapas:
- Sin emparejar: texto más imágenes y audio independientes, para que el modelo aprenda las nuevas modalidades.
- Emparejado: pares imagen–descripción y audio–transcripción, para que los alinee con el lenguaje.
- Enfriamiento: datos de mayor calidad con más matemáticas y código.
- Contexto largo: la ventana crece paso a paso de 8k a 262k tokens.
En total, más de la mitad de los tokens de entrenamiento son de solo texto, lo que preserva las habilidades lingüísticas de Apertus 1.0. Los datos de texto se actualizan con fuentes como FineWeb2-HQ+, FinePDFs y Nemotron-CC. Todos los datos nuevos, incluidos los multimodales, cumplen el mismo criterio que antes: disponibles públicamente, con licencias permisivas y con las exclusiones de robots.txt respetadas retroactivamente. Cada fuente está listada en apertus-data-transparency.
Posentrenamiento
El posentrenamiento se ejecuta en cinco etapas: SFT → SFT de contexto largo → RL → DPO → alineación con la carta (SDPO).
- SFT sobre 3.7M de muestras de texto más datos de imagen y voz. Las trazas de razonamiento se añaden solo a los prompts que el modelo no puede resolver ya sin ellas. Los datos de uso de herramientas se restringen a trayectorias verificadas por ejecución. Publicamos la mezcla de SFT de texto que usamos en Hugging Face.
- SFT de contexto largo en la ventana completa de 262k restaura la capacidad de contexto largo que el SFT de contexto corto erosiona.
- RL con recompensas verificables (RLVR) sobre unos 350k prompts de matemáticas, código, seguimiento de instrucciones, multilingües y de visión, mezclando pensamiento activado y desactivado.
- DPO con pares de preferencia calificados por jueces mejora la calidad del chat, el uso de herramientas y la seguridad. Publicamos el grupo de preferencias y pares de entrenamiento.
- SDPO alinea el modelo con el Carta de Apertus mediante retroalimentación de jueces y auto-distilación.
Resultados de la evaluación
Junto con las capacidades extendidas del modelo, también ampliamos significativamente el alcance de las evaluaciones. Más allá de las evaluaciones basadas en texto existentes utilizadas para Apertus 1.0, añadimos evaluaciones multimodales (imagen y audio) y evaluaciones en modo de razonamiento (thinking-mode).
Las evaluaciones multimodales se realizan a través del MLLM-eval-suite pipeline, que fusiona dos importantes marcos de evaluación multimodal: lmms-eval y VLMEvalKit. También añadimos una serie de benchmarks basados en texto, además de benchmarks ampliados de traducción y capacidades multilingües, seguridad y uso de herramientas. Estos se pueden encontrar en nuestro repositorio de post-entrenamiento evaluation repository, basado en un fork de lm-evaluation-harness.
Aunque todavía va por detrás de los modelos frontera de pesos abiertos, la nueva versión también ha mejorado significativamente el rendimiento en capacidades de codificación y seguimiento de instrucciones, con Apertus 1.5 8B superando a modelos de pesos abiertos de tamaño similar en tareas de IF y multilingües. El modo de razonamiento mejora aún más el rendimiento en benchmarks exigentes con alta carga de razonamiento como AIME. El rendimiento multimodal del modelo está más cerca de Gemma 4 12B y de otros modelos actuales de pesos abiertos. El rendimiento multimodal de Apertus 1.5 es competitivo en comprensión espacial entre los modelos de pesos abiertos y en comprensión de documentos/gráficos entre los modelos de código abierto.
También agradecemos a nuestros colaboradores y evaluadores externos su ayuda con la evaluación eficiente de las capacidades de Apertus. En particular, Apertus 1.5 muestra un rendimiento sólido en tareas legales suizas, estando a la par con los modelos de pesos abiertos líderes (blog, code). Además, en Last Translation Benchmark, Apertus 1.5 8B presenta capacidades de traducción automática que igualan a GPT-OSS-20B y superan a modelos como Claude Haiku 4.5 o Google Translate (tabla de clasificación, artículo).
Tarjetas de evaluación: Apertus ❤️ EvalEval
Apertus colabora con la Coalición EvalEval para garantizar una evaluación comparativa completamente transparente y reproducible. Publicamos los resultados de Apertus 1.5 en el esquema Every Eval Ever (EEE) , un formato compartido que registra no solo las puntuaciones, sino también quién realizó la evaluación, cómo se accedió al modelo, la configuración de generación y cómo debe interpretarse cada métrica: detalles que suelen faltar en las tablas de clasificación y que a menudo explican por qué puntuaciones aparentemente similares difieren.
Los resultados se muestran en la Eval Card a continuación, que combina los datos de la ejecución con los metadatos del benchmark y del modelo en un único registro interpretable, y también están disponibles a través de Hugging Face Community Evals. Esta es la misma infraestructura que el UK AI Security Institute utiliza para publicar sus evaluaciones de forma abierta. Dado que nuestras evaluaciones de texto se ejecutan en nuestro fork público de lm-evaluation-harness, que EEE admite con un convertidor dedicado, cualquiera puede volver a ejecutarlas y comparar sus números con los nuestros bajo configuraciones idénticas.
Los informes de evaluación estructurados también importan más allá de la investigación. EvalEval ha mapeado las Evaluation Cards con los requisitos de gobernanza de IA, incluyendo el Artículo 55 del EU AI Act y el GPAI Code of Practice, y encontró que el esquema EEE puede representar 56 de los 60 elementos de presentación de informes de evaluación que estos marcos exigen. Esto encaja con cómo ya publicamos Apertus: junto con los modelos, publicamos un Resumen Público del Contenido de Entrenamiento y, de forma voluntaria, un documento de Code of Practice . Los registros de evaluación legibles por máquina son un siguiente paso natural: facilitar que los reguladores, los desplegadores y los investigadores encuentren, interpreten y comparen la evidencia detrás de un modelo.
Estamos comprometidos con promover la evaluación reproducible y transparente mediante las Eval Cards y el esquema EEE, y animamos a otros desarrolladores de modelos a informar sus resultados de la misma manera, para que las puntuaciones puedan compararse entre modelos y organizaciones.
Reproducibilidad de Apertus 1.5
Todas las recetas, ablaciones y mezclas de datos están documentadas en el Informe Técnico. Nuestro objetivo es popularizar el desarrollo de modelos abiertos haciendo público y accesible el proceso de entrenamiento de la v1.5. Los checkpoints intermedios están alojados en nuestra colección de Apertus 1.5 en Hugging Face, incluyendo los pesos base, SFT, RLVR y DPO, así como nuestras mezclas de datos de entrenamiento curadas/conjuntos de datos personalizados en la colección de datasets de Apertus 1.5. Compartirlos permite a los investigadores investigar cómo cada etapa cambia el comportamiento del modelo.
El informe cubre numerosas ablaciones sobre el efecto de los datos de post-entrenamiento en diferentes etapas, donde observamos que los datos multimodales mezclados junto con los datos de texto durante el SFT ayudan a mejorar en todas las modalidades. También encontramos que los beneficios de los razonamientos multimodales sobreviven al posterior aprendizaje por refuerzo solo de texto: partiendo de un checkpoint SFT entrenado con razonamientos multimodales, el RL mejora las matemáticas más que cuando se parte de un checkpoint solo de texto, y la ventaja en tareas de razonamiento persiste durante todo el entrenamiento.
| Modelos | 8B | 70B |
|---|---|---|
| Pre-entrenamiento (base de contexto largo) | Apertus-v1.5-8B-base | Apertus-v1.5-70B-base |
| Ajuste fino supervisado (SFT) | Apertus-v1.5-8B-SFT | Apertus-v1.5-70B-SFT |
| Aprendizaje por refuerzo (RLVR) | Apertus-v1.5-8B-RLVR | Apertus-v1.5-70B-RLVR |
| Alineación de preferencias (DPO) | Apertus-v1.5-8B-DPO | Apertus-v1.5-70B (final) |
| Alineación con la carta (SDPO) | Apertus-v1.5-8B (final) | – |
| Etapa | Datos | Código / receta |
|---|---|---|
| Preentrenamiento: Etapas 1–2 (sin emparejar, emparejado) | Todas las fuentes con versiones y licencias en apertus-data-transparency; recetas de procesamiento de visión y audio en multimodal-data | Megatron-LM, scripts de lanzamiento en pretrain-code, apertus-omni-tokenizer, benchmark-image-tokenizer, benchmark-audio-tokenizer (incl. constructor de habla–texto intercalado) |
| Preentrenamiento: Etapa 3 (cooldown) | apertus-data-transparency; conjuntos de datos de imágenes curados NASA, Our World in Data, Smithsonian, swisstopo | Megatron-LM, scripts de lanzamiento en pretrain-code |
| Extensión de contexto largo | apertus-data-transparency; tareas sintéticas de contexto largo en LongContextQA | Megatron-LM, scripts de lanzamiento en pretrain-code |
| SFT | Apertus-v1.5-SFT-mix (mezcla SFT multimodal listada en el informe) | posttraining-data, Megatron-LM (scripts de lanzamiento SFT) |
| SFT de contexto largo | Subconjuntos de la mezcla SFT (listados en el informe), además de LongContextQA tareas | Megatron-LM |
| RL (RLVR) | Mezcla listada en el informe | verl, verl-recipe |
| DPO | Apertus-v1.5-Preference-Pool (completaciones anotadas), Apertus-v1.5-Preference-Data (pares) | posttraining, verl |
| SDPO (alineación con el charter, solo 8B) | gretelai/gretel-safety-alignment-en-v1 | autoDestilación |
Disponibilidad de los modelos
Proton Lumo y Infomaniak Euria son dos aplicaciones muy utilizadas que recientemente han integrado Apertus 1.5. Estos despliegues están enlazados en el Community Showcase entre otros - véase este hilo de discusión para una vista previa.
El acceso a Apertus 1.5 en forma de API para desarrolladores ha sido anunciado por una serie de proveedores, incluidos Swisscom, Infomaniak, Phoeniqs, y otras empresas enumeradas en nuestra guía de disponibilidad general. El informe también proporciona detalles sobre cómo trabajamos con evaluadores externos para probar y preparar los modelos.
Las instrucciones técnicas para ejecutar los modelos se encuentran en las tarjetas de modelo de las versiones de Apertus en Hugging Face y en nuestra guía de inicio rápido.
Cómo participar
¡Gracias por leer esta entrada del blog y por formar parte de nuestra comunidad! Acabamos de celebrar cinco millones de descargas en nuestras analíticas de Hugging Face 🤗 y no vamos a frenar. En el reciente AI+X Summit en Zúrich, nuestro equipo anunció la hoja de ruta para Apertus 2.0: arquitectura sparse/MoE, ~600B de parámetros totales, calendario de entrenamiento extendido, con agentes, matemáticas y programación como prioridades.
En resumen: les invitamos a leer nuestro informe, descargar los modelos, explorar los checkpoints intermedios, ajustar los pesos y reproducir nuestras evaluaciones. Las preguntas que aún no estén cubiertas en nuestras publicaciones o en las preguntas frecuentes del sitio web siempre son bienvenidas, y también nos encantaría saber qué temas serían más útiles para la comunidad en futuros análisis a fondo.
Si desarrolla con Apertus o lo utiliza, por favor complete el formulario de Showcasey contáctenos a través de las opciones de nuestra página de contacto. Esperamos destacar más trabajos, saber qué está construyendo y escuchar cómo se puede mejorar Apertus!
Citación
Project Apertus, et al. "Apertus 1.5: From Open Text Models to Open Multimodal Reasoners." arXiv:2610.15542. Preprint, arXiv, 11 de octubre de 2026. https://doi.org/10.48550/arXiv.2610.15542.
@misc{apertus2026apertus15opentext,
      title={Apertus 1.5: From Open Text Models to Open Multimodal Reasoners},
      author={Project Apertus and Yixuan Xu and Yassine Turki and Vinko Sabolčec and Valentina Pyatkin and Tommy Chu and Sven Najem-Meyer and Sean F. Carroll and Robert Smith and Raphael Kreft and Oscar Alessandro Tazza and Oleg Lavrovsky and Nicola Irmiger and Matteo Santelmo and Marian Schneider and Juan García Giraldo and Hanna Yukhymenko and Eduard Ďurech and Davit Melikidze and Dani Tamayo and Bettina Messmer and Aryan Ahadinia and Anunay Yadav and Allen Huang and Ahmad Fraij and Alessandro Bombarda and Alex Padula and Alexander Hägele and Alexander Sternfeld and Anna Hedström and Anna Kosovskaia and Arthur Wuhrmann and Arundhati Balasubramaniam and Badr Al Mahouri and Barna Pasztor and Bartosz Szostakiewicz and Bich Ngoc Doan and Bryan Schmid and Burak Sezen and Camille Challier and Clément Charmillot and Dana Shayakhmetova and Daniel Perruchoud and David Brüggemann and David Isztl and Elia Palme and Emma Anastassova and Fabian Bösch and Faruk Zahiragić and Fawzi Roberto Mohamed and Fiona Panicali and Florian Kolly and Flynn Guerra and Francesco Monti and Frederike Lübeck and Gennaro Oliva and Haofeng Yang and Haoliang Shang and Helen El Khoury and Henrique Mendonça and Jannis Vamvas and Jérome Landolt and Jessica Lam and Jingchun Xiao and Jonathan Coles and Joshua Oyebanji and Khanh Nguyen and Konstantinos Pitas and Lasse B. Strand and Li Mi and Loïc Deslarzes and Lorenzo Baggi and Lorenzo Noci and Luca Baumann and Luca Sartori and Lukas Drescher and Marco De Negri and Marco Passerini and Mark Klein and Marko Stojanovic and Martin Majsec and Matin Ansaripour and Mattea Busato and Mauro Pellonara and Max Neuwinger and Michael Graber and Michal Tešnar and Michelle Wastl and Miguel Gila and Mikolaj Boronski and Morgane Magnin and Moritz Reihs and Mukhammadali Sayfiddinov and Nathan Ranchin and Nicolas Cuveillier and Oscar Wohlfahrt and Qianqian Zou and Rada Kamysheva and Rita Sevastjanova and Roman Machacek and Sebastian Keller and Simon Matrenok and Simon Pierre and Stefano Schuppli and Suei-Wen Chen and Szabina Horváth-Mikulas and Taliesin Perez and Thilo Spinner and Thomas Kleine Buening and Tim Robinson and Tymoteusz Kwiecinski and Vilém Zouhar and Vinzenz Thoma and Xiaozhe Yao and Yannick Metz and Yuhei Fukuhara and Yusif Askari and Zixuan Chen and Alexander Ilic and Ana Klimovic and Andreas Krause and Andrei Kucharavy and Elliott Ash and Joost VandeVondele and Martin Rajman and Mennatallah El-Assady and Thomas Schulthess and Timo Kehrer and Torsten Hoefler and Antoine Bosselut and Martin Jaggi and Imanol Schlag},
      year={2026},
      eprint={2610.15542},
      archivePrefix={arXiv},
      primaryClass={cs.CL},
      url={https://arxiv.org/abs/2610.15542},
}