
Pensamiento
Resumen
Timestral, la primera familia de modelos fundacionales de series temporales de Mistral, ofrece pronósticos probabilísticos y multivariantes de vanguardia con solo 209M de parámetros, superando a modelos más grandes en los benchmarks clave y admitiendo covariables pasadas y futuras. Disponible en cuatro tamaños (de 5M a 209M de parámetros), equilibra precisión y eficiencia, funciona eficientemente en CPUs y destaca en pronósticos zero-shot para dominios diversos. El modelo combina preentrenamiento sintético, atención consciente de covariables y aprendizaje de contexto largo, con opciones de ajuste fino para adaptación de dominio a través de Mistral Forge.
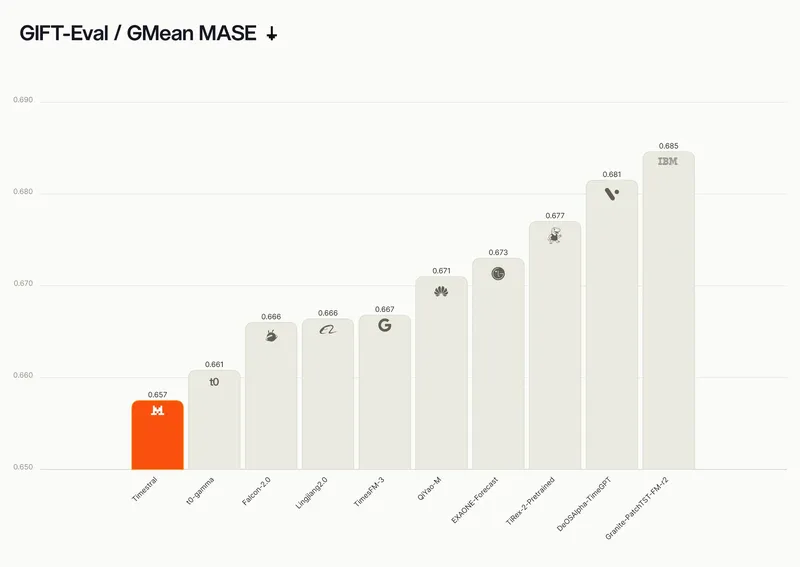
Hoy lanzamos Timestral, nuestra primera familia de modelos fundacionales de series temporales. Nuestro modelo más grande, con solo 209M de parámetros, ocupa el primer lugar en los tres principales benchmarks públicos del campo, GIFT-Eval, TIME y fev-bench, superando el anterior estado del arte con solo dos tercios de los parámetros del modelo.
Timestral ofrece pronósticos probabilísticos y multivariantes y admite covariables solo pasadas y de futuro conocido. Nuestra familia de modelos se sitúa en la frontera de Pareto entre la precisión de pronóstico y el tamaño del modelo, ofreciendo un rendimiento líder en cada tamaño. Los resultados se han enviado a las clasificaciones de GIFT-Eval y TIME.
Modelos fundacionales de series temporales (TSFM)
Las series temporales son uno de los tipos de datos más comunes en la empresa, desde la telemetría de sensores hasta las métricas de observabilidad. Los pronósticos basados en ellas impulsan decisiones en planificación de capacidad, energía, cadenas de suministro, riesgo y mantenimiento.
Las plantas industriales hacen pronósticos de los sensores de proceso contra el calendario de producción, detectan la deriva de los equipos antes de que fallen y planifican la capacidad y las piezas de repuesto en miles de activos. Los equipos financieros pronostican flujos, volúmenes y volatilidad para orientar posiciones, cobertura y tesorería en miles de cuentas.
Los modelos clásicos como ARIMA y la regresión lineal siguen siendo herramientas consolidadas para pronosticar series temporales. Estos modelos suelen ajustarse a una sola serie y aprenden únicamente de la historia de esa serie.
Los modelos de aprendizaje profundo como PatchTST añaden la capacidad de aprender patrones no lineales a través de muchas series relacionadas, pero normalmente se entrenan desde cero en cada conjunto de datos, por lo que lo que aprenden no se transfiere a dominios nuevos.
Los modelos fundacionales de series temporales llevan el enfoque de preentrenamiento a las series temporales. Entrenado con un corpus amplio y diverso, nuestro modelo aprende patrones que se transfieren entre series, pronosticando de forma zero-shot sobre datos que nunca ha visto, incluso en dominios donde los datos son escasos.
Resultados de los benchmarks
Evaluamos Timestral en los tres principales benchmarks públicos de pronóstico: GIFT-Eval, TIME y fev-bench. Entre los modelos preentrenados y zero-shot, ocupa el primer lugar en las cinco métricas. Estos resultados provienen de un único checkpoint, sin ensembling.
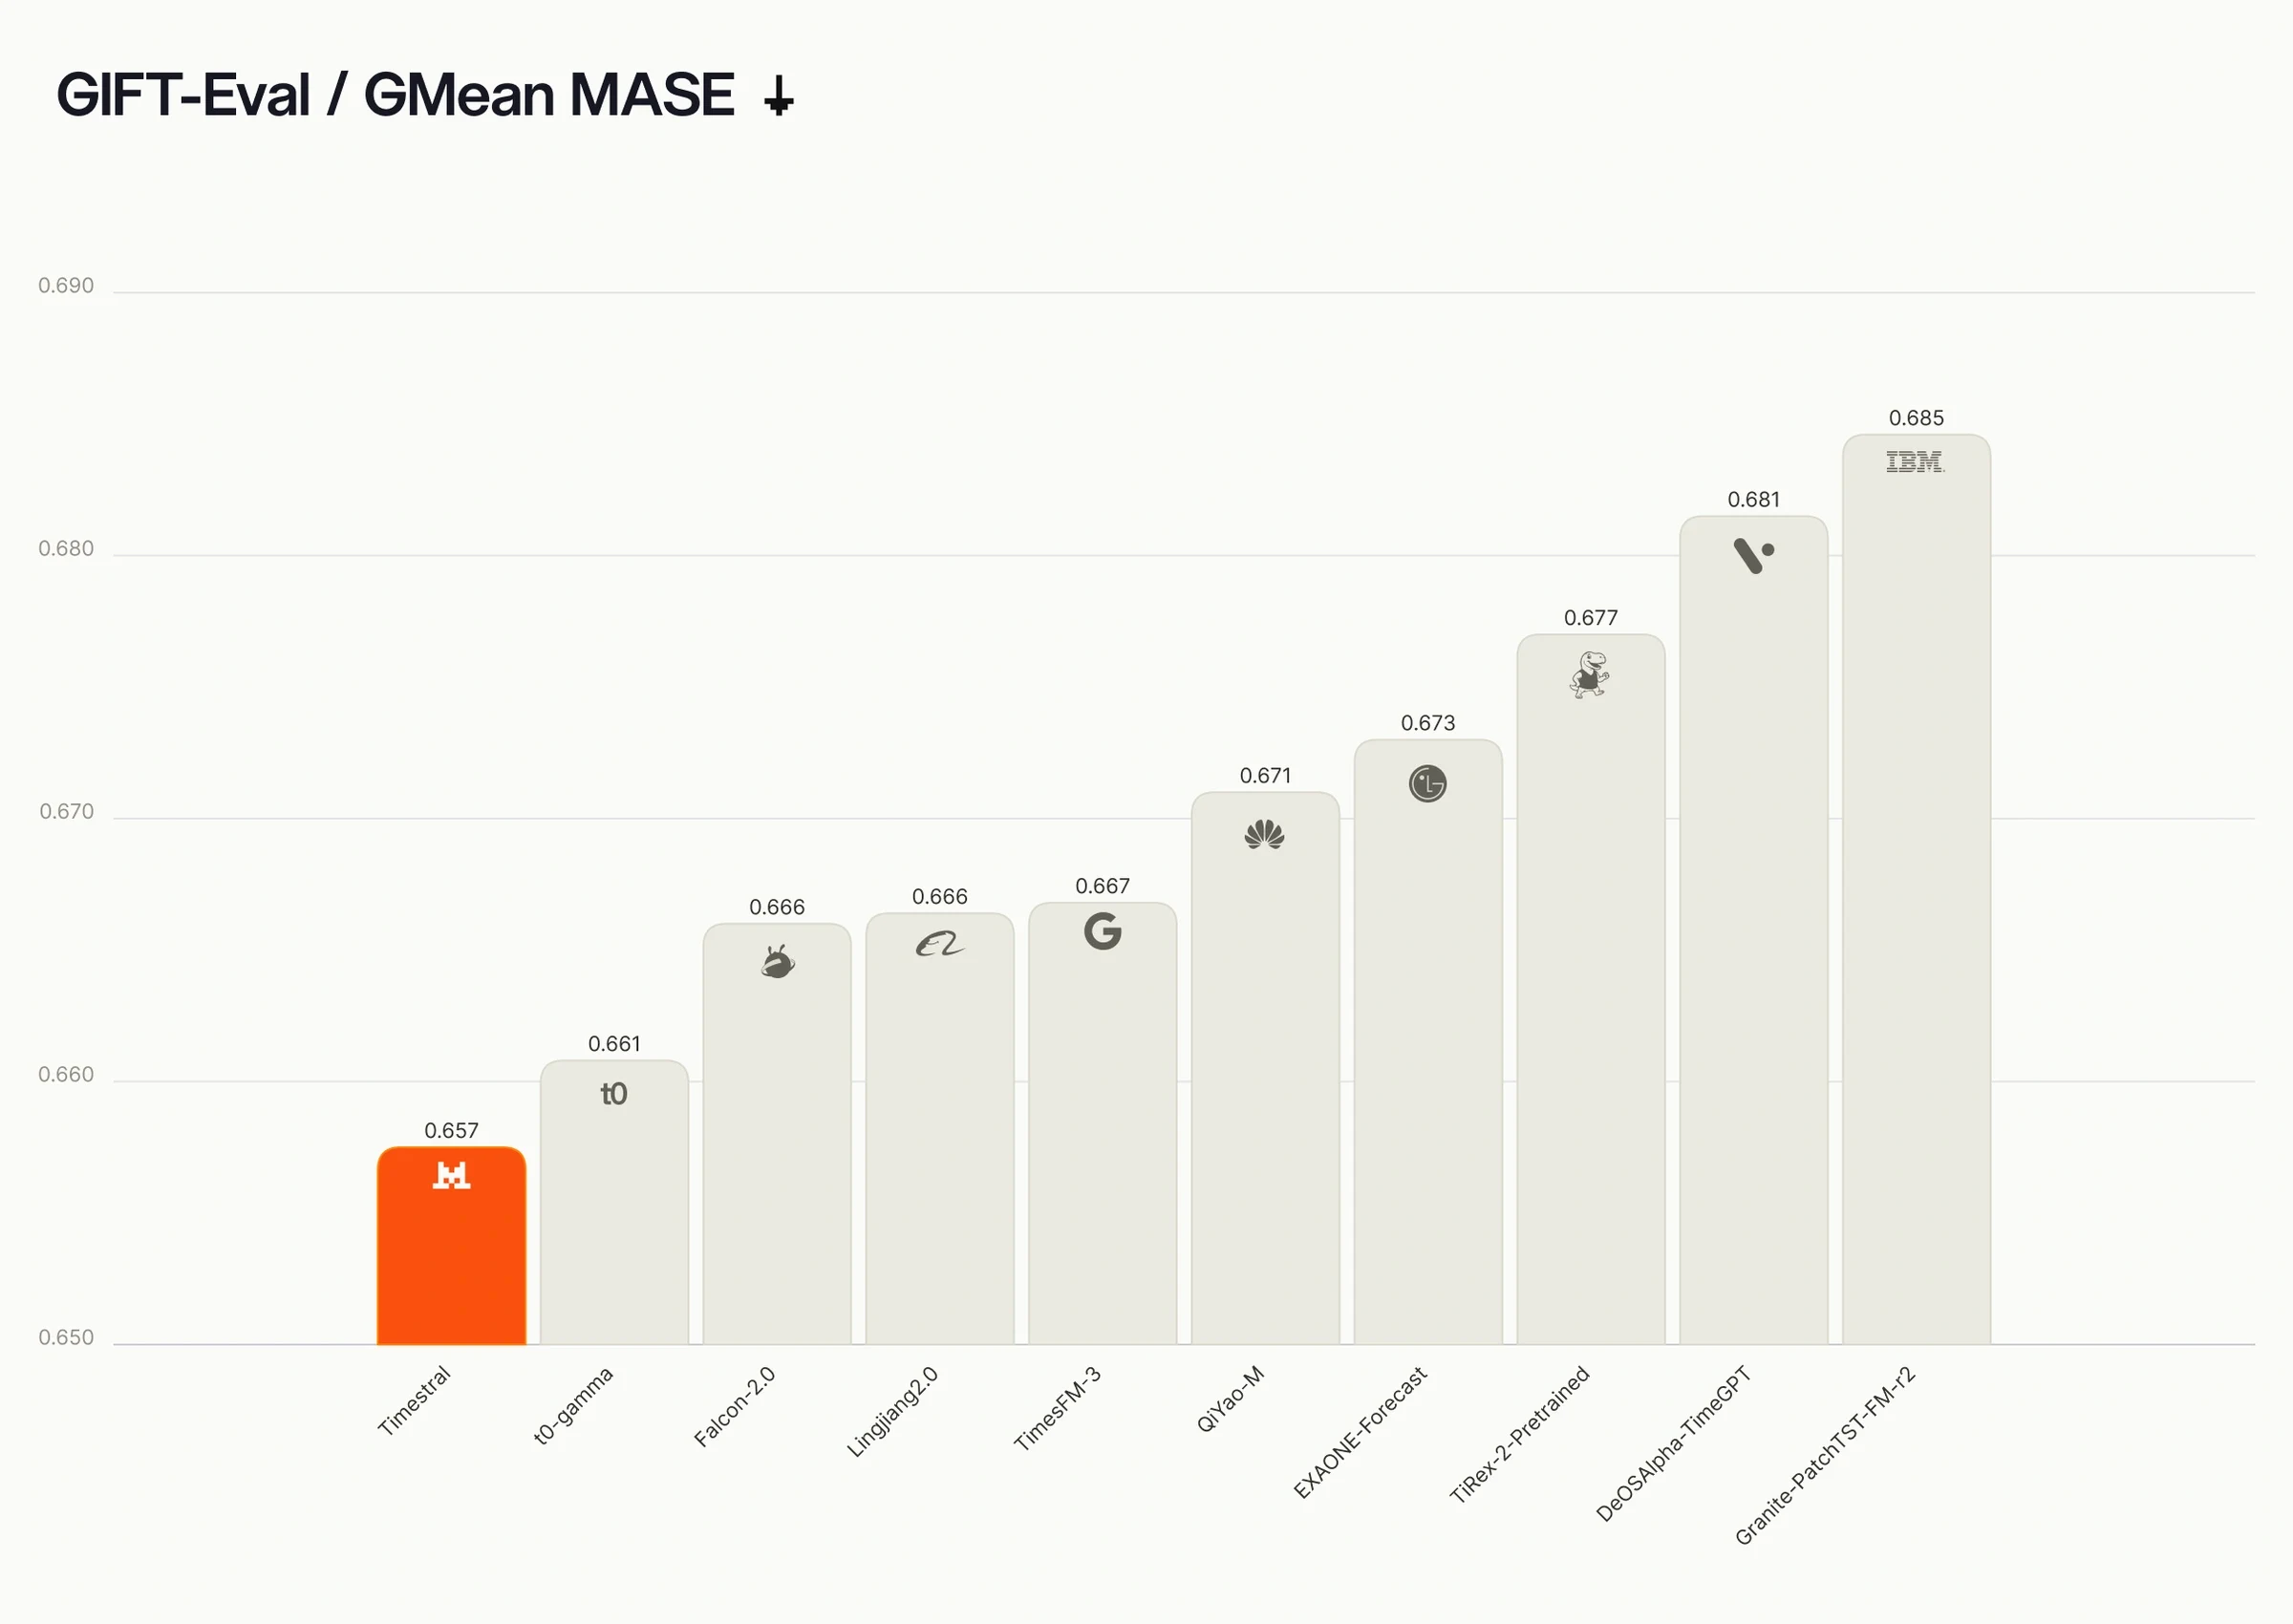
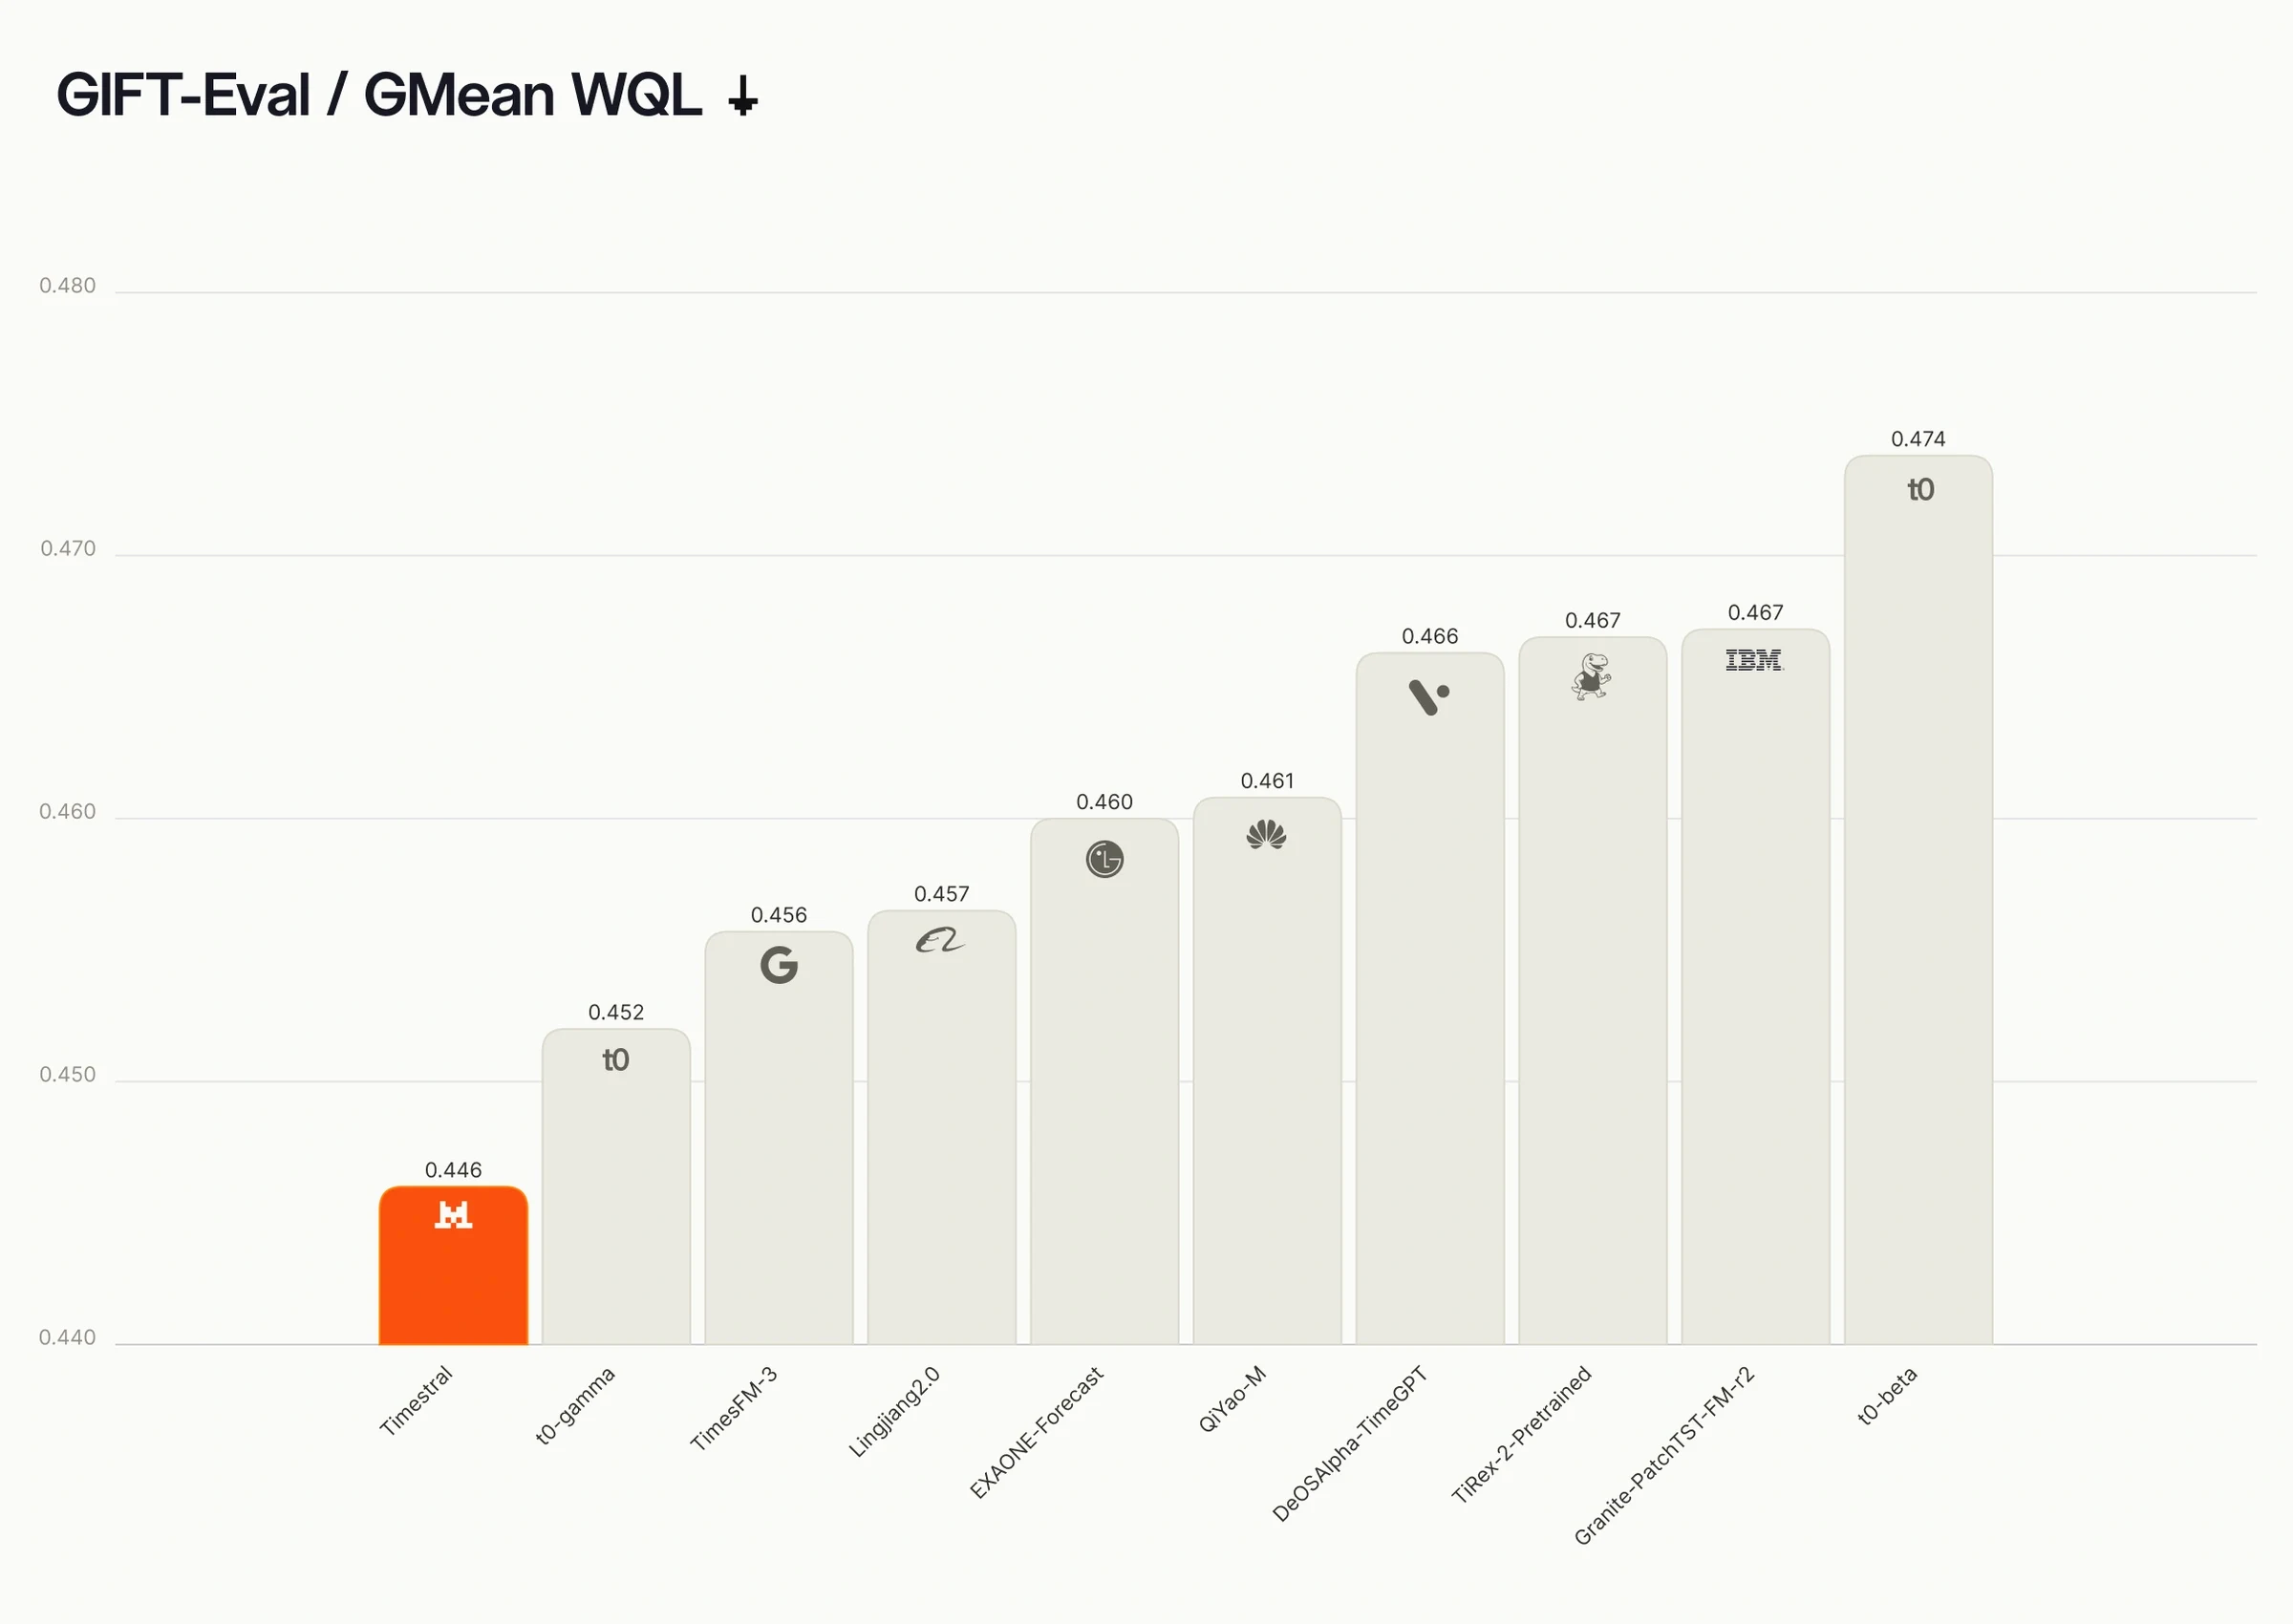
GIFT-Eval, los diez primeros de 83 entradas comparables preentrenadas y zero-shot. Menor es mejor.
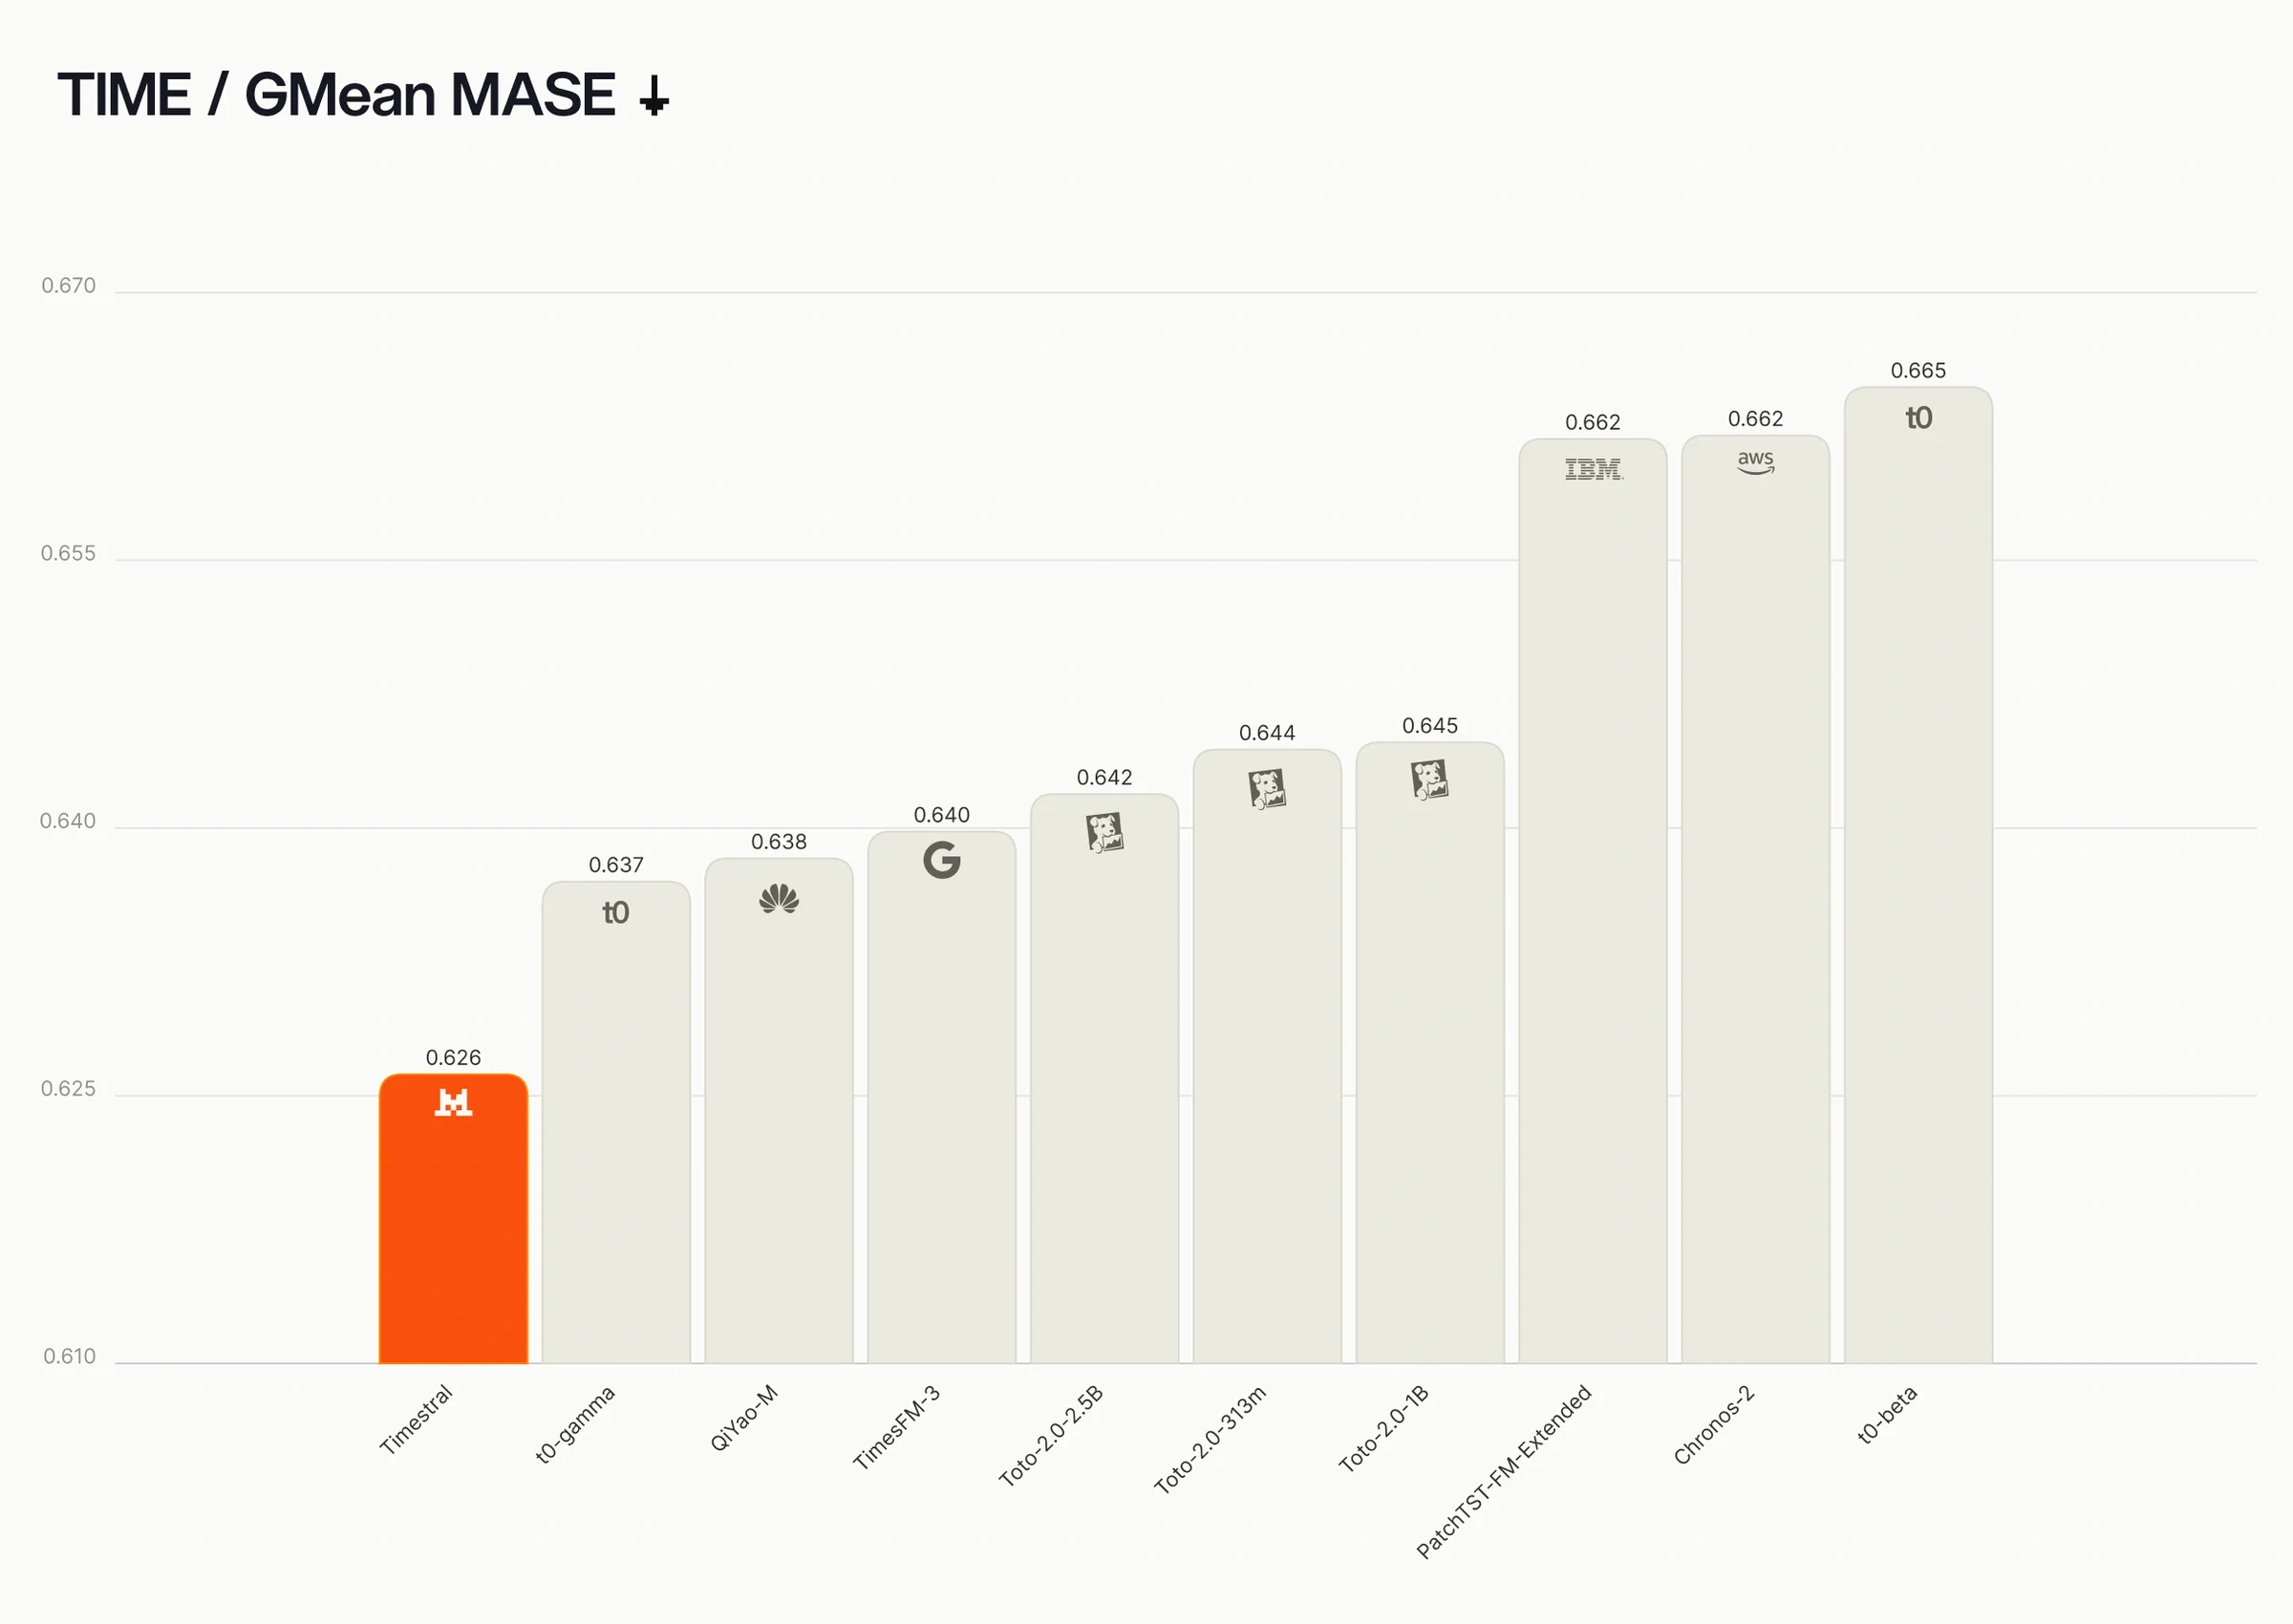
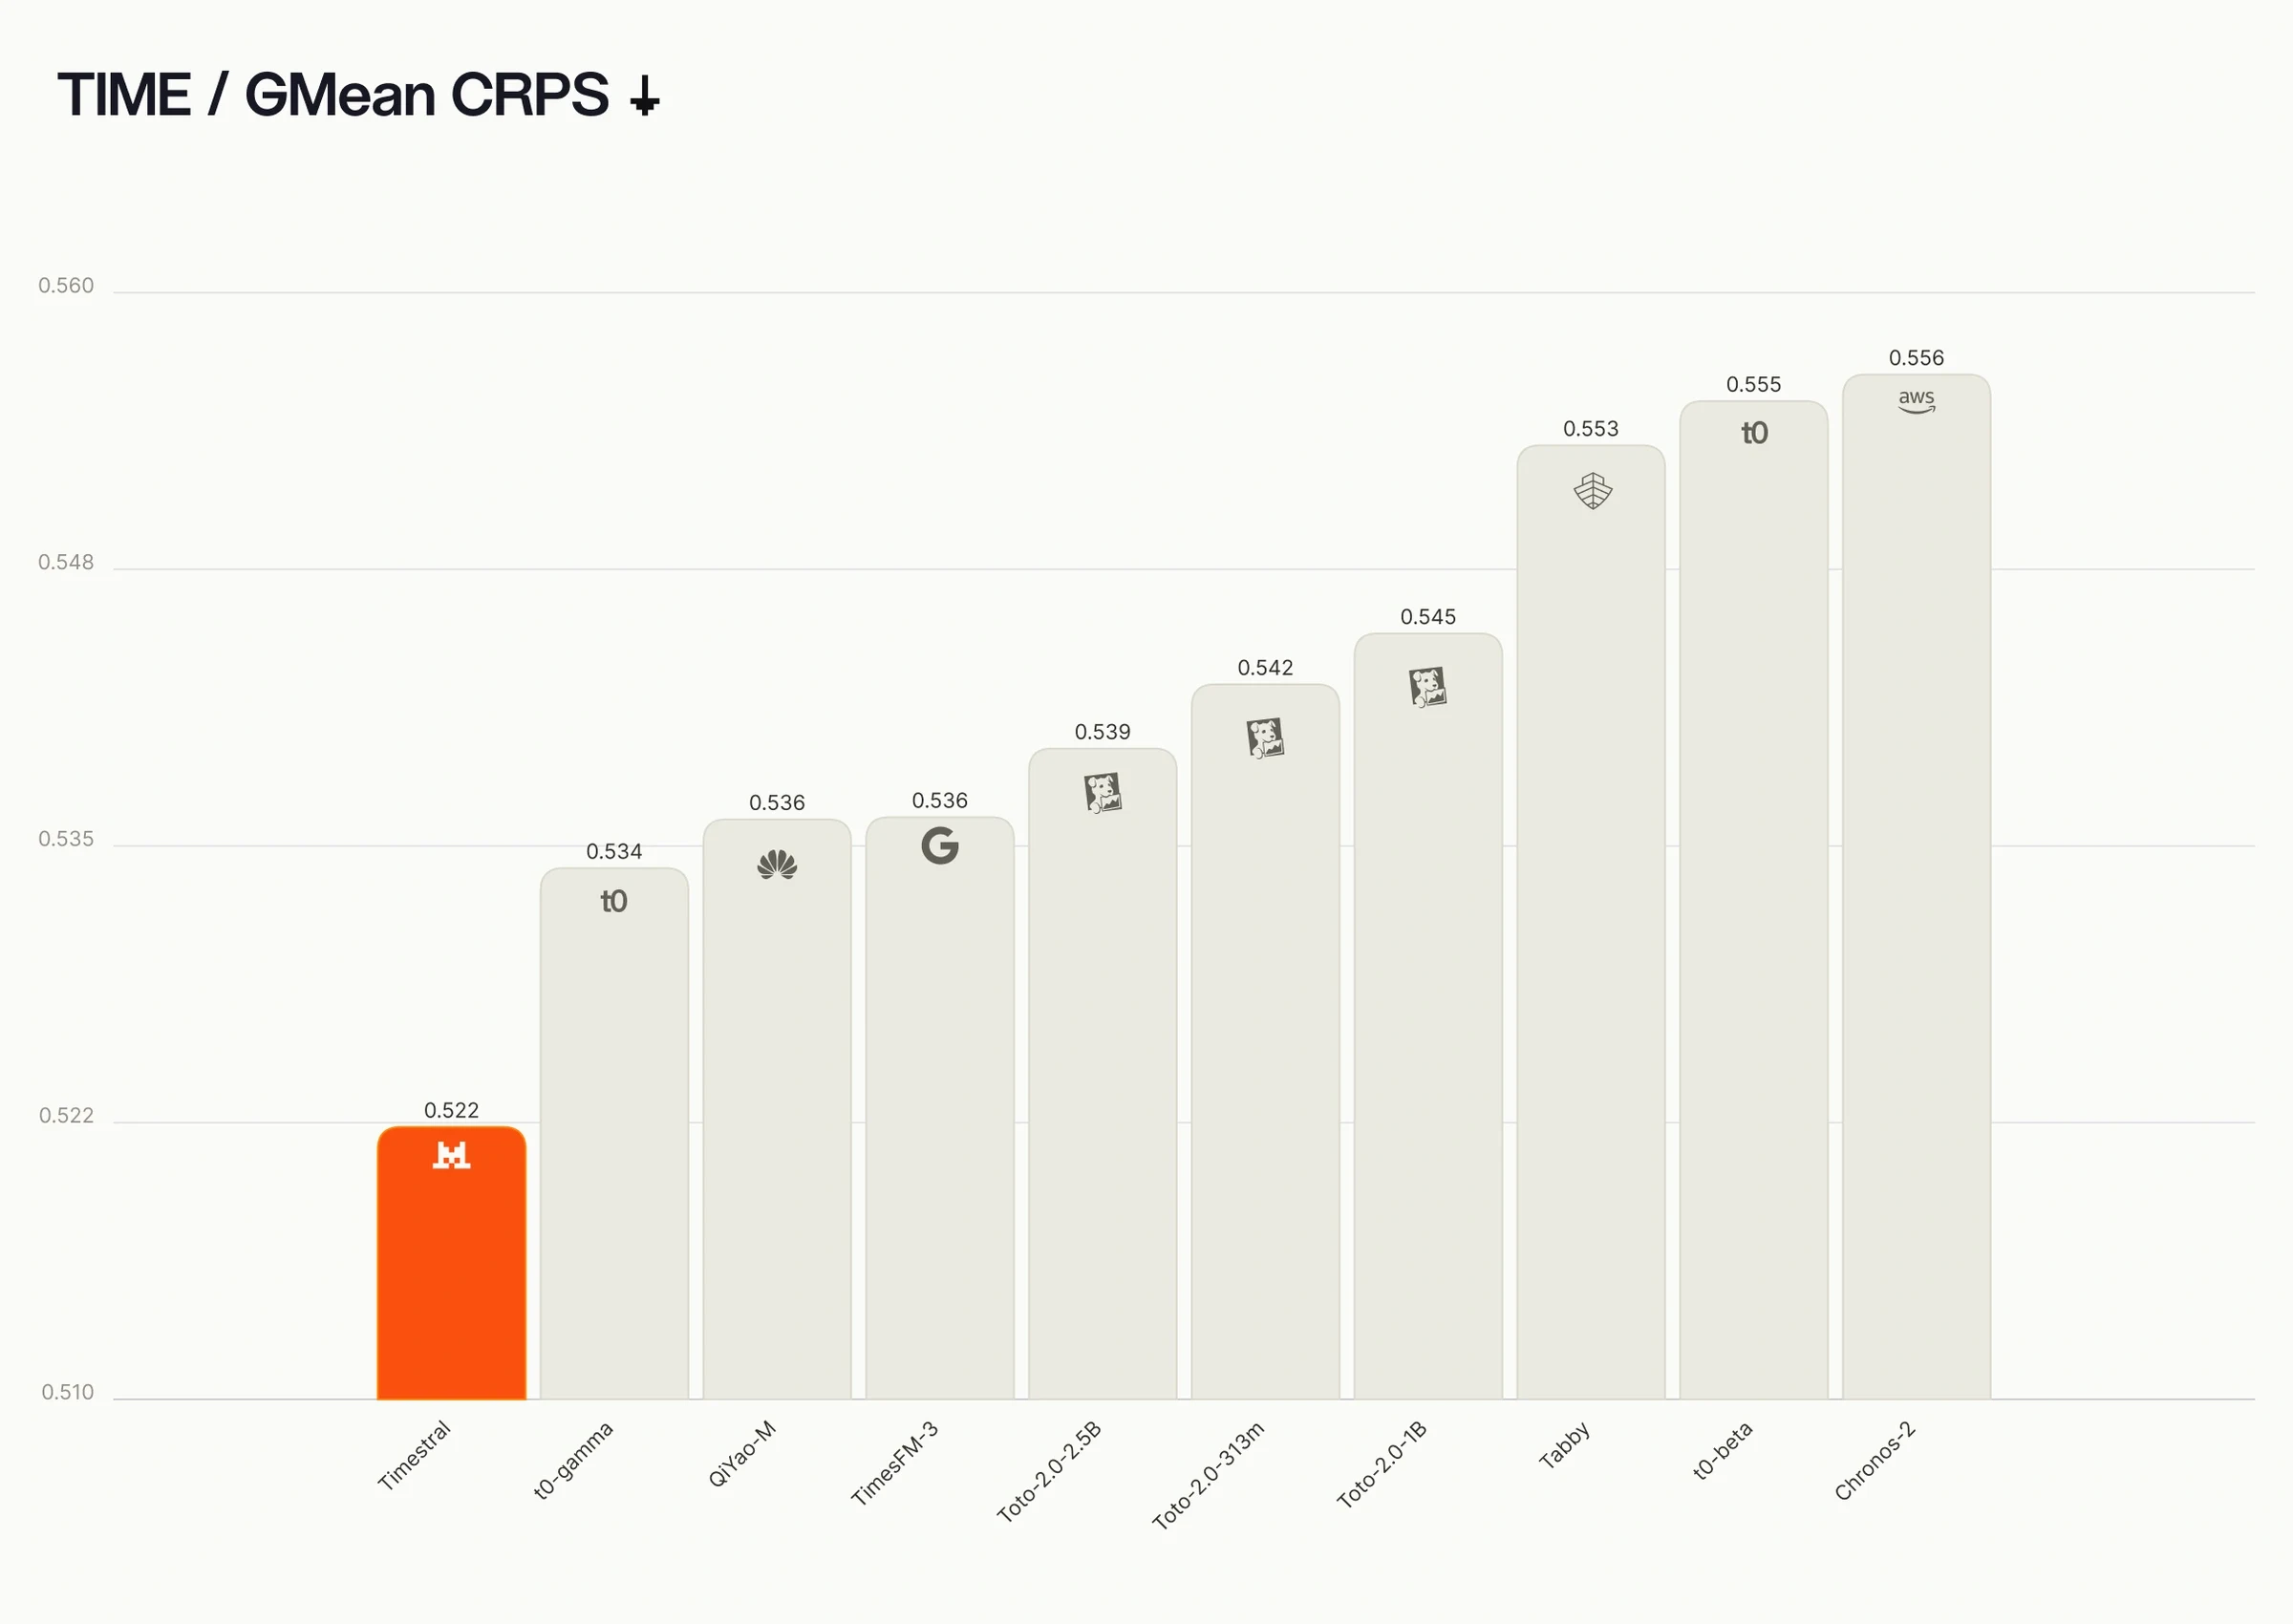
TIME, los diez primeros de las 35 entradas de la clasificación. Menor es mejor en ambas métricas.
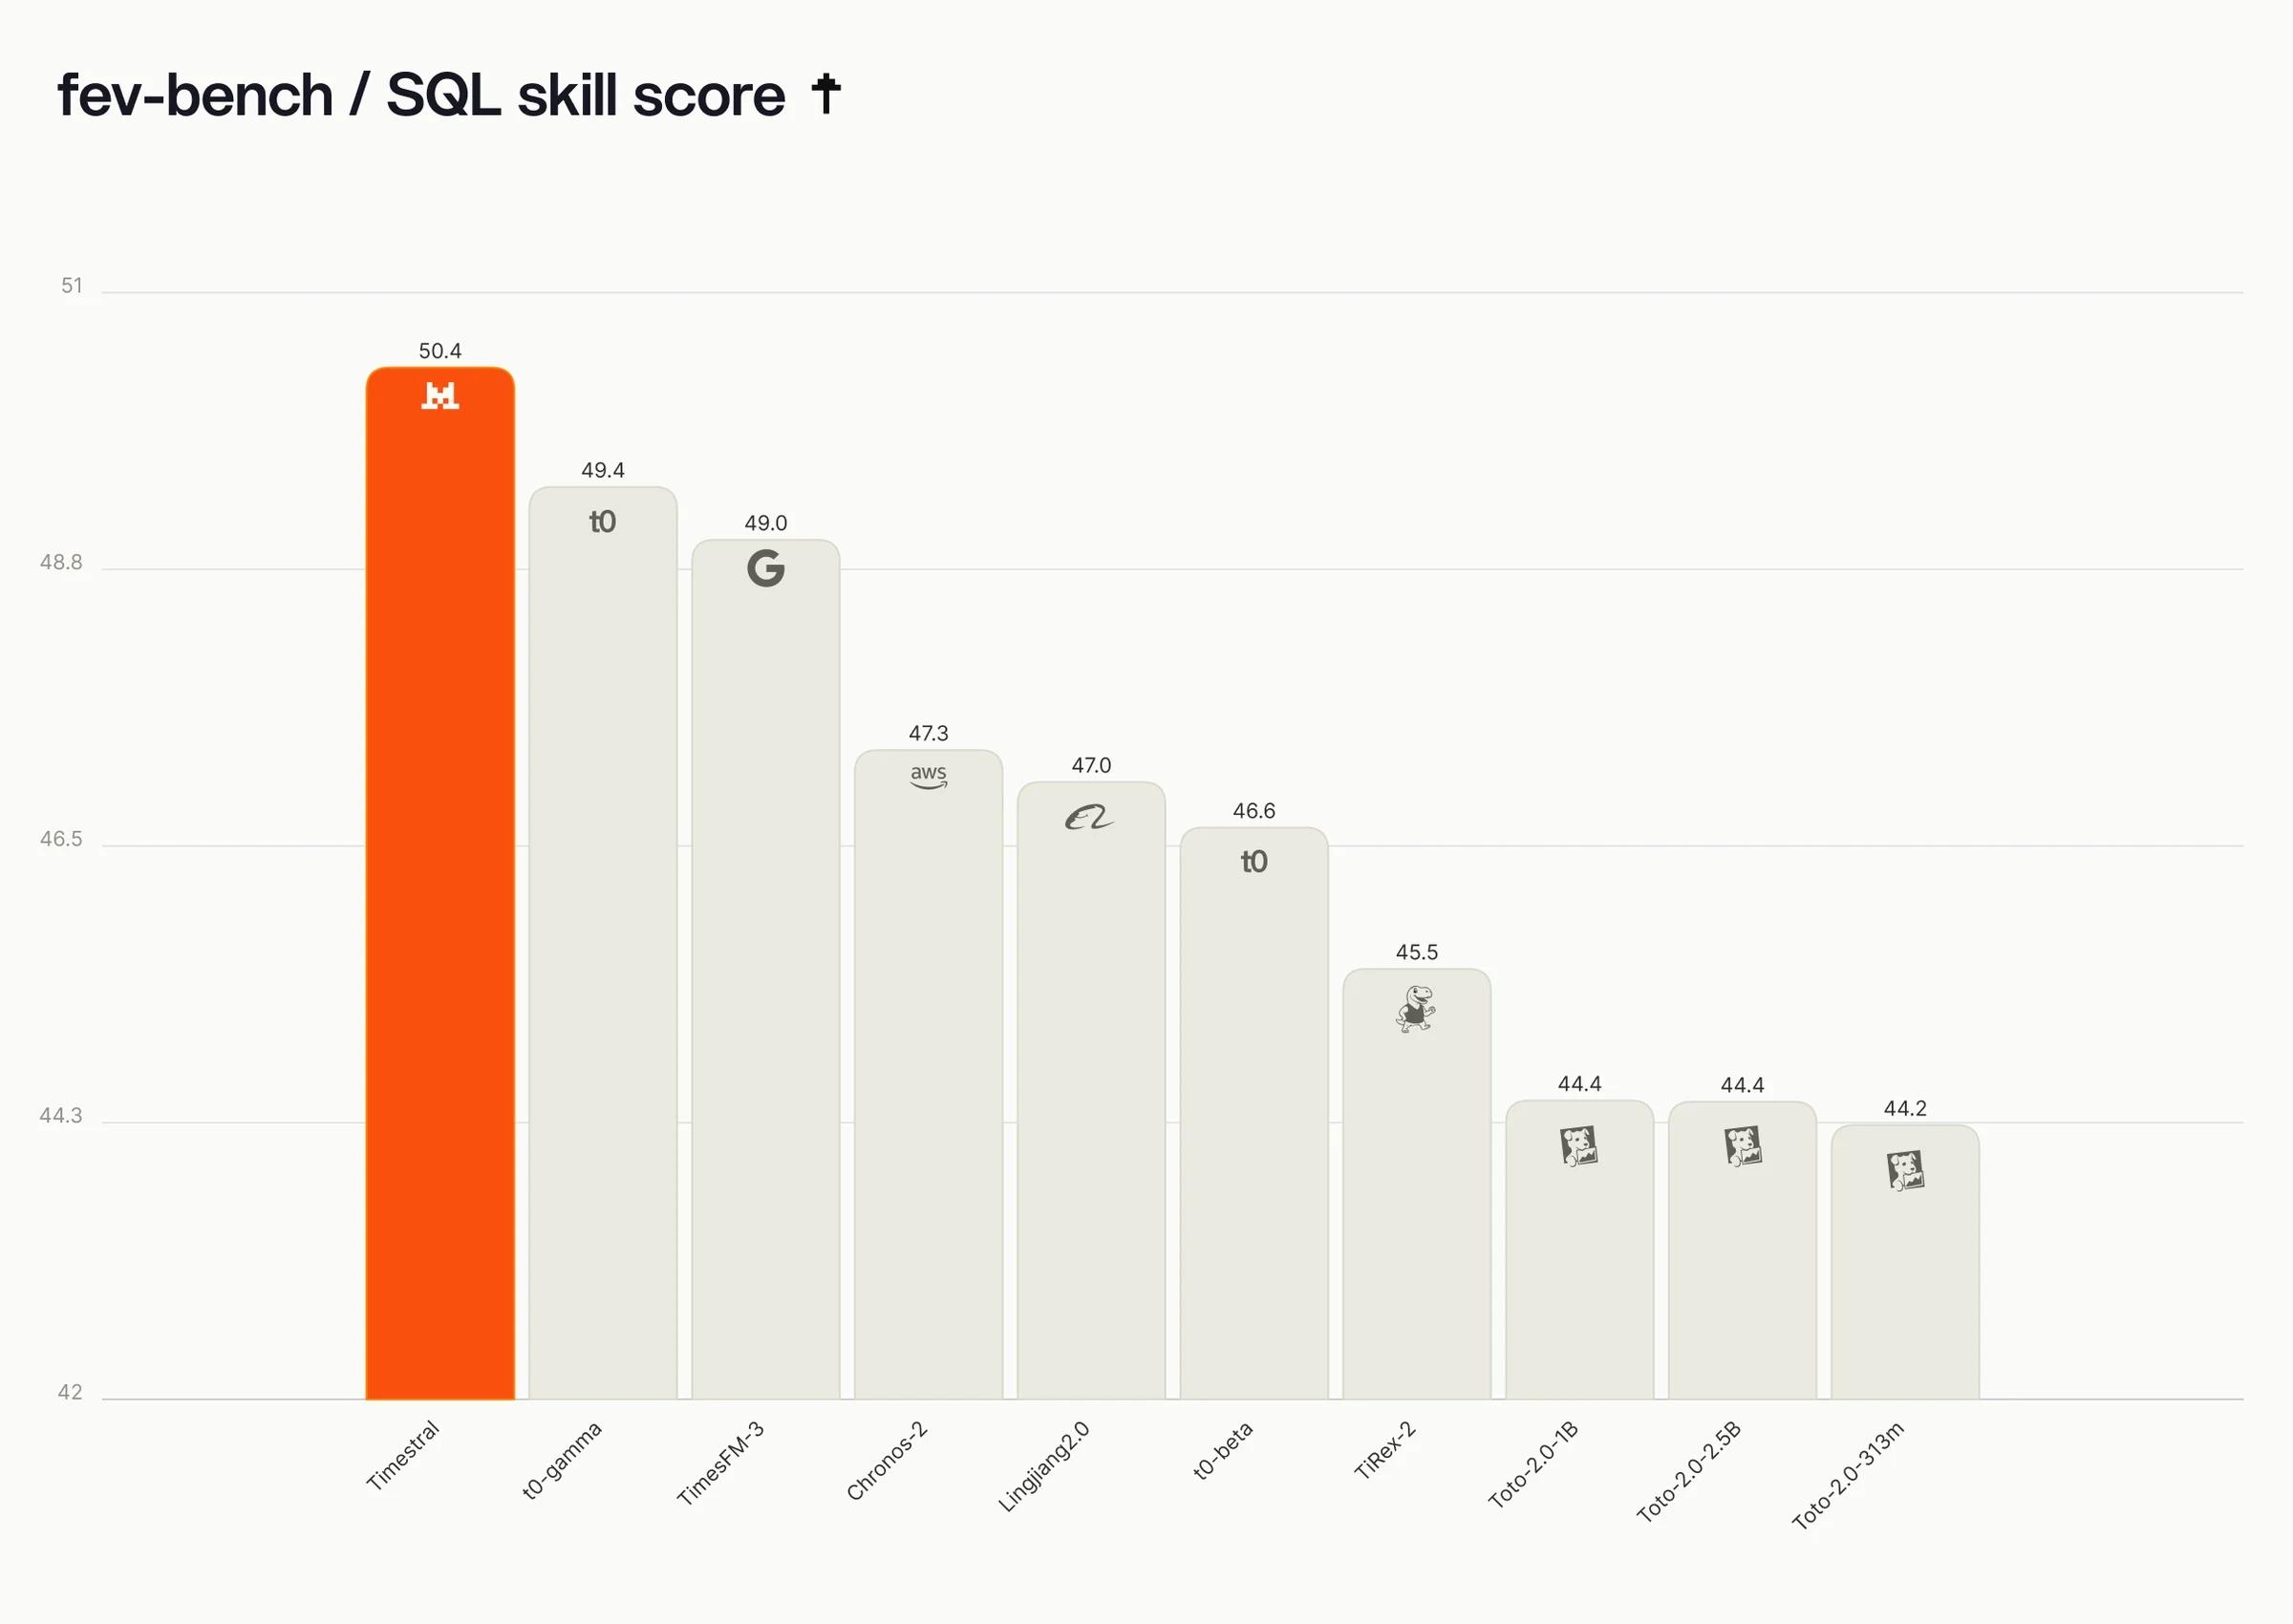
fev-bench, los diez primeros de las 37 entradas de la clasificación, por SQL skill score. Mayor es mejor.
Una familia de modelos optimizada para cada especificación
Timestral se ha optimizado como una familia de cuatro modelos: 5M, 28M, 123M y 209M de parámetros. Los modelos más grandes mejoran el rendimiento del pronóstico, mientras que los más pequeños son más rápidos y baratos. Los cuatro comparten la misma arquitectura y receta de entrenamiento. Cada tamaño se sitúa en la frontera de Pareto entre precisión y tamaño del modelo: para cada tamaño de modelo, ningún modelo público pronostica mejor.
Puntuación frente a tamaño del modelo en GIFT-Eval, TIME y fev-bench (mostrado como 1 − skill score). Menor es mejor. Nuestro modelo de 28M supera a Chronos-2, unas cuatro veces más grande, en GIFT-Eval y TIME. Nuestro modelo de 209M supera a TimesFM-3 y Falcon-2.0 con menos parámetros.
Timestral no necesita una GPU en la inferencia. En una CPU de servidor estándar con 8 hilos, pronosticar un día por adelantado a partir de tres semanas de historial de 15 minutos toma 10 ms con el modelo de 5M y 140 ms con el modelo de 209M. Los modelos más pequeños intercambian algo de precisión por velocidad: el modelo de 28M es cinco veces más rápido que el de 209M, y el modelo de 123M se queda a 0.2% de la puntuación del de 209M con tres cuartas partes de su latencia.
Un ejemplo industrial
Considere una planta industrial con miles de sensores en sus equipos. Timestral puede mejorar los pronósticos sobre esos datos de varias maneras.
Pronóstico multivariante. La vibración, la temperatura y la presión de una bomba no se mueven de forma independiente. Un aumento en una a menudo explica o causa un cambio en otra. Timestral modela las series relacionadas conjuntamente, de modo que puede usar esas dependencias en lugar de pronosticar cada sensor de forma aislada.
Pronóstico probabilístico. Un único valor previsto puede no mostrar el panorama completo. Timestral predice un conjunto completo de cuantiles, de modo que los equipos pueden ver cuán amplia es la incertidumbre, establecer umbrales de alerta que la reflejen y planificar el mantenimiento en función del riesgo en lugar de un solo número.
Covariables categóricas. Algunas covariables toman valores de un conjunto de categorías en lugar de números continuos, como el día de la semana o el estado de una máquina (en funcionamiento, inactiva, en mantenimiento). Codificarlas como números impondría un orden o una escala que no tienen. Timestral las acepta como entradas categóricas directamente para mejorar los pronósticos.
Covariables de futuro conocido. Algunos factores que influyen en el comportamiento de los sensores se conocen de antemano, como los calendarios de producción, los apagados planificados y los pronósticos del tiempo. Timestral puede condicionar en función de ellos para mejorar la calidad de los pronósticos, de modo que un aumento de carga programado se anticipe en lugar de señalarse como una sorpresa.
Del modelo al sistema
Timestral es un modelo numérico que puede ejecutarse dentro de flujos de monitorización existentes, o combinarse con nuestros modelos de lenguaje en flujos de trabajo agénticos multimodales.
En la planta, eso podría verse así:
Timestral funcionando de forma continua sobre los flujos de datos de los sensores de la planta, detectando anomalías a medida que ocurren.
Cuando marca una anomalía en una bomba, un agente codifica las señales y las compara con embeddings de datos históricos de sensores para encontrar fallos históricos similares.
El agente inicia entonces subagentes para ejecutar un análisis de causa raíz, apoyándose en el contexto de esa planta, como registros de mantenimiento, diarios de turnos y notas de operadores, manuales de equipos, órdenes de trabajo pasadas y lecturas de equipos relacionados.
El agente redacta un diagnóstico sugerido basado en los hallazgos, con evidencia de respaldo y posibles próximos pasos.
El gerente de la planta recibe un diagnóstico y un plan respaldados por los datos de los sensores, en lugar de solo una alerta.
Contribuciones técnicas clave
Se han combinado varias ideas para producir estos resultados. Cada una se describirá en detalle en el informe técnico.
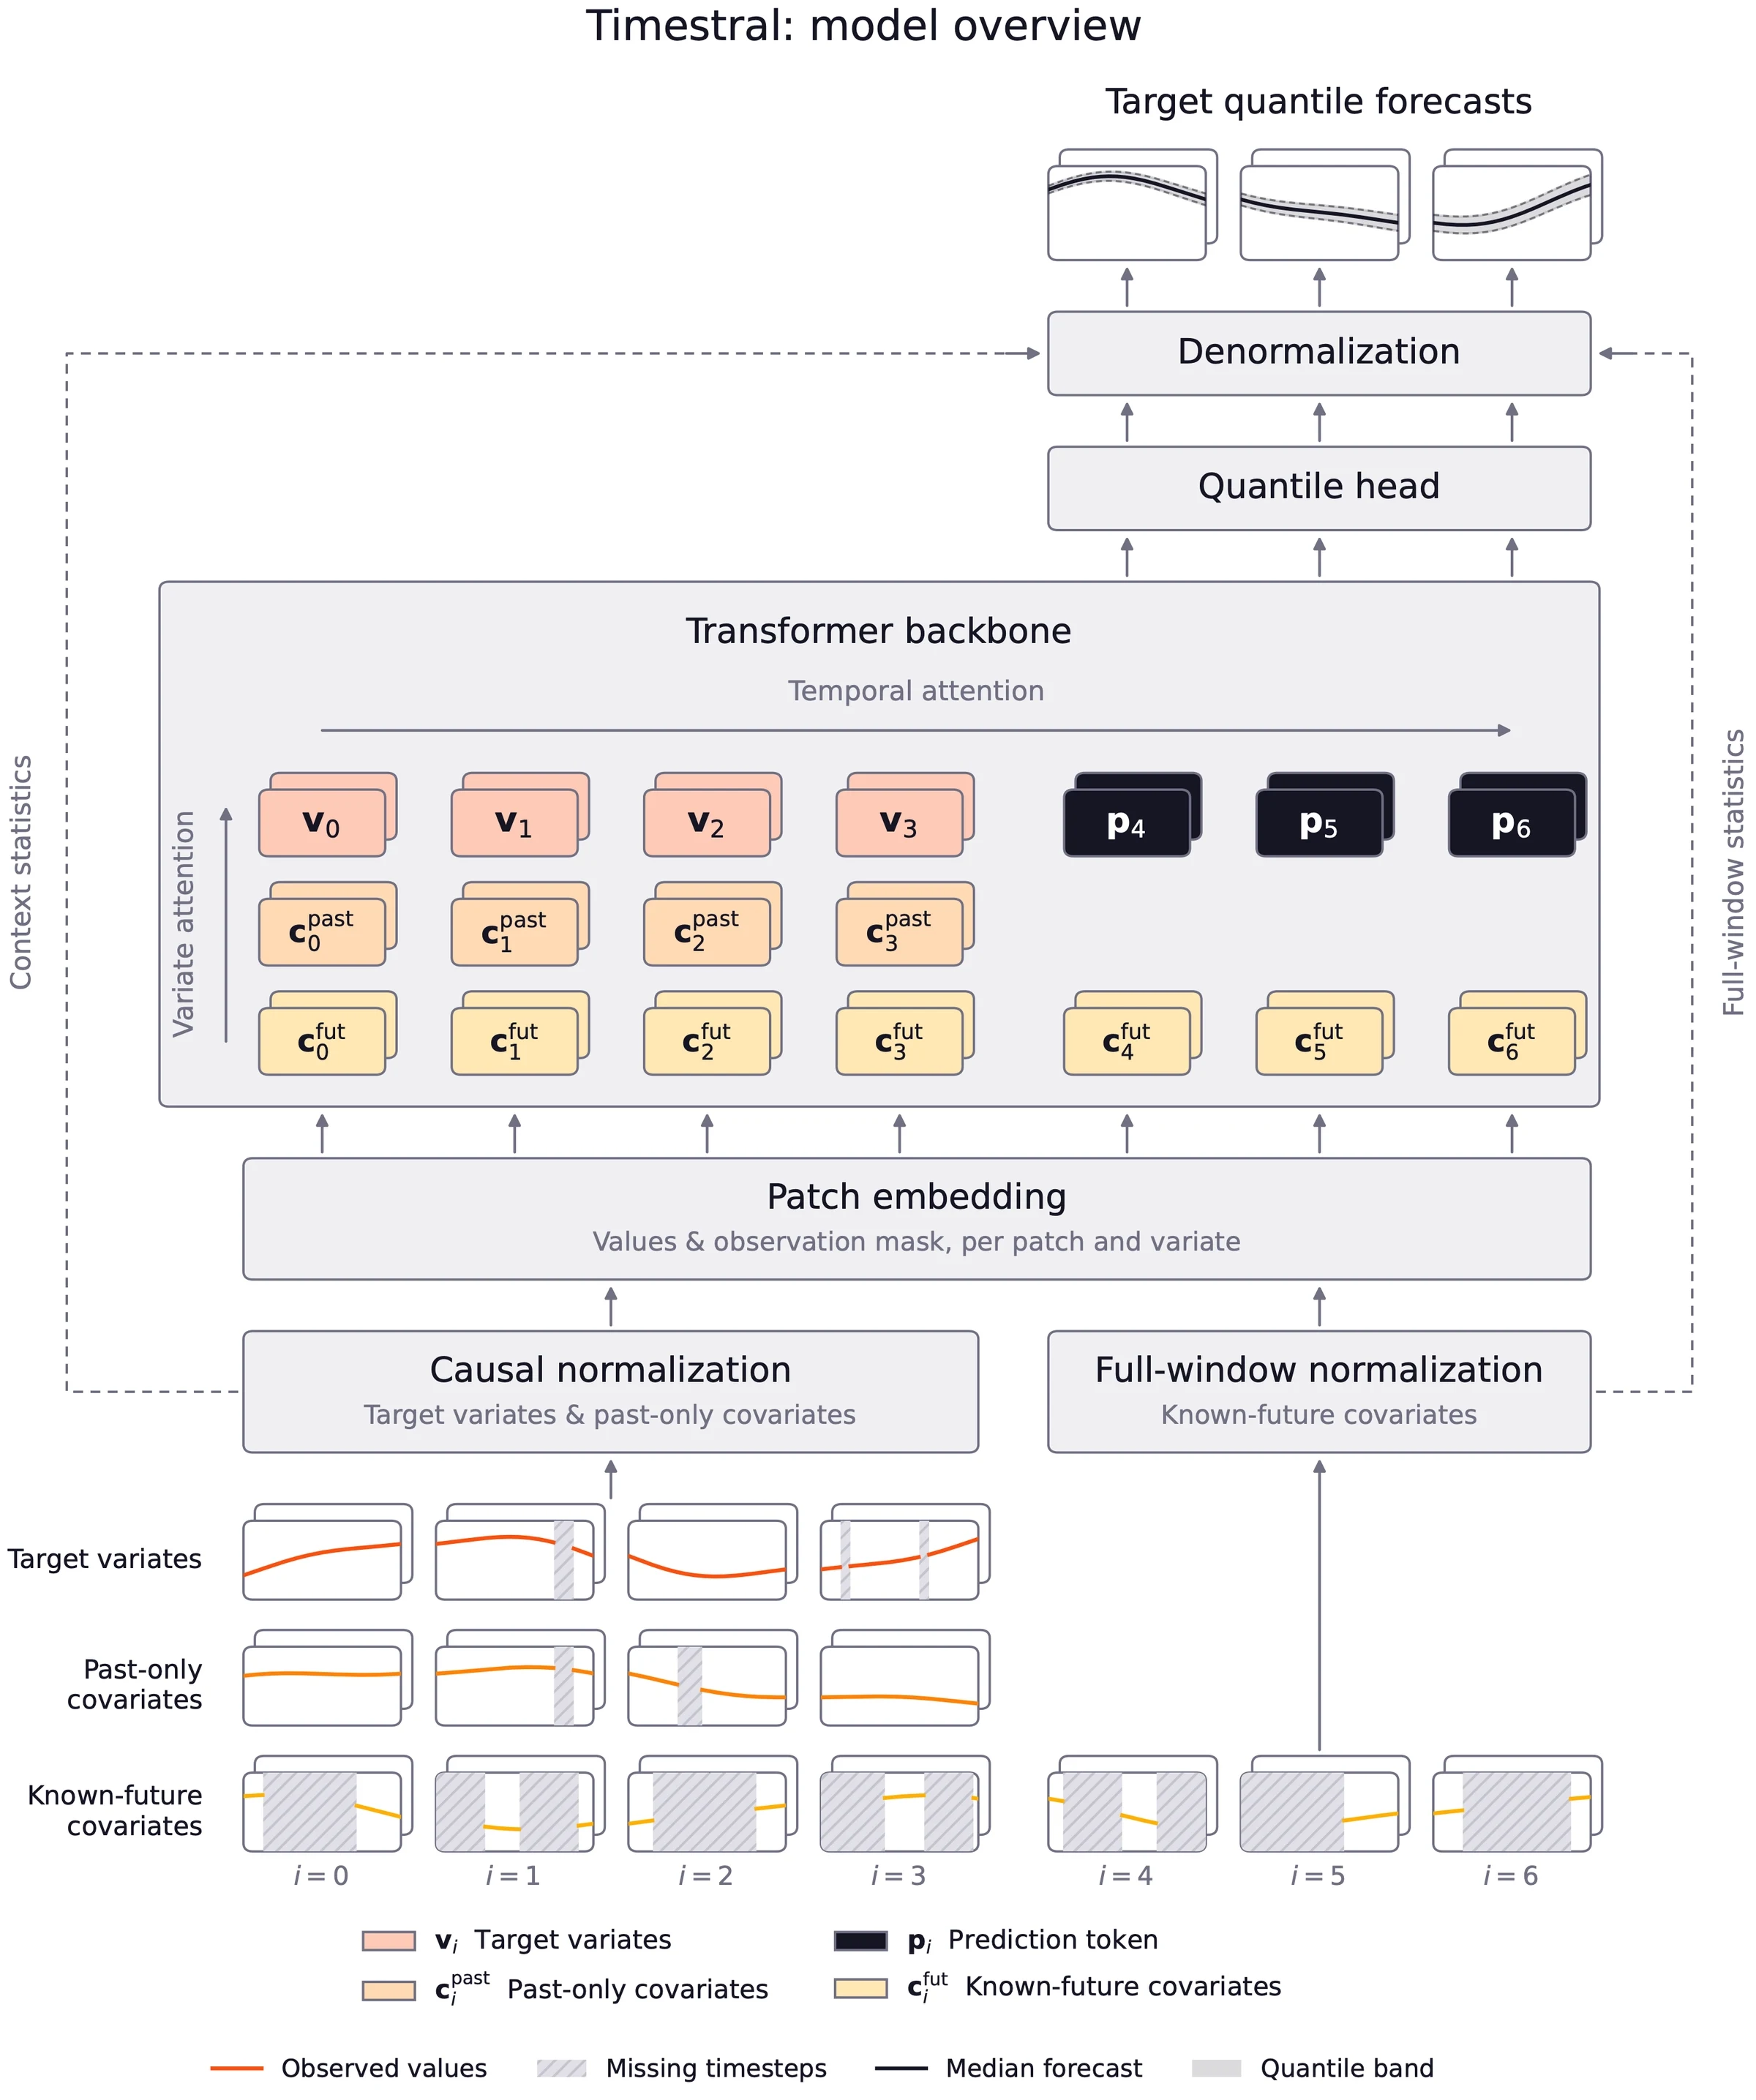
Decoupled Horizon Forecasting. Los decoders causales entrenados con contiguous patch masking, como en Toto 2.0 y TimesFM-3, enmascaran los valores que se van a pronosticar, por lo que parecen valores faltantes y también se pierden como contexto para pronósticos posteriores. Nuestro enfoque, DHF, separa ambas cosas: el historial completo permanece en la secuencia, y los forecast tokens aprendidos leen el historial que los precede. Así, cada valor observado sirve como objetivo y como contexto, los vacíos verdaderos permanecen marcados como faltantes, y las longitudes del horizonte de entrenamiento y el aumento de datos faltantes pueden ajustarse de forma independiente entre sí.
Covariate-aware attention. Cada serie de entrada recibe un rol: variable objetivo, covariable solo pasada o covariable de futuro conocido. Las covariables de futuro conocido son visibles en toda la ventana mientras que los objetivos permanecen causales, y la información fluye solo de las covariables hacia los objetivos. Por lo tanto, Timestral puede usar un calendario de festivos o un pronóstico del tiempo sin filtrar el futuro propio de un objetivo en su pronóstico.
Synthetic-first data. La mayoría de los datos de entrenamiento fueron sintéticos. Primero generamos procesos univariados con dinámicas temporales coherentes, incluyendo tendencias, estacionalidad y patrones de ruido diversos. Luego usamos un sintetizador multivariado para construir series multivariadas introduciendo dependencias no lineales entre estos procesos.
Entrenamiento en dos etapas. Timestral se pre-entrena primero a gran escala con datos puramente sintéticos con un tamaño de contexto de 8192, y luego se post-entrena con una mezcla de datos reales y sintéticos con un contexto 4 veces más largo. El objetivo es una pinball loss sobre 21 cuantiles, una aproximación discreta de CRPS.
Un modelo que puede adaptarse
Los benchmarks públicos miden el rendimiento general, pero los datos de producción pueden diferir significativamente en comportamiento y estructura. También pueden cambiar con el tiempo a medida que los mercados cambian de régimen, los equipos se degradan y los patrones de demanda se desplazan. El valor duradero radica en poder adaptar un modelo a datos del dominio y seguir reentrenándolo a medida que la distribución se mueve.
Para las organizaciones que quieran ir más allá, Timestral está disponible a través de Mistral Forge, el mismo pipeline de entrenamiento que usamos para nuestros modelos de lenguaje. Admite:
Inferencia zero-shot de fábrica.
Extensiones arquitectónicas, como covariables específicas del dominio.
Fine-tuning con datos propietarios, especializándose en un dominio mientras se preserva el rendimiento general.
Control sobre los datos de entrenamiento, incluyendo el ajuste de la mezcla de entrenamiento, la reproducción de datos de pre-entrenamiento y la generación de muestras de datos sintéticos que reflejen el dominio objetivo. El control total de los datos garantiza que nada de lo que sometemos a backtest se vio durante el pre-entrenamiento.
El pipeline completo puede desplegarse en el hardware de nuestros clientes, incluidos entornos aislados (air-gapped).
Próximos pasos
Hemos publicado un repositorio de GitHub para que puedas ejecutar Timestral con tus propios datos. Se publicará próximamente un informe técnico con los resultados completos. Para problemas de pronóstico más especializados, o para colaborar en investigación, no dudes en contactarnos.
Timestral | |
|---|---|
Tipo | Modelo fundacional de series temporales (TSFM) |
Parámetros | 5M, 28M, 123M y 209M |
Longitud de contexto | 32,768 pasos de tiempo |
Salida | Pronósticos probabilísticos, 21 cuantiles |
Entradas | Objetivos multivariantes, covariables solo pasadas y de futuro conocido |
Despliegue | On-prem, VPC o aislado (air-gapped) |
Licencia | MIT modificado |
Timestral
Nuevo
Los modelos fundacionales de series temporales de Mistral. Pronósticos probabilísticos de vanguardia, 5M–209M de parámetros, funciona en CPU.
Pronósticos probabilísticos
Descubrir