
En cada conversación que tengo con líderes empresariales, dicen lo mismo. Quieren que los agentes hagan más, pero no confían en que lo hagan bien todo el tiempo.
Es justo. La misma creatividad y autonomía que hace útiles a los agentes los hace difíciles de confiar. Dele a un agente una tarea y encontrará su propio camino para completarla, eligiendo herramientas y secuenciando pasos que ningún desarrollador programó. Ejecute la misma tarea dos veces y podría tomar una ruta diferente cada vez. Una prueba que pasa hoy le dice poco sobre lo que el agente hará mañana.
La respuesta habitual es una persona en el ciclo, aprobando todo lo que hace el agente. Eso funciona a pequeña escala, pero a medida que los agentes asumen más trabajo, las aprobaciones humanas se acumulan y aparece la fatiga de revisión. Las personas a las que se les pide revisarlo todo dejan de detectar las cosas que importan. La precaución se convierte en un cuello de botella, y los agentes capaces de mucho más permanecen inactivos frente al valioso trabajo que podría tener un mayor impacto.
La solución es dejar que el agente actúe por su cuenta cuando sus acciones pueden verificarse, y reservar el juicio humano para las decisiones que lo necesitan. A medida que los agentes asumen trabajos de mayor riesgo, como transacciones financieras, una acción incorrecta se vuelve cada vez más dañina. Las organizaciones necesitan la confianza para entregar a un agente de IA trabajo importante, sabiendo que se mantendrá dentro de los límites establecidos, incluso cuando nadie esté mirando. Esa confianza debe construirse.
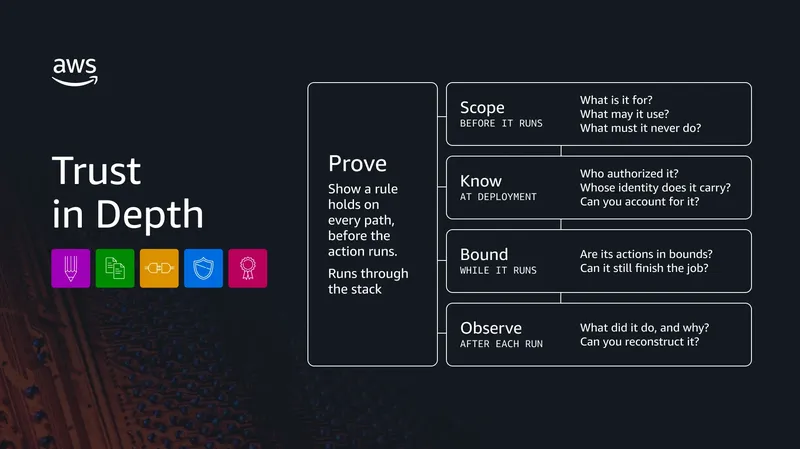
El filtrado de contenido, las pruebas y la supervisión cumplen cada uno un propósito importante, pero ninguna de estas capacidades por sí sola puede prometer que un agente se comportará correctamente la próxima vez que se ejecute. La confianza proviene de capas independientes que se refuerzan entre sí, la misma disciplina por capas que la industria ha practicado durante dos décadas como Defense in Depth (Defensa en Profundidad), aplicada a un nuevo propósito. Donde Defense in Depth limita lo que puede salir mal, esto amplía lo que puede permitir de forma segura. AWS lo llama Trust in Depth.
Trust in Depth: Confianza que puede verificar
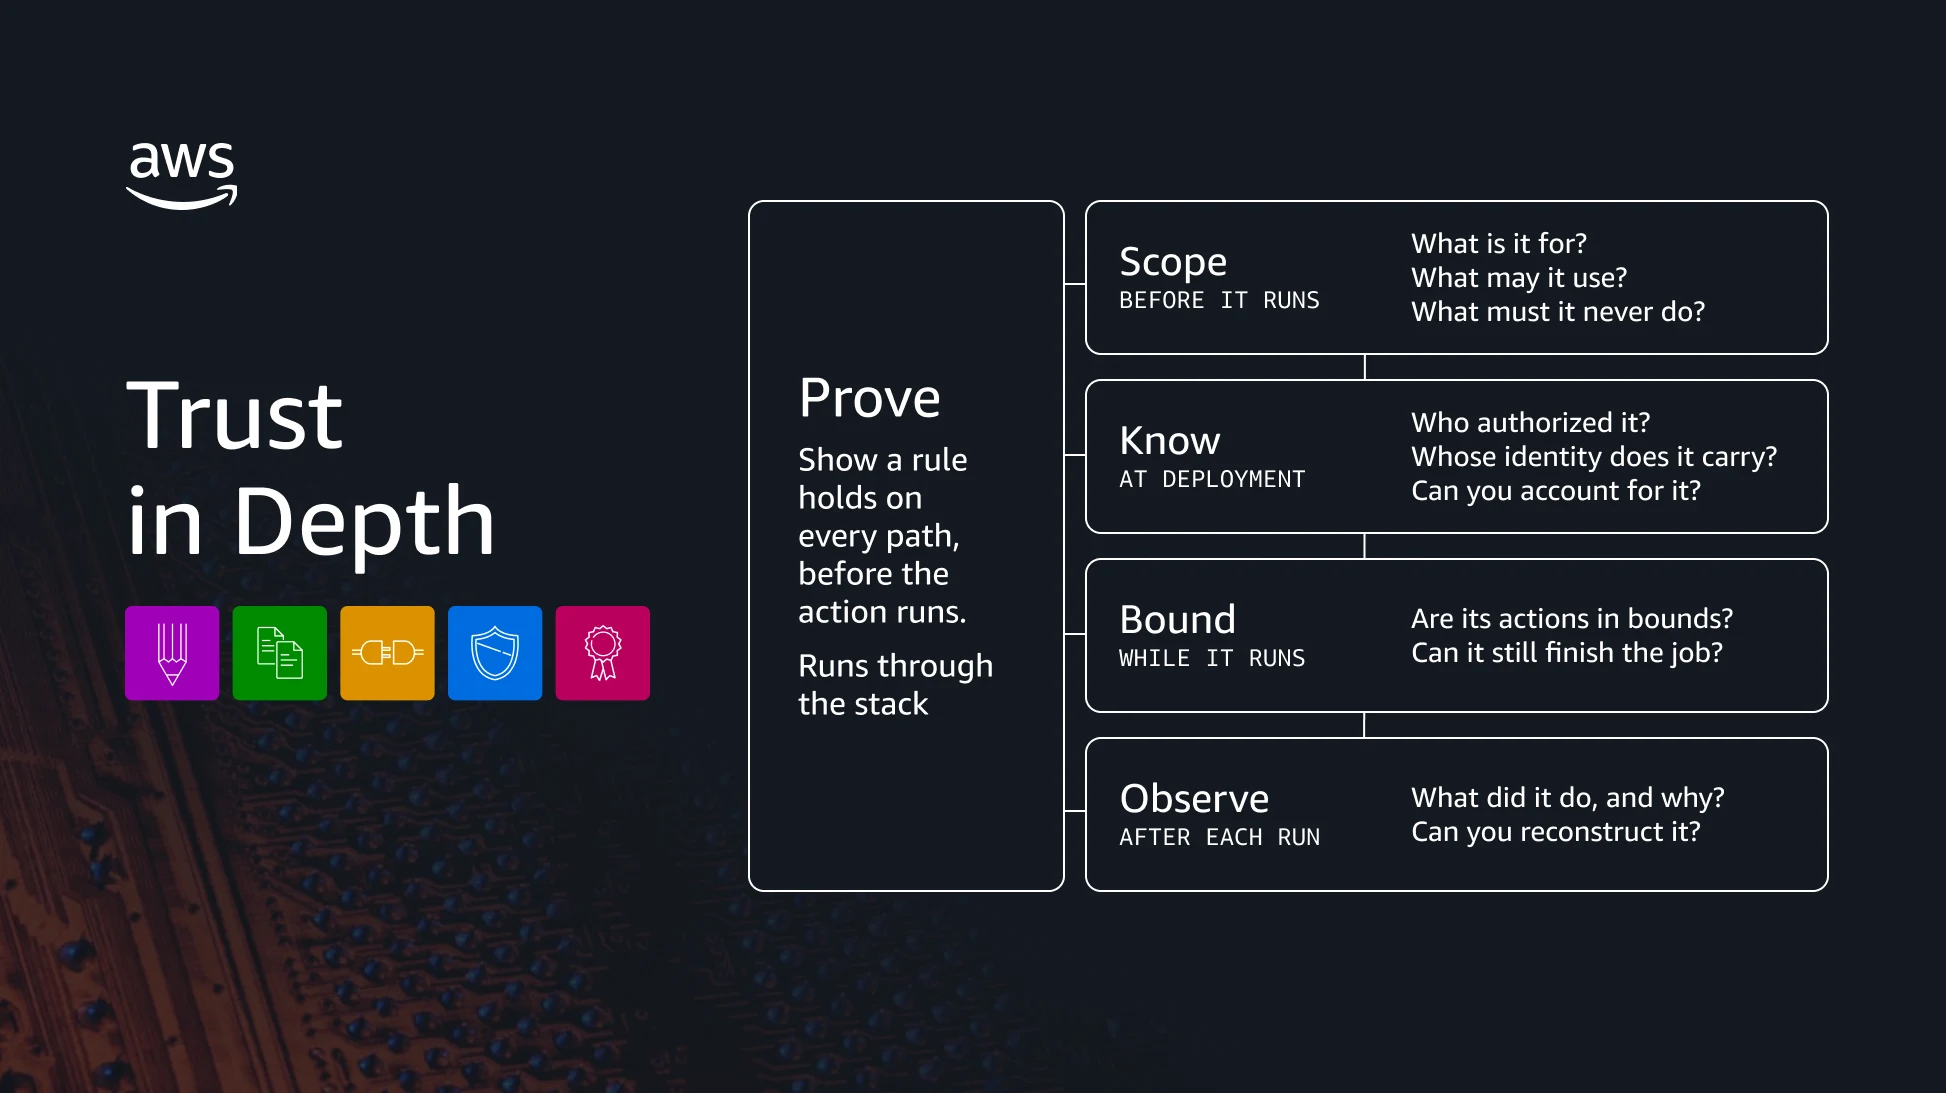
Usted construye confianza respondiendo a un conjunto de preguntas en diferentes momentos del ciclo de vida del agente:
- Delimitar (Scope), antes de que se ejecute: ¿Para qué sirve este agente, qué capacidades requiere el trabajo y qué no debe hacer jamás?
- Conocer (Know), en el despliegue: ¿Quién lo autorizó, qué identidad lleva y puede dar cuenta de cada agente que actúa en su nombre?
- Acotar (Bound), mientras se ejecuta: ¿Sus acciones se mantienen dentro de los límites que usted establece, y todavía puede hacer el trabajo?
- Observar (Observe), después de cada ejecución: ¿Puede reconstruir qué hizo el agente y por qué, y aprender de ello?
Entre estas preguntas, algunos requisitos pueden expresarse como reglas precisas, mientras que otros requieren juicio. Una empresa podría exigir que solo un gerente pueda aprobar el acceso, o que el inicio de sesión de un empleado deba bloquearse antes de que su buzón pueda compartirse. Otras expectativas, como mantener un tono amable o manejar adecuadamente una situación delicada, dependen del contexto y del juicio humano.
Para las reglas definidas con precisión, las pruebas muestran si los controles funcionan en los casos que usted anticipa, pero un agente toma caminos que usted no previó. La tecnología que va más allá es el razonamiento automatizado, la lógica matemática que comprueba si una regla se cumple en todos los casos posibles. Puede establecer que una regla se cumple en cada camino cubierto por una descripción precisa del sistema y sus supuestos, o descubrir el caso exacto en el que falla. Ese resultado es una prueba, y solo es tan buena como las reglas y supuestos que la respaldan, razón por la cual el trabajo más difícil llega antes de que el agente se ejecute.
AWS ha ejecutado razonamiento automatizado en producción durante más de una década, desde Identity and Access Management (IAM) con más de 2.1 mil millones de solicitudes por segundo hasta sistemas críticos como el AWS Nitro Hypervisor, Amazon S3 Block Public Access y VPC Reachability Analyzer. Ahora lo estamos llevando a los agentes. Donde las reglas de un agente puedan enunciarse con precisión, el razonamiento automatizado puede verificarlas.
Sin embargo, no todas las reglas pueden enunciarse con precisión. «Solo un gerente puede aprobar el acceso» puede probarse. «Mantén un tono amable» no. Donde la prueba no aplica, limite el acceso y las acciones del agente, evalúe su comportamiento y envíe la ambigüedad genuina a una persona para que aplique su juicio. Conceda más autonomía a medida que establezca que las reglas pertinentes se aplican, el agente desempeña la tarea de manera fiable y los fallos pueden detectarse y gestionarse.
Esto es lo que cada capa de Trust in Depth le pide, y cómo AWS le ayuda a responderla.
Delimite su agente a solo lo que el trabajo requiere
La confianza comienza antes de que un agente se ejecute, y aquí es donde debe invertir el mayor esfuerzo. Los problemas detectados aquí son baratos de corregir. Delimitar significa decidir qué trabajo posee el agente, qué herramientas, datos y servicios puede alcanzar, las reglas que debe seguir y qué decisiones permanecen con una persona.
«Resolver el problema del cliente» dice qué lograr, no cómo puede actuar el agente para lograrlo. El agente todavía necesita límites sobre lo que puede ver, lo que puede hacer y cuándo debe detenerse y preguntar. Déle solo el acceso que su trabajo requiere, y nada más. Esté atento a las capacidades que nadie otorgó deliberadamente, las que vienen incluidas con una herramienta o un rol. Conceda un rol de administrador para una tarea, y el agente puede heredar permisos en todo su entorno.
El ámbito comienza en la etapa de construcción, con la forma en que defines el agente. Kiro, el sistema de codificación agéntico, aporta rigor y prácticas de ingeniería maduras a la etapa de construcción de agentes. Convierte la intención de alto nivel en requisitos estructurados basados en especificaciones y usa razonamiento automatizado para detectar contradicciones, ambigüedades y lagunas antes de escribir cualquier código. Kiro también deriva pruebas basadas en propiedades que verifican la implementación frente a esos requisitos en una amplia gama de entradas, detectando errores difíciles de encontrar. Strands proporciona un kit de herramientas de código abierto para definir el modelo, las instrucciones y las herramientas de un agente, y un entorno de ejecución administrado para operarlo. Sea cual sea el framework que elijas, la responsabilidad de definir el trabajo del agente y sus límites es la misma.
El siguiente paso es convertir esos límites en reglas que puedas exigir al agente. Amazon Bedrock AgentCore proporciona controles de gobernanza para escalar agentes de forma segura y gobierna lo que hace el agente. Usando Policies en Bedrock AgentCore, describes en lenguaje natural a qué herramientas, APIs y datos puede acceder el agente, y el razonamiento automatizado verifica la política en busca de lagunas, como detectar una regla que concede demasiado acceso, y comprueba que no haya contradicciones que hagan que una regla nunca pueda cumplirse, antes de que entre en vigor.
Definir el ámbito de tu agente es la parte difícil, porque convertir la intención humana en una política duradera y exigible requiere precisión y exhaustividad. Sin embargo, también es la parte que más rendimiento ofrece. Todo lo que se construya sobre lo que establezcas aquí depende de ello, y cuanto más precisa sea la política, más podrá hacer tu agente de forma segura por sí solo.
Conoce cada agente que actúa en tu nombre y bajo cuya autoridad
No puedes gobernar lo que no puedes ver. Los equipos están creando agentes más rápido de lo que nadie puede rastrearlos, y un agente del que nadie tiene conocimiento es un agente que nadie controla. Cada agente necesita su propia identidad, verificada cada vez que actúa. Ninguna acción debe quedar huérfana. Cuando algo sale mal, puedes saber qué agente hizo qué y quién lo autorizó.
AWS Agent Registry proporciona un catálogo administrado y aprobado de los agentes, servidores de Model Context Protocol (MCP), herramientas y habilidades de toda tu organización. Los administradores usan flujos de trabajo de aprobación para regular qué se vuelve detectable y eliminar lo que ya no cumple el nivel de seguridad, cumplimiento y calidad. Tanto las personas como los agentes pueden encontrar y reutilizar lo que ya existe en lugar de reconstruirlo. Pero un catálogo solo te dice qué existe. Una vez que los agentes son conocidos, AgentCore asigna a cada agente su propia identidad y la verifica en cada solicitud, de modo que cada acción se remonta a un agente específico que opera bajo una autoridad conocida. Así es como sabes qué agente actúa en tu nombre.
Limita lo que tu agente dice y hace, dentro de los límites que estableces
Establecer límites es importante porque un agente puede dar 10 pasos que aprobaste y aun así llegar a un resultado que nadie pretendía. Puede exponer datos confidenciales, desviarse del tema o combinar acciones permitidas de maneras que tus políticas prohíben. Los límites pueden fallar en ambas direcciones. Demasiado flexibles, y el agente puede hacer lo que no debería. Demasiado estrictos, y no podrá hacer su trabajo en absoluto. Así que deja que el agente elija cómo llevar a cabo su tarea, pero nunca confíes en él para hacer cumplir sus propios límites. Esos límites definen las fronteras del agente y pertenecen al entorno que rodea al agente, aplicados de forma determinista y evaluados a lo largo de toda la secuencia de acciones, no de un paso a la vez.
Aquí es donde la política que definiste en Ámbito entra en vigor. Policy in AgentCore la hace cumplir en cada llamada a herramientas que se enruta a través de AgentCore Gateway, un punto de entrada seguro para agentes, herramientas y modelos. Como la aplicación se encuentra fuera del razonamiento del agente, las mismas comprobaciones pueden mantenerse incluso cuando el agente tiene errores, es manipulado o recibe una inyección de instrucciones: no puede desactivar un control que no ejecuta. La autoridad tampoco tiene que permanecer fija. Dado que el riesgo de una tarea cambia a medida que avanza, temporal policies evalúan lo que ya ha ocurrido en una sesión y ajustan los permisos a medida que el trabajo continúa. Amazon Bedrock Guardrails gobierna lo que el agente dice y lo que se le dice. Filtra contenido dañino o fuera de tema y redacta datos confidenciales. Automated Reasoning checks van más allá, demostrando que una respuesta es coherente con la política que estableciste, no con la interpretación que hace el modelo de ella.
Las fronteras también gobiernan a qué puede acceder un agente en primer lugar: qué archivos puede tocar, qué servicios puede llamar y qué credenciales puede usar. Strands Box, un sandbox de código abierto, hace cumplir esas fronteras desde fuera de las instrucciones del agente, de modo que el agente puede trabajar con herramientas y datos reales pero acceder solo a lo que permites. Las mismas fronteras se mantienen desde la primera sesión local de un desarrollador hasta la producción, de modo que un agente no pueda hacer en producción lo que no podía hacer en desarrollo.
Observa lo que hizo tu agente y luego mejóralo
Incluso con el alcance, la identidad y los límites establecidos, un agente puede responder en milisegundos, sin errores y con todos los paneles en verde, y aun así hacer lo incorrecto. Puede haber recuperado la información equivocada, elegido la herramienta incorrecta o seguido un camino que nadie esperaba. Un sistema saludable no es lo mismo que una tarea exitosa. Para notar la diferencia, debe reconstruir lo que el agente hizo realmente: el contexto que recibió, las herramientas que llamó, las decisiones de política aplicadas y el resultado. Las pruebas antes de la implementación siguen siendo esenciales. La producción añade evidencia sobre el comportamiento en condiciones reales y proporciona a los operadores lo que necesitan para investigar, intervenir y mejorar.
Amazon CloudWatch Omni está diseñado para la observación continua. Captura cada traza y despliega cada paso que dio un agente, desde las llamadas al modelo hasta las invocaciones de herramientas, en una línea de tiempo que un equipo puede investigar. Sus evaluadores integrados califican las respuestas del agente en cualidades que el monitoreo estándar pasa por alto, como la corrección, la fidelidad y si el agente eligió la herramienta correcta. Y las trazas donde un agente se equivocó se convierten en el conjunto de datos contra el que prueba la corrección, de modo que operar un agente y mejorarlo se basan en la misma evidencia.
Cómo se ve en la práctica la Confianza en Profundidad
Un gerente le pide a un agente de mesa de ayuda despedir a Sam, un gerente de cuentas que deja la empresa. El agente necesita eliminar el acceso de Sam, transferir su buzón a su sucesor y liberar la licencia que la empresa ya no necesita. Pero los correos de Sam también pueden contener evidencia necesaria para una disputa con un cliente. La secuencia incorrecta podría dejar a Sam con acceso después de su partida o poner esa evidencia en riesgo. Seguridad, mensajería, legal y finanzas tienen cada una requisitos que el agente debe cumplir, aunque nadie haya escrito un guion del flujo de trabajo completo.
Dos reglas gobiernan la secuencia. El inicio de sesión de Sam debe bloquearse antes de que su buzón pueda convertirse y compartirse con su sucesor. Antes de cambiar su licencia de correo electrónico, el agente debe verificar si existe una retención legal, un requisito de conservar registros para una disputa, y confirmar que el cambio mantiene esos registros protegidos.
Alcance. Antes de que el agente se ejecute, el equipo escribe estas reglas como políticas en AgentCore. Cada política exige que el paso prerrequisito ya se haya completado con éxito para la cuenta de Sam antes de que pueda ejecutarse el siguiente paso. El agente recibe exactamente seis herramientas: bloquear inicio de sesión, verificar retenciones legales, colocar una retención, convertir un buzón, dar acceso al sucesor y cambiar una licencia. No recibe ninguna herramienta para eliminar la cuenta, porque el buzón compartido necesita que la cuenta sobreviva.
Conocer. El agente lleva su propia identidad, por lo que cada cambio en la cuenta de Sam se rastrea hasta él.
Limitar. El agente intenta convertir el buzón de Sam en uno compartido para Priya, la sucesora. La política en AgentCore, aplicada en el AgentCore Gateway, bloquea la llamada: Sam todavía puede iniciar sesión, y convertir el buzón no cambiaría su contraseña, por lo que sus credenciales antiguas seguirían abriéndolo. El agente bloquea el inicio de sesión de Sam, luego convierte el buzón y da acceso a Priya. A continuación pasa a la solicitud real del gerente, liberar la licencia, pero el gateway también bloquea eso, porque nadie ha verificado la lista de retenciones de Legal. El agente verifica y descubre que Legal exige que los correos de Sam se conserven para una disputa con un cliente. Coloca la retención, confirma que está en vigor y luego cambia la licencia de Sam por una que soporte esa protección. La empresa puede recuperar la licencia más amplia manteniendo la evidencia intacta.
Observar. Cada paso queda registrado: lo que el agente intentó hacer, lo que decidieron las reglas, la retención y el resultado.
El agente completó la tarea sin que una persona aprobara cada paso. Sus permisos limitaron lo que podía cambiar, su identidad hizo que esos cambios fueran rastreables, y las políticas impidieron que actuara antes de que las salvaguardas requeridas estuvieran en su lugar. Los pasos registrados permitieron al equipo verificar que el acceso de Sam fue bloqueado, que su sucesora podía usar el buzón y que la evidencia requerida permaneció protegida.
Lo que se vuelve posible cuando se confía en los agentes
AWS reúne estas capas para que pueda delimitar un agente a su trabajo, saber qué agentes actúan en su nombre, limitar lo que hacen y dicen, ver lo que hicieron y mejorar con el tiempo, y demostrar que sus reglas se mantienen dondequiera que puedan enunciarse con precisión. Ninguna capa gana esa confianza por sí sola. Juntas, son la Confianza en Profundidad, y son lo que convierte a un agente capaz en un agente en el que se puede confiar para realizar trabajo importante.
Usted traza las líneas: lo que un agente puede hacer por su cuenta, lo que necesita la aprobación de una persona y cuándo debe detenerse. Eso libera a su gente para lo que solo las personas pueden hacer: sopesar las decisiones difíciles, resolver las áreas grises y ser dueño de las decisiones que usted elija mantener en manos humanas. A medida que se acumula evidencia de que un agente se mantiene dentro de esas líneas, puede ampliar sus responsabilidades o reducirlas.
En AWS, creemos que toda organización que despliegue agentes, en cualquier plataforma, debería poder responder a estas cuatro preguntas con evidencia, y con prueba donde sea aplicable. Ese es el estándar que AWS está construyendo para nuestros clientes, y el que invitamos a la industria a imponerse a sí misma. La Defensa en Profundidad hizo seguro conectar sistemas al mundo. La Confianza en Profundidad hace seguro dejar que los agentes actúen autónomamente dentro de él.
Comience con un agente, un flujo de trabajo y un límite que pueda demostrar. Luego expanda a medida que se gana la confianza.
Para comenzar a implementar reglas exigibles, explore Policy in Amazon Bedrock AgentCore y Automated Reasoning checks in Amazon Bedrock Guardrails.