
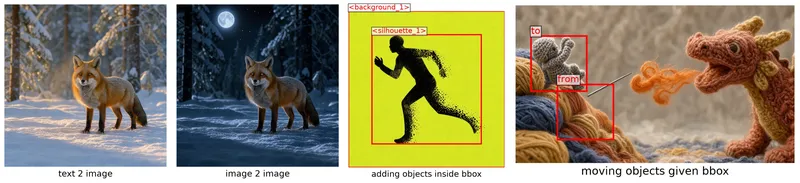
Black Forest Labs FLUX.3 Image Klein ya está aquí, y funciona en Diffusers desde el primer día. Un solo modelo hace texto-a-imagen e imagen-a-imagen con múltiples referencias, y añade algo nuevo, el control de diseño. Escribes bounding boxes en el prompt para indicar dónde debe ir cada parte de la imagen, o qué partes de una imagen de referencia mover.
Ambos checkpoints abiertos están en la colección FLUX.3 Image Klein:
| Checkpoint | Qué es | Valores por defecto |
|---|---|---|
black-forest-labs/flux-3-image-klein |
Destilado en pasos de tiempo, para inferencia rápida | 16 pasos, sin CFG |
black-forest-labs/flux-3-image-klein-base |
Modelo base | 50 pasos, CFG |

Puedes ir directamente al espacio de Hugging Face ¡y generar algunas imágenes ahora mismo!
En resumen
- Un modelo para texto-a-imagen, imagen-a-imagen con múltiples referencias y control de diseño con bounding boxes.
- El checkpoint destilado genera una imagen de 1024 × 1024 en unos 2 segundos en una H100.
- Los pesos NVFP4 y FP8 se cargan con
from_single_file, para GPUs más pequeñas. - Scripts de entrenamiento LoRA tanto para texto-a-imagen como para edición de imágenes.
- Se entrega como un pipeline de Modular Diffusers , de modo que puedes quitar bloques o añadir los tuyos propios.
Contenido
- Primeros pasos
- Qué puede hacer FLUX.3
- Modelo base y variantes cuantizadas
- Ajuste fino con LoRA
- Lo que cuesta ejecutarlo
- La arquitectura
- Diffusers modular
- Pruébalo
Primeros pasos
Instala la última versión diffusers y transformers (para el codificador de texto Qwen3-VL):
pip install -U diffusers transformers
Carga el checkpoint destilado y genera una imagen:
import torch
from diffusers import ModularPipeline

pipe = ModularPipeline.from_pretrained("black-forest-labs/flux-3-image-klein")
pipe.load_components(dtype=torch.bfloat16)
pipe.to("cuda")

pipe(prompt="a red fox", output="images")[0].save("fox.png")
Lo que FLUX.3 puede hacer
De texto a imagen
FLUX.3 responde mejor a una descripción completa de la escena con el sujeto, el entorno, la luz, la composición y el estilo. La guía oficial de prompting de Black Forest Labs tiene más consejos. El checkpoint destilado genera una 1024 × 1024 imagen en 16 pasos por defecto. Pasa height, width, o num_inference_steps para cambiarlos.
prompt = (
    "A wide-angle wildlife photograph of a red fox standing alert in a snow-covered forest clearing at golden hour. "
    "The fox is centered in the frame, its thick orange winter coat contrasting with the fresh white snow, breath "
    "visible in the cold air. Snow-laden pine trees fill the softly blurred background, and low warm sunlight rakes "
    "across the scene from the left, casting long blue shadows."
)

fox = pipe(
    prompt=prompt,
    generator=torch.Generator().manual_seed(0),
    output="images"
)[0]
fox.save("fox.png")
 |
|---|
| De texto a imagen |
De imagen a imagen
Pasa una imagen de referencia (o más) con el image argumento. Escribe el prompt como un pie de foto de la imagen que quieres, con el cambio incluido.
prompt = (
    "The same red fox in the same snow-covered forest clearing, now at night under a full moon: cool blue "
    "moonlight, deep shadows, stars visible through the pine branches, the fox's eyes catching the light."
)
night = pipe(
    prompt=prompt,
    image=fox, # from the previous text to image example
    generator=torch.Generator().manual_seed(0),
    output="images",
)[0]
night.save("night.png")
 |
|---|
| De imagen a imagen |
Con varias referencias, refiérete a ellas en el prompt como <ref_image_0>, <ref_image_1>, ... en el orden en que se pasan a image:
red_fox = pipe(prompt="a red fox", generator=torch.Generator().manual_seed(0), output="images")[0]
bench = pipe(prompt="a wooden bench", generator=torch.Generator().manual_seed(0), output="images")[0]

combined = pipe(
    prompt="The fox from <ref_image_0> sitting on the wooden bench from <ref_image_1> in a snowy setting.",
    image=[red_fox, bench],
    output="images",
)[0]

combined.save("combined.png")
 |
 |
 |
|---|---|---|
<ref_image_0>: un zorro rojo |
<ref_image_1>: un banco de madera |
El zorro en el banco |
Control de diseño
Añade una lista JSON de regiones después del pie de foto. Cada región tiene un id, un bboxy un desc, y el pie de foto la menciona como <id>.
Las cajas se escriben como
[y_min, x_min, y_max, x_max], y primero, en una escala de 0–1000. Como la escala está normalizada, la misma caja funciona con cualquier tamaño de imagen.
Colocar regiones en una nueva imagen
layout_prompt = (
    "Minimalist graphic illustration featuring a black silhouette of a person <silhouette_1> centered against a "
    "solid, vibrant chartreuse background <background_1>. The figure is captured in a dynamic, mid-stride running "
    "pose, facing toward the left side of the frame. "
    '[{"id": "background_1", "bbox": [0, 0, 1000, 1000], "desc": "A flat field of neon yellow-green with a subtle '
    'paper texture and fine, organic grain."}, {"id": "silhouette_1", "bbox": [150, 150, 850, 850], "desc": "A '
    "black silhouette of a person in motion, made of dense stippled ink. The leading edges are solid; the trailing "
    'arm and leg dissolve into coarse square pixels and scattered dots."}]'
)

runner = pipe(prompt=layout_prompt, generator=torch.Generator().manual_seed(0), output="images")[0]
 |
|---|
El desc de cada región se dibuja dentro de su bbox |
Mover regiones dentro de una imagen de referencia
Para las ediciones, cada región indica de dónde proviene su contenido de (src_bbox en la referencia) y a dónde va (tgt_bbox en la salida). Una región con las mismas dos cajas permanece donde está.
Este ejemplo mueve al caballero tejido hacia arriba y a la izquierda, y fija el fondo, el acantilado, la aguja, el dragón y el fuego:
from diffusers.utils import load_image

knight_image = load_image("knight_orig.png")
edit_prompt = (
    "In <ref_image_0>, move the miniature grey amigurumi knight figure <knight_1> upwards and to the left along the "
    "yarn cliff <cliff_1>. Keep the rest of the image completely unchanged, preserving the blurred yarn backdrop "
    "<backdrop_1>, the large knitted dragon <dragon_1>, and the fiery orange thread <fire_1>. "
    '[{"id": "knight_1", "from": "ref_image_0", "src_bbox": [500, 150, 850, 350], "tgt_bbox": [194, 55, 544, 255], '
    '"desc": "A miniature amigurumi knight crocheted from thick grey woolen yarn."}, '
    '{"id": "backdrop_1", "from": "ref_image_0", "src_bbox": [0, 0, 1000, 1000], "tgt_bbox": [0, 0, 1000, 1000], '
    '"desc": "A soft, out-of-focus backdrop of cream and indigo knitted yarn."}, '
    '{"id": "cliff_1", "from": "ref_image_0", "src_bbox": [300, 0, 1000, 450], "tgt_bbox": [300, 0, 1000, 450], '
    '"desc": "A steep cliff of stacked yarn skeins in mustard, terracotta, and indigo."}, '
    '{"id": "needle_1", "from": "ref_image_0", "src_bbox": [420, 250, 550, 450], "tgt_bbox": [420, 250, 550, 450], '
    '"desc": "An oversized polished steel tapestry needle."}, '
    '{"id": "dragon_1", "from": "ref_image_0", "src_bbox": [100, 600, 950, 1000], "tgt_bbox": [100, 600, 950, 1000], '
    '"desc": "A large, fluffy knitted dragon in terracotta and mustard yarn."}, '
    '{"id": "fire_1", "from": "ref_image_0", "src_bbox": [350, 400, 650, 650], "tgt_bbox": [350, 400, 650, 650], '
    '"desc": "Curled puffs of fiery orange angora thread suspended in mid-air."}]'
)

moved = pipe(prompt=edit_prompt, image=knight_image, generator=torch.Generator().manual_seed(0), output="images")[0]
 |
|---|
El caballero se mueve desde su src_bbox hasta su tgt_bbox, y el resto de la escena se queda en su lugar |
Modelo base y variantes cuantizadas
Modelo base
Todo lo anterior usa el checkpoint destilado. El checkpoint base ejecuta 50 pasos con classifier-free guidance, y es el que hay que ajustar finamente (véase Ajuste fino con LoRA).
pipe = ModularPipeline.from_pretrained("black-forest-labs/flux-3-image-klein-base")
pipe.load_components(dtype={"vae": torch.float32, "default": torch.bfloat16})
pipe.to("cuda")

pipe.guider = pipe.guider.new(guidance_scale=5.0)  # optional
image = pipe(prompt=prompt, output="images")[0]
Checkpoints en formato de archivo único
Black Forest Labs también distribuye el transformer como un solo archivo, en bf16 y en dos formatos cuantizados: fp8r (rowwise FP8) y nvfp4. Carga cualquiera de ellos con from_single_file, y luego carga los demás componentes por nombre para que el transformer bf16 tampoco se descargue.
from diffusers import BFLQuantizationConfig, Flux3Transformer2DModel, ModularPipeline

model_id = "black-forest-labs/flux-3-image-klein-base"
variant = "fp8r"  # or "nvfp4"

transformer = Flux3Transformer2DModel.from_single_file(
    f"https://huggingface.co/{model_id}/blob/main/variants/{variant}/model.safetensors",
    config=model_id,
    subfolder="transformer",
    quantization_config=BFLQuantizationConfig(compute_dtype=torch.bfloat16),
    dtype=torch.bfloat16,
)

pipe = ModularPipeline.from_pretrained(model_id)
pipe.load_components(dtype=torch.bfloat16)
pipe.update_components(transformer=transformer)
pipe.to("cuda")
Para el archivo único sin cuantizar, usa https://huggingface.co/{model_id}/blob/main/model.safetensors y omite quantization_config.
| Variante | Kernels rápidos en | Otras GPUs |
|---|---|---|
fp8r |
Capacidad de cómputo 8.9+ (Ada, Hopper, Blackwell) | Los pesos se descuantizan en cada paso: menos memoria, sin aumento de velocidad |
nvfp4 |
Blackwell, con flashinfer-python y flashinfer-cubin en la misma versión |
Igual que arriba |
Ajuste fino de LoRA
FLUX.3 funciona tanto para texto-a-imagen como para imagen-a-imagen, lo que lo convierte en una excelente base para LoRAs personalizados. diffusers incluye scripts de entrenamiento DreamBooth LoRA para ambas tareas (también puedes entrenar con AI Toolkit de Ostris).
Aquí hay un ejemplo de texto-a-imagen que aprende un estilo de cartas de tarot a partir del conjunto de datos multimodalart/1920-raider-waite-tarot-public-domain , activado con trtcrd:
accelerate launch train_dreambooth_lora_flux3_klein.py \
  --pretrained_model_name_or_path="black-forest-labs/flux-3-image-klein-base" \
  --dataset_name="multimodalart/1920-raider-waite-tarot-public-domain" \
  --caption_column="caption" \
  --instance_prompt="trtcrd" \
  --output_dir="trained-flux3-tarot-lora" \
  --mixed_precision="bf16" \
  --resolution=1024 \
  --use_aspect_ratio_buckets \
  --train_batch_size=1 \
  --rank=16 \
  --lora_alpha=16 \
  --learning_rate=1e-4 \
  --lr_scheduler="constant" \
  --max_train_steps=1500 \
  --validation_prompt="a trtcrd of a cat, tarot style" \
  --validation_epochs=25 \
  --seed=0 \
  --push_to_hub
Para reducir el uso de memoria, añade algunos flags de optimización:
  --gradient_checkpointing \
  --cache_latents \
  --use_8bit_adam
--gradient_checkpointingrecalcula las activaciones en la pasada hacia atrás (menos VRAM, ligeramente más lento),--cache_latentsprecodifica las imágenes y libera la VAE, y--use_8bit_adammantiene los estados del optimizador en 8-bit.
Vale la pena experimentar con un par de parámetros. La cuadrícula siguiente entrena el mismo estilo de tarot con diferentes ranks de LoRA y optimizadores; los adaptadores están en el Hub en diffusers-modular/flux3-tarot-lora. Más funciones y configuraciones de entrenamiento están documentadas en el DreamBooth FLUX.3 README.

Para la edición basada en instrucciones, el script de imagen-a-imagen (train_dreambooth_lora_flux3_klein_img2img.py) entrena con tripletas (imagen de referencia, imagen objetivo, instrucción), donde la referencia se menciona en el prompt como <ref_image_0>.
Consulta el DreamBooth FLUX.3 README para ver todas las opciones y el ejemplo completo de imagen-a-imagen.
Cuánto cuesta ejecutarlo
En esta sección, hablaremos del consumo de memoria y la velocidad de generación de los modelos.
Memoria
| nombre | pico asignado (tras la carga) GiBs | pico asignado (tras la inferencia) GiBs |
|---|---|---|
| nvfp4 (RTX6000) | 13.4 | 15.3 |
| fp8r (H100) | 14.35 | 16.27 |
| bf16 (H100) | 18.80 | 20.72 |
Si tienes menos memoria:
- Cargar un transformador cuantizado.
- Ejecute el codificador de texto por separado y libérelo. Solo se ejecuta una vez por imagen, antes de la eliminación de ruido (véase Codificar una vez, generar muchas).
- Active la descarga automática a la CPU, que mueve cada componente a la GPU solo mientras se ejecuta (no hicimos pruebas de rendimiento de esto)
from diffusers import ComponentsManager, ModularPipeline

manager = ComponentsManager()
manager.enable_auto_cpu_offload(device="cuda")

pipe = ModularPipeline.from_pretrained("black-forest-labs/flux-3-image-klein", components_manager=manager)
pipe.load_components(dtype={"vae": torch.float32, "default": torch.bfloat16})
# no pipe.to("cuda"): the manager handles device placement
Velocidad
Tiempos de extremo a extremo para el checkpoint destilado (16 pasos), promediados sobre tres ejecuciones después de un calentamiento:
| Flujo de trabajo | Tamaño de salida | Tiempo | Memoria máxima |
|---|---|---|---|
| De texto a imagen | 1024 × 1024 | 1.93 s | 23.8 GiB |
| De imagen a imagen, una referencia de 1024 × 1024 | 1024 × 1024 | 3,87 s | 23.8 GiB |
| Edición de diseño (el caballo), una referencia de 1360 × 768 | 1360 × 768 | 4,10 s | 23.8 GiB |
Una sola NVIDIA H100 80GB, sin offloading, backend de atención predeterminado.
Una imagen de referencia aproximadamente duplica el tiempo. Los tokens de referencia se unen a la misma secuencia que el texto y la imagen que se está generando, por lo que una referencia de 1024 × 1024 añade 4,096 tokens a cada llamada del transformador
 |
|---|
| Barras apiladas de tokens por llamada del transformador: texto a imagen 4,256 tokens; imagen a imagen 8,272; texto a imagen con diseño 4,336; imagen a imagen con diseño 8,800 |
La arquitectura
Abramos el modelo, una pieza a la vez. El modelo recibe tres tipos de tokens:
- texto
- la imagen con ruido que se está generando
- y opcionales imágenes de referencia
De píxeles a tokens
FLUX.3 es un modelo de flujo en espacio latente para generación de imágenes. Esto significa que el desenfocador toma latentes como entrada y produce latentes como salida. Usamos un VAE para decodificar los latentes de vuelta a píxeles. FLUX.3 usa la misma arquitectura de VAE que Flux.2.
El VAE de FLUX.2 comprime una imagen 8× en cada dirección en 32 canales, y luego cada parche de 2 × 2 de ese latente se empaqueta en un solo token con 128 canales.
Así un token cubre un parche de 16 × 16 píxeles, y una imagen de 1024 × 1024 se convierte en una cuadrícula de 64 × 64 con 4,096 tokens. La imagen con ruido comienza como ruido aleatorio de exactamente esa forma. Una imagen de referencia pasa por el mismo codificador VAE y empaquetado, y conserva su propio tamaño.
Del prompt a los tokens
El codificador de texto es Qwen3-VL, un modelo de visión y lenguaje. FLUX.3 no solo toma su última capa. Lee los estados ocultos de ocho de sus 36 capas (capas 4, 8, …, 32) y las apila, de modo que cada token de texto se convierte en un vector de 8 × 2560 = 20,480 dimensiones antes de que una capa lineal lo proyecte al ancho del transformador, que es 3072.
Esto le da al transformador características de varias profundidades del modelo de lenguaje, no solo de su capa final. El prompt se rellena hasta un múltiplo de 80 tokens, y el transformador también atiende al relleno, por lo que el pipeline toma un prompt por llamada.
Dos etapas
El transformador procesa los tokens en dos etapas:
- Etapa 1: bloques por modo. Cada flujo pasa por 5 bloques con sus propios pesos. El texto tiene sus propios bloques, la imagen ruidosa tiene los suyos, y las imágenes de referencia tienen los suyos.
- Etapa 2: bloques conjuntos. Los flujos se concatenan en una sola secuencia,
[text | image | reference], que pasa por 28 bloques que comparten un único conjunto de pesos.
Las dos etapas se diferencian en quién puede atender a quién.
En la etapa 1, cada flujo solo atiende a sí mismo, así que cada tipo de token se refina primero en sus propios términos. En la etapa 2, todo atiende a todo, donde la imagen aprende del texto y de las referencias. Para comparar, los bloques double-stream de FLUX.2 también dan pesos separados al texto y a la imagen, pero les permiten atenderse mutuamente desde el principio. FLUX.3 mantiene los flujos completamente separados primero, y luego los fusiona.
Al final, los tokens de texto y de referencia simplemente se descartan. Solo los tokens de imagen pasan por las capas de salida, que predicen cómo moverlos un paso hacia una imagen limpia.
Dentro de un bloque
Cada bloque, en cualquiera de las etapas, tiene la misma forma. La atención y el MLP se ejecutan en paralelo sobre la misma entrada normalizada, y su suma se añade de nuevo al flujo residual.
Cada bloque comienza con un LayerNorm que no tiene escala ni desplazamiento aprendidos propios. La escala, el desplazamiento y la puerta provienen de un embedding del paso temporal en su lugar (esto se llama modulación). Dentro de la atención, las queries y las keys se normalizan con RMS y reciben rotary position embeddings (RoPE), que veremos a continuación.
En un bloque conjunto, todos los tokens comparten los mismos pesos, pero los tokens de texto, imagen y referencia reciben cada uno su propia escala, desplazamiento y puerta.
def block(x, shift, scale, gate):      # shift, scale, gate come from the token's timestep embedding
    h = layer_norm(x)                  # no learned scale or shift
    h = (1 + scale) * h + shift
    q, k, v = to_q(h), to_k(h), to_v(h)
    q, k = rope(rms_norm(q)), rope(rms_norm(k))
    out = attention(q, k, v) + mlp(h)  # parallel, MLP is SwiGLU
    return x + gate * out
Cada token obtiene su propio paso de tiempo
En FLUX.1 y FLUX.2, una sola incrustación de paso de tiempo modula todos los tokens. En FLUX.3, la modulación depende del tipo de token.
Los tokens ruidosos de la imagen son modulados por el paso de tiempo actual t. Los tokens de texto y referencia siempre son modulados por el paso de tiempo 0, lo que significa «limpio, nada que eliminar el ruido aquí». Así que incluso una referencia que parece casi idéntica a la salida se marca como contexto dado, no como algo que generar.
El checkpoint destilado es un mapa de flujo. También se le indica el paso de tiempo al que salta cada paso. Ese segundo paso de tiempo obtiene su propia incrustación, que se añade a la modulación de cada token, de modo que cada uno de sus 16 pasos puede dar un salto mayor.
Posiciones en cuatro dimensiones
La atención por sí sola no sabe dónde está un token (este fenómeno se llama equivariancia de permutación). RoPE lo corrige rotando cada query y key en una cantidad que depende de la posición del token. FLUX.3 utiliza cuatro ejes de posición, (t, h, w, l) (paso de tiempo, altura, anchura, longitud de la secuencia), y le asigna a cada uno un cuarto (32 dimensiones) de cada cabeza de atención de 128 dimensiones:
| Tokens | t: paso de tiempo | h: altura | w: anchura | l: longitud de la secuencia |
|---|---|---|---|---|
| token de texto i | 0 | 0 | 0 | i |
| token de imagen en (fila, columna) | 0 | fila / 2 | columna / 2 | 0 |
| referencia k en (fila, columna) | 0 | fila / 2 | columna / 2 | −(k + 1) |
Los tokens de texto se alinean a lo largo de l, como palabras en una frase. La imagen y las referencias son cuadrículas 2D en (h, w), separadas entre sí a lo largo de l. Como una referencia usa las mismas (h, w) coordenadas que la salida, «el mismo punto de la referencia» tiene un significado preciso para el modelo, que es en lo que se basa la src_bbox / tgt_bbox edición.
El bucle de desnudging
FLUX.3 es un modelo de flow-matching. La generación parte de ruido puro y, en cada uno de los 50 pasos, el transformador predice una velocidad. Esta es la dirección del ruido hacia una imagen limpia. El scheduler da un paso a lo largo de ella.
En cada paso también se puede leer la estimación actual del modelo sobre la imagen final. Decodificar esa estimación en unos pocos pasos muestra cómo toma forma la imagen:
 |
 |
||||
|---|---|---|---|---|---|
| Paso 1 | Paso 5 | Paso 10 | Paso 15 | Paso 25 | Paso 50 |
El zorro, su pose y la luz ya están en su lugar en el paso 10, mientras el nivel de ruido sigue siendo 0.97. Las ramas cargadas de nieve y la textura del pelaje solo aparecen en los últimos pasos. El scheduler de FLUX.3 usa un gran time shift (6.93), que mantiene el nivel de ruido alto durante la mayor parte de la ejecución: 44 de los 50 pasos ocurren por encima de σ = 0.5. Construimos esta figura añadiendo un pequeño bloque al pipeline, lo que nos lleva a Modular Diffusers.
Si es la primera vez que usas flow matching, tenemos un tutorial para principiantes y un video para que entiendas cómo funciona.
Modular Diffusers
FLUX.3 se distribuye como un pipeline de Modular Diffusers .
Consulta los workflows
Puedes listar los workflows e imprimir los bloques exactos de cada uno, sin cargar ningún peso.
from diffusers import Flux3AutoBlocks

blocks = Flux3AutoBlocks()
print(blocks.available_workflows)
# ['text2image', 'image_conditioned']

print(list(blocks.get_workflow("text2image").sub_blocks))
# ['text_encoder', 'denoise.input', 'denoise.prepare_latents', 'denoise.set_timesteps',
#  'denoise.prepare_rope_inputs', 'denoise.denoise', 'denoise.after_denoise', 'decode']
get_workflow() resuelve las ramas auto y te da la secuencia simple de pasos que se ejecutarán. print(blocks.get_workflow("image_conditioned").doc) imprime los componentes, las entradas, los valores por defecto y las salidas de ese workflow.
Codifica una vez, genera muchas
Saca el text encoder, codifica el prompt una sola vez, libéralo y genera a partir de los embeddings almacenados en caché.
import torch
from diffusers import ModularPipeline

model_id = "black-forest-labs/flux-3-image-klein-base"

blocks = ModularPipeline.from_pretrained(model_id).blocks
text_blocks = blocks.sub_blocks.pop("text_encoder")  # `blocks` now starts at the VAE encoder

text_pipe = text_blocks.init_pipeline(model_id)
text_pipe.load_components(dtype=torch.bfloat16)
text_pipe.to("cuda")

state = text_pipe(prompt=prompt, negative_prompt="")  # no guider here, so ask for the negative embeddings

prompt_embeds = state.get("prompt_embeds")
negative_prompt_embeds = state.get("negative_prompt_embeds")

del text_pipe
torch.cuda.empty_cache()

image_pipe = blocks.init_pipeline(model_id)  # no text encoder to load
image_pipe.load_components(dtype={"vae": torch.float32, "default": torch.bfloat16})
image_pipe.to("cuda")

for seed in range(3):
    image = image_pipe(
        prompt_embeds=prompt_embeds,
        negative_prompt_embeds=negative_prompt_embeds,
        generator=torch.Generator().manual_seed(seed),
        output="images",
    )[0]
    image.save(f"{seed}.png")
Añade un paso dentro del bucle
La figura de denoising de arriba provino de un bloque adicional que registra la estimación del modelo de la imagen limpia en cada paso:
from diffusers.modular_pipelines import Flux3AutoBlocks, InputParam, ModularPipelineBlocks, OutputParam


class Flux3PreviewStep(ModularPipelineBlocks):
    model_name = "flux3"

    @property
    def inputs(self):
        return [InputParam("latents"), InputParam("noise_pred")]

    @property
    def intermediate_outputs(self):
        return [OutputParam("x0_previews", type_hint=list)]

    @torch.no_grad()
    def __call__(self, components, block_state, i, t):
        if i == 0:
            block_state.x0_previews = []
        sigma = t / 1000  # timesteps are sigmas scaled to [0, 1000]
        block_state.x0_previews.append(block_state.latents - sigma * block_state.noise_pred)  # x0 = x_t - sigma * v
        return components, block_state


blocks = Flux3AutoBlocks()
denoise_loop = blocks.sub_blocks["denoise"].sub_blocks["text2image"].sub_blocks["denoise"]
denoise_loop.sub_blocks.insert("preview", Flux3PreviewStep(), 1)  # between "denoiser" and "after_denoiser"

pipe = blocks.init_pipeline(model_id)
pipe.load_components(dtype={"vae": torch.float32, "default": torch.bfloat16})
pipe.to("cuda")

out = pipe(prompt=prompt, generator=torch.Generator().manual_seed(0), output=["x0_previews", "images"])
Pruébalo
- Modelos: colección FLUX.3 Image Klein
- Documentación: FLUX.3 en Diffusers
- Fine-tuning: scripts de DreamBooth LoRA
- Prompting: guía de prompting de Black Forest Labs
¿Has creado algo con FLUX.3? Comparte tus LoRAs y pipelines en el Hub. ¡Nos encantaría verlos! 😎