IT之家 15 de octubre (nota). NVIDIA anunció el lanzamiento del modelo multimodal abierto Nemotron 3.5 Super VL, dirigido a agentes de IA que necesitan funcionar de manera continua y ejecutar tareas de múltiples pasos.
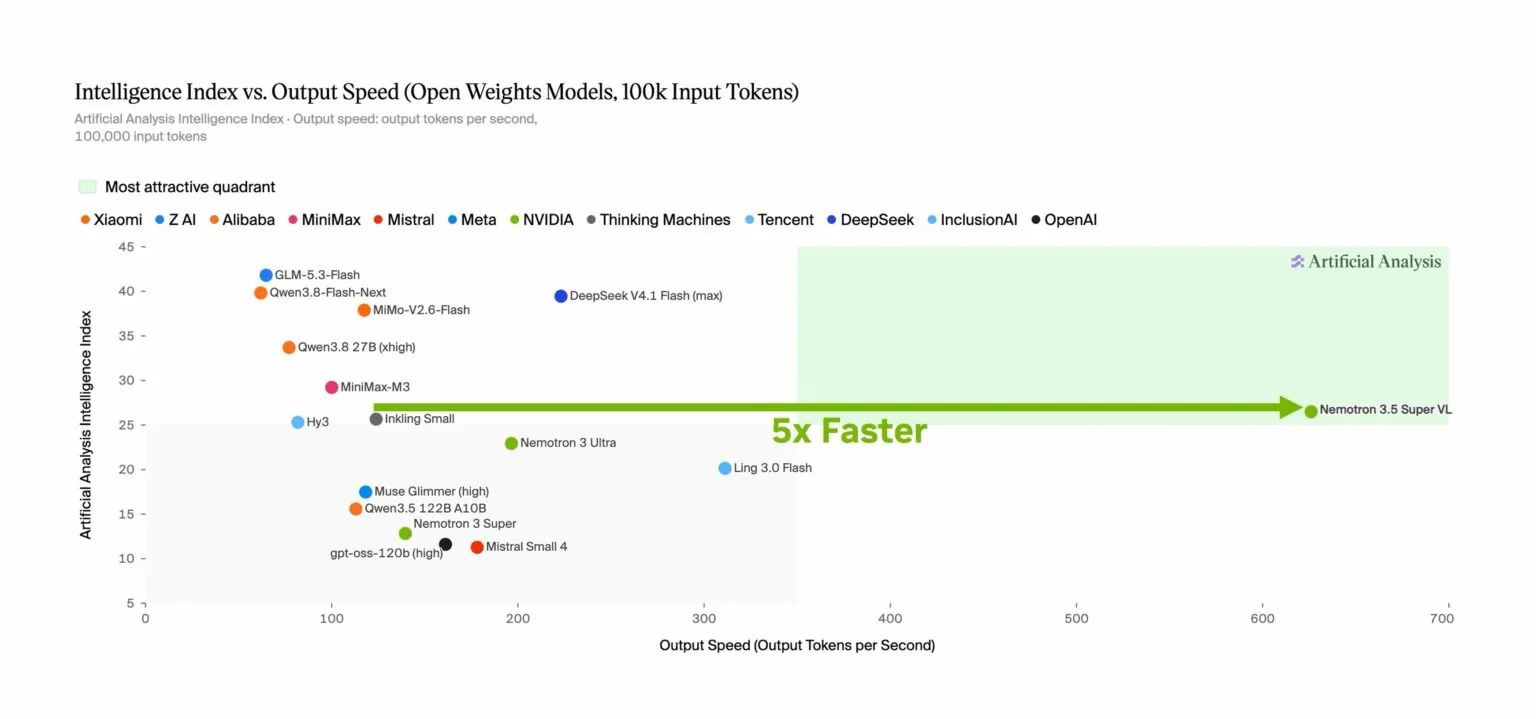
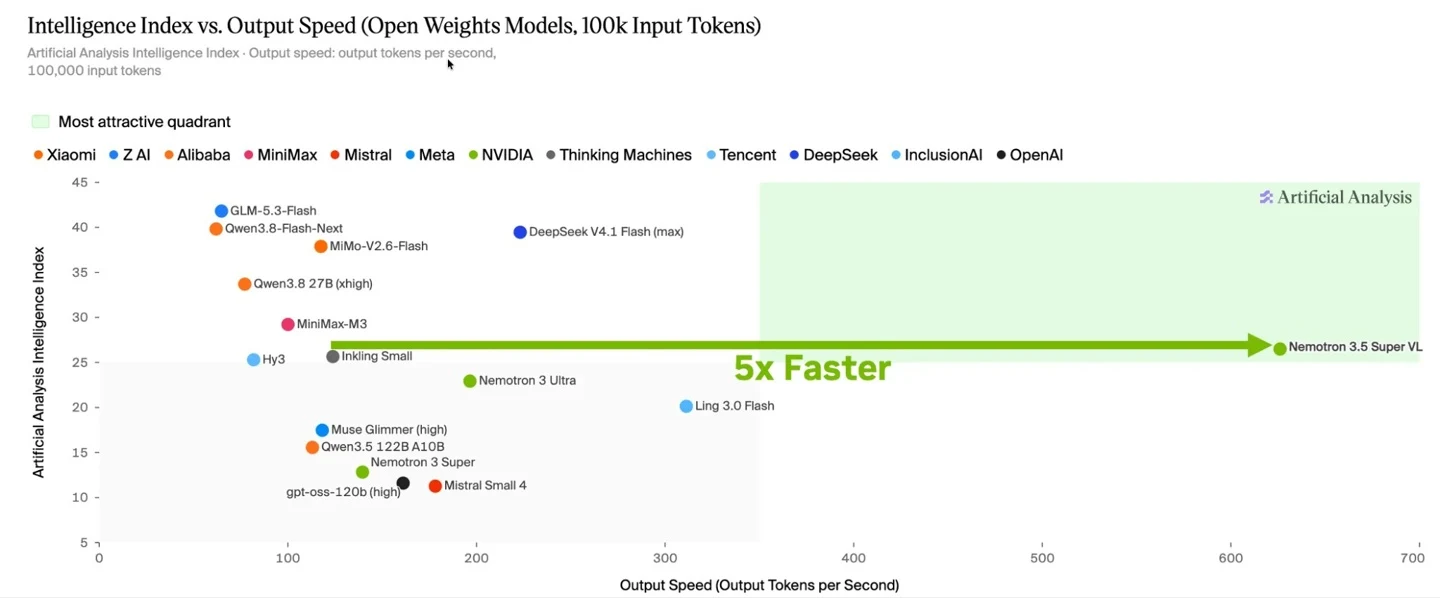
El modelo adopta una arquitectura de mezcla de expertos (MoE), con un total de 120 mil millones de parámetros y 12 mil millones de parámetros activados. NVIDIA afirma que, al ejecutar tareas de agentes en una sola GPU, el rendimiento de este modelo puede llegar a ser hasta 5 veces el de otros modelos abiertos de escala similar.
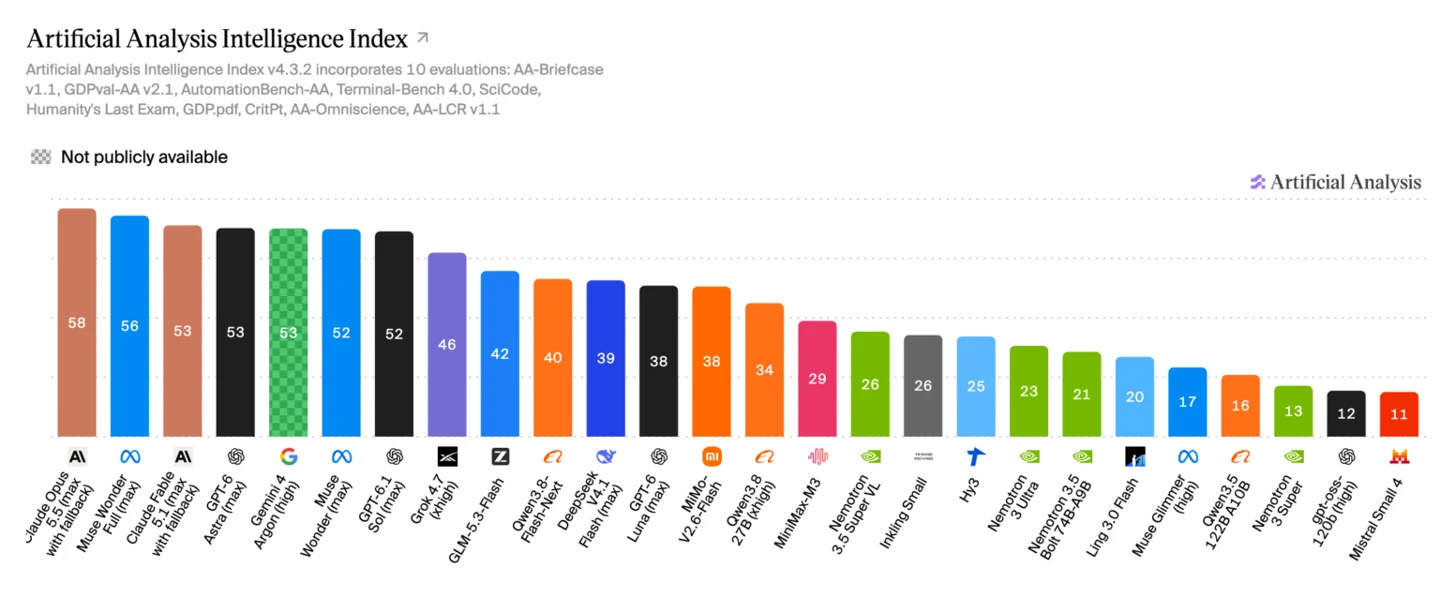
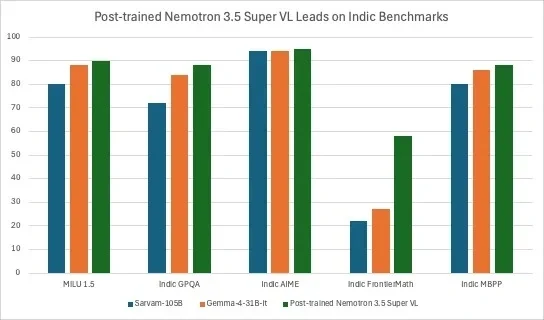
Según la presentación, Nemotron 3.5 Super VL integra las capacidades de razonamiento, seguimiento de instrucciones y llamadas a herramientas junto con la comprensión de texto, imágenes, documentos y video en un solo modelo, y puede utilizarse en escenarios como pruebas y depuración de código, recuperación de información a través de sitios web, análisis de documentos, identificación de amenazas de ciberseguridad y búsqueda de contenido en video. Los desarrolladores pueden utilizar la cadena de herramientas NeMo de NVIDIA para realizar postentrenamiento con sus propios datos, herramientas, políticas y flujos de trabajo, y ajustar el comportamiento del modelo según las necesidades del negocio.
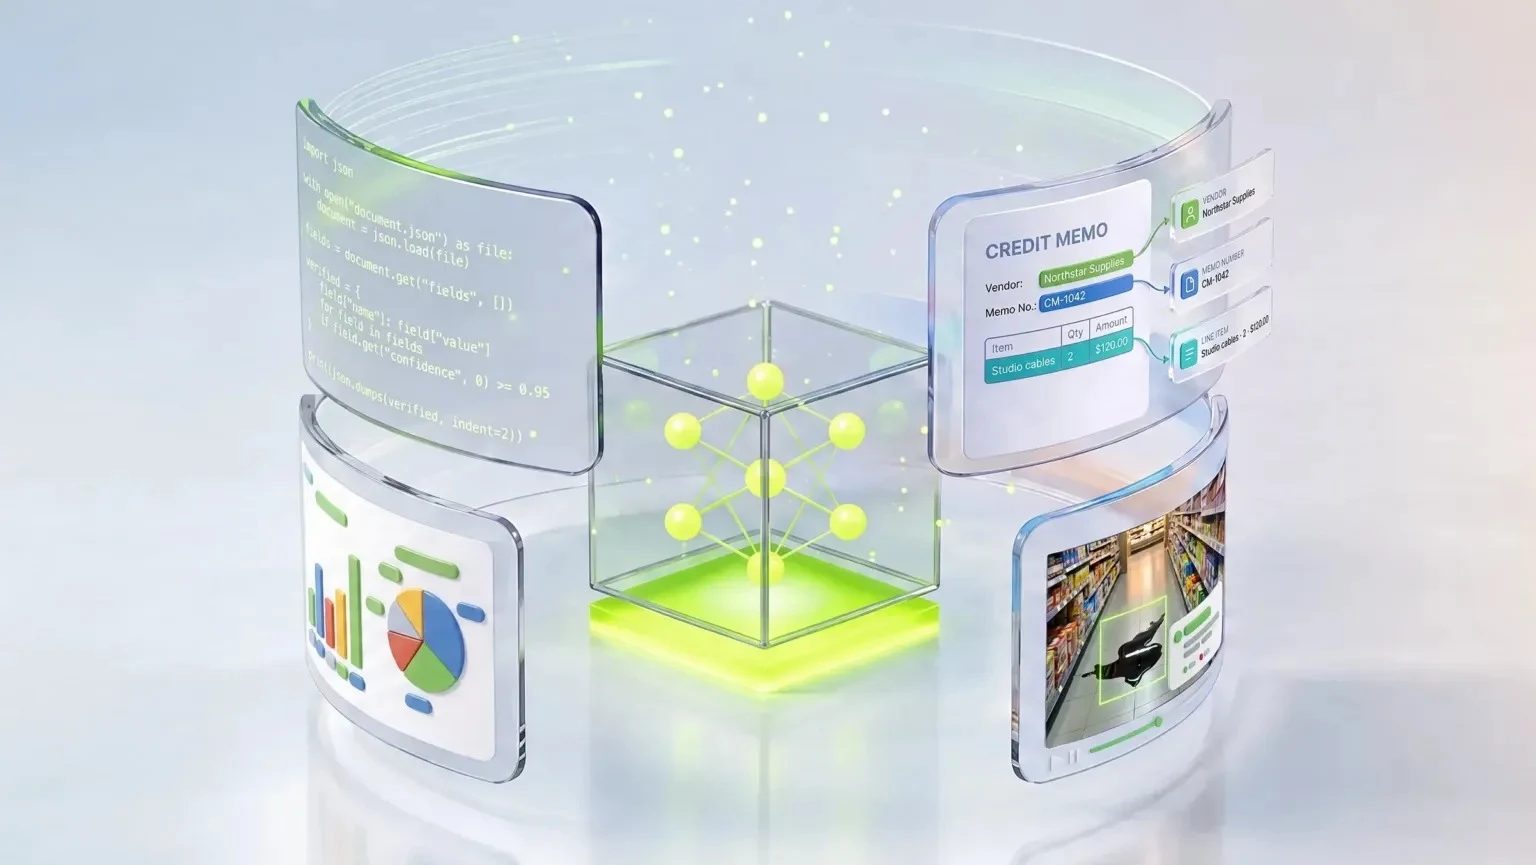
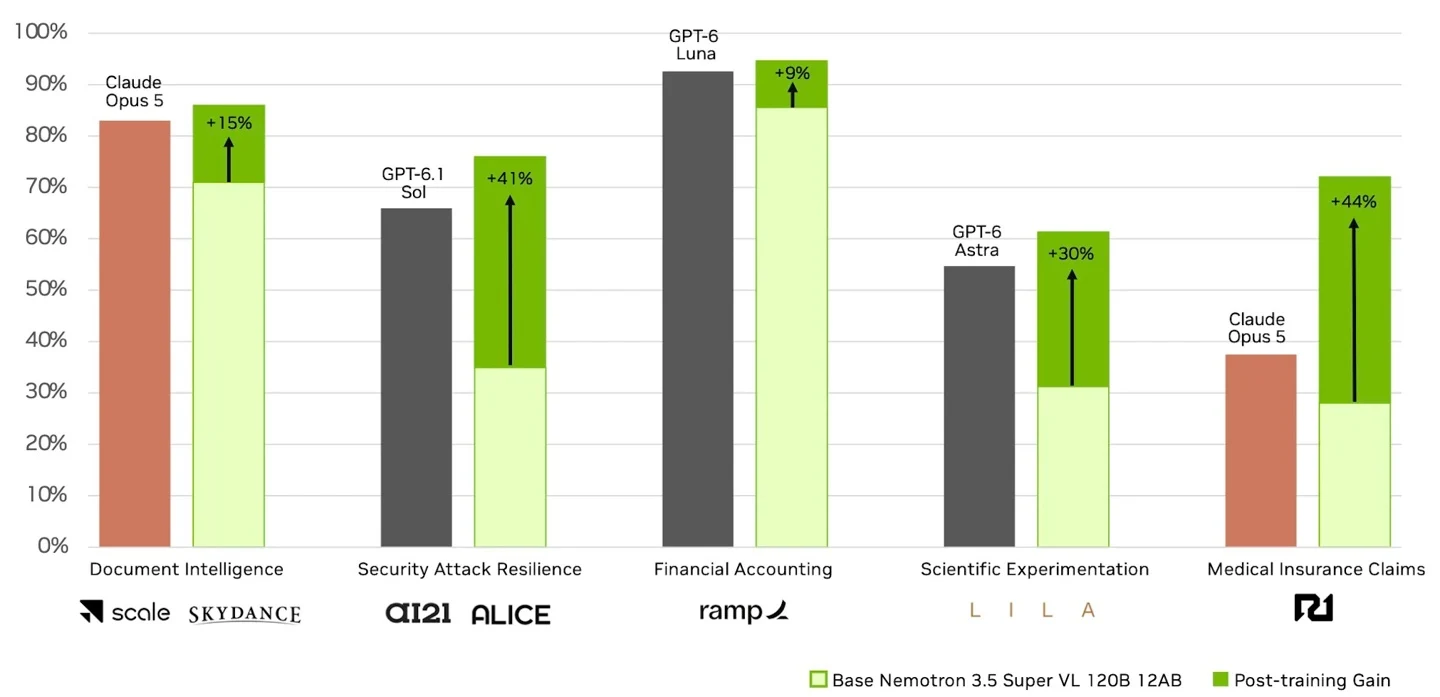
NVIDIA también dio a conocer varios casos de personalización empresarial. Por ejemplo, el proveedor de tecnología de datos de IA Scale AI personalizó para la compañía de medios y entretenimiento Skydance Corporation un agente de procesamiento de créditos de proveedores, y se estima que los costos de inferencia de esas cargas de trabajo se reducirán un 97.5% y la latencia un 80%.
La plataforma de operaciones financieras Ramp está convirtiendo imágenes de recibos en datos JSON estructurados que incluyen comercio, fecha e información de pago, con un aumento de rendimiento estimado de hasta 50% y una reducción de latencia de 90%. AI21 colaboró con la empresa de seguridad de IA Alice para personalizar un modelo destinado a la inteligencia de amenazas y el análisis de vulnerabilidades, con una mejora de precisión del 40% en esas tareas.
En cuanto a las evaluaciones del modelo, NVIDIA afirmó que Nemotron 3.5 Super VL obtuvo una puntuación de 80.8% en el benchmark de razonamiento sobre gráficos CharXiv, superior al 63% de Nemotron 3 Nano Omni; combinado con la interpretación de código Python, la puntuación alcanzó el 84%.
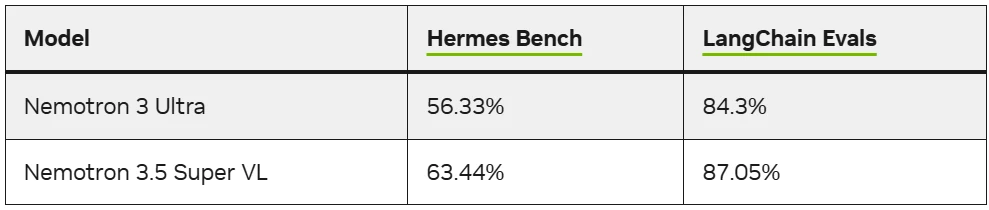
En las evaluaciones de comportamiento Hermes Bench y LangChain, el modelo obtuvo 63.44% y 87.05% respectivamente, por encima del 56.33% y 84.3% de Nemotron 3 Ultra. NVIDIA también indicó que este modelo se encuentra entre los modelos abiertos con mejor desempeño en la clasificación OCRBench v2.
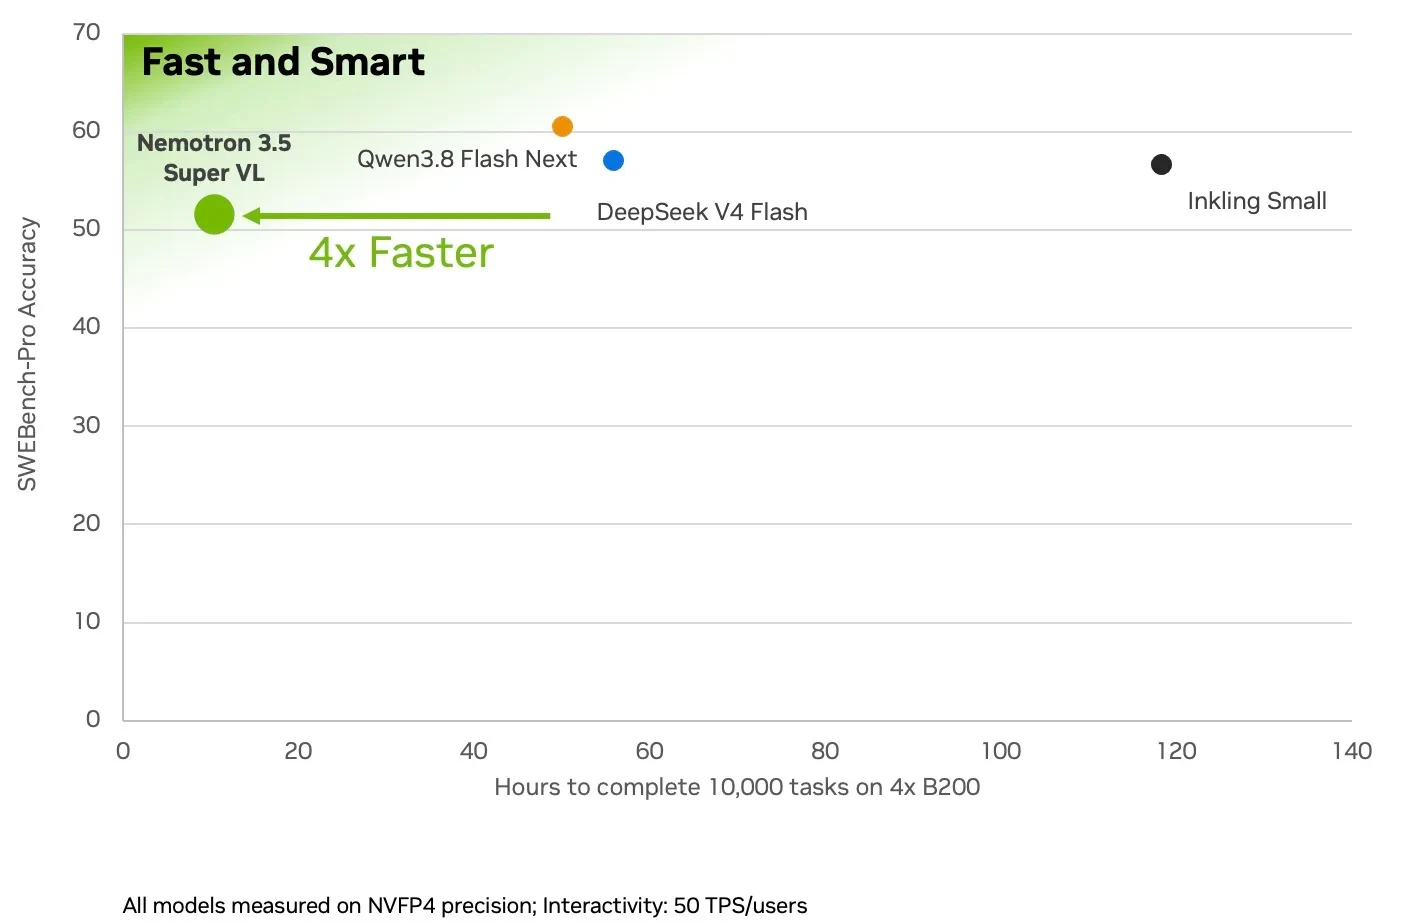
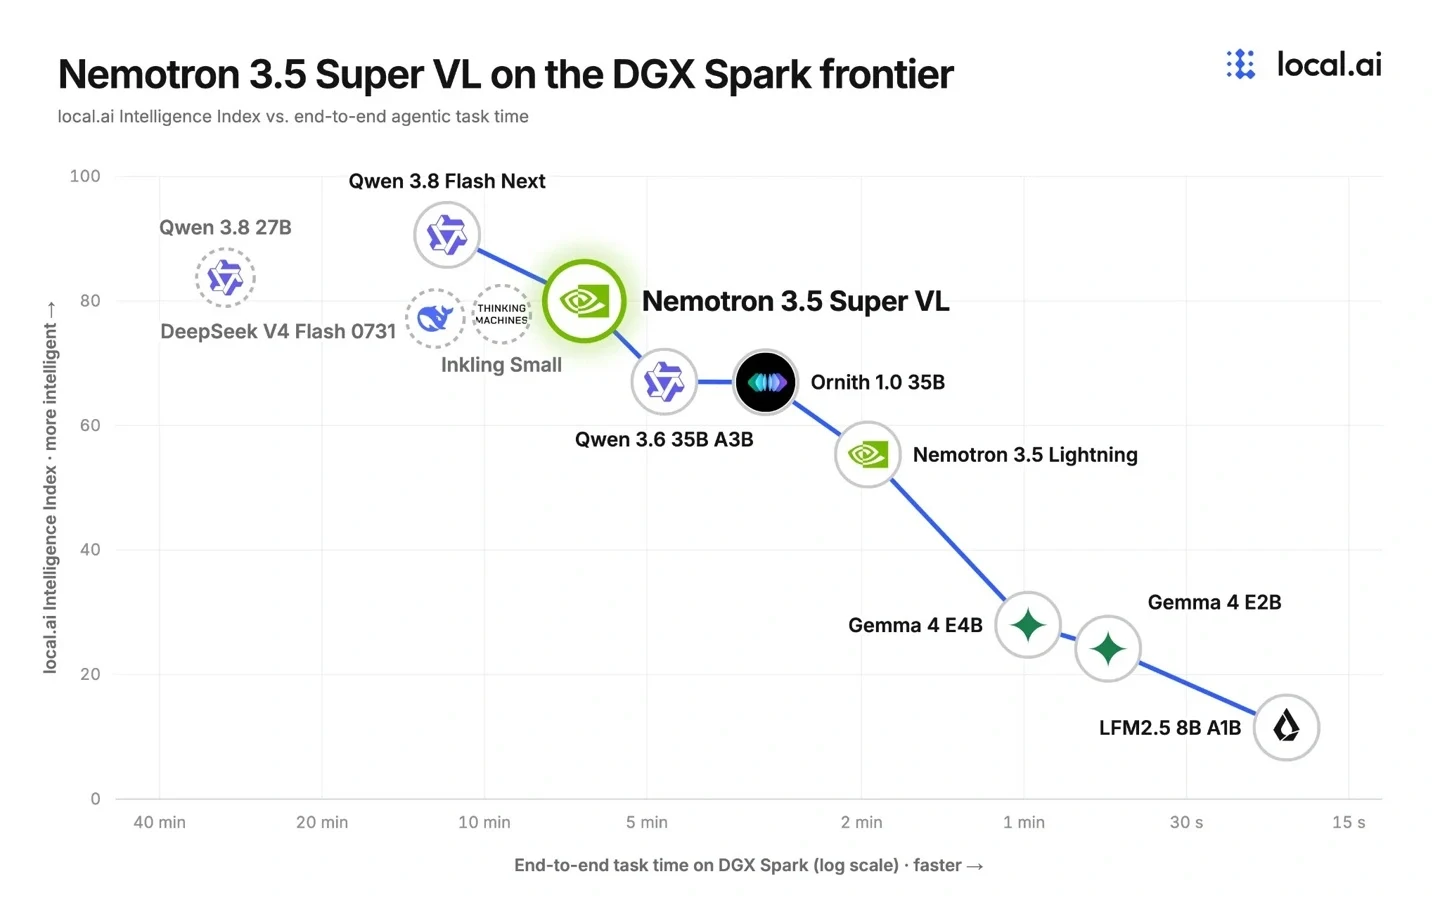
Para reducir el costo de inferencia, Nemotron 3.5 Super VL emplea técnicas como la decodificación especulativa, la precisión mixta y la reutilización de contexto. NVIDIA explicó que su método de decodificación especulativa LiLiCorr puede aumentar la velocidad de generación de tokens hasta 2.3 veces en DGX Spark. El modelo también admite la cuantización NVFP4, con pesos de 4 bits y activaciones de 4 bits en la arquitectura Blackwell de NVIDIA; en plataformas que no son Blackwell, el mismo checkpoint utiliza pesos de 4 bits y activaciones de 16 bits.
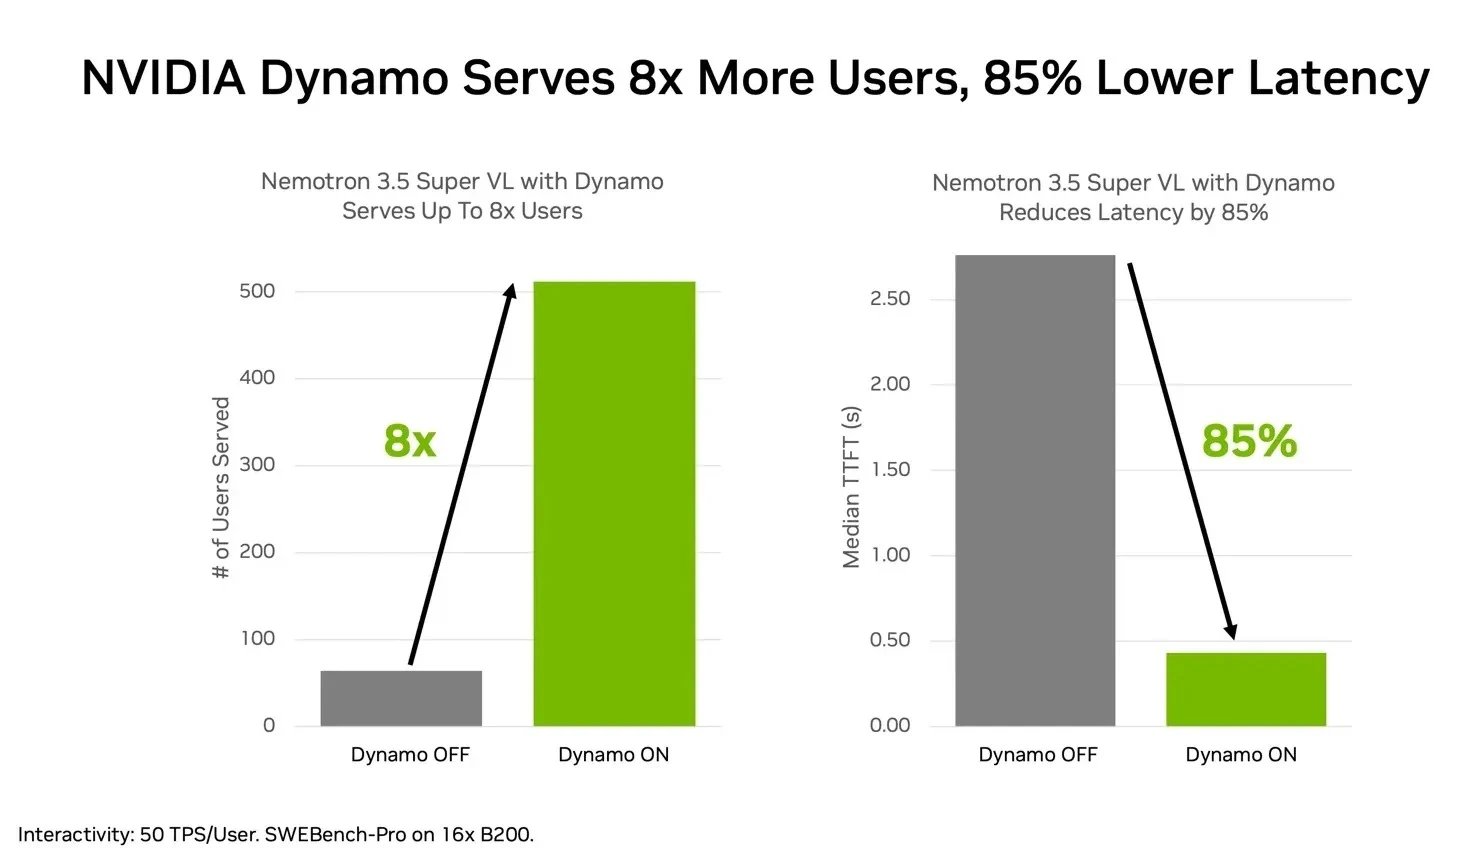
NVIDIA también presentó un esquema de optimización de despliegue orientado a la inferencia distribuida. Según los datos divulgados, en condiciones de prueba con 16 GPU NVIDIA B200 y una generación de 50 tokens por segundo por usuario, NVIDIA Dynamo, combinado con enrutamiento consciente de caché, afinidad de sesión y descarga de caché KV, puede atender hasta 8 veces más usuarios y reducir la latencia del primer token en un 85%.
Este lanzamiento también incluye los pesos del modelo base, de modelos posentrenados y del modelo cuantizado en NVFP4, así como las recetas de entrenamiento, los conjuntos de datos y los entornos de aprendizaje por refuerzo.
NVIDIA indicó que Nemotron 3.5 Super VL utilizó en total unos 26 billones de tokens durante el preentrenamiento y el preentrenamiento continuo, unos 3.8 millones de muestras en la fase de postentrenamiento, y realizó aprendizaje por refuerzo en decenas de entornos. Los nuevos conjuntos de datos abiertos abarcan ámbitos como las llamadas a herramientas de agentes, el razonamiento financiero, el seguimiento de instrucciones, contextos largos, la equidad y la comprensión del lenguaje visual.
Además de Super VL, NVIDIA también lanzó dos modelos en el dispositivo de la serie Nemotron 3.5 Bolt. Nemotron 3.5 Bolt 74B-A9B 24GB adopta una arquitectura MoE de 74 mil millones de parámetros totales y 9 mil millones de parámetros activados, y comprime el modelo a 24GB mediante cuantización nativa de 2 bits; está orientado a tareas de agentes locales y es compatible con llama.cpp, vLLM, Ollama, Unsloth y LM Studio. Nemotron 3.5 Bolt E4B 4GB está dirigido a escenarios como asistentes de voz locales, personajes interactivos e interfaces integradas, y está previsto para el 23 de octubre.
IT之家 señaló que Nemotron 3.5 Super VL y Bolt 74B-A9B 24GB ya están disponibles, y los desarrolladores pueden acceder a los recursos de estos modelos a través de Hugging Face, OpenRouter, ModelScope y otros canales. Super VL puede desplegarse en DGX Spark, DGX Station, sistemas RTX, centros de datos o la nube; Bolt E4B 4GB está previsto para el 23 de octubre.