

Google quiere que Gemini 4 Argon sea el único modelo de IA que los robots necesitan
 Jonathan Kemper
Ver el perfil de LinkedIn de Jonathan Kemper
15 de octubre de 2026
 Google Deepmind
Puntos clave
- Gemini 4 Argon es el intento de Google de desarrollar un único modelo de IA que controla robots, genera entornos de entrenamiento 3D interactivos y evalúa los datos de entrenamiento.
- De entradas simples como fotos o bocetos, el sistema genera simulaciones en las que los robots pueden practicar movimientos antes de su implementación en el mundo real.
- Las demostraciones todavía requieren un prompt y orientación detallados por parte del usuario. Argon está disponible a través de los programas de acceso pagado para desarrolladores de Google.
Con Gemini 4 Argon, Google está presentando un único modelo para todo el proceso de robótica. Este modelo controla robots, crea mundos de práctica virtuales y evalúa videos de entrenamiento. Pero los prompts de ejemplo revelan cuánto aún necesita la supervisión humana.
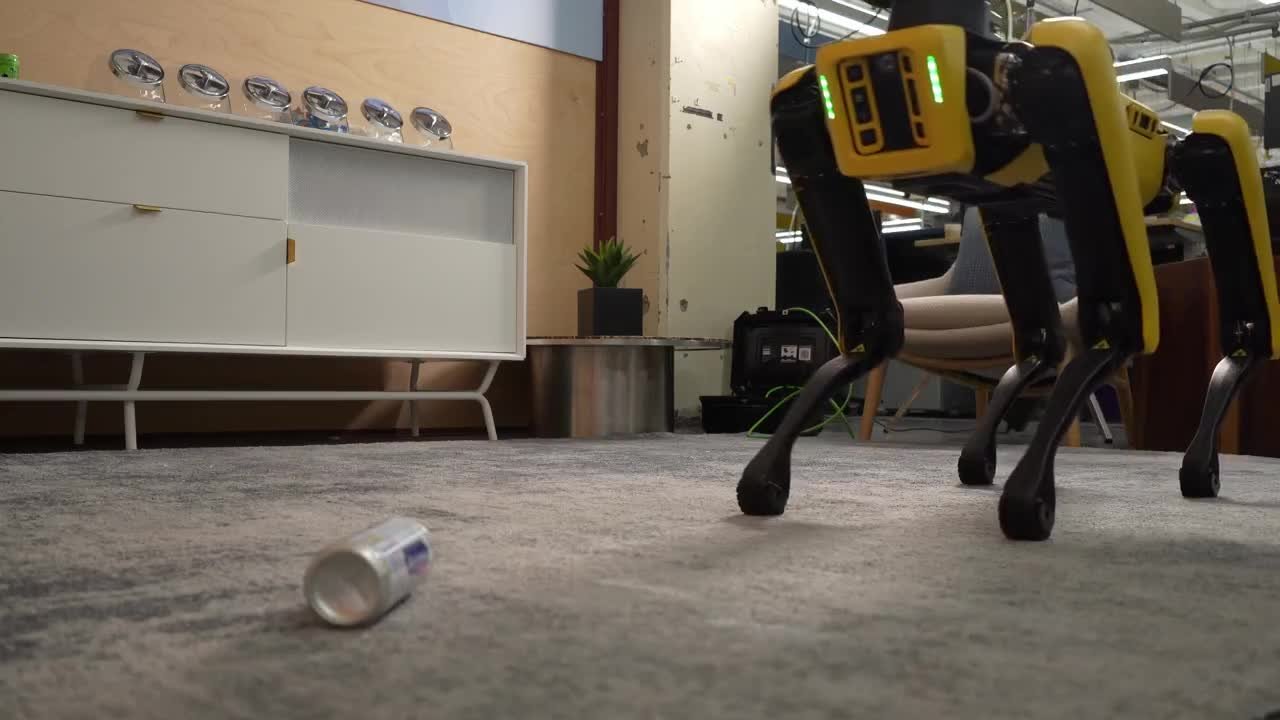
El robot Spot de Boston Dynamics debería lanzar latas de refresco en una papelera para basura con paso. Antes de tocar el pedal real, Gemini 4 Argon crea una copia virtual de la papelera, y el robot practica el equilibrio sobre tres patas dentro de esa simulación. Solo entonces intenta llevar a cabo la tarea con hardware real. Antes de dejar caer la lata, dos agentes de IA adicionales verifican que el pie y el agarrador estén posicionados correctamente.
Así es como Google demuestra las capacidades de su más nuevo modelo para tareas de robótica. Argon está diseñado para comprender mejor las relaciones espaciales, escribir código de control y interpretar videos en términos de física. Google considera este modelo una herramienta de uso general que abarca todo, desde el control de robots individuales hasta la recreación de investigaciones publicadas, y lo llama otro paso hacia “AGI física”, un objetivo que él y su filial de IA DeepMind han estado perseguiendo durante años.

Una sola foto se convierte en miles de ejercicios de entrenamiento
La demostración de Spot sigue un patrón que se observa en muchos ejemplos de Google: Argon utiliza simulaciones para preparar tareas, verificarlas o generar datos de entrenamiento. A partir de una sola foto de una mesa con accesorios de fiesta, el modelo construyó una réplica virtual, que incluye un gorro de peluche suave. El modelo ideó 77 tareas, desde volver a colocar objetos caídos hasta limpiar la mesa, y generó más de 4,500 episodios de entrenamiento para un modelo de control. Cuando se probó en el robot real, la tasa de éxito aumentó de 56 a 75 por ciento y el tiempo de ejecución disminuyó de 35 a 24 segundos.

El argón también puede provenir de otras fuentes. A partir de una grabación de un robot operado por teléfono, se crea una simulación diseñada para tener la misma apariencia y reproducir las mismas lecturas de fuerza en los dedos. A partir de un video en primera persona de un ser humano que realiza una tarea de agarre, el modelo traduce los movimientos de la mano y los dedos en un humanoide virtual con cinco dedos.
Incluso un boceto con un bolígrafo funciona. Un dibujo muestra un robot humanoide que derriba una pirámide de cajas con una pelota, y Argon lo convierte en una simulación que calcula el movimiento de lanzamiento para derribar todas las seis cajas sin que el robot caiga.

El argón dirige un modelo de video de IA para planificar las acciones del robot
Una demostración se desarrolla completamente dentro de un video generado por IA. Gemini Omni es un modelo de mundo vídeo que genera clips que muestran cómo cambia una escena cuando ocurre algo en ella, y Argon actúa como director. Escribe instrucciones con fecha de tiempo que describen qué deben hacer las manos, como desplazar una ficha de Scrabble al centro de la mesa. Gemini Omni genera un video a partir de esas instrucciones, y luego Argon revisa cada fotograma individual y ajusta la siguiente orden de comandos. El objetivo es armar cinco fichas de letras dispersas para formar la palabra “ARGON”, y después de 33 pasos, están en el orden correcto.

En una demostración separada con un simple brazo robótico, Argon tuvo que colocar un ladrillo de Lego en una caja de madera y mejorar su propio rendimiento a lo largo del tiempo. Cuando los intentos fallaban, el prompt le indicaba a Argon que revisara sus propios registros y imágenes de la cámara, identificara la causa y volviera a intentarlo después de aplicar una solución verificada. La primera ejecución duró poco menos de un minuto, y la segunda fue mucho más rápida, en 23 segundos, aunque el ladrillo rozó el borde de la caja. En el tercer intento, aterrizó justo en el centro después de unos 17 segundos.

Google también quiere que Argon sirva para investigación. Dado un único prompt por artículo, recrea experimentos de robótica publicados como simulaciones interactivas que se ejecutan en el navegador. Google dice que hasta ahora se han construido 68 tales sandboxes, incluyendo fútbol con robots y un robot humanoide en patinete.
El benchmark ERQA (Embodied Reasoning Question Answering) evalúa qué tan bien los modelos de IA comprenden y resuelven problemas físicos y espaciales en entornos 3D. El test utiliza 400 preguntas sin herramientas auxiliares, por lo que los modelos tenían que resolver todo mediante el razonamiento solo. Argon obtiene un 87 por ciento según Google, por delante de todos los otros modelos punteros. El segundo lugar, Claude Opus 5.5, alcanza un 82.3 por ciento, unos cinco puntos porcentuales por detrás. GPT-6 Astra sigue con un 81 por ciento, y Claude Fable 5.1 está en el último lugar con un 74 por ciento, 13 puntos por detrás.

El benchmark AA-Robotics de Artificial Analysis, publicado un día después, cuenta una historia diferente. En ese test, los modelos de lenguaje controlan directamente un brazo robótico real en ocho tareas, y Argon se posicionó en tercer lugar con 55 de 100 puntos, por detrás de GPT-6 Astra con 69 y GPT-6.1 Sol con 65.
Argón también revisa la calidad de los datos de entrenamiento
Más allá de controlar robots y crear simulaciones, Argon tiene como objetivo evaluar los datos de entrenamiento. En un video de poco más de dos minutos en el que se muestra un robot de dos brazos doblando un zorro en origami, el modelo divide la secuencia en subpasos y señala las pausas y los apretones fallidos. Esos segmentos reciben menos peso durante el entrenamiento. En otro video de una persona clasificando anillos, Argon rastrea dónde progresa la tarea, se detiene o retrocede.
Google también mostró un caso de uso más divertido basado en un puzzle clásico de pesaje. Entre doce bolas de apariencia idéntica, una es más pesada o más ligera que las demás. Argon construyó una simulación con dos brazos de robot y una balanza, leyendo la inclinación de la balanza a partir de imágenes de cámara únicamente. Encuentra la bola extraña en tres pesajes o menos.
El verdadero soporte está en los prompts
Google publicó prompts de ejemplo detallados para las demostraciones, y puso en perspectiva algunas de las afirmaciones más importantes. Para reparar una taza que se ha volcado, descrito como “zero-shot”, Argon recibe una imagen de cámara con un overlay de cuadrícula centimétrica y comandos preconstruidos como “agarrar” o “bajar hasta el contacto”. Para las simulaciones, hay listas largas de prohibiciones para evitar que el modelo tome atajos, como simplemente copiar los valores medidos por el sensor. En el artículo del blog, Google no comparte las tasas de fracaso de los demos individuales, y la tasa de éxito del 75 por ciento no menciona cuántas intentaciones totales se basa en ellas.

El argón está ahora disponible en Google AI Studio y en el entorno de desarrollo Antigravity, pero solo para suscriptores de Google AI Ultra. Los desarrolladores también pueden acceder al modelo a través de la etapa de pago de la Gemini API.
Google había lanzado Gemini 4 Argon globalmente apenas unos días antes. En cuanto a robótica, la empresa ya había introducido Gemini Robotics-ER 1.6, un modelo para percepción espacial y planificación de tareas. La capacitación en entornos virtuales tampoco es algo nuevo: la startup World Labs demostró cómo se pueden convertir escenas reales en mundos de entrenamiento virtual, mientras que DreamDojo de Nvidia simula las acciones de robots como videos. Lo que diferencia el enfoque de Google es la ambición de manejar simulación, control y evaluación con el mismo modelo.
Noticias sobre IA Sin Eufemismos – Seleccionadas por humanos
Suscríbase a THE DECODER para leer sin anuncios, un boletín semanal sobre IA, nuestro informe de vanguardia “AI Radar” exclusivo seis veces al año, acceso completo al archivo y acceso a nuestra sección de comentarios.
Fuente: Google