
Muse Spark Open, el modelo de pesos abiertos optimizado para programación de Meta, ya está disponible en Amazon SageMaker JumpStart, el centro de aprendizaje automático (ML) de Amazon SageMaker AI. El modelo fue entrenado con flujos de trabajo reales de desarrolladores, como refactorizaciones de varios archivos y largas sesiones de depuración, y admite una ventana de contexto de 1 millón de tokens. Puede desplegarlo en un endpoint de SageMaker AI en su propia cuenta de AWS en unos pocos pasos, sin tener que gestionar usted mismo la infraestructura de servicio. SageMaker JumpStart ofrece dos variantes: BF16 (Muse-Spark-Open-816B-A42B) y cuantizada NVFP4 (Muse-Spark-Open-816B-A42B-NVFP4).
En esta publicación, presentamos Muse Spark Open y le mostramos cómo desplegar el modelo con Amazon SageMaker Studio y el SageMaker Python SDK, enviarle una primera solicitud de inferencia y realizar la limpieza.
Descripción general de Muse Spark Open
Meta describe Muse Spark Open como un modelo optimizado para programación, entrenado para flujos de trabajo de código agéntico, con un enfoque en la precisión en el primer intento, la llamada a herramientas y la comprensión de bases de código grandes. Es un modelo de razonamiento, y acepta texto, imágenes, documentos, audio y audio-video como entrada y devuelve texto.
Muse Spark Open utiliza una arquitectura de mezcla de expertos (MoE) con 816 mil millones de parámetros totales, de los cuales 42 mil millones están activos para cada token. El modelo tiene la capacidad de una red muy grande, mientras que el cálculo que dedica a cada token se acerca al de un modelo denso mucho más pequeño. Meta publica los pesos bajo la Muse Model License, que incluye la Muse Spark Usage Policy.
La siguiente tabla resume el modelo.
| Atributo | Muse Spark Open |
| Proveedor | Meta |
| Arquitectura | Mezcla de expertos (MoE), modelo de razonamiento |
| Parámetros | 816B en total, 42B activos |
| Longitud de contexto | 1M de tokens |
| Modalidades de entrada | Texto, imagen, documento, audio, audio-video |
| Modalidades de salida | Texto |
| Variantes en SageMaker JumpStart | BF16 y NVFP4 |
| Licencia | Muse Model License, incluida la Muse Spark Usage Policy |
Diseñado para agentes de programación de larga ejecución
Meta entrenó Muse Spark Open en la forma en que los desarrolladores trabajan en repositorios reales: generación de código, depuración, refactorizaciones de varios archivos y tareas que se ejecutan durante mucho tiempo. Con la ventana de contexto de 1 millón de tokens, el modelo puede procesar un proyecto completo, incluidas sus dependencias, el código heredado y miles de archivos. No necesita dividir una tarea en partes más pequeñas para que quepa en el contexto.
Meta también diseñó Muse Spark Open como un modelo agéntico desde el principio. Meta afirma que el modelo planifica, actúa, observa el resultado y se autocorrige a lo largo de horizontes extensos, en lugar de hacer llamadas aisladas a herramientas. Como modelo de razonamiento, trabaja en una tarea antes de actuar, y el endpoint de SageMaker AI devuelve ese razonamiento junto con la respuesta, de modo que puede seguir lo que un agente está haciendo y por qué. Meta entrenó el modelo para navegar por la web, coordinar subagentes para trabajos que pueden dividirse y operar computadoras en entornos de escritorio, móvil y navegador. Estas son capacidades del modelo. En SageMaker AI, su aplicación o framework de agente proporciona las herramientas, el navegador y el entorno de uso de computadora que el modelo invoca. Más allá del código, Meta informa que Muse Spark Open razona sobre imágenes, documentos, audio y video.
Dos propiedades del modelo determinan cómo servirlo. Primero, la activación dispersa mantiene bajo el cómputo por token, pero la puesta en producción aún requiere suficiente memoria de GPU para contener los 816 mil millones de parámetros, por lo que la elección de la instancia se reduce a la capacidad de memoria. Segundo, la variante NVFP4 almacena los pesos en el formato de punto flotante de 4 bits de NVIDIA, que necesita aproximadamente una cuarta parte de la memoria de los pesos BF16. En SageMaker AI, esa diferencia decide la instancia: la variante NVFP4 se ejecuta en ml.p5e.48xlarge, y la variante BF16 se ejecuta en ml.p6-b300.48xlarge. Eso hace de NVFP4 la variante que conviene probar primero al dimensionar por costo. Evalúela en sus propias cargas de trabajo para confirmar que la calidad se ajusta a su caso de uso.
Con pesos abiertos en SageMaker AI, usted también controla la implementación. El endpoint se ejecuta en su cuenta de AWS, por lo que su código fuente y sus prompts se procesan en una infraestructura que usted configura y controla. Puede adjuntar el endpoint a su propia Amazon Virtual Private Cloud (Amazon VPC), cifrar su volumen de almacenamiento con una clave de AWS Key Management Service (AWS KMS)y activar el aislamiento de red para el contenedor. También elige el tipo de instancia y los límites de escalado, y fija la versión del modelo, de modo que el modelo solo cambia cuando usted vuelve a implementarlo.
Casos de uso
Puede usar Muse Spark Open para una amplia gama de aplicaciones. El enfoque de Meta en la programación y los flujos de trabajo agénticos lo hace adecuado para los siguientes casos de uso:
- Asistentes de programación sobre repositorios privados: Responda preguntas sobre bases de código extensas, refactórelas y depúrelas con el proyecto completo en contexto, mientras el código se procesa en un endpoint de su cuenta.
- Agentes de programación de larga ejecución: Ejecute agentes que planifiquen un cambio, editen varios archivos, ejecuten pruebas en su propio sandbox y corrijan el rumbo según los resultados.
- Flujos de trabajo de ingeniería multimodales: Convierta capturas de pantalla, documentos de diseño o un informe de error grabado con audio y video en un plan de reproducción o un borrador de corrección.
Primeros pasos con SageMaker JumpStart
Puede desplegar Muse Spark Open desde SageMaker Studio o con el SageMaker Python SDK. Cada ruta crea un endpoint de SageMaker AI en tiempo real en su cuenta.
Requisitos previos
Antes de empezar, asegúrese de tener lo siguiente:
- Una cuenta de AWS con permisos para crear modelos y endpoints de SageMaker AI.
- Un rol de ejecución de AWS Identity and Access Management (IAM) para SageMaker AI. En este tutorial, la
AmazonSageMakerFullAccesspolítica administrada es suficiente. En producción, delimite el rol a las acciones y recursos que necesita su despliegue. Para más detalles, consulte How to use SageMaker AI execution roles. - Un dominio de SageMaker AI con acceso a SageMaker Studio, para la ruta de Studio. Para ver las instrucciones de configuración, consulte Use quick setup for Amazon SageMaker AI.
- Cuota de servicio para el tipo de instancia del endpoint: ml.p5e.48xlarge for endpoint usage para la variante NVFP4, o ml.p6-b300.48xlarge for endpoint usage para la variante BF16. Para solicitar un aumento de cuota, consulte Requesting a quota increase.
- Para la ruta del SDK: Python 3.10 o posterior y SageMaker Python SDK v3 (
pip install --upgrade sagemaker). - Una región de AWS donde Muse Spark Open esté disponible en SageMaker JumpStart. En el lanzamiento, Muse Spark Open está disponible en US East (N. Virginia) y US East (Ohio). Para comprobar la disponibilidad en otras regiones, abra SageMaker JumpStart en su región.
Las instancias que alojan Muse Spark Open son instancias multi-GPU, y usted paga por un endpoint mientras esté en ejecución, ya atienda solicitudes o no. Elimine el endpoint cuando termine, como se describe en la sección de limpieza de esta publicación. Para ver las tarifas, consulte Amazon SageMaker AI pricing.
Despliegue con SageMaker Studio
La ruta de SageMaker Studio es adecuada para una primera evaluación: encuentra el modelo, revisa su licencia y lo despliega desde una sola tarjeta de detalles del modelo.
Para encontrar Muse Spark Open en SageMaker JumpStart
- Abra SageMaker Studio.
- En el panel de navegación, elija JumpStart.
- En el cuadro de búsqueda, escriba Muse Spark Open.
- Elegir Muse-Spark-Open-816B-A42B para la variante BF16 o Muse-Spark-Open-816B-A42B-NVFP4 para la variante NVFP4 y abrir su tarjeta de detalles del modelo.
La Figura 1 muestra la tarjeta de detalles del modelo, que incluye la descripción del modelo, la licencia y la Desplegar opción.
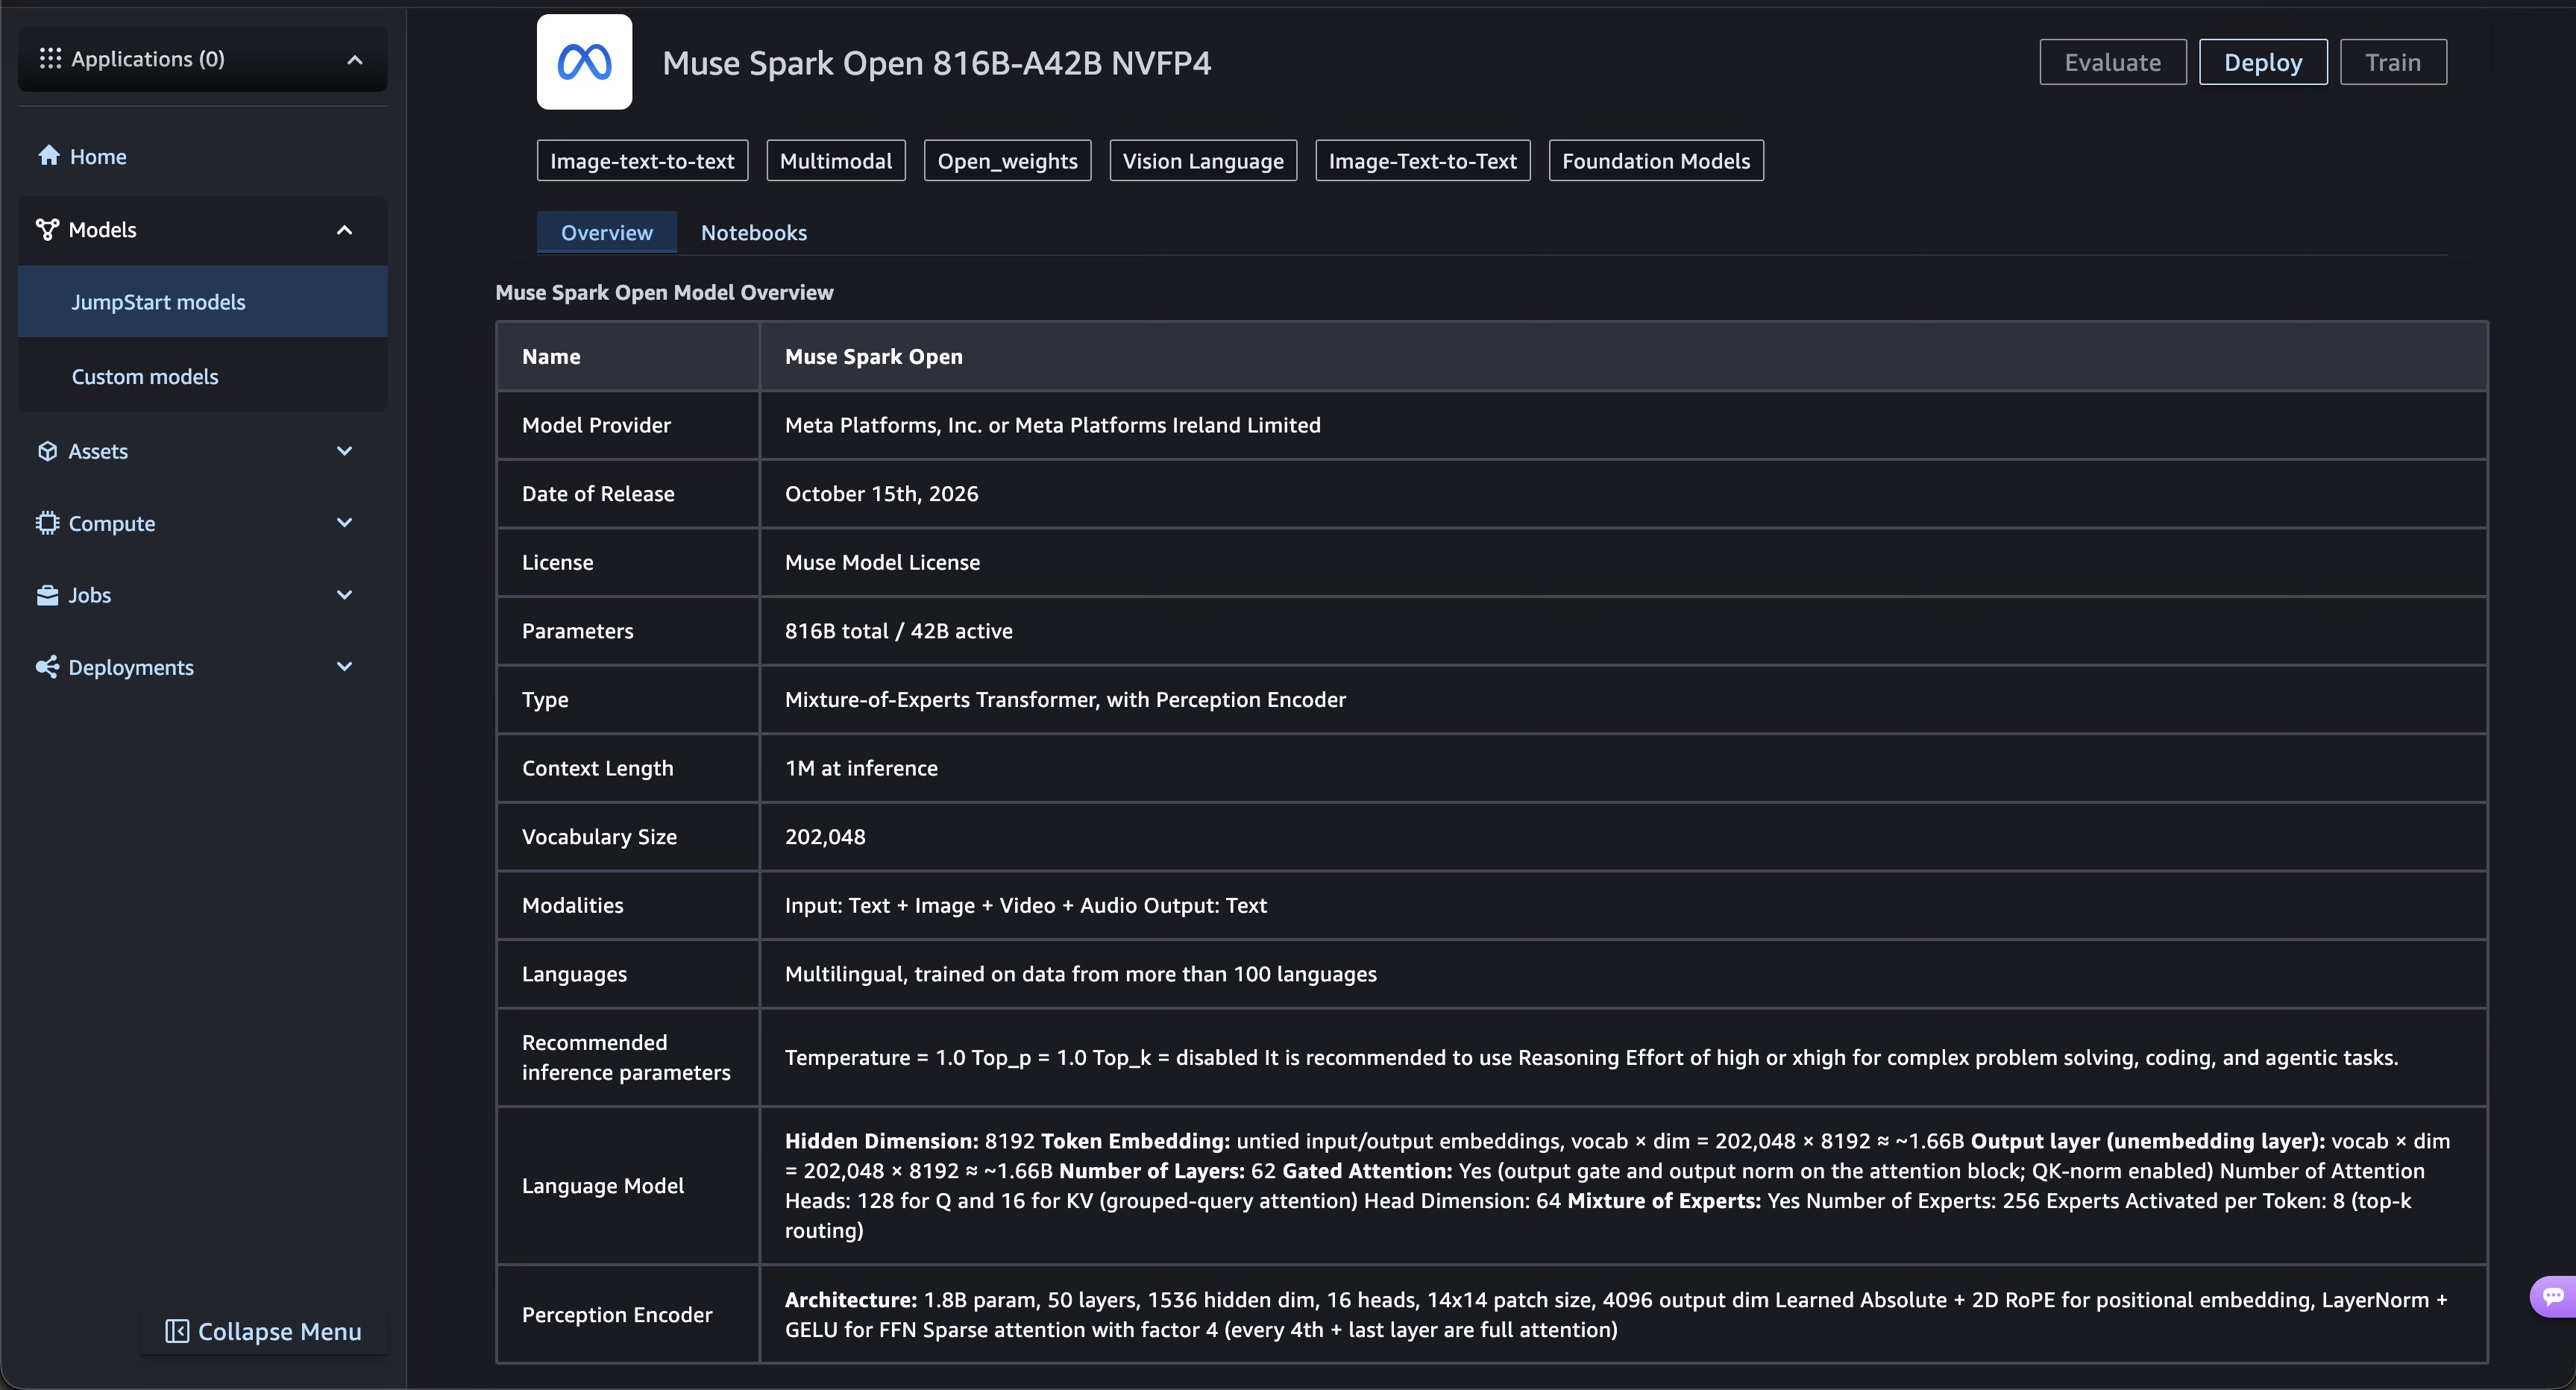
Figura 1: La tarjeta de detalles del modelo Muse Spark Open en SageMaker JumpStart
Para desplegar el modelo
- En la tarjeta de detalles del modelo, elija Desplegar.
- Muse Spark Open es un modelo restringido (gated), por lo que SageMaker Studio muestra su contrato de licencia de usuario final (EULA). Revise el acuerdo y acéptelo para continuar.
- Para Nombre del endpoint, mantén el nombre generado o introduce el tuyo propio.
- Para Tipo de instancia, seleccione ml.p5e.48xlarge para NVFP4 o ml.p6-b300.48xlarge para BF16. SageMaker Studio solo muestra los tipos de instancia que el modelo admite.
- Para Número inicial de instancias, ingrese 1.
- (Opcional) En Opciones avanzadas, seleccione una VPC y una clave de AWS KMS, o active el aislamiento de red.
- Elegir Desplegar.
La Figura 2 muestra los ajustes de despliegue para la variante NVFP4.
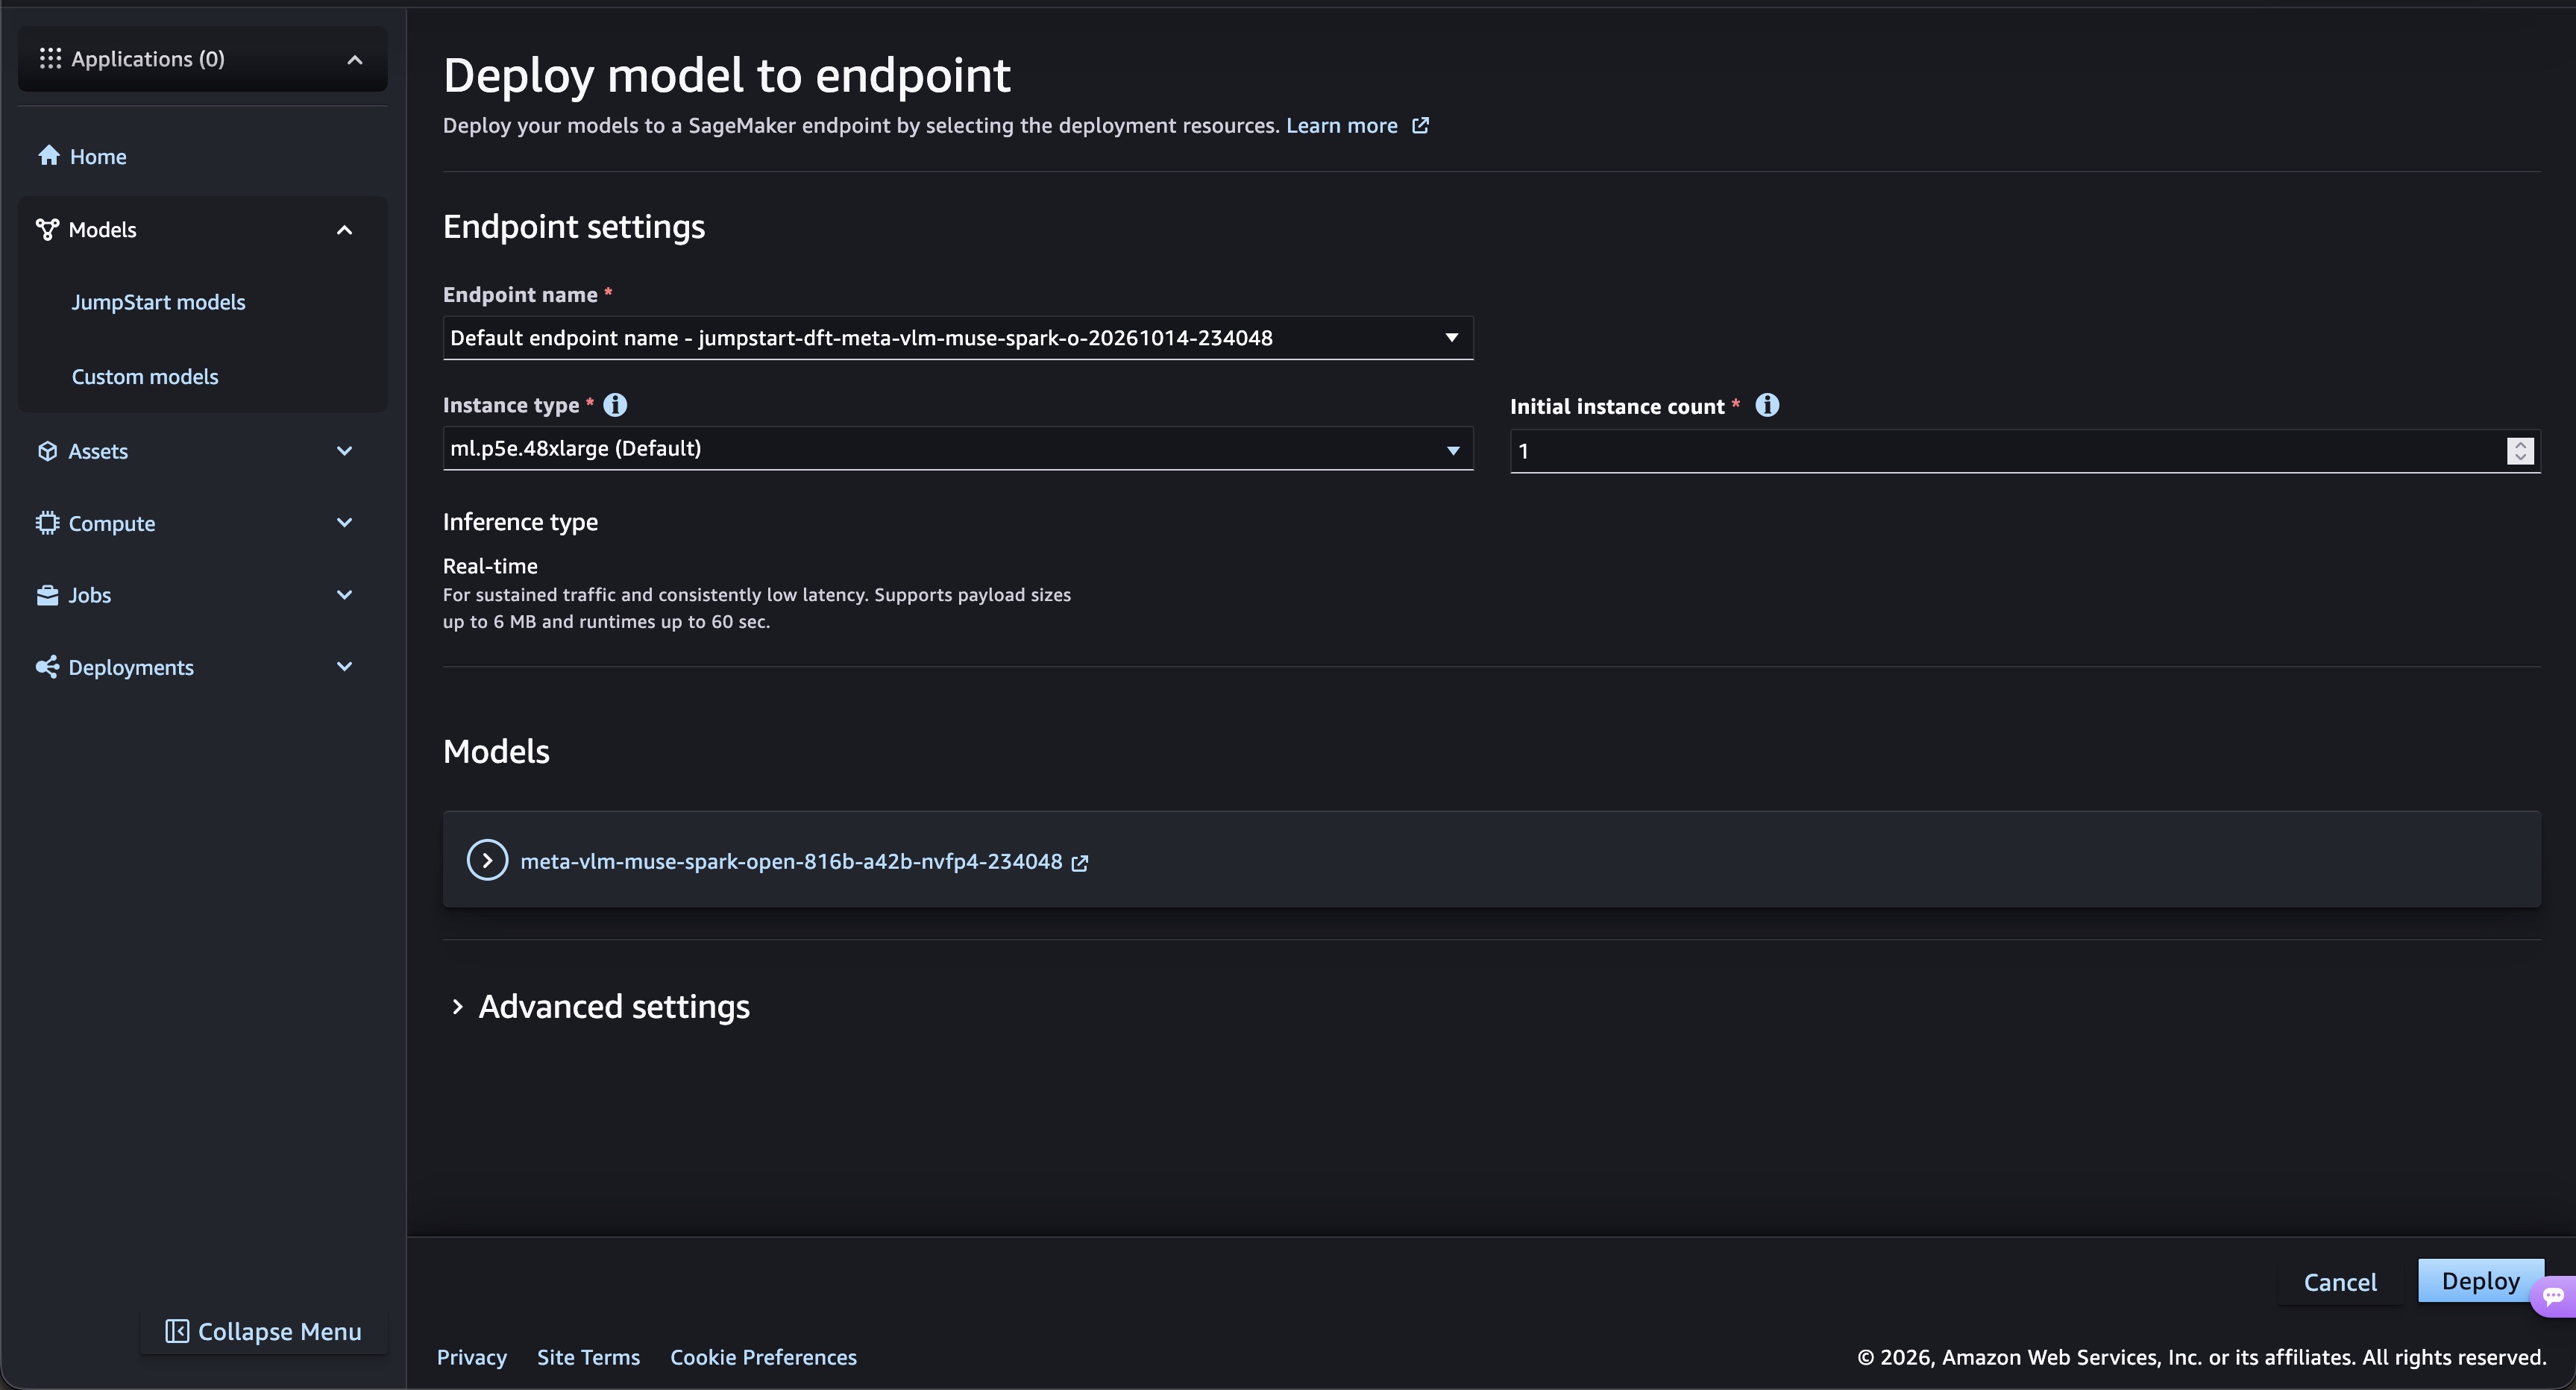
Figura 2: Ajustes de despliegue para Muse Spark Open
El despliegue normalmente tarda 15–20 minutos mientras SageMaker AI aprovisiona la instancia y carga los pesos. Cuando el estado del endpoint cambia a InService, el endpoint está listo para recibir solicitudes, como se muestra en la Figura 3.
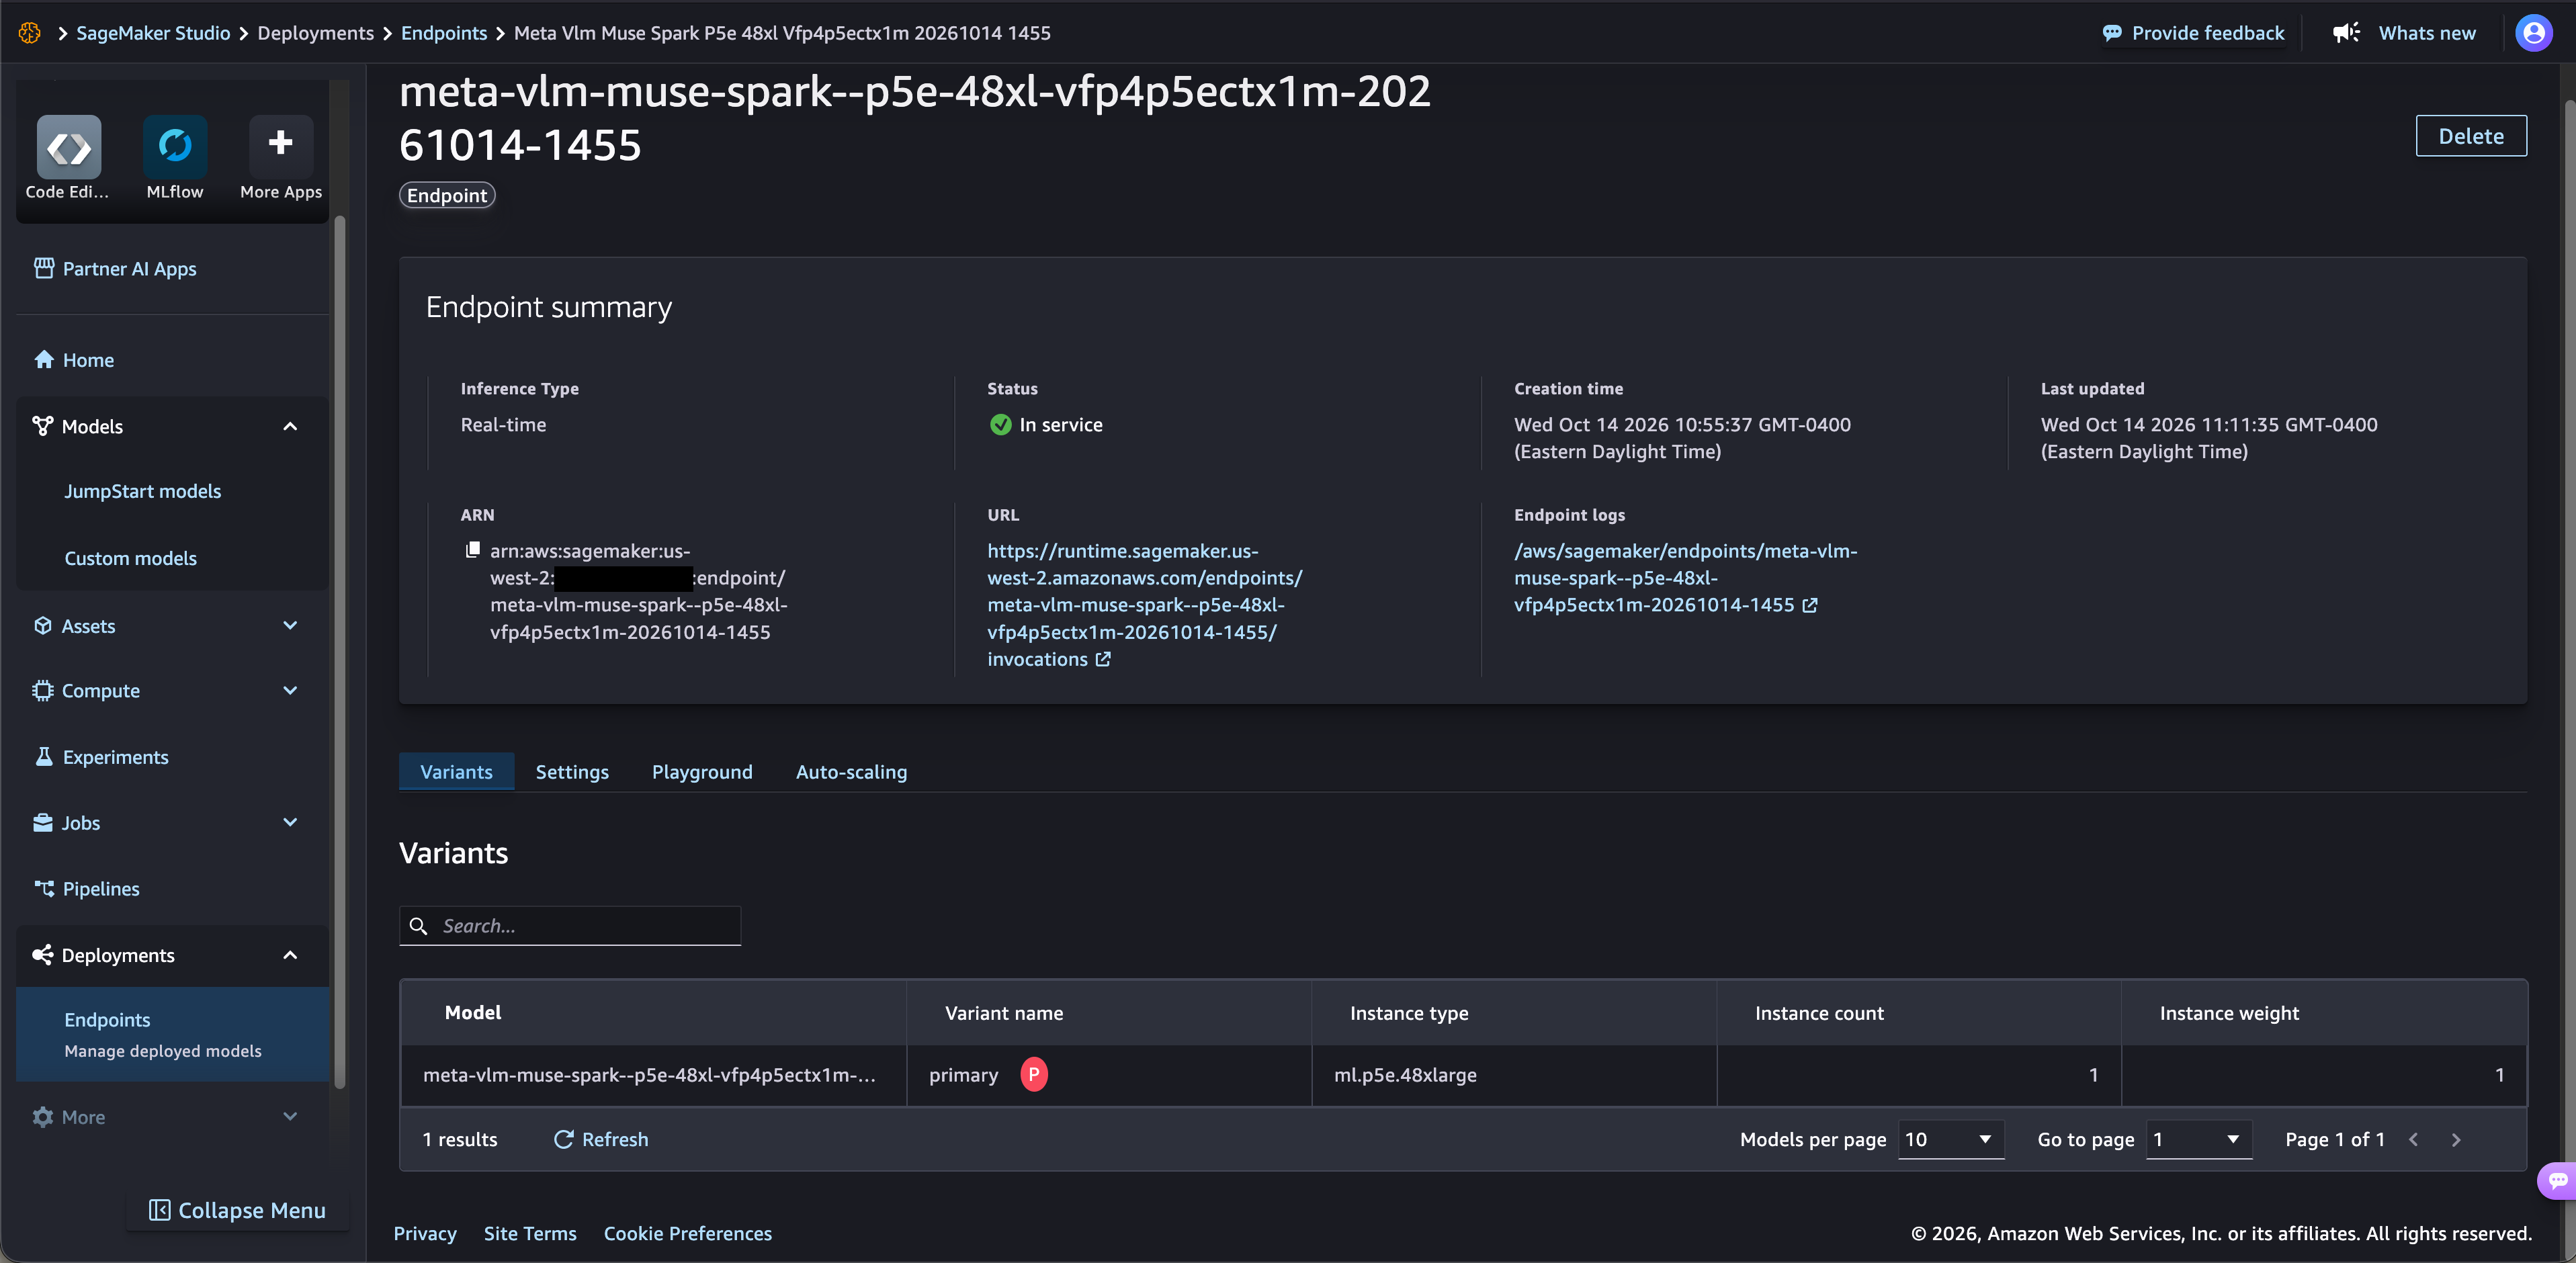
Figura 3: El endpoint de Muse Spark Open en servicio
Desplegar usando el SageMaker Python SDK
SageMaker JumpStart identifica cada variante mediante un ID de modelo:
- BF16:
meta-vlm-muse-spark-open-816b-a42b. - NVFP4:
meta-vlm-muse-spark-open-816b-a42b-nvfp4.
El siguiente código despliega la variante NVFP4 con SageMaker Python SDK v3. Puede ejecutarlo en un cuaderno de SageMaker Studio, que usa el rol de ejecución de su dominio. En cualquier otro entorno de Python con credenciales de AWS, pase su rol de ejecución de SageMaker AI con el role_arn parámetro. Muse Spark Open es un modelo restringido (gated), por lo que debe establecer accept_eula=True para desplegarlo. Para fijar una versión específica del modelo, añada model_version a JumpStartConfig.
from sagemaker.core.jumpstart.configs import JumpStartConfig
from sagemaker.serve import ModelBuilder
from sagemaker.train.configs import Compute

# NVFP4 variant; for BF16, use "meta-vlm-muse-spark-open-816b-a42b" with ml.p6-b300.48xlarge
model_id = "meta-vlm-muse-spark-open-816b-a42b-nvfp4"

jumpstart_config = JumpStartConfig(
    model_id=model_id,
    accept_eula=True,  # Confirms that you accept Meta's license terms
)

model_builder = ModelBuilder.from_jumpstart_config(
    jumpstart_config=jumpstart_config,
    compute=Compute(instance_type="ml.p5e.48xlarge"),
    # role_arn="<your-sagemaker-execution-role-arn>",  # Required outside SageMaker Studio
)

model = model_builder.build(model_name="muse-spark-open-nvfp4")
endpoint = model_builder.deploy(endpoint_name="muse-spark-open-nvfp4")
Ejecutar inferencia
Cuando el endpoint esté en servicio, envíele una solicitud con el método invoke . El endpoint acepta un payload de chat compatible con OpenAI con una lista messages y devuelve una finalización de chat (chat completion). La respuesta final está en message.content, el razonamiento del modelo está en message.reasoning_contenty usage.reasoning_tokens informa cuántos tokens utilizó el razonamiento. Dado que Muse Spark Open es un modelo de razonamiento, deje suficiente espacio en max_tokens para su razonamiento y la respuesta final.
import json

payload = {
    "messages": [
        {
            "role": "user",
            "content": "Write a Python function that validates ISO 8601 dates, and add pytest unit tests for it.",
        }
    ],
    "max_tokens": 4096,
}

response = endpoint.invoke(
    body=json.dumps(payload),
    content_type="application/json",
)

result = json.loads(response.body.read().decode("utf-8"))
message = result["choices"][0]["message"]
print("Reasoning:", message.get("reasoning_content"))
print("Answer:", message["content"])
El endpoint también admite streaming. Para recibir los tokens a medida que se generan, añada "stream": true al cuerpo de la solicitud y llame a endpoint.invoke_with_response_stream en lugar de invoke.
Limpieza
Para dejar de incurrir en cargos, elimine el endpoint cuando ya no lo necesite. Si desplegó con el SDK, elimine el modelo, el endpoint y la configuración del endpoint:
from sagemaker.core.resources import EndpointConfig

endpoint_config = EndpointConfig.get(endpoint_config_name=endpoint.endpoint_name)
model.delete()
endpoint.delete()
endpoint_config.delete()
Si desplegó desde SageMaker Studio, elimine el endpoint en la consola de SageMaker AI: elija Inference, luego Endpoints, seleccione el endpoint y elija Actions, Delete.
Conclusión
En esta publicación, mostramos cómo implementar Muse Spark Open, el modelo de pesos abiertos optimizado para programación de Meta, desde SageMaker JumpStart hasta un endpoint en su propia cuenta de AWS. Utilizó SageMaker Studio o el SageMaker Python SDK y envió al modelo una primera solicitud de inferencia. Evalúe ambas variantes en sus propios repositorios antes de elegir una instancia para producción.
Para comenzar, busque Muse Spark Open en SageMaker JumpStart dentro de SageMaker Studio. Para obtener más opciones de implementación, como componentes de inferencia y configuraciones de implementación optimizadas, consulte JumpStart foundation model usage en la Amazon SageMaker AI Developer Guide. Antes de implementar, revise la Muse Model License, que SageMaker JumpStart muestra cuando implementa el modelo. Para obtener ayuda para planificar una implementación de producción, contacte con AWS.