
Aspectos destacados
- Arquitectura: 816B de parámetros totales, 42B activos por token con una ventana de contexto de 1M.
- Cuantización: Meta lanzó el modelo tanto en BF16 como en NVFP4. Los pesos MXFP4 fueron publicados por AMD.
- Multimodal: percepción nativa de imágenes y video a través del mismo Perception Encoder que Muse Glimmer, con soporte adicional de audio.
- Paralelismo: Paralelismo de tensores y Paralelismo de pipeline tanto en Nvidia como en AMD. EP, TEP, DEP y disagregación PD en Nvidia. También está disponible el soporte inicial en TPU.
- Decodificación especulativa: Hemos entrenado un modelo borrador DSpark, compatible tanto con CUDA como con ROCm, que acelera el rendimiento del modelo, probado en el banco SPEED.
Uso
Hay imágenes preconstruidas disponibles para ambos proveedores:
- Nvidia: vllm/vllm-openai:muse-spark-open
- AMD: vllm/vllm-openai-rocm:muse-spark-open
Tenga en cuenta que el modelo solo estará disponible en el wheel nocturno de PyPI después de que el código (PR #61879) sea revisado y fusionado, lo que suele tardar alrededor de una semana.
# Rust frontend is recommended
export VLLM_USE_RUST_FRONTEND=1

vllm serve meta-models/Muse-Spark-Open-816B-A42B-NVFP4 \
    --tensor-parallel-size 8 \
    --enable-expert-parallel \
    --max-model-len 1048576 \
    --reasoning-parser muse \
    --tool-call-parser muse \
    --enable-auto-tool-choice \
    --speculative-config '{"method":"dspark","model": "Inferact/Muse-Spark-Open-DSpark","num_speculative_tokens":7,"draft_sample_method":"probabilistic","rejection_sample_method":"block","enable_adaptive_verification":true}'
Para usar este modelo con texto plano:
  curl http://localhost:8000/v1/chat/completions \
    -H 'Content-Type: application/json' \
    -d '{
      "model": "meta-models/Muse-Spark-Open-816B-A42B-NVFP4",
      "messages": [{"role": "user", "content": "Refactor this module."}],
      "reasoning_effort": "xhigh"
    }'
Para percepción multimodal:
 curl http://localhost:8000/v1/chat/completions \
   -H 'Content-Type: application/json' \
   -d '{
     "model": "meta-models/Muse-Spark-Open-816B-A42B",
     "messages": [{"role": "user", "content": [
       {"type": "image_url", "image_url": {"url": "https://example.com/screenshot.png"}},
       {"type": "video_url", "video_url": {"url": "https://example.com/demo.mp4"}},
       {"type": "audio_url", "audio_url": {"url": "https://example.com/clip.wav"}},
       {"type": "text",      "text": "What is happening here, and when?"}
     ]}]
   }'
Detalles de implementación
Arquitectura del modelo
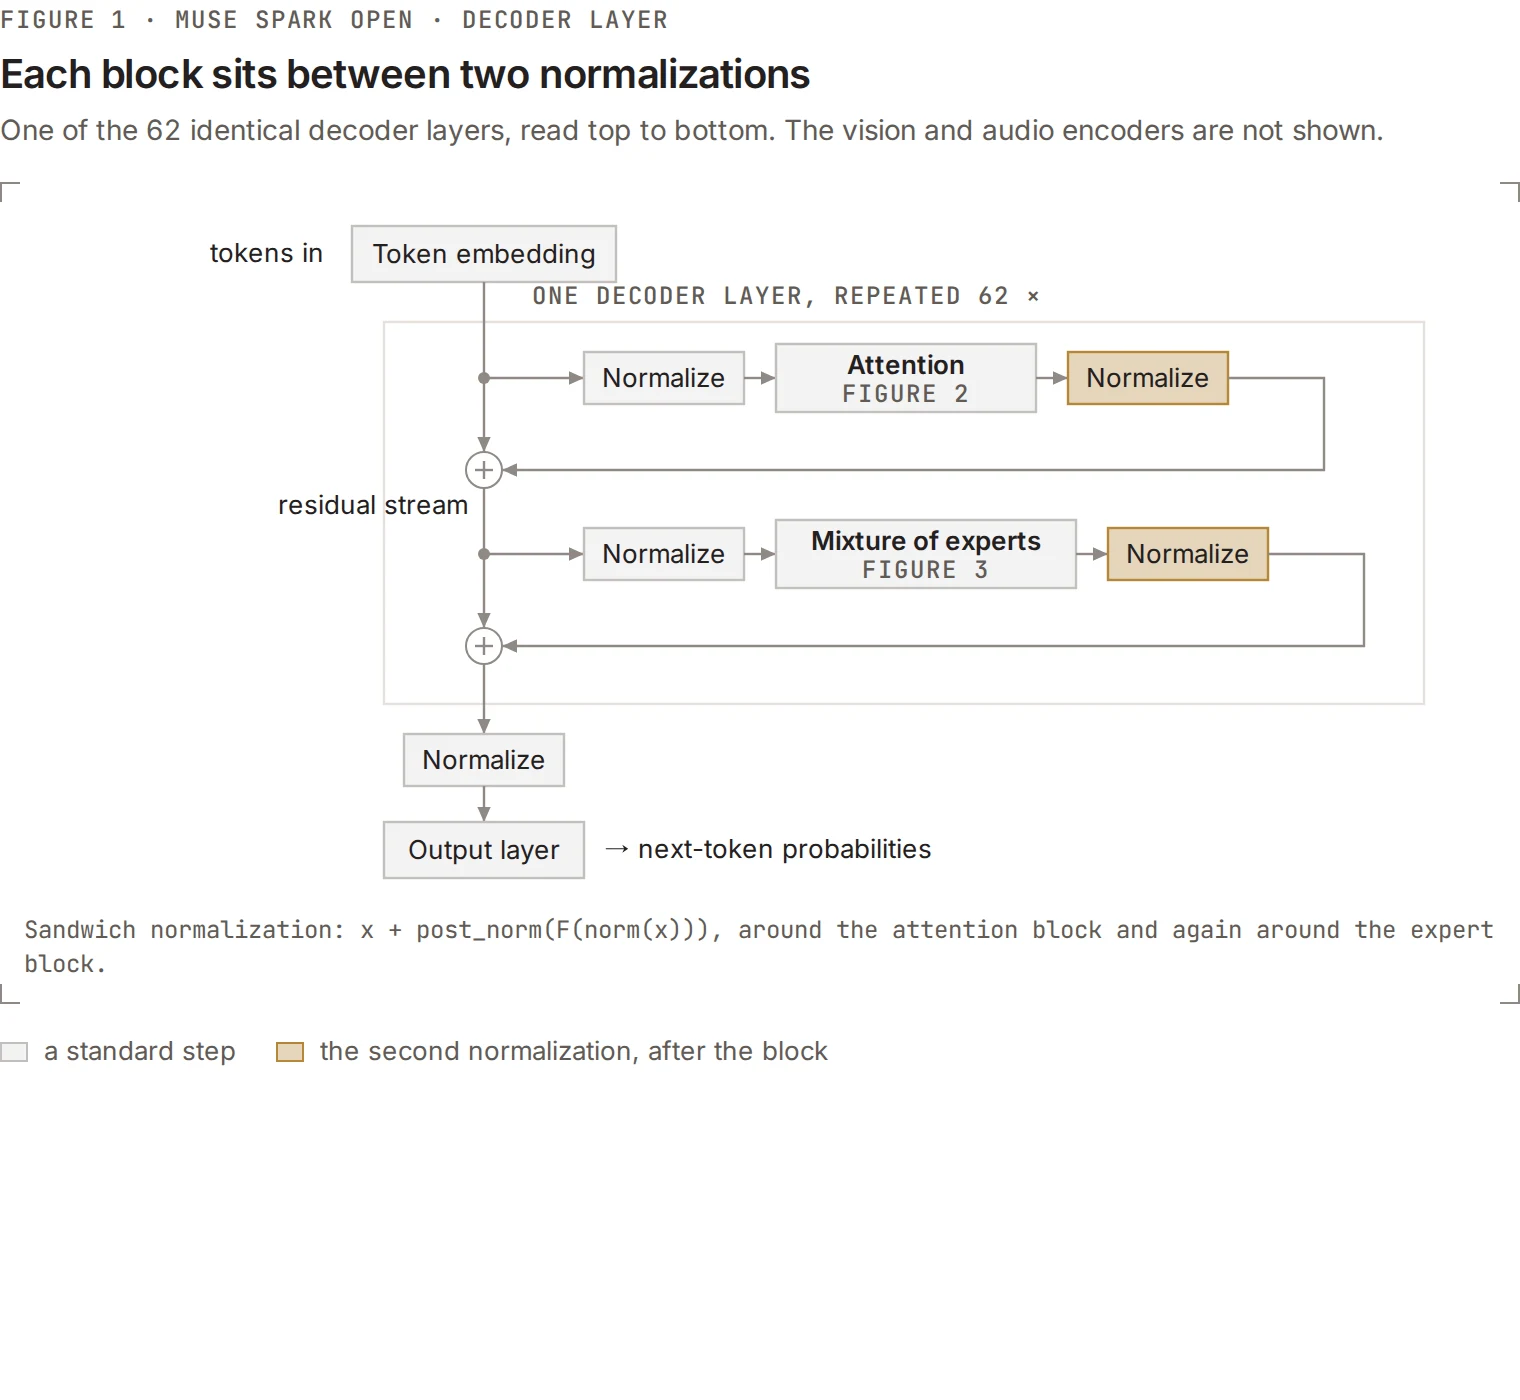
Muse Spark Open es un modelo de mezcla de expertos con 816B de parámetros totales, incluido el decodificador de texto, más un codificador de visión de 2B y un pequeño codificador de audio a su lado. El decodificador tiene 62 capas, y cada una de ellas es una capa de mezcla de expertos. Aquí es donde se ubican los pesos:
| parte | tamaño |
|---|---|
| 256 expertos por capa | 799 B |
| atención | 13.5 B |
| proyecciones latentes MoE | 4.2 B |
| capa de embedding y capa de salida | 3.3 B |
| torre de visión (separada) | 1.9 B |
La arquitectura del modelo es similar a Muse Glimmer. Para quienes no han usado Muse Glimmer, hay algunas cosas en esta arquitectura de modelo que vale la pena examinar más de cerca.
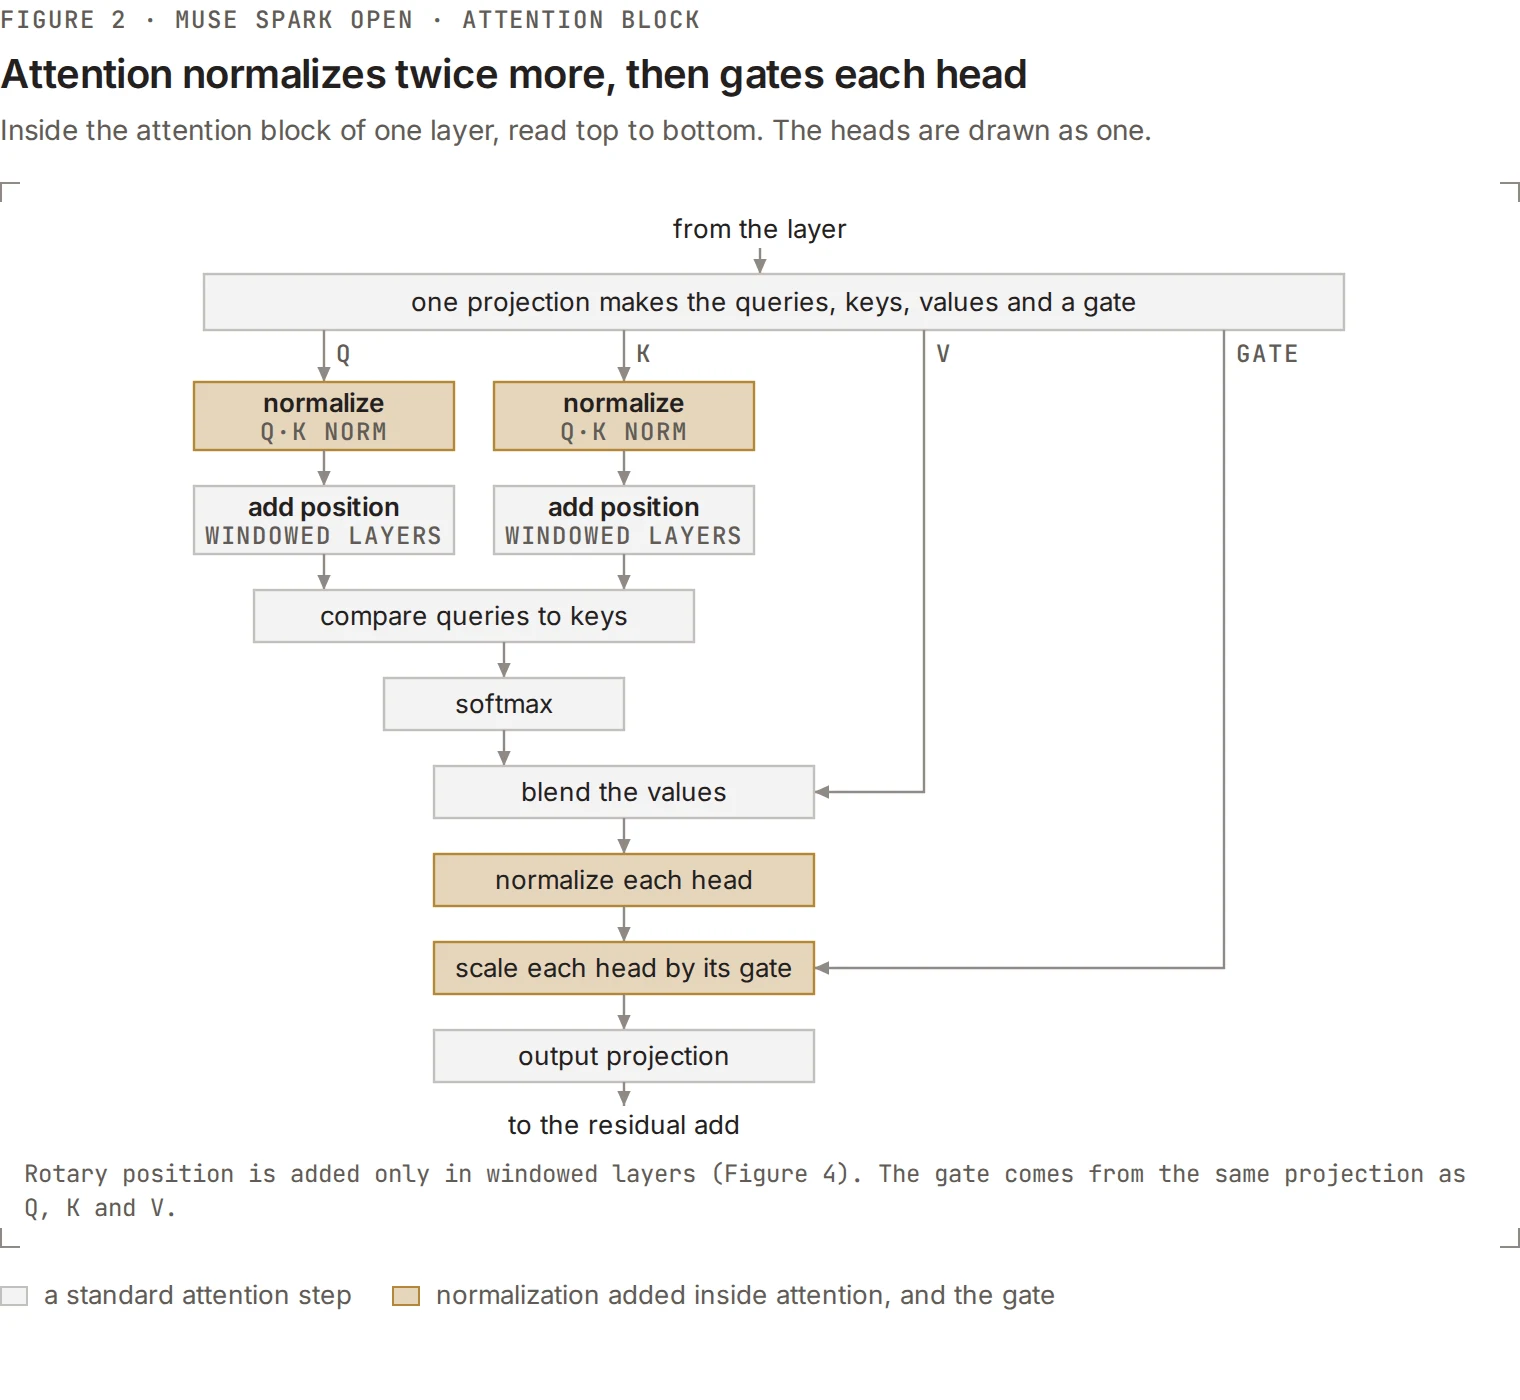
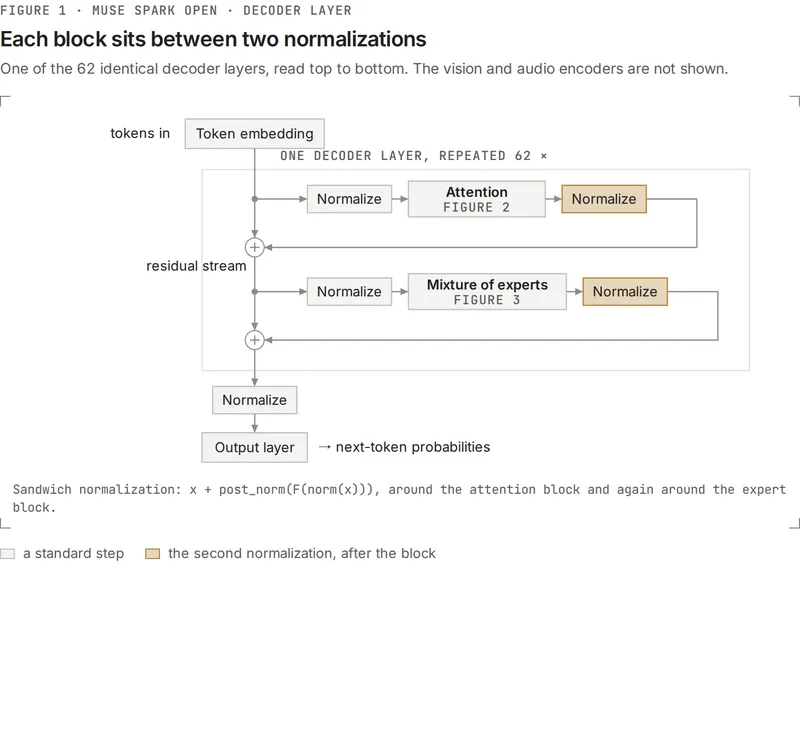
Normalización en sándwich. La mayoría de los decodificadores colocan una capa de normalización antes de cada bloque, dando x + F(norm(x)). Muse Spark Open, de manera similar a Muse Glimmer, coloca una antes y otra después, como las dos rebanadas de un sándwich con el bloque en medio, dando x + post_norm(F(norm(x)))
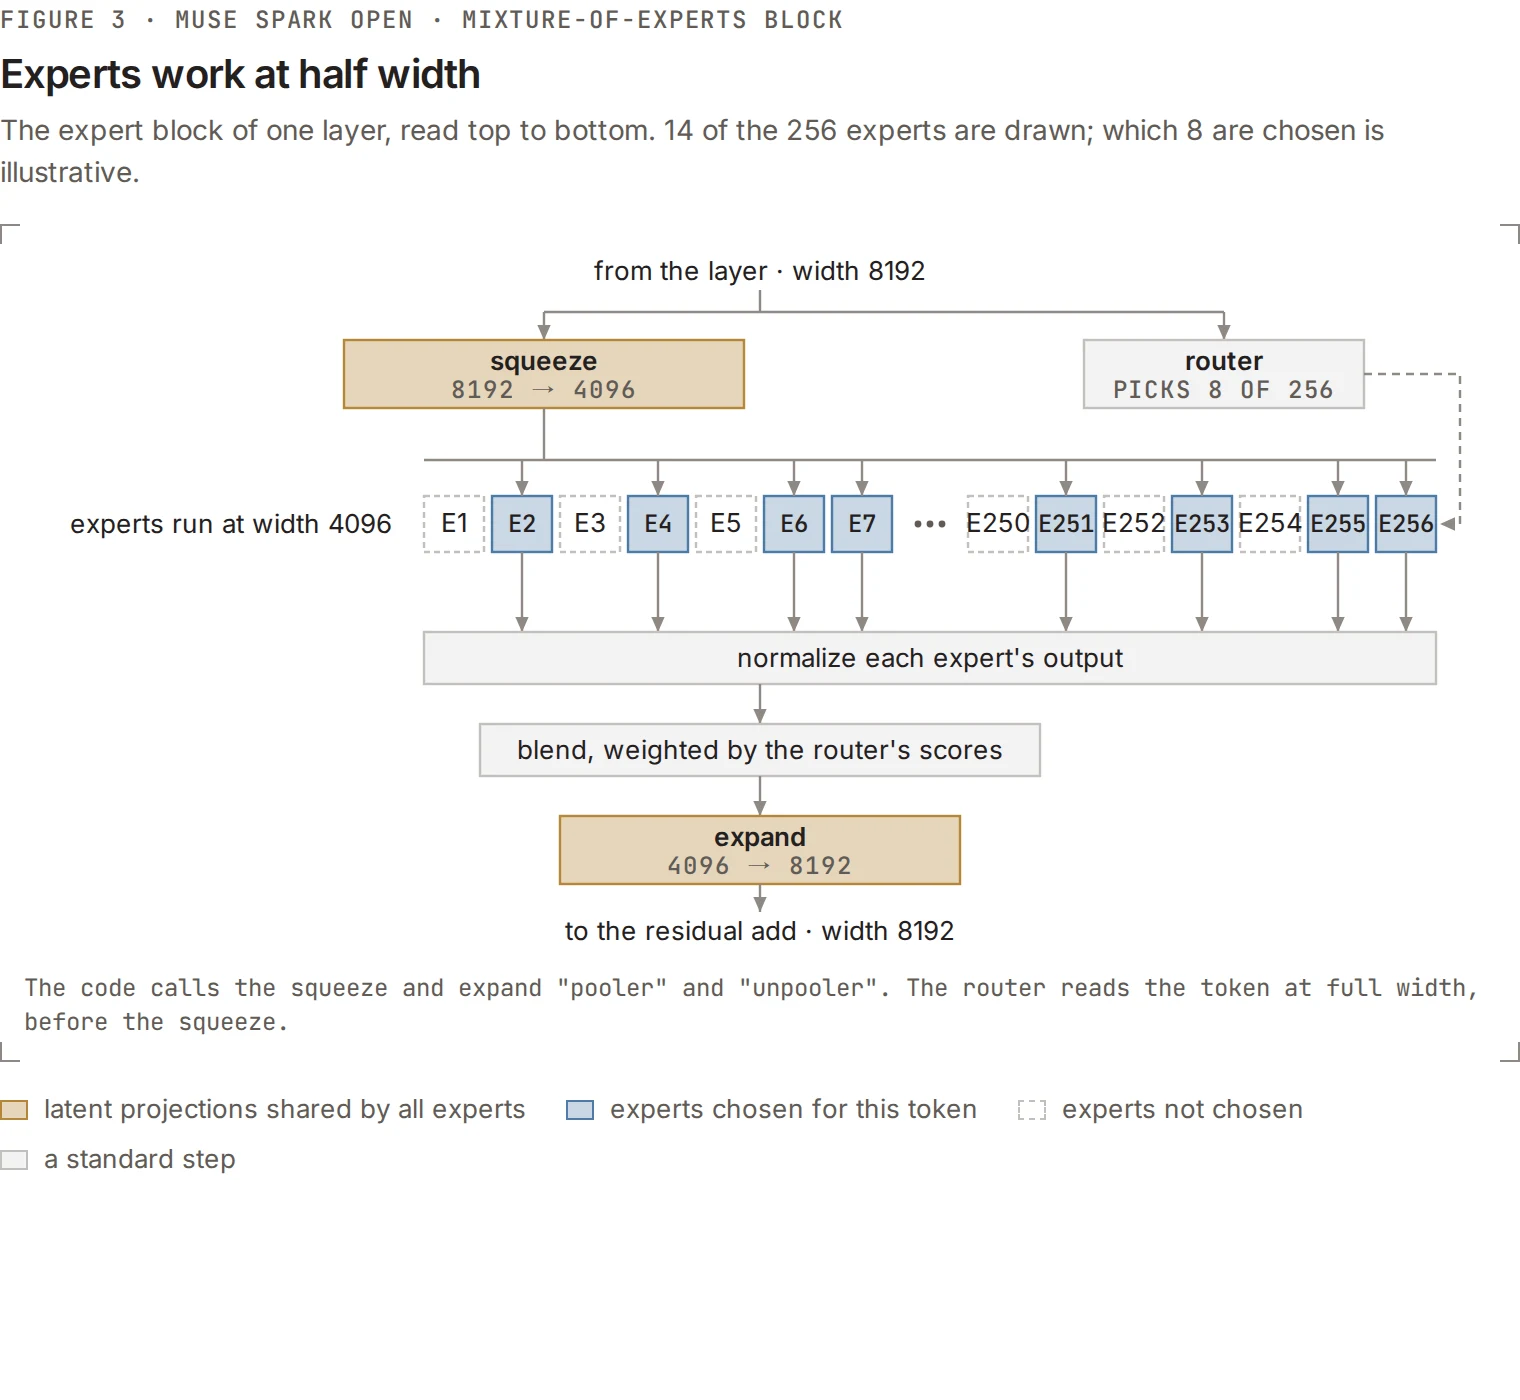
MoE latente. Cada capa de mezcla de expertos (MoE) lleva dos matrices adicionales, compartidas por los 256 expertos de esa capa. El código las llama pooler y unpooler, aunque ninguna hace pooling en el sentido habitual; en cambio, ambas son proyecciones aprendidas para comprimir y expandir las dimensiones. El pooler es una matriz de 8192 × 4096 que reduce a la mitad el ancho de cada token antes de que llegue a los expertos; mientras que el unpooler restaura el ancho completo después. Por lo tanto, los expertos trabajan completamente a 4096 en lugar de 8192, lo que redujo a la mitad la cantidad de parámetros requeridos en las dos capas de proyección de expertos.
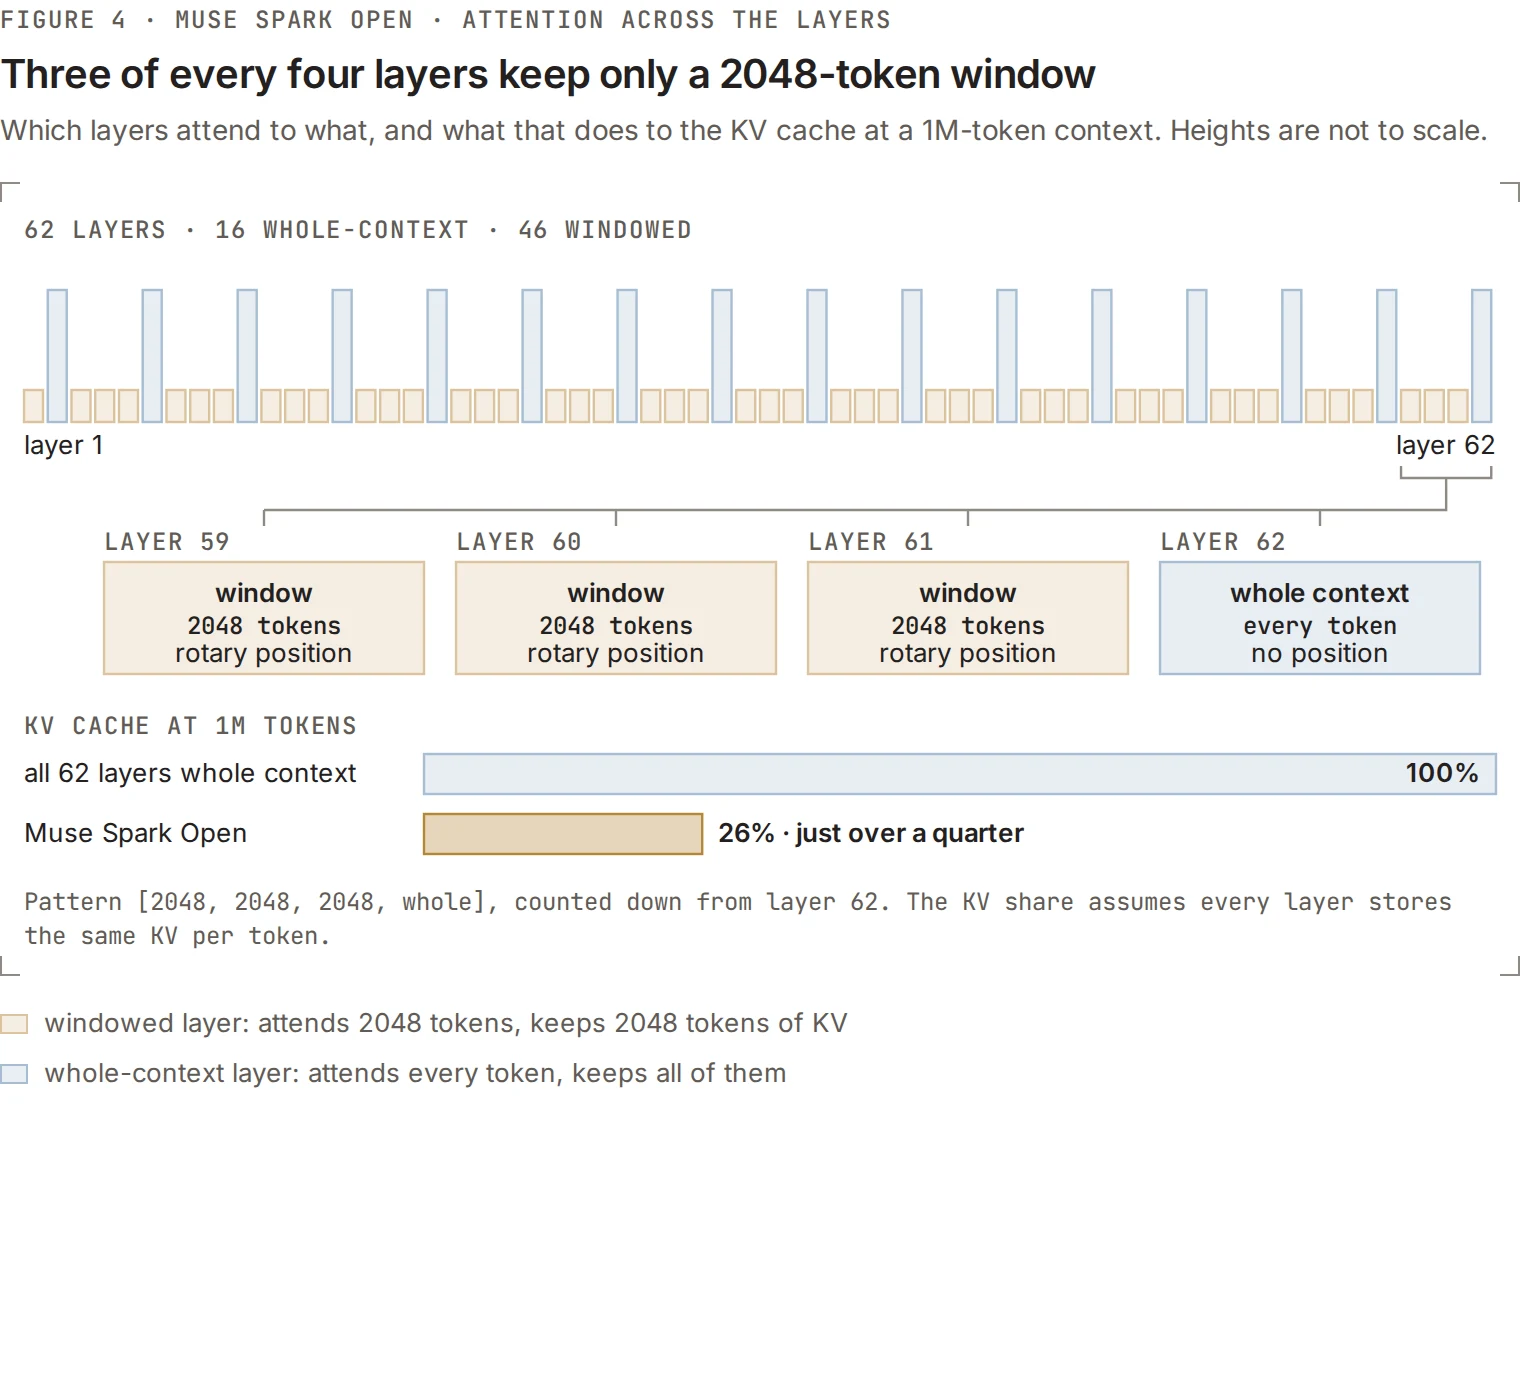
Atención híbrida. Las capas alternan entre atención completa y Atención de Ventana Deslizante (SWA) en un ciclo repetitivo de 4 con tres atendiendo a una ventana de 2048 tokens y la cuarta mirando todo el contexto. El ciclo está anclado al final de la pila, por lo que la capa final siempre es una capa de atención completa. A lo largo de 62 capas, esto da 46 capas estrechas y 16 anchas, donde las capas estrechas solo contienen KV reciente. Con 1M de tokens, esto reduce la caché a apenas más de ¼ de lo que necesitaría la atención totalmente completa. Esto es lo que hace asequible la longitud de contexto de 1M.
Codificador de visión. Muse Spark Open usa el mismo Perception Encoder que Muse Glimmer, una torre de 2B de parámetros que lee imágenes en su resolución nativa, en lugar de redimensionarlas a un cuadrado. Los videos pasan por el mismo codificador: los fotogramas se muestrean en el momento de la carga como una serie de fotogramas de video muestreados con marca de tiempo tokenizada en el prompt.
Codificador de audio. El audio se lee como forma de onda cruda a 24 kHz y cada 1920 muestras, es decir 80ms, se convierten en un token a través de una serie de transformaciones. Todo el codificador de audio tiene solo 118M de parámetros. Tenga en cuenta que la pista de audio del video no se procesa. Para darle al modelo tanto las imágenes como el sonido de un clip, envíe el video y el audio extraído como dos partes de contenido separadas en la misma solicitud.
DSpark
Para acelerar la inferencia de Muse Spark Open en vLLM, entrenamos un especulador usando DSpark, un algoritmo de decodificación especulativa que usa difusión por bloques para proponer hasta siete tokens de borrador en una sola pasada. La programación basada en confianza ayuda a mantener aceleraciones significativas incluso con tamaños de lote grandes, donde la decodificación especulativa tradicionalmente ofrece rendimientos decrecientes, como se muestra en los resultados a continuación.
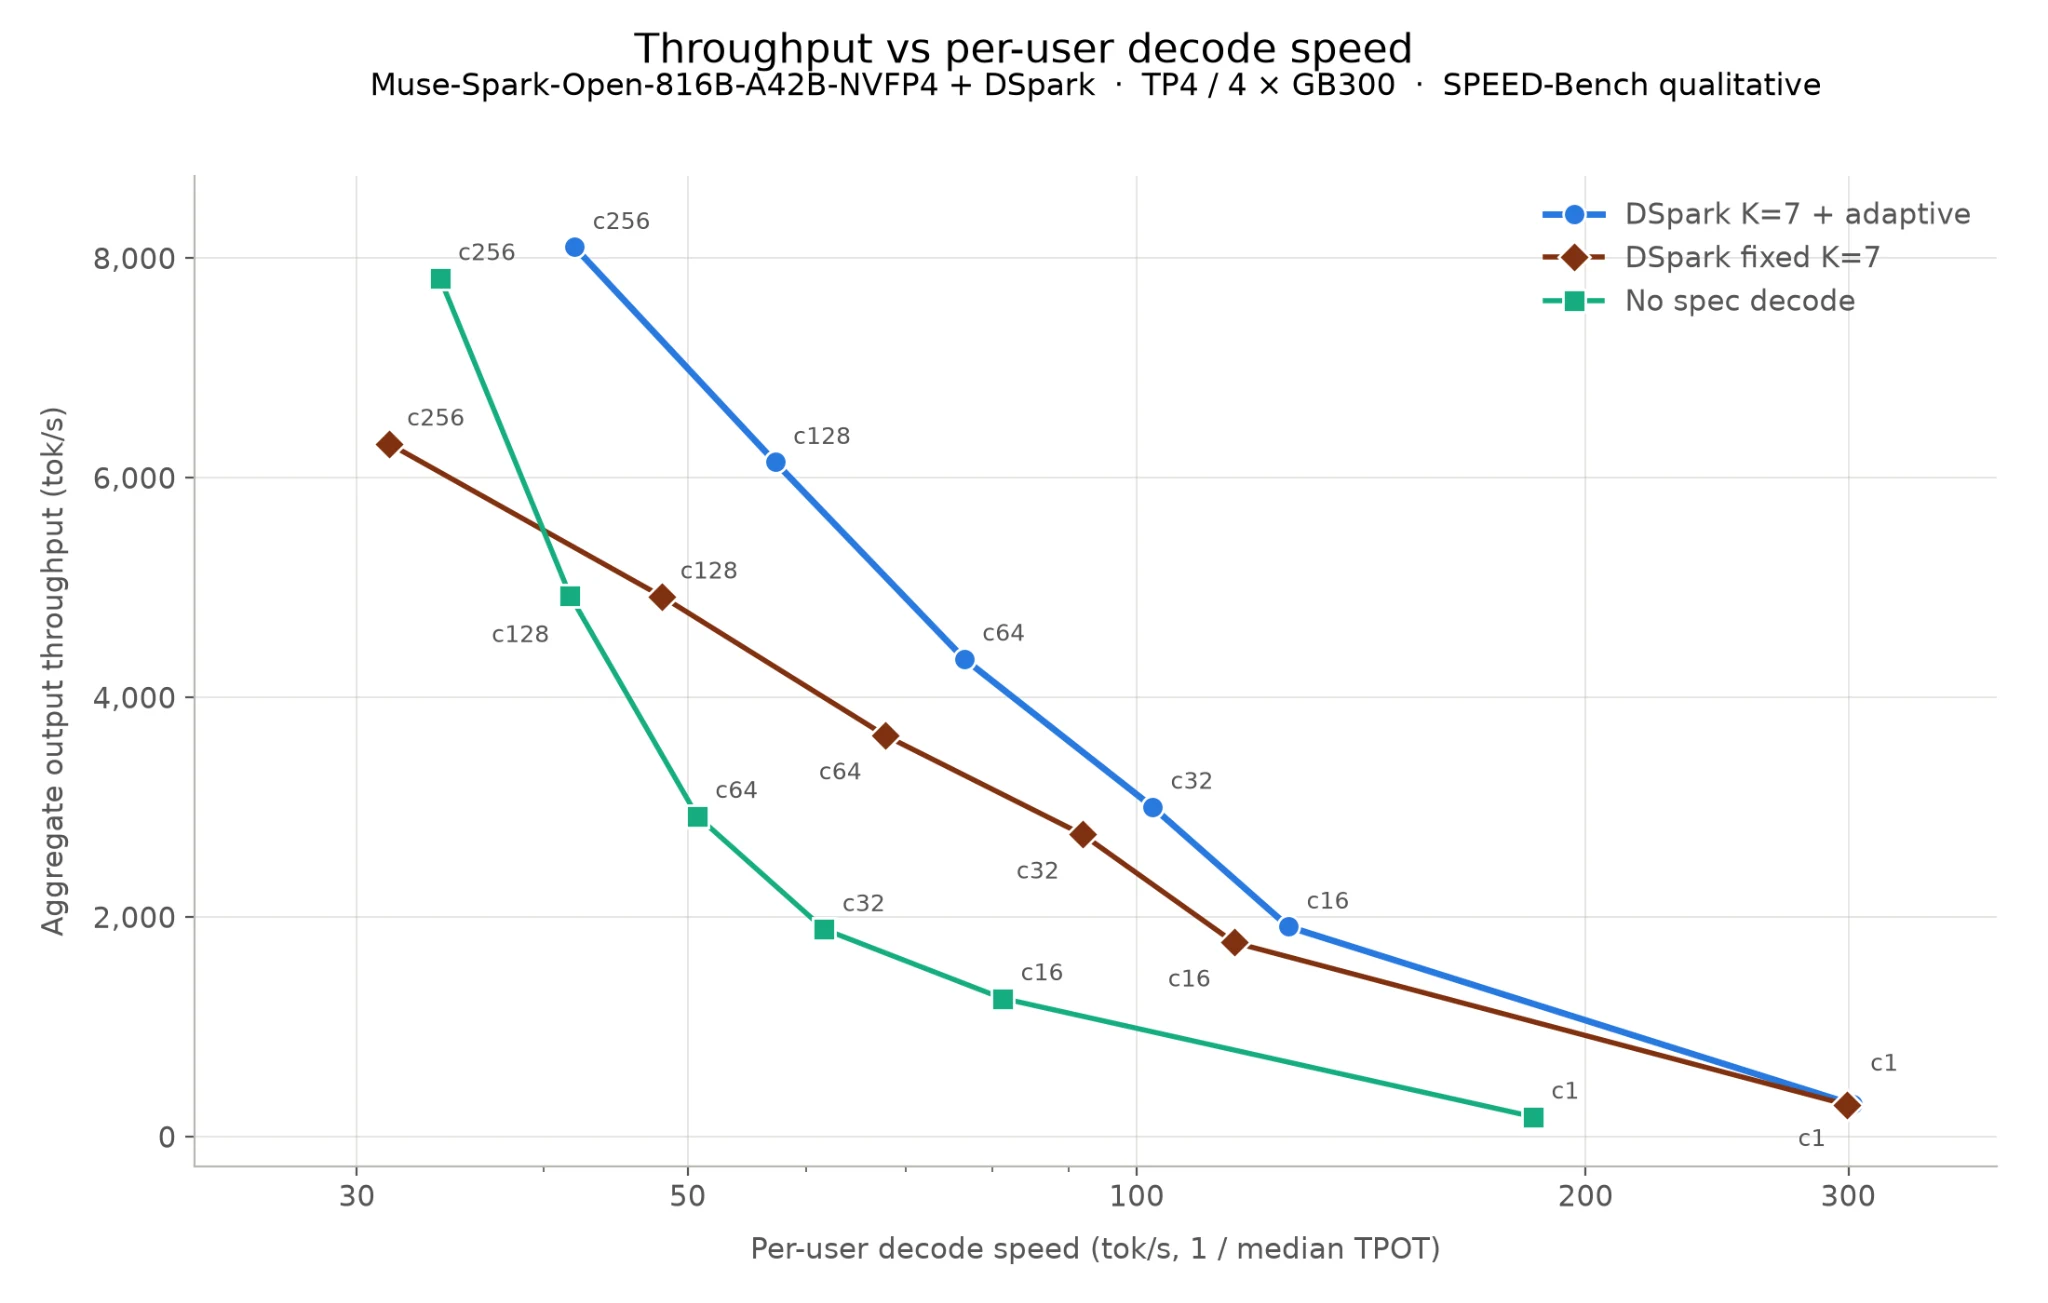
Nuestro especulador también usa la atención de ventana deslizante de Muse Spark Open para mantener la generación de borradores ligera, incluso con un contexto de 1M de tokens. Juntas, estas decisiones lo hacen muy adecuado para cargas de trabajo de producción que abarcan una amplia gama de tamaños de lote y longitudes de contexto.
Para habilitarlo, agregue esto cuando el servidor arranque:
--speculative-config '{"method":"dspark","model": "Inferact/Muse-Spark-Open-DSpark","num_speculative_tokens":7,"draft_sample_method":"probabilistic","rejection_sample_method":"block","enable_adaptive_verification":true}'Nvidia
El equipo de Nvidia mejoró la inferencia de Muse Spark Open en FlashInfer y vLLM mediante kernels fusionados de normalización, compuertas y residuales; finalización de MoE fusionada con comunicación tensor-paralela y RMSNorm; una nueva implementación GEMM BF16 de baja latencia y una reducción de la sobrecarga de compilación; sharding de pooler/unpooler TEP con colectivos MNNVL fusionados; GEMM de router TF32 alimentado por la salida FP32 de la norma; y mejoras en el movimiento de datos, soporte de hardware y fiabilidad del runtime.
AMD
Gracias al equipo de AMD, también hemos soportado el modelo en GPUs AMD Instinct™ MI355X, tanto en formatos cuantizados FP8 como MXFP4, proporcionando un mejor rendimiento de inferencia y eficiencia de despliegue. Tenga en cuenta que ROCm actualmente soporta tanto el paralelismo de tensores (Tensor-Parallel) como el de tuberías (Pipeline-Parallelism).
TPU
Hemos agregado soporte para Muse Spark Open en TPU sobre TorchTPU. Contáctenos o a Google para obtener acceso al código. También hemos construido megakernels para Muse Spark Open. Con decodificación especulativa DSpark (longitud de aceptación = 6), alcanzan más de 650 tokens/seg en 4 chips TPU v7 y más de 960 tokens/seg en 8 chips. Sin decodificación especulativa, aún entregan más de 270 y 350 tokens/seg, respectivamente.
Aprendizaje por refuerzo en vLLM
vLLM también soporta LoRA RL en Muse Spark Open desde el día 0, sirviendo como motor de rollout con Verl FSDP2 como entrenador. vLLM sirve el checkpoint original NVFP4 con el adaptador LoRA aplicado encima. El entrenador se ejecuta sobre una dequantización BF16 de los mismos pesos y actualiza solo el adaptador (rango 32, alpha 64), que cubre la atención, las proyecciones latentes del MoE y todos los expertos enrutados. También reproduce el enrutamiento MoE del rollout (R3), y solo el adaptador se sincroniza de vuelta a vLLM después de cada paso.
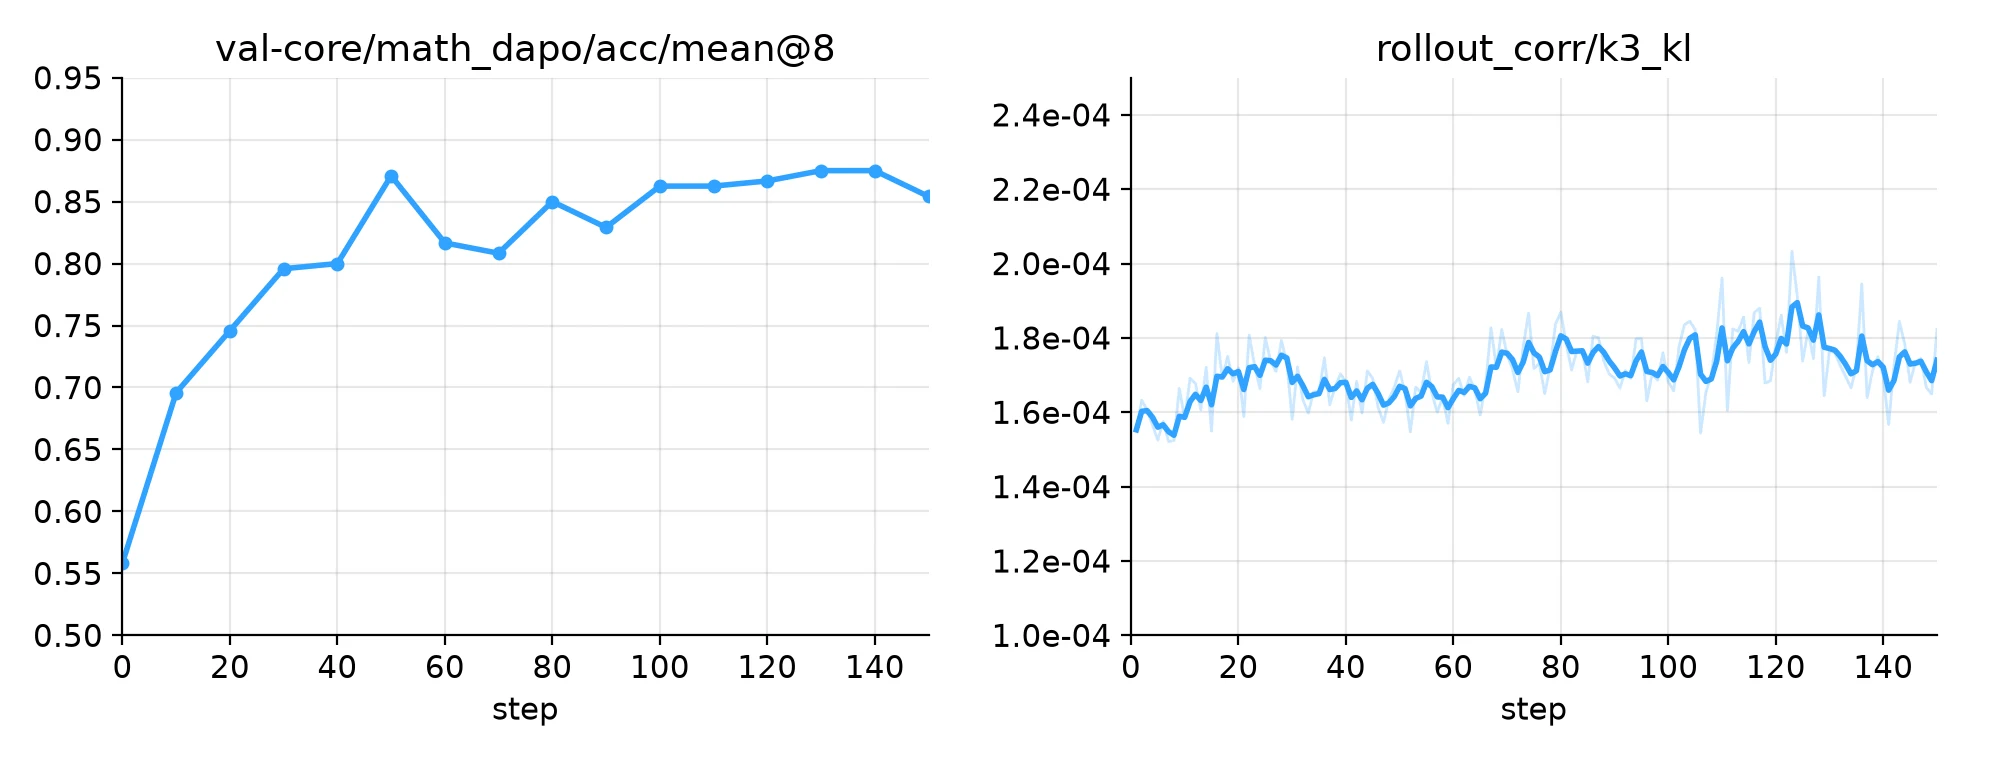
Entrenamos con GRPO en DAPO-Math-17K durante 150 pasos en 16 GPUs GB300, muestreando 8 respuestas para cada uno de 32 prompts por paso con hasta 4K tokens por respuesta. La precisión en AIME-2024 (mean@8) pasó de 0.56 antes del entrenamiento a 0.85 al final de la ejecución. Durante toda la ejecución, la k3 KL entre las log-probabilidades del entrenador y de vLLM se mantuvo cerca de 2×10⁻⁴. Más detalles están disponibles en https://github.com/verl-project/verl/pull/8257. En el ecosistema de vLLM, Titan RL también utiliza vLLM como su motor de rollout para ofrecer soporte de RL desde el día 0.
Agradecimientos
Extendemos nuestro más sincero agradecimiento a los equipos de Meta Superintelligence Labs y a la comunidad de vLLM por su estrecha colaboración en la entrega del soporte Day 0 para Muse Spark Open en vLLM. También agradecemos a Inferact por el entrenamiento del especulador DSpark y la integración con TPU, así como a NVIDIA y AMD por sus optimizaciones de hardware fundamentales.
Colaboradores:
- Inferact: Jie Li, Zifeng Mo, Zixi Qi, Jeff Ma, Ziqi Zhao, Dakai An, Ao Shen
- Meta: Beto de Paola, Sidhartha Reddy Potu
- Nvidia: Cyrus Chang, Duncan Moss, Marek Pikulski, Seong Hee Lee
- AMD: Andy Luo, Hongxia Yang, Haichen Zhang