
Lu Yu, desde Aofeisi
Quantum Bit | Cuenta oficial QbitAI
¡Madre mía! Otra vez llegó el Double 11 anual...
Compañeros que trabajan en el comercio electrónico, ¿are you ok? Mi amiga ya no aguanta más y me bombardea con mensajes todos los días:
¿Conocen alguna buenaherramienta de IA para trabajarPidan recomendaciones? Urgente, urgente, urgente, preferiblemente una que haga bien el trabajo y aguante mucho tiempo.
Y no es broma, últimamente descubrí una verdadera joya.
El recientemente abierto en código por Ant Bailing,Ling-3.1-flashdel que depende para mis informes semanales de trabajo y mis resúmenes de temas.
u1s1, también he usado Claude Code, Codex y otros, pero al final descubrí que los modelos nacionales son los que más me convencen.
EspecialmenteBailingque normalmente no presume, no compite en parámetros ni en rankings, pero cuando llega el momento de trabajar, es sumamente confiable.
Según la versión oficial, este modelo se centra en una sola cosa:terminar el trabajo dentro de los flujos de trabajo reales.
Tomando como ejemplo el informe de comercio electrónico del principio, cuando el jefe dice«resumir la situación de esta gran promoción»lo que recae sobre el trabajador es buscar información, verificar datos, dar seguimiento al progreso, y luego hacer un Excel y una PPT de presentación...
Detrás de una sola tarea suele haber colaboración entre múltiples eslabones, y lo más problemático es que los datos están dispersos en diferentes archivos y diferentes herramientas.
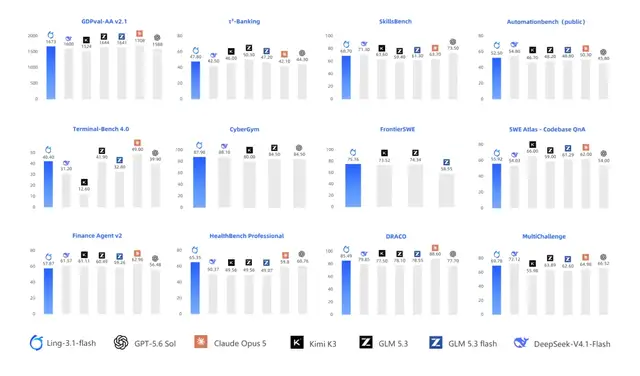
Imagen de la cuenta oficial de Bailing en Weibo
Ling-3.1-flash es precisamente un modelo profesional dealta relación inteligencia-eficienciaderivado de este tipo de necesidades reales.
En pocas palabras, lo que quiere demostrar es que responder con elegancia es solo secundario; lo clave es poder entregar la tarea.
Creado para tareas del mundo real
Para poder asumir trabajos tan minuciosos como el análisis de una gran promoción, el modelo debe avanzar de manera continua a lo largo de múltiples procesos. El diseño del modelo Ling-3.1-flash puede entenderse siguiendo esta cadena de tareas.
El primer problema que el modelo necesita resolver esDescomponer con claridad los objetivos de entrega。
El usuario puede dar una sola instrucción vaga, pero lo que realmente hay que entregar es un conjunto completo de materiales de informe; el modelo debe buscar por sí mismo la información relevante, determinar qué falta y qué se necesita, y luego avanzar a partir de los resultados intermedios.
Ling-3.1-flashfunciona exactamente así.
Conecta la comprensión de requisitos, la descomposición de tareas, la integración de información, la invocación de herramientas y la verificación de resultados, y puede trabajar a través de páginas web, documentos, hojas de cálculo y entornos de código.
En lo intelectual puede crear Excel y PPT, y en lo práctico también puede generar y probar código.
¡Y es que! Estas capacidades ya tienen una forma deimplementación bastante concreta。
Ling-3.1-flash ya ha sido integrado en el cliente de escritorio colaborativo Agent interno de Ant«Xiaohu»; el modelo dirige las acciones, mientras que el entorno de ejecución debe permitirle realmente leer archivos, ejecutar programas y escribir resultados.
Esta es una idea que vale la pena tomar como referencia; aunque todavía no podemos usar Xiaohu, nuestra propiaAgent de oficinacombinada con Ling-3.1-flash, presumiblemente debería dar buenos resultados también.
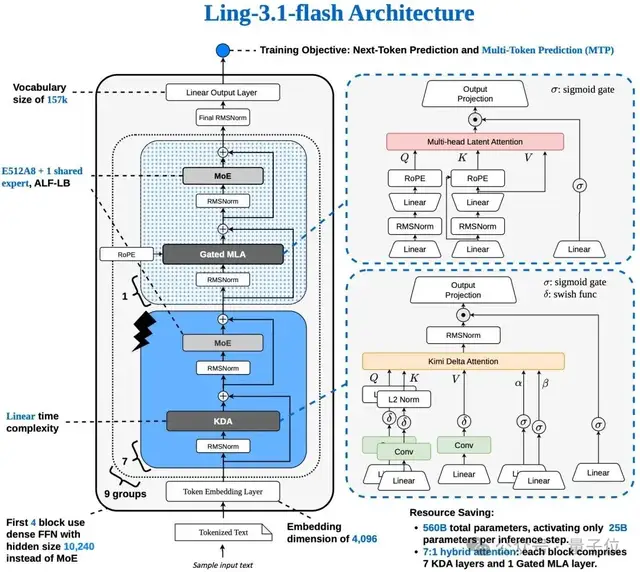
A medida que la tarea avanza, los materiales y el contexto histórico se expanden notablemente, y el costo computacional también aumenta en consecuencia.
En este momento, el Ling-3.1-flashdiseño de arquitectura híbridade Ling-3.1-flash desempeña un papel clave.
El modelo tiene aproximadamente 560B de parámetros totales, con alrededor de25Bactivados por cada Token. Manteniendo la capacidad de conocimiento, Ling-3.1-flash ha reducido la escala de pesos que realmente participan en el cálculo en cada paso.
En cuanto a la estructura de atención, hereda la arquitectura de Ling-3.0-flash y aumenta además la proporción deatención lineal.
Utiliza una configuración de 7 capas de KDA combinada con 1 capa de Gated MLA, donde KDA se encarga del procesamiento de secuencias con complejidad temporal lineal, y por cada 8 capas se conserva 1 capa de Gated MLA para mantener una vía de atención global.
La ventana de contexto del modelo puede alcanzar un límite de hasta1M, puede contener de una sola vez más documentos, código y tareas históricas, reduciendo el trabajo de dividir manualmente y de transferir información una y otra vez.
Al mismo tiempo, el modelo configura 512 expertos de enrutamiento, cada Token selecciona 8 de ellos y, al mismo tiempo, invoca 1 experto compartido.
este tipo de"Mixture-of-Experts lineal disperso híbrido con MoE" — wait, must translate only. "Mezcla híbrida deExperts lineales dispersos y MoE" — keep simple: "Mezcla lineal híbrida y MoE disperso"...con un único objetivo: que el modelo no falle en ejecuciones prolongadas y que tampoco llegue a quemar el poder de cómputo.
Además, el equipo también está reduciendo activamente las barreras de despliegue; mediante la cuantización de precisión mixta, la ocupación de los pesos del modelo pasó de aproximadamenteReducción de 534GB a 292GBEn la configuración de prueba Hopper correspondiente, las GPU necesarias para el despliegue fueron suministradas porde 8 tarjetas a 4 tarjetas。
Orientado a escenarios de negocio concretos, el equipo también ofrece una solución de inferencia en paralelo de contexto largo (PCP/DCP) y refuerzaJSON Schemade soporte, lo que permite al modelo procesar más convenientemente documentos extensos e integrarse con las interfaces de negocio existentes.
Más allá de la arquitectura, para saber si es mula o caballo, hay que ponerlo a prueba en evaluaciones reales.
EnEvaluación de tareas de oficinaEn GDPVal-AA V2.1, Ling-3.1-flash obtuvo una puntuación ELO de 1673, mostrando competitividad en el manejo de tareas laborales de múltiples pasos.
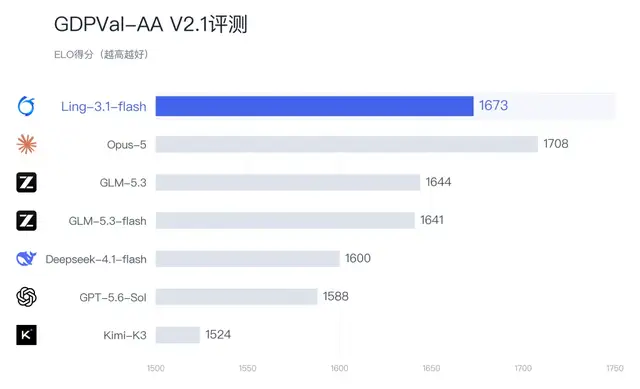
Imagen procedente de la cuenta oficial de Bailing en Weibo
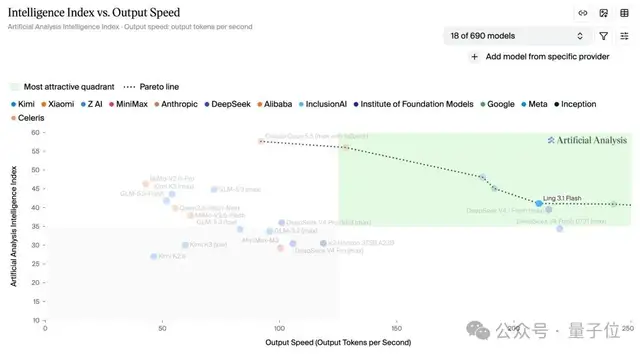
Mientras tanto, segúnArtificial AnalysisSegún la última evaluación pública, Ling-3.1-flash tiene un índice de inteligencia de 41, una velocidad de salida de aproximadamente 210 Token por segundo y un precio de llamada híbrida de unos 0.19 dólares por millón de Token, ofreciendo para escenarios de negocio de alta frecuencia una opción que equilibra nivel de inteligencia, eficiencia de generación y coste de llamada.
Escenario médicoEn la evaluación HealthBench Professional bajo..., Ling-3.1-flash también mantiene una posición relativamente líder.
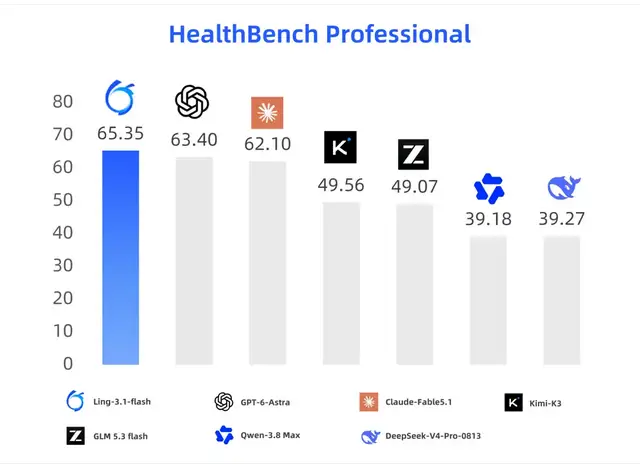
Imagen originaria de la cuenta oficial de Bailing en WeChat.
Además, en escenarios como el desarrollo de software y la operación de terminales, Ling-3.1-flash también posee cierta capacidad de comprensión y ejecución de información.
Tomando como ejemplo una tarea de desarrollo de un compilador nativo de Lua llevada a cabo internamente en Ant, todo el proceso duró aproximadamente 17 horas, durante las cuales el modelo desarrolló y corrigió repetidamente, alcanzando finalmente una tasa de aprobación en pruebas independientes de97.8%。
Por lo tanto, al elegir un agente de oficina, Ling-3.1-flash resulta completo, profesional y sin errores, lo que lo convierte en la opción prioritaria para probar.
Prueba práctica de Ling-3.1-flash: la verdad se ve en los hechos
Para probar qué tan bien trabaja realmente«Verdadero»¡empecemos con la prueba real!
Para la primera tarea, probemos primero con unencargo de e-commerce del Double 11para tantear el terreno.
Supongamos que eres el responsable de e-commerce de la marca de organización del hogar Ling; según los materiales, debes presentarle al jefe un plan para la gran promoción del Double 11 que cubra del 15 de octubre al 11 de noviembre, y el plan será entregado directamente a los equipos de operaciones, contenido, atención al cliente y almacén para su ejecución posterior.
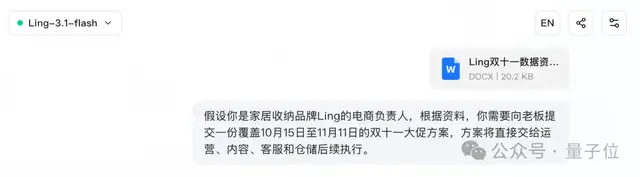
P.D. Los datos relevantes fueron generados con la ayuda de Codex.
Tras recibir los objetivos de negocio, la información de los productos, la situación del equipo y los datos históricos de los canales, el modelo comenzó rápidamente a organizar la información y a diseñar el plan de promoción.
Primero, el modelo realizó unanálisis de viabilidad del objetivo inicial。
. No aceptó directamente el castillo en el aire propuesto por el jefe; tras identificar de antemano restricciones como la disminución de la eficiencia marginal de la publicidad, el inventario y la capacidad de envío, ofreció una estimación relativamente razonable del objetivo inicial.
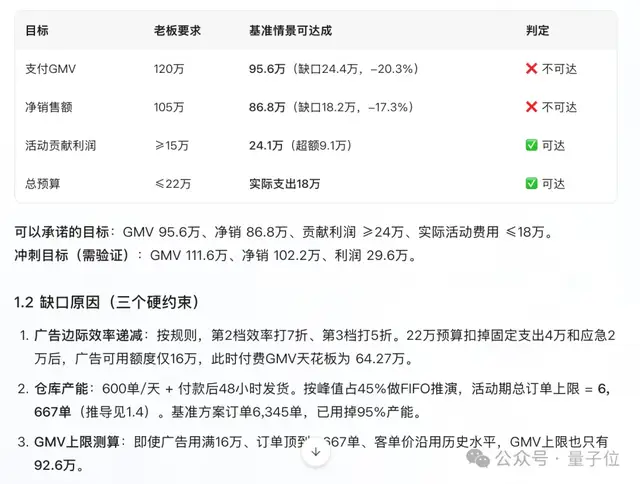
También proporcionó la correspondienteruta de ajustepara ayudar a los trabajadores a responder a las preguntas del jefe.
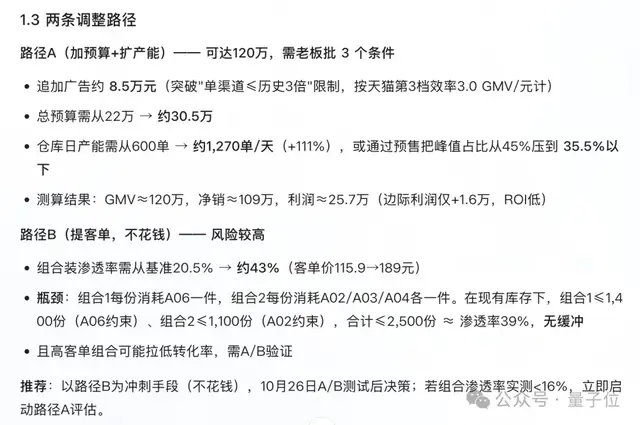
Veamos ahora el plan de descuentos de la promoción propuesto por el modelo: las cifras clave calculadas en él, la verdad,resisten la verificación。
. Tanto la tabla de combinaciones de productos como el detalle del presupuesto por canal, cada dato es trazable, lo que demuestra cierta capacidad de análisis de datos.
Ling-3.1-flash también proporcionó detalladamente uncronograma de ejecución por fases, incluyendo incluso las condiciones previas necesarias para cada fase.
Aunque en el prompt solo pedimos que el plan de promoción llegara hasta el día del Double 11, el modelo añadió por su cuenta el posterior proceso de revisión y cálculo de beneficios.
Realmente es muy detallado y considerado~
Lasalida de textodel modelo tampoco está nada mal; por ejemplo, domina con soltura los mensajes para acelerar pedidos en videos cortos y los guiones para transmisiones en directo.
Imágenes, textos y ganchos, todo incluido; nosotros, los pobres asalariados, podemos copiar directamente la tarea de la IA: sin complicaciones y sin esfuerzo.
Por último, el modelo también realiza proactivamente unaverificación de consistencia, señalando claramente qué datos aún deben ser verificados por el usuario y qué contenidos necesitan su confirmación; la iniciativa final en la ejecución del plan sigue estando siempre en manos del usuario.
Además del trabajo de oficina diario,los escenarios de salud médicatambién son un punto fuerte de Ling-3.1-flash.
Le entregamos unos datos virtuales de un análisis de lípidos en sangre y una descripción vaga de los síntomas, con la esperanza de que el modelo organizara una hoja de comunicación para llevar a la consulta médica.
Ante la falta de información suficiente, Ling-3.1-flash no emitió un juicio directamente, sino que primero enumeró los detalles que el usuario debía complementar, y luego distinguió entre hechos conocidos, puntos inciertos y preguntas para hacer al médico.
Trasguiaral usuario para que complementara la información clave, el modelo cruzó y verificó el contenido nuevo con el existente, obteniendo así una referencia de consulta más profesional.
Cabe destacar que, durante el proceso de razonamiento, el modelo insistió constantemente en elprincipio de alerta de línea roja: recordó en todo momento al usuario que estuviera atento a los cambios en su estado de salud y que acudiera al médico a tiempo, y tampoco dio pautas de medicación concretas.
A lo largo del proceso, actuó más bien como un asistente que completa el trabajo preliminar para el médico.
Sin embargo, Ling-3.1-flash también presenta algunos pequeños errores; por ejemplo, si se le introduce de golpe un texto largo extenso,la atención del modelo a veces se desvía。
. Por ejemplo, un plan para la gran promoción del Double 11 es en sí mismo una tarea de trabajo muy compleja y de largo plazo, por lo que se recomienda más entregarla por etapas, por ejemplo, usar primero un script para organizar los datos y luego generar el plan, avanzando así de manera gradual.
Al generar con una sola instrucción existen igualmente límites de adaptación: si el resultado actual no es bueno, suele ser más eficiente que el usuario vuelva a aclarar la idea de implementación y las especificaciones de entrega que seguir probando suerte.
Además,la versión actual aún no cuenta con comprensión visual nativa, por lo que hay que colocar por adelantado un modelo de visión que realice el procesamiento, lo que también aumenta el costo de todo el flujo.
En definitiva, si el modelo logra resultados utilizables depende de la tarea.
Bailing entra por delante en el flujo de tareas reales
Después de hablar del modelo en sí, volvamos la vista aBailing: en realidad ha pisado con precisión los puntos de dolor del sector.
Este año, el círculo de los grandes modelos ha competido casi por completo en Coding y en los rankings.
Pero cuando la competencia alcanza cierto nivel, cada vez más personas se preguntan algo más fundamental: ¿acaso AGI solo tiene el Coding como único campo de examen?
El juicio de Xiting, responsable de Bailing, en la Conferencia de Waitán fue queel Coding no es el único campo de examen。
. En su opinión, el objetivo de Bailing sigue siendo servir a las tareas del mundo real, extraer las capacidades del modelo del plano técnico,y usar tareas reales para puntuar a los modelos。
Por eso, Bailing puso su serie de modelos 3.0 en los dos lugares donde menos se puede permitir errores:Finanzas y sanidad。
LingFinEs un modelo financiero de gran escala de alta relación eficacia-coste, que reconstruye la eficiencia financiera tomando la investigación sectorial como punto de entrada; modelo mejorado para el sector sanitario y de la salud.LingSante, se centra en el razonamiento de conocimiento médico, la recuperación basada en evidencia y la exploración de flujos de trabajo estandarizados.
Entre ellos, Ling-3.0-flash-Fin (con 124B de parámetros totales y 5.1B activados) permite que la IA entre en el flujo real de tareas de investigación financiera, integrando la cadena completa de tareas, desde buscar material y realizar análisis hasta generar resultados de investigación.
En tareas de investigación financiera de alta dificultad iguala a modelos frontera de clase 3T, su rendimiento agregado como agente financiero alcanza el primer nivel entre los de código abierto, y su desempeño en tareas críticas está a la altura de modelos frontera como GPT-5.4.
Ling-3.0-flash-Sante lleva una alta relación eficacia-costo a los escenarios médicos, logrando el mejor rendimiento entre los modelos de menos de 1.6T con una escala de 124B parámetros,Rendimiento general comparable al de varios modelos insignia.。
Imagen proveniente de la cuenta oficial de Bailing en Weibo
En comparación con los modelos base, estos no son simples ajustes menores del sector: se han incorporado de verdad en entornos de trabajo complejos, con un pulido y una verificación continuos.
Mirando desde una perspectiva más amplia, Bailing también está haciendo algo que lidera a la industria, que es redefinir"Eficiencia"Esta palabra.
En el pasado, la industria hablaba derelación de eficiencia de cómputo, cuánta capacidad de cómputo se utilizó y si la eficiencia fue alta.
Bailing fue la primera en hablar conjuntamente de la eficiencia de cómputo del modelo, la eficiencia de parámetros y la eficiencia de Tokens, enfatizando elratio de inteligencia-eficiencia。
Esta formulación también obtuvo rápidamente respuesta de la industria; en el último medio año, Anthropic y OpenAI han ido lanzando sucesivamente capacidades profesionales orientadas a las finanzas y la salud.
Por ejemplo, el mes pasado Anthropic lanzóClaude for Financial Advisors, que organiza conectores y Skills de tareas en torno a trabajos concretos, lo cual es otra práctica de integración de flujos profesionales.
Es cierto que la disputa de rutas está aún lejos de decidirse, pero«entrar en los flujos de trabajo reales»está pasando de ser la elección de una sola empresa a convertirse en la tendencia de toda la industria.
Este año también es un año clave para que Bailing pase de la capacidad del modelo al valor de la tarea.
A través de Ling-3.1-flash, el camino que seguirá Bailing ya está escrito:
Hacia arriba, seguir elevando el techo de capacidad de los Agentes para los desarrolladores;hacia abajo, reducir aún más la barrera de uso para los usuarios comunes, convirtiendo una mejor relación entre inteligencia y eficiencia en una capacidad real de hacer las cosas;hacia afuera, seguir profundizando la especialización de los modelos para lograr avances en el mundo real.
Se puede ver que la forma en que el círculo de los modelos demuestra su valor está cambiando de marcha, pero todo apenas comienza.
Ling Studio:
https://ling.tbox.cn
OpenRouter:
https://openrouter.ai/inclusionai/ling-3.1-flash
HuggingFace:
https://huggingface.co/inclusionAI/Ling-3.1-flash
ModelScope:
https://modelscope.cn/models/inclusionAI/Ling-3.1-flash