
IT之家 16 de octubre — Ant Group Bailing anunció ayer la apertura del código del modelo Ling-3.1-flash. Ling-3.1-flash tiene unos 560B de parámetros totales, con unos 25B activados por Token, y admite un contexto de hasta 1M.
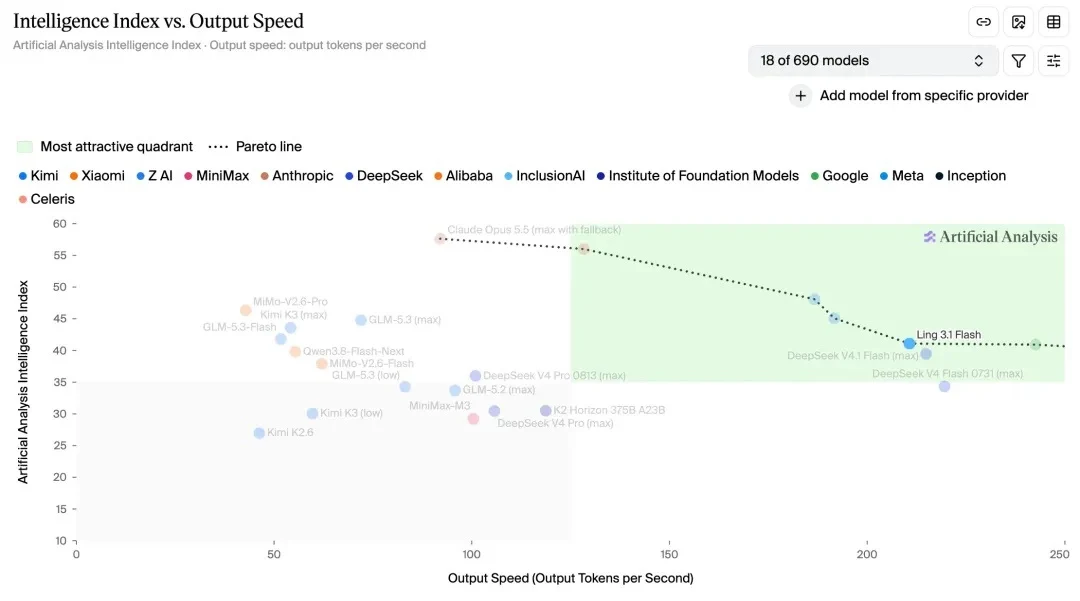
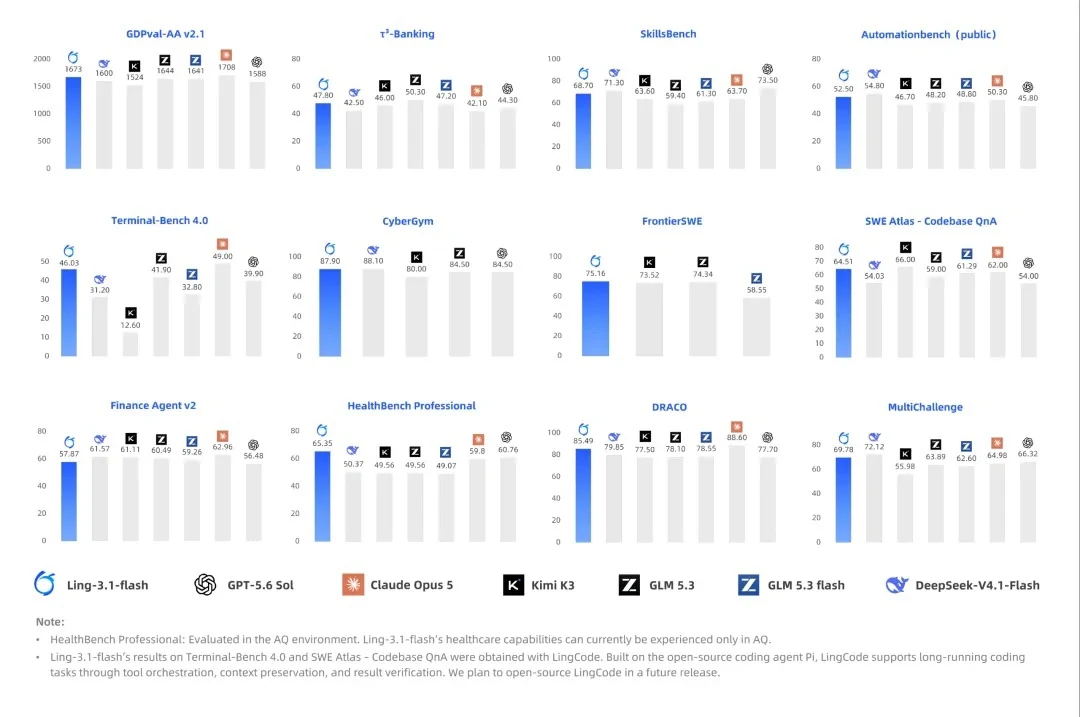
En las evaluaciones públicas de Artificial Analysis, el índice de inteligencia de Ling-3.1-flash es de 41 y la velocidad de salida es de aproximadamente 210 Tokens por segundo.
Para el despliegue local, el equipo aplicó cuantización MXFP4 a los routed experts y mantuvo block-FP8 en las capas dense, reduciendo la ocupación de pesos de unos 534GB a 292GB. En la configuración de pruebas correspondiente con GPU Hopper, el despliegue del servicio pasó de 8 tarjetas a 4 tarjetas, permitiendo que los equipos con GPU de nivel servidor ejecuten el modelo con menos tarjetas; la demanda real sigue variando según el contexto, la concurrencia y la configuración del servicio.
Para el procesamiento de documentos largos, el equipo ofrece una solución de inferencia paralela de contexto largo (PCP / DCP); la llamada de herramientas también reforzó el soporte de JSON Schema, facilitando la conexión con interfaces de negocio existentes.
Las preguntas y respuestas de conocimiento empresarial y los asistentes de oficina suelen necesitar leer primero documentos extensos, y los usuarios aún desean ver la respuesta cuanto antes. El equipo redujo la sobrecarga de inferencia mediante la fusión de operadores y la decodificación especulativa DSpark: en solicitudes de producción simuladas con una entrada media de unos 25.47K Tokens, una salida de unos 224 Tokens y una tasa de acierto de caché del 76%,con configuración de 8 tarjetas Hopper el tiempo medio hasta el primer Token fue de 604 milisegundos, y el intervalo medio entre Tokens de salida consecutivos fue de 3.28 milisegundos. Esto ofrece una referencia de prueba para la respuesta interactiva tras la entrada de documentos largos.
Los sistemas de negocio que prestan servicio de forma continua también necesitan evaluar cuántas solicitudes puede atender una sola instancia dentro de un presupuesto fijo de GPU. Con una entrada media de aproximadamente 8.5K Token y una salida de aproximadamente 800 Token, en la 4 tarjetas Hopper , con una entrada media de unos 8.5K Tokens y una salida de unos 800 Tokens, el modelo alcanzó unos 1.36 QPS, cumpliendo a la vez las restricciones de prueba de un tiempo hasta el primer Token P50 inferior a 3 segundos y un intervalo entre Tokens de salida consecutivos P90 inferior a 70 milisegundos. Esto ofrece una referencia para la planificación de capacidad de despliegues propios.
En cuanto a la experiencia en línea, Ling-3.1-flash ofrece actualmente un descuento por tiempo limitado del 2.5 折 (75 % de descuento); los precios con descuento son los siguientes:
OpenRouter(en dólares): entrada 0.075 dólares; salida 0.225 dólares; lectura de caché 0.015 dólares.
Ling Studio(en yuanes): entrada 0.5 yuanes; salida 1.5 yuanes; lectura de caché 0.1 yuanes.
IT之家 adjunta los enlaces de código abierto:
Hugging Face:https://huggingface.co/inclusionAI/Ling-3.1-flash
ModelScope:https://modelscope.cn/models/inclusionAI/Ling-3.1-flash
Lectura relacionada:
Declaración publicitaria: los enlaces de salto externo contenidos en el texto (incluyendo, entre otros, hipervínculos, códigos QR, contraseñas y otras formas) se utilizan para transmitir más información y ahorrar tiempo de selección; los resultados son solo de referencia. Todos los artículos de IT之家 que contienen enlaces externos incluyen esta declaración.