
Hemos dicho antes que Claude escribe aproximadamente el 90 por ciento del código propio de Claude Code. Entonces, ¿cómo revisamos el código en la cantidad que producimos? ¿Alguien sigue leyendo código? Y si algo falla, ¿quién lo detecta?
Este artículo aborda el flujo de revisión de código en el equipo Claude Code y cómo ha evolucionado. De junio a septiembre, las solicitudes de merge a la base de código de Claude Code se duplicaron más que dos veces, mientras que la proporción de solicitudes que tuvieron que ser revertidas disminuyó en más del 40 por ciento.
No eliminamos la revisión. Pero trasladamos la mayor parte de la lectura a las máquinas, optimizándola para el tiempo y la atención humana, y invertimos mucho en hacer que sea rápido y fácil deshacer errores.
Reconsiderar el propósito de la revisión del código
Cuando los agentes escriben código, el número de cambios aumenta rápidamente. En el monorepo de Anthropic, los cambios que se registran al día pasaron de unos 2,500 en mayo a más de 30,000 en septiembre este año.
El código de Claude vive en su propio repositorio, separado del monorepo, pero también está sufriendo mucha presión. Cuando se envía este código rápido y manual, una revisión línea por línea es increíblemente difícil, si no imposible.
La revisión de código realiza dos tareas:
- Encuentre y corrija los problemas antes de que se lance el producto
- Construir un contexto compartido y una comprensión de la base de código entre el equipo
Este artículo se centra principalmente en encontrar y solucionar problemas, pero volveremos al segundo punto cerca del final.
Pensamos que “¿un ser humano leyó el código?”, es un proxy impreciso para preguntar: “¿qué podría salir mal con este cambio, y qué verificación —automatizada o humana— es la adecuada para detectarlo?”.
Al hacer esa pregunta, también cambió cuándo se lleva a cabo la revisión. Antes, la revisión era como un umbral al final del camino: escribir el código, abrir una PR, esperar a su colega.
Ahora, las revisiones se realizan de forma continua, más como un corrector ortográfico mientras se escribe. La mayoría de los cambios han sido revisados y corregidos por Claude al menos una vez antes de que se pida a un humano que reviselos. Esto detecta la mayoría de los errores rutinarios y permite que el equipo se concentre en las cuestiones de nivel más alto y en el análisis detallado.
EL RECURSO ESCRAVO: EL TIEMPO Y LA ATENCIÓN HUMANAS
Queremos preservar el tiempo y la atención humana para los problemas que solo los seres humanos pueden resolver, y asegurarnos de que las verificaciones automáticas se encarguen del resto. Con nuestra tasa actual de cambio, todavía hay una cantidad increíble de trabajo por hacer para los humanos, y nuestro equipo se enfrenta a nuevos y novedosos desafíos casi a diario.
El tiempo humano abarca ambos aspectos del costo de la revisión: el tiempo que las personas invierten en revisar y el tiempo que invierten en corregir los errores del código malo. Eliminar el primero no ayuda si ese tiempo simplemente se convierte en parte del segundo.
Así que el objetivo es que la mayoría de los pull requests en el repositorio Claude Code (la CLI, las aplicaciones de escritorio y web, y las aplicaciones móviles) se fusionen con, como máximo, una persona en el proceso, que puede ser el autor, sin aumentar el número de reverts ni incidentes. Para medir el tiempo humano, rastreamos las aprobaciones humanas por PR (mediana y percentil 95), los comentarios humanos y cuánto tiempo dura un PR esperando a una persona. Las tasas de reverts e incidentes son la barrera: si aumentan, no hemos ahorrado tiempo humano, solo lo hemos movido.
LA VIDA DE UN CAMBIO
Un cambio típico, desde la computadora portátil de un ingeniero (o una sesión con Claude en Slack), pasa por múltiples capas de revisión de código.
CAPA POR CAPA
1. El trabajo se verifica antes de que cualquier otra persona lo vea
La mayoría de las revisiones se realizan antes de que exista un PR. Le damos a Claude algo que pueda ejecutar, como pruebas, una compilación o una pantalla de pantalla para comparar con el diseño, y le pedimos que muestre el resultado en lugar de decir que está terminado. Luego, un subagente revisa el dif con contexto fresco. Ambos hábitos provienen de nuestro guía de buenas prácticas.
Antes de abrir un PR, muchos de nosotros también realizan algunas tareas internas: uno busca errores, otro simplifica el dif y otro verifica el comportamiento de todo en todo. Los cambios en la interfaz de usuario también se revisan según nuestras directrices de diseño.
Boris Cherny, quien creó Claude Code, ha dicho que darle a Claude una forma de verificar su trabajo probablemente es lo más importante para obtener buenos resultados. Estima que esto hace que el resultado final sea dos a tres veces mejor, y escribe: “La verificación es diferente para cada dominio. Puede ser tan simple como ejecutar un comando bash, o ejecutar una sucesión de pruebas, o probar la aplicación en un navegador o simulador de teléfono”.
Cuando el revisor automático sigue marcando lo mismo, lo corremos en la fuente: en la habilidad, con una regla de lint, o con actualizaciones en los archivos instructivos, como por ejemplo:
CLAUDE.mdindica a Claude qué es el proyecto: la estructura de código, las convenciones, los objetivos y las no objetivos. Cada revisión lo carga, por lo que en un código base largo lo mantenemos breve y nos referimos a otras documentaciones desde allí. El revisor también señala el código que rompe una convención y los cambios que hacen que una línea del código pierda su vigencia.REVIEW.md, escrito por los propietarios del código, indica al revisor qué es importante en su parte del código. Comprobamos por separado si el revisor realmente lo sigue. Los buenos son breves. Indican cómo se ve el error en ese repositorio (en el caso de documentación es “lo miente”, en el caso de configuración es “rueda incorrectamente”), limitan los problemas, listan los caminos que deben omitirse y piden un archivo y una línea como evidencia en lugar de una suposición basada en un nombre. También piden un resumen que comience con un conteo y dice claramente cuando no hay nada que arreglar.
2. Revisión de IA en cada solicitud de pull
Cada solicitud de pull recibe una revisión por Claude antes de que una persona la examine. Lee el dif para todo el repositorio y el propósito indicado en la solicitud de pull, y se pregunta: ¿la cambio resuelve el problema, se adapta al sistema o rompe algo más?
En la corrección de un error, se busca la causa raíz. La versión pública, Code Review for Claude Code, está ahora disponible generalmente en los planes Team y Enterprise, y /code-review ejecuta una versión más ligera localmente.
Cuando lanzamos la vista previa de investigación, la proporción de comentarios de revisión sustantivos en los PR internos pasó del 16% al 54%. La mayoría de los PR con más de 1,000 líneas recibe hallazgos, y la mayoría de los pequeños regresan sin problemas. Los administradores establecen cada repositorio en Quick, Standard o Deep. Es valioso usar Deep cuando un error no detectado cuesta más que el tiempo adicional de revisión.
Los hallazgos son verificados por otros agentes antes de que los humanos los examinen. Varias agencias buscan errores al mismo tiempo. Luego, un grupo separado vota sobre cada hallazgo, y solo se publica si hay suficientes votos que lo confirmen como real. Los hallazgos relacionados únicamente con estilo, diagnósticos o limpieza son descartados. Hemos realizado pruebas A/B de esos filtros en nuestras propias PRs antes de mantenerlos. Lo que queda se muestra como comentarios en línea ordenados por gravedad. Cada uno está etiquetado como Importante, Nit o Pre-existente, por lo que un error que la PR no introdujo no parece ser culpa del autor.
Todas las observaciones deben ser resueltas. O bien se corrige el problema o se aclara la cuestión con una explicación. A menudo, el agente resuelve el problema durante la noche, por lo que el autor vuelve a un PR que ya ha pasado otra ronda de revisión.
3. Revisión de seguridad que puede bloquear
La seguridad también requiere una revisión automatizada independiente. Un PR no puede fusionarse mientras alguna observación de la revisión de errores o de la revisión de seguridad siga abierta. O se corrige el problema o se cierra el hilo con una breve explicación, y así se elimina un falso positivo.
Si una commit posterior corrige el problema, el hallazgo se elimina por sí mismo. Puede configurar lo mismo con la acción GitHub Action de revisión de seguridad de código abierto o con el comando /security-review. La configuración se describe en revisiones de seguridad automatizadas en Claude Code.
4. Comprobaciones automáticas que bloquean
Lo habitual: comprobaciones de tipo, pruebas en todas las plataformas y una construcción del código. (Escribimos sobre cómo escalar CI en este artículo aquí.) Un solicitud de cambio en la CLI típica puede pasar por decenas de comprobaciones antes de que alguien la examine. El modelo de solicitud de cambio pide cómo se probó el cambio y cómo deshacerlo. Claude puede completarlo, pero la persona que solicitó el cambio lo aprueba.
5. Aprobación humana, escalada según el riesgo
Una corrección en los documentos y un cambio en el actualizador automático conllevan diferentes riesgos, por lo que requieren revisión diferente.
| Riesgo | Ejemplos | Aprobaciones humanas |
|---|---|---|
| Bajo | Documentos, copias, funciones exclusivas para el interior, cambios aditivos detrás de una marca | Ninguno necesario una vez que la revisión automatizada y los controles de seguridad estén verdes |
| Mediano | Cambios en productos comunes y cambios en áreas sensibles como el caché, el actualizador automático o las indicaciones del sistema | Una persona |
| High | El código de mayor riesgo, además de un pequeño conjunto de rutas que siempre requieren dos personas | Dos personas |
El cambio establece el nivel, no el autor. Un clasificador lee el cambio y selecciona su nivel de riesgo. Un segundo clasificador determina si este cambio específico necesita otra persona, incluso cuando su nivel indica que no es necesario. Algunos caminos siempre requieren una persona, cualquier cosa que los propietarios hayan marcado como sensible y cualquier archivo de flujo de trabajo CI.
Solo los autores confiables reciben los caminos más ligeros. Solo los autores que están en la lista de confianza del repositorio obtienen los caminos más ligeros, principalmente el equipo que lo administra. Todo el resto necesita la aprobación de otra persona. La aprobación de un agente tampoco cuenta como aprobación de una persona. La revisión automática puede aprobar cambios de bajo riesgo, pero no puede ocupar un espacio que requiere una persona humana.
Quien haya solicitado el cambio es responsable de él. En un PR escrito por un agente, la persona que dirige al agente cuenta como uno de los revisores requeridos, tal como si hubiera escrito el código por sí mismo.
Un aprobación cubre un único commit específico. Si se realizan nuevos commits que el sistema no puede verificar, como un push de un agente o una fusión resuelta manualmente por alguien, será necesario dar nuevamente la aprobación.
6. Fusionar cola, banderas y una liberación gradual
La cola de fusion vuelve a realizar cada comprobación contra el main con el cambio aplicado, por lo que dos PRs que pasan por separado no pueden combinarse en un main dañado. El nuevo comportamiento generalmente se lanza primero a los empleados de Anthropic bajo una marca, y nuestro uso intensivo a menudo revela regresiones antes de que los usuarios las detecten. Las versiones públicas se lanzan al latest Canal primero. El stable rastro de canales.
7. Detección rápida, rollback rápido
Algunos errores seguirán pasando, por lo que la última capa consiste en detectarlos rápidamente. Las banderas se desactivan sin una implementación. Claude Code tiene una rotación de turno semanal, y las revisiones de incidentes determinan qué capa debería haber detectado el problema.
Darse cuenta de una mala fusión todavía depende del autor y del operador en turno, así como de los paneles de revertir y incidentes. Aún no tenemos interruptores de circuito que aseguren la aprobación cuando esos números se mueven; los ingenieros aquí los quieren antes de que más código se mueva hacia fusiones sin humano.
Un colega dijo que desacelerar reduce la tasa de errores, pero sobre todo porque haces menos de todo. Preferimos ser más rápidos a detectar y solucionar problemas.
CÓMO HACEMOS QUE EL REVISTO sea mejor
Nuestro proceso de revisión de código está mejorando constantemente en un ciclo continuo.
Cualquier incidente ahora es una evaluación. El equipo recopiló los PR anteriores que causaron incidentes, junto con sus correcciones y revertes, y contaba con ingenieros que conocen el código para confirmar cada error y dónde se encontraba. El revisor ejecuta pruebas diarias contra ese conjunto de datos.
Medimos el ruido observando qué hacen las personas con los comentarios. Es fácil detectar más errores si no te importa señalar muchos casos que no son errores, así que necesitamos un control al respecto. Clasificamos cada comentario que deja el revisor según la respuesta de la persona en el PR: lo arreglaron, dijeron que estaba mal, dijeron que el comportamiento era intencional o decidieron que no importaba. También hacemos que el revisor trabaje en PRs que sabemos que están limpios y contamos cuántas veces informa algo que habría llevado a alguien a hacer un cambio dañino. Nuestra prioridad, escrita de manera clara, es detectar primero los verdaderos errores y luego reducir las rondas de revisión.
El ruido cuesta más cuando el autor es un agente. Una persona puede resolverlo en segundos. Un agente lo arregla, lo que significa otro commit y otra ronda de revisión.
La revisión debe converger. Un autor de agente y un revisor de agente pueden mantenerse ocupados el uno al otro indefinidamente. Un PR en CLI pasó por más de cincuenta rondas de revisión y correcciones durante la noche, antes de que su autor lo detuviera.
Cuando aplicamos git blame en lo que el revisor señalaba constantemente, aproximadamente el 59% era código que ya estaba presente desde la primera pasada del revisor. El revisor rara vez encontraba nuevos bugs; solo encontraba algunos más viejos cada vez que revisaba el código.
Nos empeoramos la situación nosotros mismos. Habíamos acostumbrado a realizar varias rondas por defecto, ya que cada pasada descubre algo nuevo. Esto puede ser valioso en un cambio arriesgado, pero no en todos los PRs. Ahora el equipo monitorea las rondas por pasar junto con el recordatorio, y cambiaron la revisión:
- Un casco redondo. Después de tres rondas, el revisor pide al autor que retroceda y reconsidere su enfoque.
- Revisión adicional de Diff-only después de las primeras unas vueltas.
- Indique el tipo de error, para que el autor corrija cada instancia, no una sola línea.
- Ninguna repetición de los hallazgos ya publicados.
Los agentes de revisión también ejecutan a diario un análisis del código existente, lo que nos ayuda a detectar los errores antiguos antes de que aparezcan en otro lugar.
DÓNDE LOS HUMANOS SE QUEDAN EN EL CIRCUITO
Hacer que un ingeniero sénior deje su trabajo profundo para detectar un error rutinario cuesta mucho más que una revisión automatizada. En Anthropic, nuestros trabajos han pasado de leer cada diferencia a las decisiones en las que las máquinas son malas:
- ¿Deberíamos hacer esto en absoluto? Dirección, gusto y alcance. Un equipo que declaró que tenía un cuello de botella en la revisión resolvió, pero continuó manteniendo la revisión humana para los cambios provenientes de fuera del equipo, por lo que alguien pregunta: “¿Deberíamos hacerlo siquiera?”
- Código riesgoso, como el de facturación, el actualizador automático y los flujos de trabajo de CI.
- Arquitectura que establece un patrón que otros copiarán.
- Leer las pruebas. El resultado del test, la orden que se ejecutó y lo que devolvió, una captura de pantalla, los hallazgos del revisor. Si no puedes decir qué se pasaría por alto en las verificaciones, pide una revisión real en lugar de una aprobación rápida.
- Ser responsable del resultado. Una persona es responsable de cada cambio que se implementa, quienquiera sea quien lo haya escrito.
Compartir el contexto entre el equipo
La segunda función de la revisión de código siempre ha sido difundir la comprensión del código base. Leer el dif de un colega es la forma en que se aprende qué cambió y cómo encajan los componentes. Si las máquinas realizan la mayor parte de la lectura, ¿cómo alguien puede aprender el código?
No tenemos un proceso formal para esto. Nadie en el equipo tiene un modelo mental completo del código de Claude en su cabeza, y creemos que nadie necesita tenerlo. Cuando alguien quiere entender una parte del código base, pide a Claude que escriba una explicación específica para esa sección. Esto lleva minutos y refleja el código tal como está hoy.
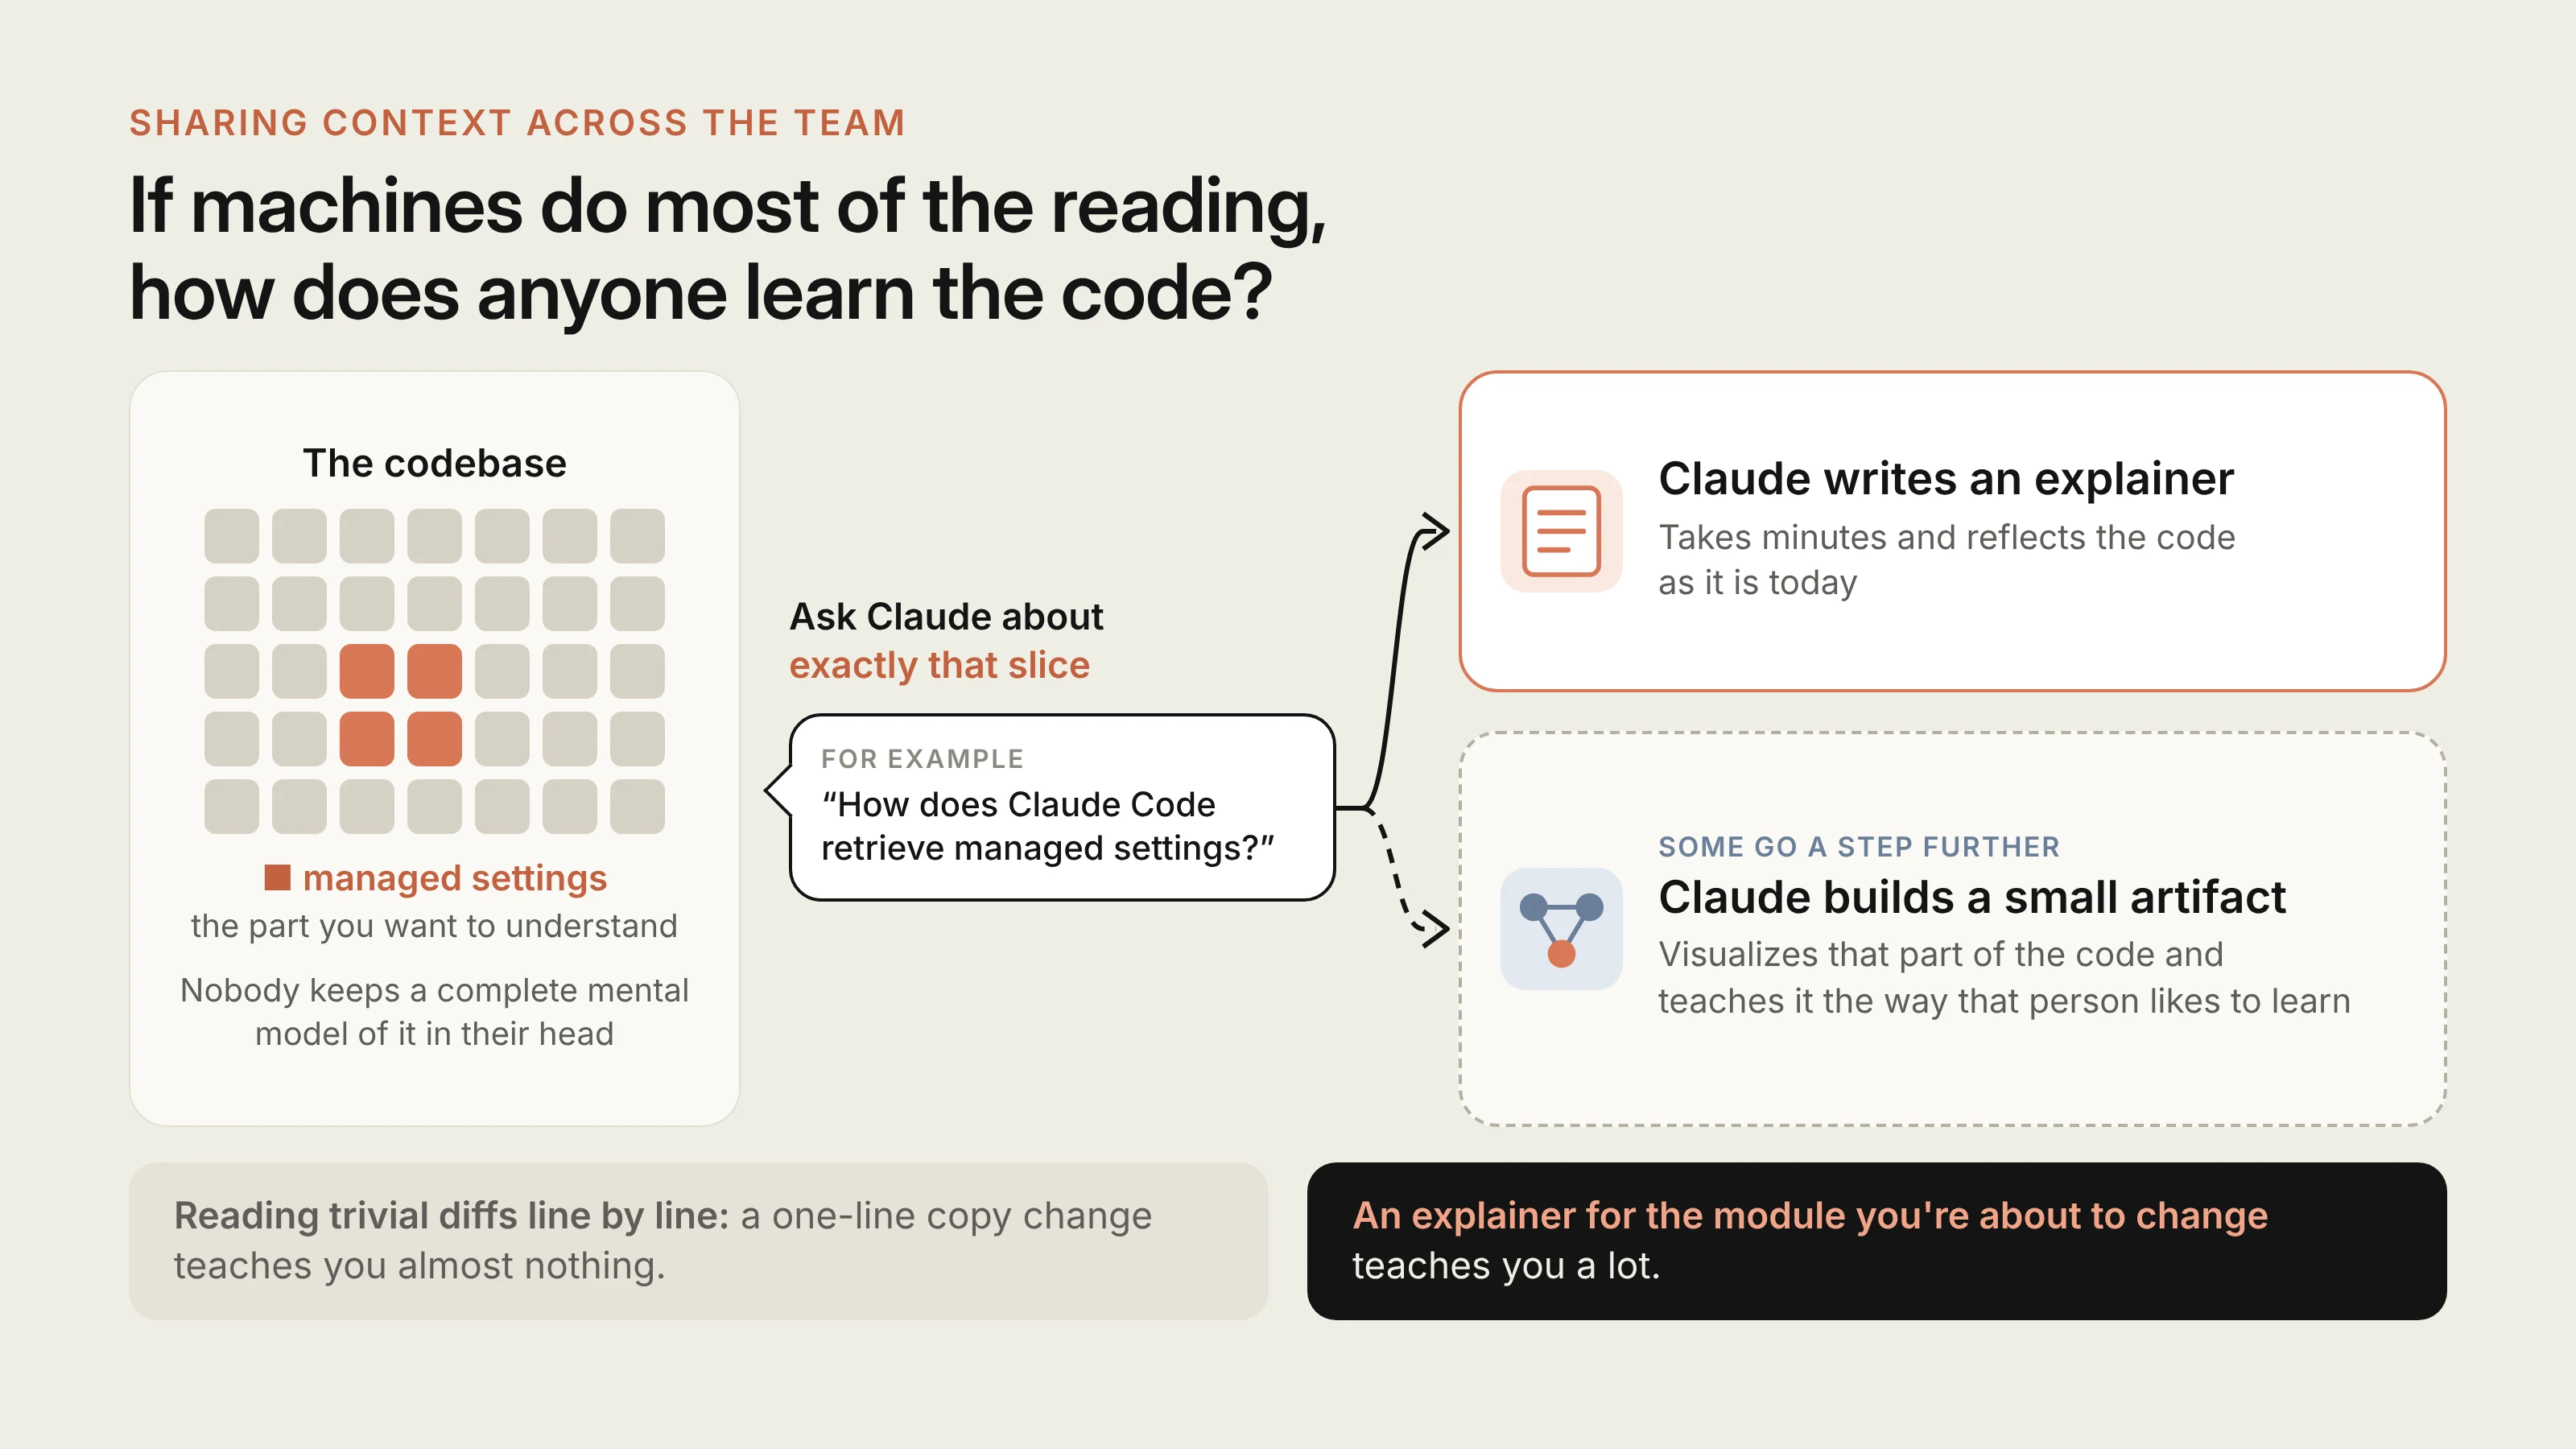
Algunos de nosotros van un paso más allá y hacen que Claude cree un pequeño artefacto que muestra esa parte del código, y lo enseña de la manera en que esa persona prefiere aprender.
Si el objetivo es ganar la atención humana de manera adecuada, esto es mejor que leer los cambios triviales línea por línea. Un cambio en una sola línea no enseña casi nada. Una explicación del módulo que se va a modificar te enseña mucho. Nuestra cultura de usar canales abiertos de Slack también ayuda, ya que puedes ver lo que otros están construyendo mientras lo hacen.
“Usted lo posee, usted lo esquema”.
Si aterrizas con un cambio pequeño o medio y algo sigue fallando, es una norma del equipo que generalmente se soluciona. Algunas cosas evitan que esto vaya mal:
- Los cambios son pequeños, por lo que son fáciles de revisar, depurar y revertir.
- Todo es reversible. Las etiquetas, los revertes y las versiones estadizadas pueden deshacer la mayoría de los errores en minutos.
- El radio de explosión define el nivel. El código costoso atrae a más personas y requiere más verificaciones.
- Las regresiones aparecen rápidamente a través de la telemetría y el uso interno.
- No hay que culpar. Ser responsable de una solución significa que tienes el mayor contexto; las revisiones de incidentes analizan el sistema.
La propiedad también se comparte. Muchos miembros del equipo trabajan en canales abiertos, donde cualquiera puede ver lo que los demás están construyendo, tomar una línea de trabajo o dirigir a Claude hacia un problema, y la retroalimentación proviene también de personas que no son dueños del código. Esa apertura es una parte importante de cómo se mantiene la calidad alta sin tener un control en cada línea.
CUANDO CAMBAMOS DIRECCIÓN
Los agentes hacen que sea barato comenzar las cosas, por lo que algunos trabajos no deberían completarse. Por lo general, alguien en el canal pregunta por qué, señala una decisión anterior o sugiere un camino más sencillo, y el autor cierra o reforma la relación pública.
Dado que el código era fácil de escribir, cerrar el PR no parece una pérdida. La clave es plantear una dirección diferente en el hilo desde el principio, no como un comentario bloqueante sobre un PR terminado.
CÓMO PUEDES Adoptar Este Proceso
La mayoría de los elementos necesarios para hacer esto con su equipo ya existen hoy en día.
Antes del pull request
- Dale a tu agente la capacidad de ejecutar las comprobaciones, listadas en un breve
CLAUDE.md, además de ganchos que ejecutan formatter y linters. - Ejecute
/code-reviewy/security-reviewlocalmente, o una revisión con contexto nuevo por el subagente. - Agrega un archivo
REVIEW.md, y traslada los comentarios de revisión repetidos a él.
En cada solicitud de pull
- Requiere CI, y agrega “Testing”, “Risk” y “Cómo revertir” en el plantilla de PR.
- Agregar un revisor de IA (Revisión de código para Claude Code, o la acción GitHub Action Claude Code) en un repositorio, ajustar
REVIEW.mddurante unas semanas, y luego ampliarlo. - Agregar una revisión de seguridad automatizada, y requerir que cada hilo de revisión se resuelva antes de la fusión.
- Ajustar el esfuerzo de la revisión de código al riesgo: una pasada rápida en cambios rutinarios, una profunda que si se pierde un error es costoso (Rápido, Estándar o Profundo en la Revisión de Código).
- Rondas de revisión de capítulos; después de las primeras unas, se revisa nuevamente solo el nuevo dif.
Aprobación
- Escriba los niveles de riesgo, definidos por el cambio en lugar del autor; comience estricto y suavice las condiciones con evidencia.
- Mantenga las rutas de aprobación más ligeras para los autores en quienes confía.
- Utilice CODEOWNERS y la protección de rama para que los flujos de trabajo de autenticación, facturación, CI y lanzamiento, así como los instaladores, siempre necesiten una persona.
- Nunca permita que la aprobación de un bot sustituya a la aprobación necesaria de un ser humano; rechace las aprobaciones en nuevos commits.
Unir y después
- Usar una cola de fusión, banderas de característica, uso interno primero, lanzamientos en etapas y un despliegue de rollback de un paso.
- Convierta los incidentes y los cambios en un conjunto de evaluaciones, y vuelva a calcular el puntaje del revisor cada vez que sus prompts, herramientas o modelo cambien.
- Mide el tiempo humano, con las tasas de revertir y incidentes como barrera.
DÓNDE VA ESTO
El anuncio de Code Review indicó que aprobar una solicitud de pull request sigue siendo una decisión humana; el producto publica hallazgos, no aprobaciones. Nuestros propios repositorios van más allá, permitiendo a los dueños decidir qué cambios de bajo riesgo se fusionan únicamente con las verificaciones automáticas, y esa línea sigue evolucionando.
Cuando una revisión omite algo, preguntamos qué era lo que el modelo no tenía frente a él y ponemos la solución en un CLAUDE.md, una habilidad o un nuevo control. El objetivo no ha cambiado: menos tiempo humano por cambio, y sin más revertes que antes.
Si su equipo permite que los agentes abran pull requests, nos gustaría saber qué verificaciones han automatizado, qué todavía necesitan una persona, y qué cree que hay de incorrecto.
Gracias a Emma Webb, Michael Segner y Amie Rotherham por sus reseñas.