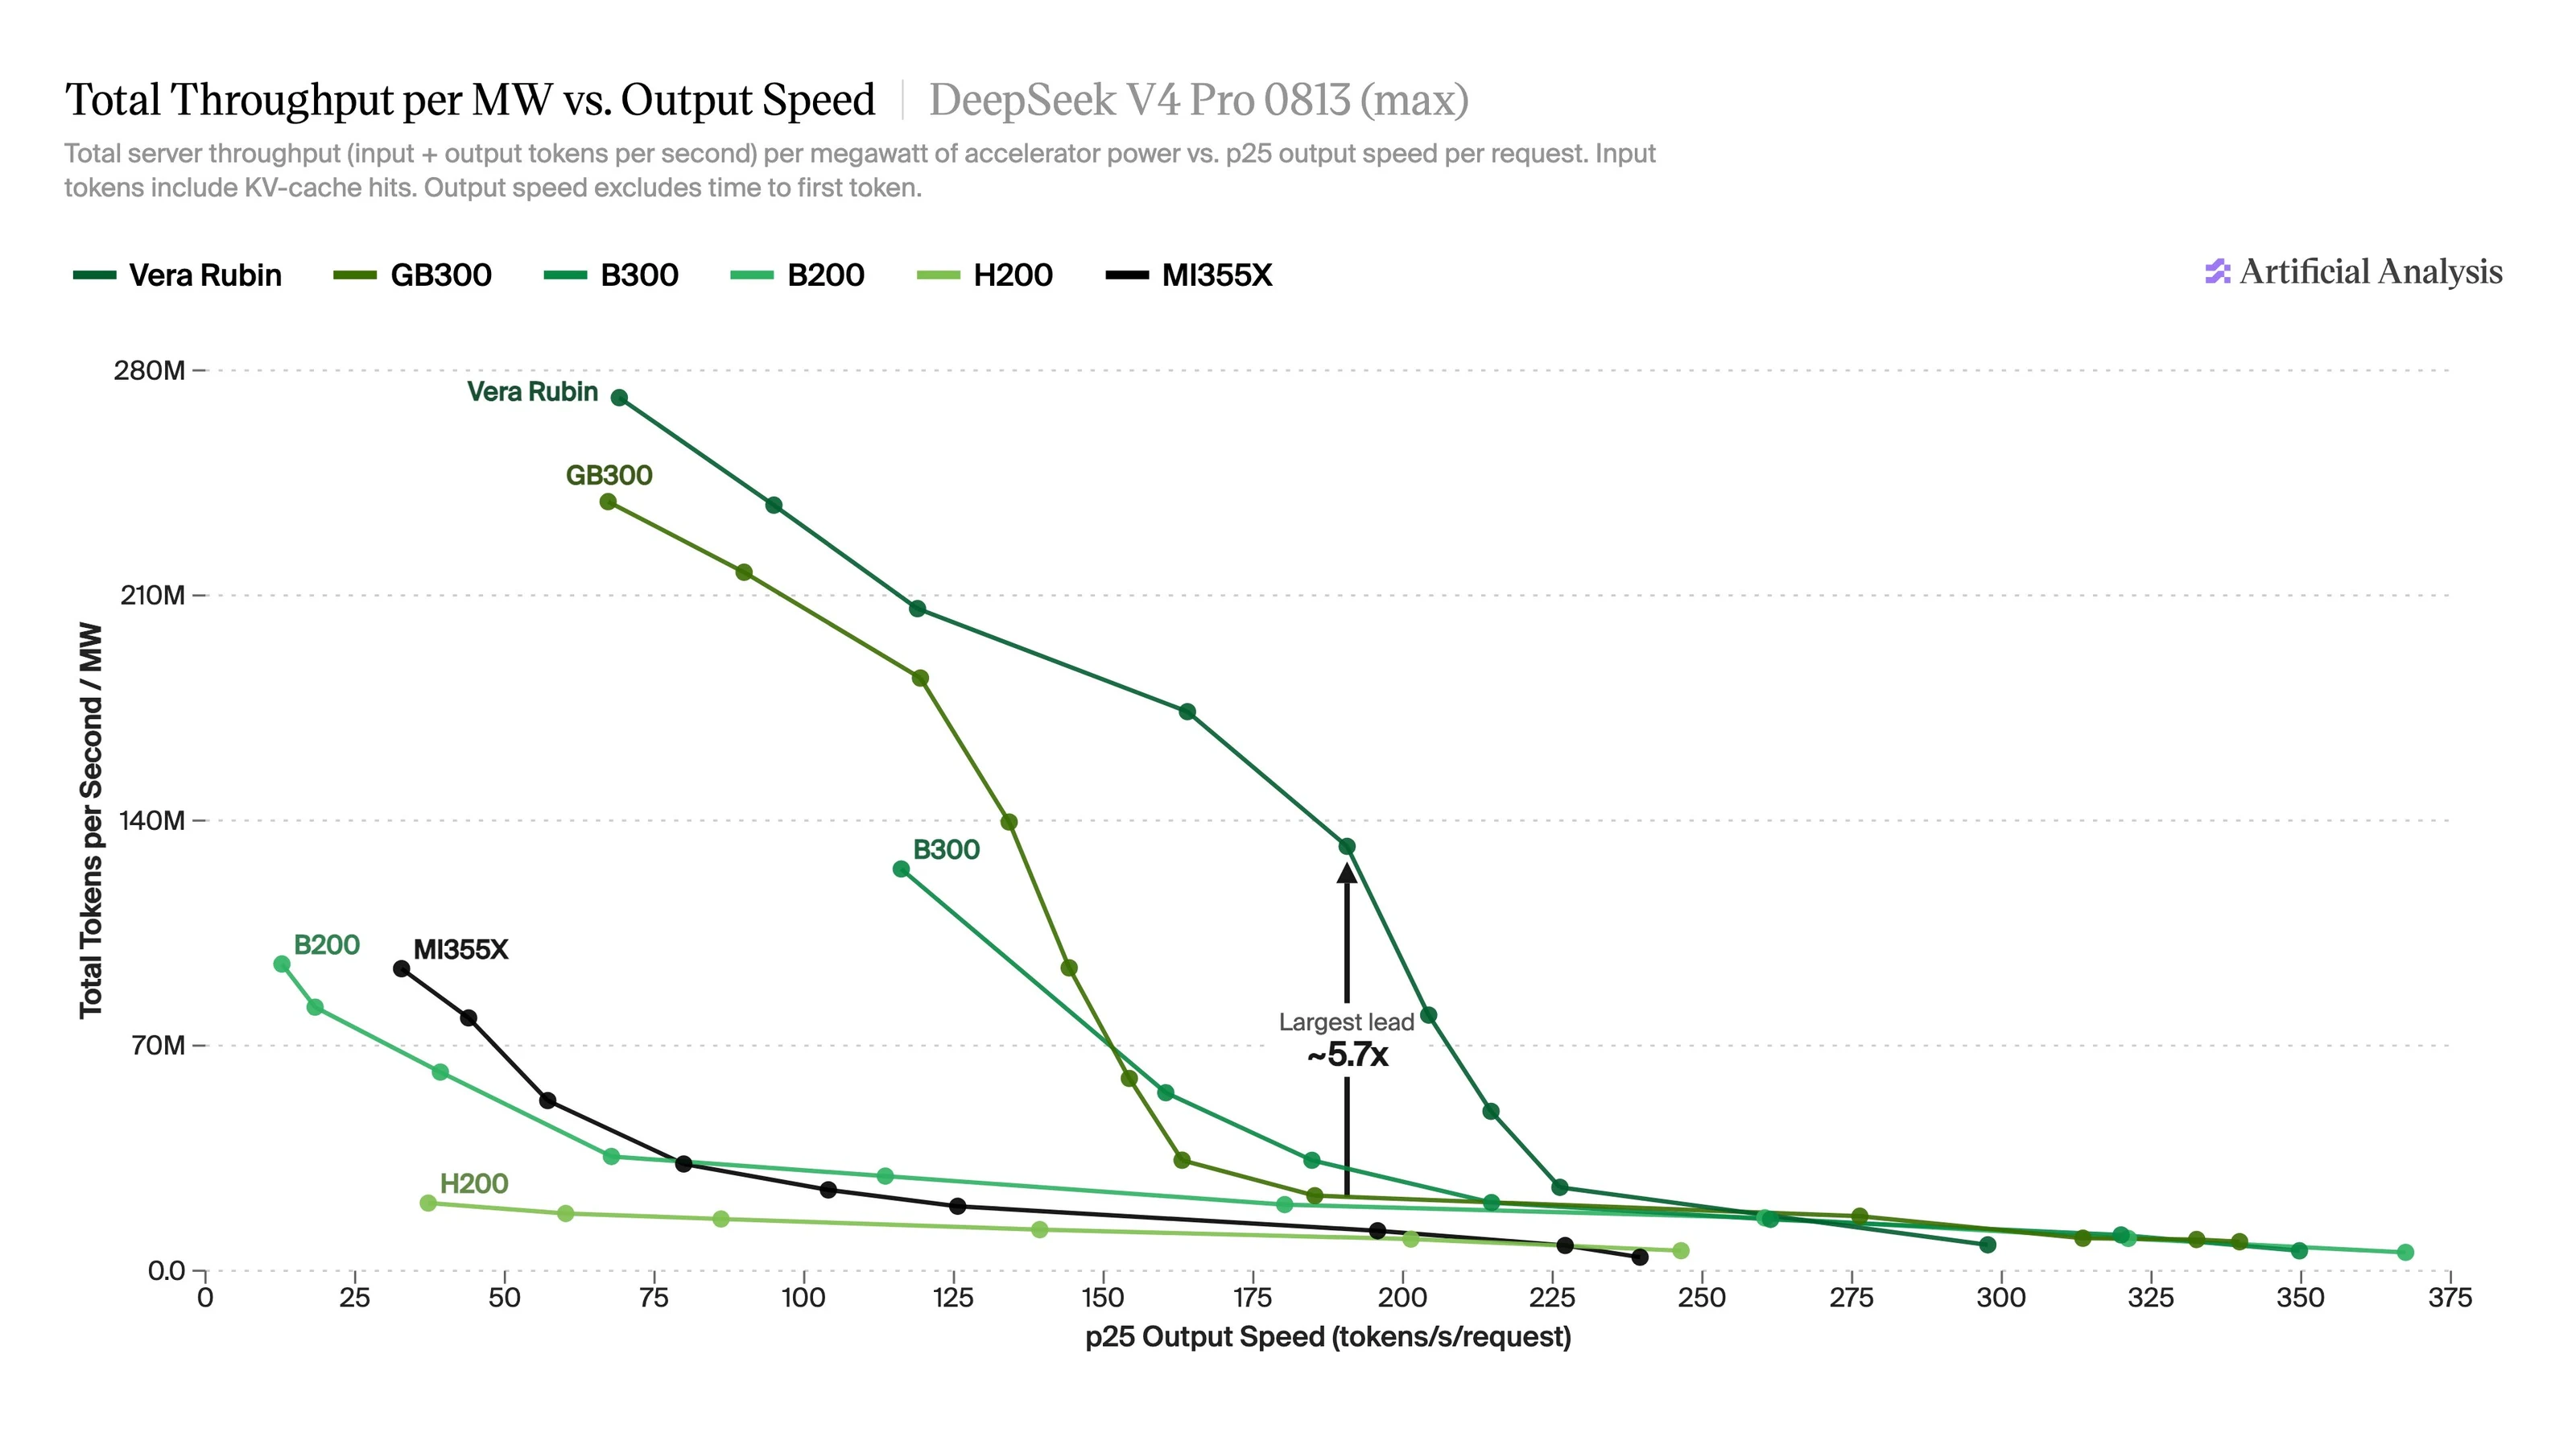
Los resultados iniciales para el Vera Rubin NVL72 de NVIDIA están ahora disponibles en AA-AgentPerf, con un rendimiento de hasta ~5.7 veces el rendimiento total por megavatio de su predecesor GB300 NVL72 en DeepSeek V4 Pro, ~5.4 veces en DeepSeek V4.1 Flash, ~3.0 veces en GLM-5.2 y ~2.8 veces en Kimi K3
Vera Rubin es la sucesora de Blackwell en NVIDIA, y Vera Rubin NVL72 es su sistema a escala de rack, con 72 GPU Rubin y 36 CPUs Vera. Cada GPU Rubin tiene el mismo volumen de memoria de 288 GB que Blackwell Ultra, pero 2.4 veces más ancho de banda de memoria, 1.7 veces más ancho de banda de NVLink y 2.3 veces más cálculo con NVFP4 denso. NVIDIA presentó todos los resultados de Vera Rubin, ejecutando TensorRT-LLM y vLLM con NVIDIA Dynamo.
AA-AgentPerf es nuestro benchmark de rendimiento de inferencia agente. Reproduce sesiones reales de codificación agente, incluyendo contextos almacenados prolongados y demoras en llamadas a herramientas, para proporcionar una medida realista del rendimiento de inferencia en los trabajos diarios de los agentes. Medimos el rendimiento total del sistema por megavatios de potencia de la GPU medida, y la velocidad de salida por agente (p25 entre solicitudes) a diferentes niveles de concurrencia, para mostrar el equilibrio entre el uso del sistema y la experiencia de usuario individual.
Resultados iniciales:
➤ El plomo de Vera Rubin es el más grande en velocidades más rápidas por usuario, donde el rendimiento de GB300 disminuye. En DeepSeek V4 Pro, pasar de ~120 a ~165 tok/s por usuario cuesta a GB300 el 81% de su rendimiento por MW, en comparación con el 16% de Vera Rubin
➤ En el punto de rendimiento máximo, ambos son más cercanos: en DeepSeek V4 Pro, Vera Rubin alcanza 272M tokens/s por MW, frente a 239M en GB300 (1.14x); 571M frente a 395M en DeepSeek V4.1 Flash (1.45x); 272M frente a 201M en GLM-5.2 (1.35x) y 70M frente a 56M en Kimi K3 (1.26x). Esperamos que la diferencia entre los sistemas aumente a medida que los kernels de Vera Rubin y otros software de servicio se optimicen.
➤ Vera Rubin establece las velocidades más rápidas por usuario en nuestro tablero para DeepSeek V4.1 Flash (906 tok/s, el resultado más rápido para cualquier modelo), GLM-5.2 (408 tok/s) y Kimi K3 (255 tok/s)
Felicidades @nvidia por los sólidos resultados.
Lea el análisis completo: https://artificialanalysis.ai/articles/vera-rubin-nvl72-agentperf