
Dentro de los esfuerzos de optimización de Kimi K3: comprender los cuellos de botella y las decisiones que hicieron que la inferencia sea más rápida
En este artículo- AgentX: el trabajo de carga y los resultados
- Dentro de Kimi K3: expertos, atención y estado recurrente
- 1. Caché: mantener el estado de la conversación disponible para reutilización
- 2. MoE: eliminar trabajo duplicado entre GPUs
- 3. Tráfico de memoria: operaciones de fusión y eliminación de copias innecesarias
- 4. MLA: decodificación más rápida de contexto largo con la asignación AMD AITER
- 5. KDA: paralelizar el preenganche y la verificación especulativa
- 6. Decodificación especulativa: elegir cuántos tokens redactar
- Qué optimizar a continuación
- Contribuciones y agradecimientos
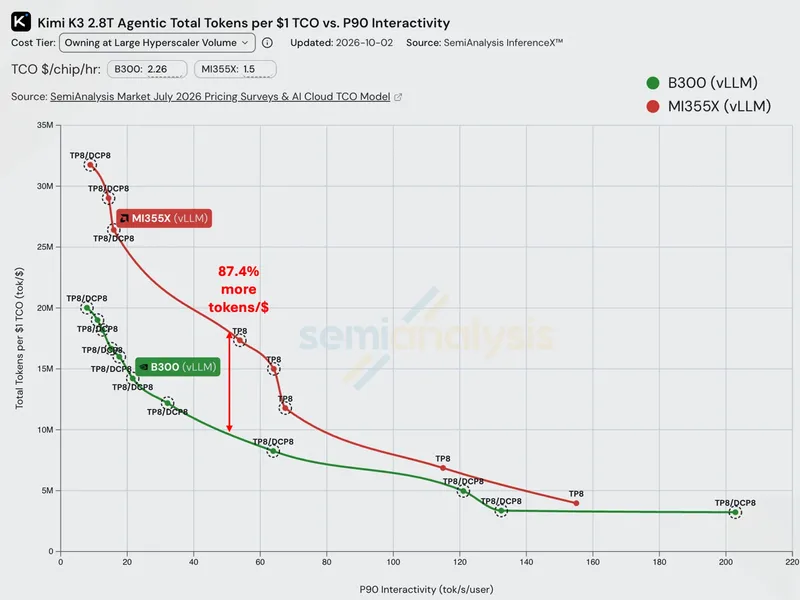
En AgentX, un sistema de ocho GPUs AMD Instinct MI355X que sirve a Kimi K3 con vLLM ofrece 24.4% más tokens totales por segundo por GPU que el NVIDIA HGX B300 con 50 tokens/s/user de interacción P90. Bajo el modelo de costo de propiedad del benchmark, ofrece 87.4% más tokens por dólar.
En este artículo, desglosaremos la ingeniería detrás de Kimi K3 en AMD Instinct MI355X, conectando las decisiones de servicio de vLLM con los kernels de GPU y el hardware subyacente. Explicaremos por qué las optimizaciones funcionaron y desarrollaremos la intuición necesaria para detectar trabajo innecesario, identificar cuellos de botella y encontrar la siguiente optimización en su propia pila de inferencia.
La interactividad es recíproca en la latencia entre tokens de la respuesta P90 y excluye el tiempo hasta el primer token. Los tokens totales incluyen el input reutilizado y el output generado.
Fuente: SemiAnalysis InferenceX, snapshot del 9 de octubre de 2026. Configuraciones de comparación.
Los picos de matriz densa publicados son 10.1 PFLOP/s MXFP4 para el AMD Instinct MI355X y 13.5 PFLOP/s FP4 para el NVIDIA B300. Ambos tienen 288 GB de HBM3E y un ancho de banda de memoria de pico de 8 TB/s. Al alcanzar este rendimiento de servicio, se refleja la ingeniería de software sostenida por AMD y sus colaboradores en toda la comunidad vLLM.
AgentX: el carga de trabajo y los resultados
El benchmark público AgentX reproduce los rastros de sesiones de agentes de codificación reales con tokens sintéticos, manteniendo las longitudes de solicitud, el tiempo y los patrones de compartición de prefijos. La carga de trabajo ofrece más del 96% de reutilización teórica de prefijos con un caché ilimitado. Las ejecuciones especulativas utilizan una referencia de aceptación sintética fija.
En 50 tokens/s/user P90 interactividad, AMD Instinct MI355X genera aproximadamente 7,567 tokens/s/GPU, en comparación con 6,083 para NVIDIA HGX B300, lo que representa una ventaja de rendimiento del 24.4%. Utilizando el TCO modelado por SemiAnalysis, de $1.50 frente a $2.26 por GPU-hour, esto se traduce en 18.16 millones frente a 9.69 millones de tokens totales por dólar de TCO: 87.4% más tokens por dólar.
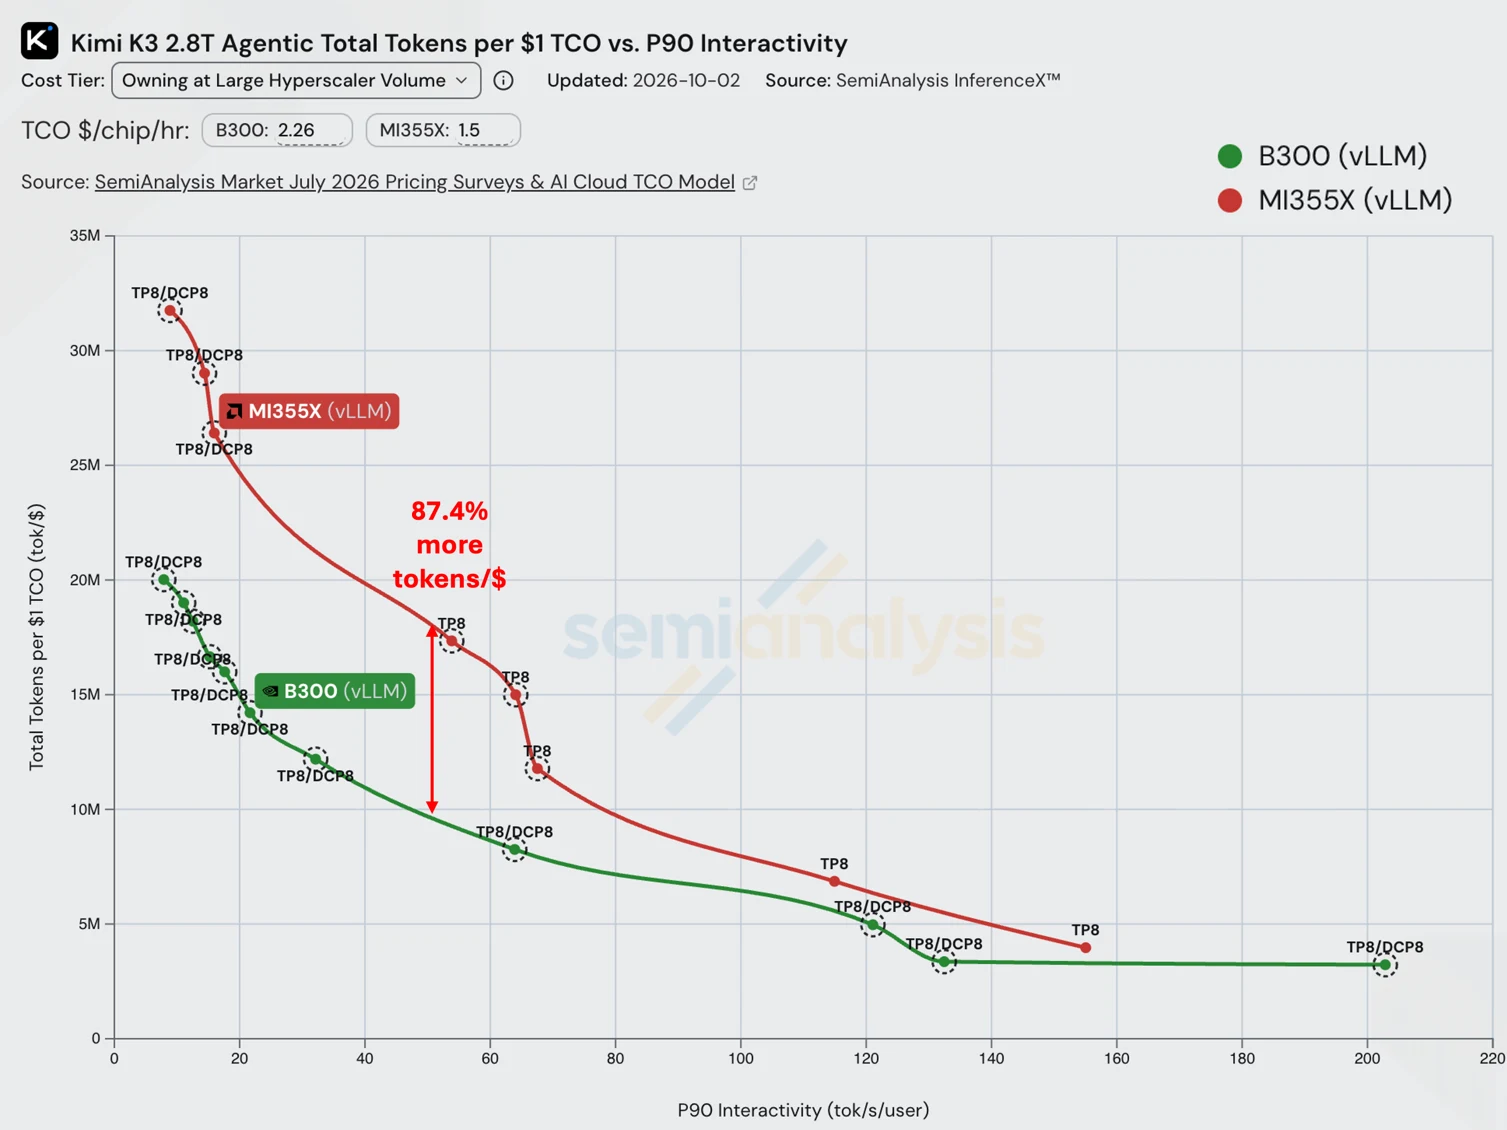
SemiAnalysis InferenceX curvas públicas, con el objetivo de 50 tokens/s/user anotado. Notas de benchmark.
Las curvas públicas comparan las estructuras completas de servicio. Las mediciones junto a cada optimización provienen de pruebas separadas y explican los mecanismos individuales bajo sus configuraciones indicadas.
Dentro de Kimi K3: expertos, atención y estado recurrente
Un giro de agente que regresa puede reutilizar la mayor parte de su prefijo, pero el procesamiento de una continuación corta sigue involucrando tres tipos de datos.
Kimi K3 utiliza dos tipos de atención. Sus 24 capas MLA conservan un historial comprimido de KV que crece con la conversación. Una nueva consulta sigue consultando ese historial. En cambio, sus 69 capas KDA transportan matrices de estado con dimensiones fijas, las cuales se actualizan a medida que llegan nuevos tokens. Configuración del modelo.
En las capas MoE, un router selecciona redes expertas para transformar cada token. Sus pesos se comparten entre las solicitudes.
MLA conserva más historial a medida que crece la conversación. KDA actualiza un estado de dimensión fija; conservar los puntos de control anteriores significa mantener copias adicionales de ese estado.
Entre giros: reutilización de caché y descarga (Sección 1).
Dentro de un paso del modelo: proyecciones de expertos, transferencias de kernel y programación de MLA/KDA (Secciones 2–5).
Elegir la profundidad del borrador: salida comprometida frente al costo total del ciclo (Sección 6).
1. Caché: mantener el estado de la conversación disponible para reutilización
DCP reduce las historias duplicadas en la memoria del GPU; el descargado de la CPU preserva el estado reutilizable fuera de ella.
DCP: compartir la historia entre las GPU
Bajo TP8, cada GPU maneja 12 de las 96 cabezas de consulta MLA de Kimi K3, pero almacena toda la historia comprimida de KV. El paralelismo de tensores divide las cabezas sin dividir el caché.
Con el paralelismo de contexto de decodificación de ocho maneras (DCP8), cada GPU almacena una octava parte de las posiciones en caché. Durante la decodificación, las GPUs intercambian consultas, calculan basándose en su historial local y fusionan sus respuestas parciales.
Dos GPU ilustan la misma partición utilizada por TP8/DCP8. Esta división adicional aplica a la historia de MLA; el estado de KDA mantiene su partición existente entre las cabezas.
Cada respuesta parcial contiene información de normalización, de modo que la fusión pueda ponderar los fragmentos correctamente. #51705 extiende el camino DCP de AITER en ROCm a la verificación de múltiples tokens.
Para una conversación de 142,000 tokens, el cargamento estimado de MLA es 24 capas × 142,000 posiciones × 576 bytes FP8 ≈ 1.96 GB por GPU. DCP8 reduce esto a aproximadamente 245 MB, antes del sobrecosto de asignación. Cada GPU procesa ocho veces más cabezas frente a una octava parte de la historia, dejando la aritmética de atención principal prácticamente sin cambios.
Descarga de CPU: mantener el estado que ya no cabe en HBM
Cuando el estado ya no cabe en la memoria del GPU, la descarga de CPU nativa de vLLM del receta de AMD preserva el historial de MLA y los puntajes de KDA en la DRAM del host.
Un hit en la caché requiere puntos de resumen correspondientes. Si la historia de MLA llega al token 3,072, pero el último punto de control compatible de KDA es de 2,048, la solicitud debe comenzar desde 2,048 y recalcular el prefijo restante.
Un punto de resumen útil necesita un estado compatible en todos los capas requeridas. Las posiciones son ilustrativas.
Guardar la cola del bloque de atención junto con el punto de control KDA ajusta sus posiciones de resumen (#54736). Restaurar ese estado implica una transferencia de vuelta al GPU, lo que evita la recomputación del prefijo. Una vez que la solicitud se reanuda, sus nuevos tokens todavía pueden hacer que varias GPUs repitan el mismo cálculo.
2. MoE: eliminar trabajo duplicado entre las GPU
En un GPU, la proyección de salida de routed-expert devuelve el vector completo que su consumidor espera. En el camino original de ROCm, una reducción y normalización previas proporcionaron a los ocho GPUs la misma entrada latente, y cada una mantuvo todos los pesos. Por lo tanto, la misma proyección se realizó ocho veces.
Las coordenadas de salida pueden dividirse entre GPU, pero cada rango todavía necesita el resultado completo. Kimi K3 ya tiene un all-reduce para sus partes compartidas de experto.
Cada GPU solo añade las salidas enrutadas que posee a su parte parcial compartida de expertos. El all-reduce existente reúne el resultado completo, sin ningún nuevo conjunto (#51253). La implementación de ROCm se basa en la estrategia correspondiente de CUDA.
Dos GPU ilustran la propiedad del coordenado de salida. Ambas rutas utilizan un operador all-reduce existente y devuelven el mismo resultado completo a cada GPU.
Cada coordenada de salida recibe su contribución enrutada exactamente una vez. Los pesos de proyección completos permanecen replicados.
El rendimiento de transmisión aumentó entre el 3.05 y el 4.91 % en la prueba del PR con ocho GPU AMD Instinct MI355X en TP8, con concurrencia de 8–128 y solicitudes de entrada de 8K/1K de salida aleatorias, y sin caché de prefijo activado.
Liberar la memoria del GPU para mantener más estado en caché
Cada rango ahora calcula únicamente sus coordenadas de proyección asignadas, manteniendo los pesos completos.
Solo al cargar las filas que utiliza cada rango libera aproximadamente 3.85 GiB por GPU en 92 capas MoE en TP8 (#59591). El cálculo del camino fusionado sigue igual; el espacio adicional puede albergar la historia MLA y los puntos de control KDA.
Esta cambio se produjo después de que la imagen utilizada para el título se publicara. El experimento independiente de AgentX reveló un menos del 1% más alto rendimiento en concurrencia 32 y 48, pero un 28.9% en concurrencia 70, donde la tasa de hitos de caché del prefijo aumentó de 74.8% a 80.1%.
Separar #59591 mediciones: ocho GPUs AMD Instinct MI355X, TP8/DCP8, FP8 KV, ejecuciones de 30 minutos, sin descarga de CPU ni decodificación especulativa. Los puntos muestran las ejecuciones reportadas; la incertidumbre de las ejecuciones repetidas no se reportó.
La mayor ganancia en alta concurrencia es consistente con la presión del caché. Comparar ambas implementaciones con una capacidad de caché igual ayudaría a aislar ese efecto.
Más sobre ruteo experto y activaciones de cuatro bits.
3. Tráfico de memoria: fusionar operaciones y eliminar copias innecesarias
Dentro de cada GPU, el siguiente lugar a investigar son los datos que se pasan entre los kernels.
El camino de KDA con un solo token de Kimi K3 ejecutó tres kernels de computación y dos copias de salida. La convolución se realizó antes de un kernel que ya había fusionado la normalización Q/K, el decaimiento y las puertas beta, así como la actualización recurrente; la normalización de salida se realizó después. El camino de HIP fusionado ejecuta estas operaciones en una sola iniciación y escribe directamente en el buffer de destino (#50654).
Los intercambios intermedios permanecen en la chip. La historia de la convolución y el estado recurrente siguen llegando a la memoria del GPU para el siguiente token.
Decodificación de KDA único-token, no especulativa, en #50654. Antes se utiliza la ruta de normalización fusionada de Triton. Los conteos siguen el código fuente; las proyecciones están fuera de la vista. Las lecturas y escrituras del estado guardado permanecen.
AttnRes mezcla los resultados de los bloques de capa anteriores con el residuo en curso. Al combinar esa mezcla con RMSNorm, la mezcla temporal se mantiene en los registros (#50593). El residuo en curso guardado para capas posteriores conserva su redondeo BF16; la mezcla se mantiene en FP32 durante la normalización. Las pruebas requieren actualizaciones persistentes exactas y permiten tolerancias numéricas para el resultado normalizado.
Con la fusión de AttnRes, el rendimiento de transferencia aumentó en un 14.2% en ocho GPU AMD Instinct MI355X en TP8, con 100K peticiones de entrada/1K peticiones de salida y sin activado el caché de prefijo. La latencia de llenado prolongado permaneció prácticamente sin cambios.
Copie los datos solo para los kernels que los utilizan
El despachador de multiplicación matricial ROCm empacaba los datos antes de elegir un kernel. Cuando seleccionaba el fallback, ese kernel leía el dato original y dejaba la copia sin usar. Mover el empacado a las ramas especializadas eliminó estas copias (#58566).
El perfil hizo que el desecho fuera visible: 69 copias innecesarias por paso de decodificación, una por capa de KDA. Cada uno movió solo 1,792 bytes, pero tardó aproximadamente 4.8 microsegundos. Mover esos bytes más rápido apenas ayudaría; la sobrecarga de lanzamiento era dominante.
En el PR de TP8, concurrencia-uno, seis borradores, perfil de 384K-context, las copias eliminadas representan 0.339 ms de tiempo del kernel de copia por paso.
4. MLA: decodificación más rápida de contexto largo con ensamblaje AMD AITER
El Kimi K3 tiene doce cabezas de consulta por GPU en TP8. El añadido de dieciséis permitió que el camino de decodificación de la asignación de AMD AITER estuviera disponible. En el test de contexto largo reportado, el tiempo por token de salida disminuyó de 43.8 a 23.6 milisegundos.
La comparación utilizó TP8 sin DCP, en concurrencia uno. El adaptador en #50578 copia cuatro cabezas de consulta, las empaca en el diseño de dieciséis cabezas y descarta sus salidas. DCP8 presenta una forma diferente, de 96 cabezas.
Esto preserva el funcionamiento del modelo, ya que cada cabezal de consulta opera independientemente sobre las posiciones en cache. Añadir otro cabezal no cambia el softmax del cabezal original. Solo la consulta se rellena en este camino de decodificación; la historia comprimida de KV almacenada mantiene el mismo tamaño.
Una conversación larga requiere mucha atención, pero ese trabajo debe distribuirse en el GPU. En el código histórico que inspeccionamos, un enfoque conservador indicación de programación Restringió el camino de Gluon Un grupo de trabajo por solicitudEse grupo de trabajo todavía procesaba toda la conversación. El relleno permitió que el camino de ensamblaje de AMD AITER estuviera disponible, con un política diferente Para dividir la historia en partes paralelas y combinar los resultados.
Las particiones de historia son trabajos asignados a grupos de trabajo dentro de un GPU. Se muestran cuatro para ilustración; la política de ensamblaje inspeccionada seleccionó dieciséis. El almacenamiento KV no ha cambiado.
| Tokens de entrada / salida | Camino original de Gluon | Camino de ensamblaje relleno |
|---|---|---|
| 1K / 1K | 22.9 ms/token | 22.8 ms/token |
| 32K / 1K | 43.8 ms/token | 23.6 ms/token |
Tiempo medio reportado por PR para cada token de salida: ocho GPU AMD Instinct MI355X, TP8, concurrencia uno, pesos del modelo MXFP4, atención BF16 y decodificación ordinaria de un solo token.
El caso de entrada corta apenas cambia; el caso de entrada larga reduce casi a la mitad el tiempo por token de salida. Estas medidas de servicio incluyen la preparación de consultas y el manejo de la salida.
5. KDA: paralelizar el prellenado y la verificación especulativa
MLA puede dividir una historia conservada entre los grupos de trabajo. KDA presenta un problema de programación más difícil: cada token depende del estado anterior. El relleno fusionado en #54038 prepara la transformación combinada de cada grupo de tokens antes de que se conozca su estado futuro.
Por ejemplo, “dividir la estado por dos y añadir dos”, luego “dividirlo por dos y añadir uno”, se combinan en “tomar un cuarto del estado inicial y añadir dos”. Esta regla puede calcularse antes de que llegue el estado inicial.
KDA hace esto mediante transformaciones matriciales. Una escaneo ordenado de los resúmenes del grupo determina el estado inicial de cada grupo; posteriormente, los grupos vuelven a reproducir sus tokens de forma paralela. El orden de los tokens se mantiene intacto, pero cada grupo ya no espera la reproducción del grupo anterior.
El agrupamiento añade un segundo recorrido y amplía el camino del trozo fusionado de dos lanzamientos a cuatro. Ayuda cuando pocas secuencias o cabezas exponen muy poco trabajo paralelo; de lo contrario, las pasadas adicionales pueden costar más de lo que se gana.
Dentro de cada grupo, el caminar recurrente mantiene el estado en los registros del acumulador de matriz entre los bloques, evitando una escritura y relojización en la memoria global. Diagrama de almacenamiento de estado.
Fused KDA proporcionó un 5.3–5.6% más de rendimiento de flujo de entrada que Triton en longitudes de entrada de 4K y 16K, en una comparación independiente de tres backend: ocho GPUs AMD Instinct MI355X, TP8, concurrencia 32, caché de prefijo deshabilitado y salidas de un token. Esto mide el backend completo. Resultados del benchmark.
Usa azulejos más pequeños para la verificación especulativa
Los lotes de verificación cortos necesitan una división diferente. En TP8, cada GPU tiene 12 KDA heads con 128 columnas de valor. Dividir cada head en cuatro tiles de 32 columnas permite solo 48 grupos de trabajo sobre 256 unidades de cálculo. #58045 pasa a tiles de cuatro columnas, aumentando el número a 384.
Cada azulejo posee columnas de valor diferentes y recorre la misma secuencia de tokens en orden. Los azulejos más pequeños aumentan el número de grupos de trabajo independientes de 48 a 384.
En una prueba independiente de kernel de repetición de gráficos en una GPU AMD Instinct MI355X (dimensiones TP8, una secuencia, cuatro posiciones de verificación), el tiempo disminuyó de 16.20 a 5.61 microsegundos por capa (2.89×). Esto incluye azulejos más estrechos, grupos de trabajo de onda única, especialización de longitud uniforme y trabajo con invariantes de tokens levantados. Los lotes irregulares mantienen un camino dinámico; las pruebas comparan los resultados y el estado recurrente.
6. Decodificación especulativa: elegir cuántos tokens redactar
La verificación más rápida puede cambiar la cantidad de tokens de borrador que deben ser verificados. La tasa útil es el resultado comprometido dividido por el tiempo total del ciclo de borrador–verificación–compromiso.
Por ejemplo, la referencia de aceptación fija de AgentX indica que se esperan 3.00 tokens comprometidos por ciclo con tres borradores, y 3.36 con cuatro, incluyendo el token de recuperación o bono. Es decir, hay un 12% más de salida comprometida por ciclo. Cuatro borradores mejoran el rendimiento solo si el ciclo completo dura menos del 12% en comparación con tres borradores.
Comparación ilustrativa bajo la referencia de aceptación controlada. El umbral del 12% es un presupuesto de costos; el crecimiento completo del ciclo no se midió aquí.
receta pública de AMD utiliza de tres a siete borradores con DCP1 y desactiva la especulación en las configuraciones de concurrencia más altas de DCP8.
¿Qué optimizar a continuación?
El trabajo en curso de relleno/descodificación y desagregación añade otro punto a investigar: el equilibrio de los trabajadores y si las transferencias se completan antes de que se necesiten sus datos.
Para otro modelo o carga de trabajo, comience con las formas de solicitud desplegadas y realice tres comprobaciones:
Comparar los rangos. ¿Son varias GPUs calculando el mismo resultado antes de que un grupo pueda procesarlo juntos?
Siga los búferes. ¿Cada tensores temporal tiene un consumidor en el camino seleccionado? ¿Pueden los datos permanecer en el chip?
Cuenta el trabajo independiente. ¿Los cabezas, tokens y azulejos reales generan suficientes grupos de trabajo para distribuir la carga?
Mide la solicitud completa a la velocidad de respuesta que necesita, y verifica ambos resultados y el estado guardado. Un núcleo más rápido es útil cuando acorta el trabajo que impide el siguiente token.
Contribuciones y agradecimientos
El esfuerzo de Kimi K3 abarca más de 50 PRs relacionados con AMD/ROCm fusionados vLLM de AMD, Embedded LLM y la comunidad en general, además del desarrollo, integración, revisión y benchmarking de AITER. Las contribuciones abarcan atención, recurrencia, MoE, cuantización, ejecución de grafos, soporte para caché e integración de plataforma.
Agradecimientos especiales a: Pin Siang Tan, Jun Kang Chow, Ye Hur Cheong, Hongxia Yang, Seungrok Jung, Bill He, Yichao Zhu, Hyukjoon Lee, Andy Luo, Mrinal Karvir, Richard Li, Sun Peng
Andy Friedrich, Ethan Yang, Tang Rui, Andreas Karatzas, Ankur Singh, Yihua Cheng, Badr Ba Sowid, Benjamin Chislett, Taoyu Zhu, Bill He, Bin Ding, Bowen Bao, Brandon Zhang, Chaemin Lim, Charles Wu, Chuan (Richard) Li, Felix Li, Cameron Quilici, Weishu Deng, Dewei Wang, Divakar Verma, Douglas Lehr, Edwin Lim, Yudong Pan, Elvir Crnčević, Fang Che, Fangzhou Ai, Xingran Fan, Fulu Li, Felix Marty, Canlin Guo, Summer Yang, Haichen Zhang, Yufeng He, Él Liu, Hongxia Yang, Hyukjoon Lee, Yifan Qiao, James E T Smith, Jiahui Cao, Yanyuan Qin, Jonathan Chen, Juntian Liu, Shao-Chun Lee, Kedar Potdar, Kevin H. Luu, Kuan-Fu Liu, Kuntai Du, Kyle Sayers, @lalala-sh, @linnea-lin-00638949, Yinfeng Liu, Lucas Wilkinson, Gabriel Wu, Markus Hartikainen, Maithili Joshi, Jeff (Junze) Ma, Matthew Wong, Misha Goin, Micah Williamson, @minmengdie, Matvei Pashkovskii, Mathews Neha, Nicolò Lucchesi, Nick Hill, Nicholas Susanto, Oxana Korzh, Pei Zhang, @ppalanga, Peiran Qin, Qiuyang Yue, Rita Brugarolas, Rebecca Lee, Ryan Rock, Rohan Potdar, @Saddss, Samuel Shen, Sean Filimon, Seungrok Jung, Shantipriya Parida, Shanshan Shen, Shengnan Xu, Simon Danielsson, Siraj Shaikh, Stacy Roberts, Stefan Koncarevic, Asan Stefanski, Minghui Jiang, Tarık Saraç, Tun Jian Tan, Lingpeng Jin, Vansh Bhatia, Maksim Vedenev, Ye Hur Cheong, @wenwzhan, Wei Zhao, Xavier Aguilar, Xiaobing Zhang, Xiaohu Guo, Xin Li, Xudong Lyu, Yanxue Ren, Wentao Ye, Yongqin Wang, Riggins Chen, Chao Hong, Yuchen Shen, Matt Qin, Yichao Zhu, Roger Wang, Zheng Gong, Jiangyun Zhu, Zvi Grinberg, Yongye Zhu.
Notas de benchmark
Configuraciones de servicio en los objetivos de comparación
| Interactividad P90 (tokens/s/user) | AMD Instinct MI355X | NVIDIA HGX B300 |
|---|---|---|
| 30 y 50 | Descarga de SimpleCPU; DCP8 / sin borradores a DCP1 / tres borradores | Mooncake offload; DCP8 |
| 150 | Solo GPU; DCP1; cinco a siete borradores | Mooncake offload; DCP8 |
Ambos sistemas utilizan ocho GPUs, pesos TP8, FP4 y FP8 KV. Los valores se interpolan dentro de cada serie publicada de descarga o solo para GPU, en función de la interactividad correspondiente; la concurrencia, el DCP y la profundidad del borrador pueden variar entre las ejecuciones de bracketing. Las recetas de AMD (YAML) y lanzador de NVIDIA proporcionan las etiquetas de imagen y las configuraciones completas.
Replay utiliza el cc-traces-weka-062126 dataset y un AIPerf harness en modo pinned, con el warmup excluido y una hora de profiling bajo curvas de aceptación sintéticas fijas. Las recetas indican los ajustes de semilla, inicio de sesión y warmup. La revisión del dataset descargado no está registrada. El replay de bucle cerrado puede generar diferentes mezclas de solicitudes completadas.
Software y descarga. Las entregas utilizan vLLM 36768d1bf (AMD) y 5894fdf98 (NVIDIA). Los presupuestos de caché del host configurados son 224.875 y 281 GB por GPU, respectivamente; las configuraciones de conector y imagen se encuentran en las recetas vinculadas.
Costos. El modelo de propiedad del gran supercomputador y constantes de costo de GPU publicados utilizan $1.50 por hora de GPU para el AMD Instinct MI355X y $2.26 para el NVIDIA HGX B300. Total tokens/$ = total tokens/s/GPU × 3,600 ÷ $/hora de GPU modelado. Algunas suposiciones de capital y utilización permanecen sin publicar. En el objetivo de interactividad de 50 tokens, la comparación muestra un costo modelado 46.6% más bajo por token.
Snapshot. Datos de SemiAnalysis InferenceX obtenidos el 9 de octubre de 2026; entregas fechadas el 30 de septiembre de 2026 (AMD) y el 16 de agosto de 2026 (NVIDIA). Los benchmarks de PR utilizan sus cargas de trabajo indicados; #59591 es un experimento independiente después de la imagen principal.
| Especificación publicada, por GPU | AMD Instinct MI355X | GPU NVIDIA B300 |
|---|---|---|
| Pico de matriz de baja precisión densa | 10.1 PFLOP/s MXFP4 | 13.5 PFLOP/s FP4 |
| Memoria de GPU | 288 GB HBM3E | 288 GB HBM3E |
| Ancho de banda de memoria máximo | 8 TB/s | 8 TB/s |
Fuentes: AMD Instinct MI355X, NVIDIA HGX B300, Especificaciones de memoria de NVIDIA. Detalles del benchmark: Metodología AgentX.
Nota técnica: enrutamiento experto y precisión
Kimi K3 selecciona 16 de los 896 expertos por token, por lo que un lote considerable de servidores todavía puede dejar pocas filas por experto. Las piezas de expertos resultantes pueden contener relleno.
A4W4 reduce otra parte del tráfico: la integración en #53940 cambia las activaciones de ocho bits a cuatro, mientras que los pesos permanecen en cuatro bits. El tráfico total también incluye salidas intermedias BF16 y relleno de expert-tile.
Nota técnica: Precisión del KDA y memoria on-chip
Cada fragmento aún necesita resolver las dependencias entre sus tokens. El núcleo los combina en una transformación que posteriormente los productos de matriz pueden aplicar. Esto genera dos preguntas prácticas: ¿qué precisión preserva la respuesta, y ¿cuánto datos temporales cabe en el chip?
Un pequeño ejemplo muestra la idea. Sustituya las correcciones anteriores por las posteriores, y cada respuesta puede expresarse directamente en términos de los datos conocidos. La tabla de coeficientes resultante ya tiene en cuenta la cadena de dependencias:
En esta ilustración escalar, el efecto de la posición uno sobre la posición tres tiene dos caminos: directamente, −1/8; a través de la posición dos, (−1/4) × (−1/4) = 1/16. Juntas, dan −1/16, la entrada en la esquina inferior izquierda de la tabla. Los ceros por encima de la diagonal reflejan que las posiciones posteriores no pueden afectar a las anteriores.
El prólogo real calcula el inverso de la matriz de dependencia dentro del bloque de 64×64. Más tarde, los productos de la matriz utilizan esta transformación para tener en cuenta esas dependencias.
Los valores intermedios del inverso pueden crecer y cancelarse. Redondearlos demasiado pronto pierde información que el resultado final necesita. La implementación utiliza las instrucciones de matriz FP32 nativas de AMD, manteniendo las entradas en FP32 y la acumulación para el inverso sensible. Solo el inverso completado se redondea a BF16 para los productos posteriores. Implementación del kernel.
¿Por qué la acumulación de FP32 no puede recuperar entradas redondeadas?
Considere restar 256 de 256.5. Ambos valores de entrada son exactos en FP32. A esta magnitud, al convertir 256.5 a BF16, se redondea a 256:
| Precisión de entrada | Resta realizada en FP32 | Resultado |
|---|---|---|
| Mantenga los entradas originales de FP32 | 256.5 − 256 | 0.5 |
| Redondee los entradas a BF16 primero | 256 − 256 | 0 |
La sustracción en FP32 no puede recuperar la información perdida antes de iniciarse. Estos valores típicos ilustran por qué el inverso utiliza instrucciones de matriz FP32 nativas de 16×16×4, manteniendo tanto la precisión de la entrada como la de la acumulación.
Un modelo FP4 también depende de operaciones con mayor precisión. Su rendimiento depende de hacer que esos caminos numéricos sean eficientes.
El prólogo también tiene un presupuesto de memoria local. AMD denomina a su almacenamiento compartido en el chip LDS. Los azulejos Q y K reutilizan el almacenamiento porque se necesitan en momentos diferentes; la entrada triangular solo almacena sus diez bloques ocupados de 16×16. El grupo de trabajo solicita 79.5 KiB, lo que se redondea a 80 KiB, la mitad del presupuesto de LDS de 160 KiB de la unidad de cálculo AMD CDNA 4 a través de su documento.
Rondas de asignación a unidades de 1,280 bytes. Los KiB adicionales ilustrados superan el umbral de residencia: dos asignaciones ya no se ajustan. Este es un cálculo de capacidad; los registros y otros recursos pueden imponer límites adicionales.
Pruebe este umbral reservando suficiente LDS no utilizado para superarlo, manteniendo el binario del kernel fijo. Si el tiempo de ejecución apenas cambia, el grupo de trabajo residencial adicional contribuyó poco para esa forma.
Estado entre bloques
Los resúmenes de grupos y los estados iniciales todavía cruzan las fronteras del kernel; los puntos de control solicitados y el estado final se guardan.
Volver al resultado de servicio del KDA.
Advertencias
La información presentada en este documento tiene únicamente fines informativos y puede contener imprecisiones técnicas, omisiones y errores tipográficos. La información contenida aquí está sujeta a cambios y puede volverse imprecisa por muchas razones, incluyendo pero no limitándose a los cambios en el producto y el roadmap, los cambios en la versión de componentes y la placa madre, las nuevas versiones de modelos y/o productos, las diferencias entre productos de diferentes fabricantes, los cambios en el software, los flashes del BIOS, las actualizaciones del firmware o similares. Cualquier sistema informático tiene riesgos de vulnerabilidades de seguridad que no pueden prevenirse ni mitigarse completamente. AMD no asume ninguna obligación de actualizar o corregir de cualquier otra manera esta información. Sin embargo, AMD se reserva el derecho de revisar esta información y de realizar cambios periódicos en su contenido sin que AMD tenga la obligación de notificar a nadie dichas revisiones o cambios. Esta información se proporciona “tal como es”. AMD no hace ninguna representación ni ofrece ninguna garantía en relación con su contenido y no asume ninguna responsabilidad por cualquier imprecisión, error o omisión que pueda aparecer en dicha información. AMD niega específicamente cualquier garantía implícita de no infracción, comercialidad o adecuación para cualquier propósito particular. EN NINGÚN CASO, AMD SERÁ RESPONSABLE ANTE CUALQUIER PERSONA POR CUALQUIER DAño directo, indirecto, especial u otro daño consecuativo que surja del uso de cualquier información contenida en este documento, incluso si AMD ha sido expresamente advertida sobre la posibilidad de tales daños. AMD, el logotipo de AMD Arrow y sus combinaciones son marcas comerciales de Advanced Micro Devices, Inc. Los nombres de otros productos utilizados en esta publicación son únicamente para fines de identificación y pueden ser marcas comerciales de sus respectivas empresas. © 2026 Advanced Micro Devices, Inc. Todos los derechos reservados.