
Datos en escritura nativa para 22 idiomas, datos romanizados para doce, y un pipeline reutilizable acelerado por GPU para traducción, evaluación de calidad y reparación.
Autores: AI4Bharat — Mohammed Safi Ur Rahman Khan, Mitesh Khapra, Anoop Kunchukuttan. NVIDIA — Niket Agarwal, Raviraj Joshi, Anusha Kamath, Markus Kliegl, Yev Meyer, Sriharsha Niverty, Kiran Praveen, Utkarsh Vaidya.
Nos complace presentar Nemotron-pretraining-Indic-v1 aproximadamente 2.8 billones de tokens en 22 idiomas de la India, que se lanzará próximamente junto con el pipeline abierto de generación de datos acelerado por GPU utilizado para crearlo. Estos son los 22 idiomas enumerados en la Constitución de la India: las primeras lenguas del 97% de los indios, es decir, casi 1.2 mil millones de ciudadanos según el Censo de 2011. Desarrollado por NVIDIA junto con IIT Madras, el principal instituto de ingeniería de la India, y su laboratorio AI4Bharat , esta publicación ofrece a los creadores de modelos un recurso nuevo y sustancial para el preentrenamiento índico. El pipeline captura la receta completa de generación, incluidos los prompts, los flujos de trabajo de LLM y los controles de calidad, de modo que los desarrolladores puedan adaptarlo a su propio material fuente y generar más datos según sus necesidades.
AI4Bharat, el laboratorio de investigación en idiomas de la India de IIT Madras, construye conjuntos de datos y modelos de código abierto para idiomas indios. Sus recursos, como Sangraha, un corpus de preentrenamiento abierto para 22 idiomas indios, han ayudado a sentar las bases de la investigación abierta en modelos de lenguaje índicos. Nuestra publicación conjunta de código abierto representa una expansión sustancial de los datos sintéticos índicos de entrenamiento que estarán disponibles para la comunidad. Aporta una amplia mezcla de material en inglés cuidadosamente seleccionado, incluidos matemáticas, código y contenido de preguntas y respuestas, a los idiomas de la India, brindando a los equipos más material de entrenamiento para construir modelos capaces de explicar conceptos técnicos, resolver problemas y responder preguntas en esos idiomas. Cada registro se remonta a un documento fuente curado, y cada salida se verifica con su entrada, de modo que el texto sintético se mantiene anclado en información real.
Mitesh Khapra, quien dirige AI4Bharat y fue incluido en la lista TIME100 AI de 2025, ha identificado el problema central: la tecnología en idiomas de la India va a la zanga del inglés porque "no tenemos suficientes datos para los idiomas indios". Respondemos a ese llamado con más datos, además de una receta abierta para generar más.
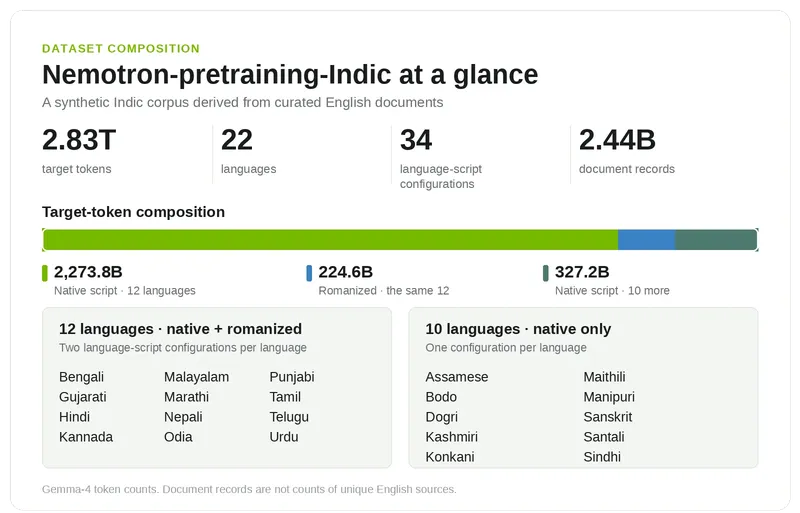
El corpus también tiene en cuenta cómo escribe la gente. Incluye datos en escritura nativa para los 22 idiomas y texto romanizado para doce, abarcando 34 configuraciones de idioma-escritura. Nuestros flujos de trabajo combinan traducción a nivel de documento, evaluación de calidad y reparación específica, con verificaciones para preservar contenido como ecuaciones, tablas y código. Estos datos complementan el texto índico escrito de forma natural, que sigue siendo esencial para el conocimiento local y el contexto cultural.
Compartimos la receta abierta de generación para que la comunidad no solo pueda reproducir los datos, sino llevar este trabajo más lejos. Los equipos pueden usar el corpus directamente, adaptar los prompts y los controles de calidad, o aportar sus propios documentos fuente al flujo de trabajo. Al abrir tanto los datos como el proceso, nuestro objetivo es hacer que la generación de datos índicos a gran escala sea más accesible y permitir que más desarrolladores contribuyan a modelos más sólidos en los idiomas de la India.
El preentrenamiento continuado de Nemotron 3.5 Super VL añadió 10 mil millones de tokens índicos, provenientes de un subconjunto de doce idiomas de este corpus y de texto índico natural. Nuestro informe técnico sobre el modelo cubre toda la historia. Planeamos construir sobre este corpus en futuros modelos Nemotron.
¿Qué contiene el corpus?
 Figura 1. El corpus contiene 2,601.0 mil millones de tokens en escritura nativa y 224.6 mil millones de tokens romanizados. Los recuentos utilizan el tokenizador Gemma-4. Los registros de documentos incluyen traducciones y variantes de escritura de fuentes compartidas; no son recuentos de documentos únicos en inglés.
El corpus tiene dos grupos de configuraciones de idioma:
- Datos en escritura nativa y romanizados: bengalí, guyaratí, hindi, canarés, malayalam, maratí, nepalí, odia, punjabí, tamil, telugu y urdu.
- Datos en escritura nativa: asamés, bodo, dogri, cachemiro, konkani, maithili, manipuri, sánscrito, santali y sindhi.
Aquí, escritura nativa describe el sistema de escritura: el texto sigue traduciéndose del inglés. Romanizado significa texto en una lengua índica escrito en alfabeto latino, no una traducción al inglés. Para cada uno de los doce idiomas con doble escritura, la romanización cubre un subconjunto de las traducciones aceptadas en escritura nativa.
Esta distinción importa al construir una mezcla de entrenamiento. Los registros nativos y romanizados ofrecen exposición a diferentes sistemas de escritura, pero pueden expresar el mismo contenido subyacente. Los recuentos de tokens describen el corpus retenido, incluidas las reescrituras aceptadas, y no el presupuesto de tokens de una ejecución de entrenamiento. Los recuentos también dependen del tokenizador utilizado, por lo que el inventario del corpus y los recuentos de tokens de entrenamiento deben leerse por separado.
De documentos fuente en inglés a datos de entrenamiento índicos
Para construir este corpus, partimos de documentos de 15 Nemotron-CC-v2 subconjuntos, que cubren texto web, material de preguntas y respuestas, matemáticas, código y otros contenidos especializados. Usamos NeMo Data Designer, el marco de código abierto de NVIDIA para generar datos sintéticos, para ejecutar traducción, controles de calidad y reparaciones dirigidas. A lo largo del flujo de trabajo, conservamos cada identificador de fuente para que los desarrolladores puedan rastrear una salida hasta su documento original. Una procedencia clara como esta es parte de lo que hace que los datos abiertos sean prácticos de auditar y sobre los que construir. La Figura 2 muestra el flujo de trabajo para doce lenguas.
 Figura 2. Flujo de datos sintéticos índicos de cuatro etapas para doce lenguas, implementado con NeMo Data Designer y Gemma-4-31B-it. Traducimos documentos en inglés, evaluamos la calidad de la traducción, reparamos las salidas con puntuaciones bajas y convertimos un subconjunto de traducciones aceptadas a escritura latina. Las otras diez lenguas utilizan el flujo de trabajo Indic Translate separado descrito a continuación.
El flujo de trabajo de doce lenguas
Para estas doce lenguas, traducimos los documentos completos para que el modelo pueda usar el contexto entre párrafos, tablas y ecuaciones. Seleccionamos Gemma-4-31B-it comparando modelos en documentos completos, verificando la calidad de la traducción y la preservación del contenido técnico. Nuestros prompts distinguen la prosa a traducir del contenido a preservar, incluidos código, ecuaciones, URL y formato.
Después de la traducción, usamos el mismo modelo para evaluar cada salida contra su fuente en inglés. Una rúbrica inspirada en Multidimensional Quality Metrics (MQM), un marco abierto para clasificar los errores de traducción por tipo y gravedad, cubre significado, fluidez, terminología, estilo y formato. Retenemos solo las salidas con una puntuación de al menos 75 sobre 100 (una puntuación de rúbrica, no un porcentaje de precisión). Para las salidas con puntuaciones más bajas, usamos los comentarios de la evaluación para guiar las reparaciones y luego las reevaluamos contra el mismo umbral. Este proceso recuperó 438.4 billion tokens entre datos en escritura nativa y romanizados, ya incluidos en el total del corpus. Revisiones humanas muestreadas y pruebas con errores introducidos deliberadamente ayudaron a identificar omisiones e inglés residual, lo que informó mejoras a nuestros prompts y controles.
Las traducciones aceptadas en escritura nativa también proporcionan el punto de partida para los datos romanizados. Convertimos un subconjunto a escritura latina y verificamos cada resultado contra su entrada en escritura nativa. Esto separa la traducción de la conversión de escritura. En nuestra comparación humana inicial, este enfoque de dos pasos produjo menos adiciones alucinadas y menos inglés residual que generar texto romanizado directamente desde el inglés.
El flujo de trabajo de diez lenguas
Para las otras diez lenguas, adaptamos el flujo de trabajo para abordar problemas de calidad en documentos largos y de estabilidad de escritura observados en nuestras comparaciones. Traducimos con Indic Translate, un modelo de traducción a nivel de documento para inglés y 22 lenguas indias de Bodhan AI, un centro sin fines de lucro de IA en educación incubado en IIT Madras. Gemma-4-31B-it evalúa luego cada traducción contra su fuente en inglés. Para ocho lenguas, mantenemos el enfoque de documento completo. Para documentos santali más largos, traducimos ventanas superpuestas y reconstruimos el documento; para manipuri, traducimos a escritura bengalí antes de convertir a Meitei Mayek, su escritura nativa. Estos flujos de trabajo retienen salidas con puntuación de al menos 75 sobre 100 y producen solo datos en escritura nativa, sin reescritura basada en retroalimentación.
¿Qué cambió tras el continued pretraining índico?
El informe técnico de Nemotron 3.5 Super VL compara el checkpoint inmediatamente anterior al continued pretraining (CPT) índico con el checkpoint posterior a esa etapa. El presupuesto configurado fue de 100 billion training tokens, con el 10% (10 billion tokens) asignado a una mezcla de texto índico sintético y natural. El 90% restante mantuvo las proporciones relativas de la mezcla de entrenamiento anterior.
Las puntuaciones aumentaron en los cinco benchmarks índicos de conocimiento y razonamiento reportados: MILU, Indic MMLU-Pro, Indic ARC-Challenge, Indic ARC-Easy e Indic GSM8K.
 Figura 3. Nemotron 3.5 Super VL antes y después de la etapa Indic CPT. Las ganancias van de 4.98 a 9.82 puntos porcentuales. La comparación reporta el cambio a lo largo de una etapa de entrenamiento que combina datos índicos sintéticos y naturales, en lugar de aislar la contribución del corpus sintético. La cobertura de idiomas difiere según el benchmark; estos son puntos de control a nivel de etapa, no una comparación de versiones finales del modelo.
Fuente: informe técnico de Nemotron 3.5 Super VL, Tabla 2. GSM8K excluye Odia porque la evaluación excedió el límite de contexto de servicio.
Estas ganancias respaldan la receta combinada de Indic CPT sintético y natural, dejando la elección de la mezcla para otros modelos e idiomas a estudios posteriores.
El informe índico complementario examina las mezclas de fuentes, el tamaño del conjunto de datos sintéticos y la cobertura de escrituras utilizando datos de primera pasada aceptados para el grupo de doce idiomas. Evaluar el corpus completo, incluidas las reescrituras recuperadas y los otros diez idiomas, sigue siendo un paso pendiente para esos estudios controlados.
Capacidades índicas más amplias en Nemotron 3.5 Super VL
Más allá de los resultados de la etapa CPT, ¿cómo se compara el modelo publicado con la generación anterior? La Figura 4 compara Nemotron 3.5 Super VL con Nemotron 3 Super en el rendimiento en tareas índicas y la calidad del idioma. Estos resultados reflejan el pipeline de entrenamiento completo del modelo publicado, incluidos Indic CPT y el post-entrenamiento.
Nemotron 3.5 Super VL obtiene puntuaciones más altas en cinco de los seis benchmarks de tareas mostrados, que abarcan conocimiento, razonamiento, matemáticas, código y traducción. El seguimiento de instrucciones en IFEval 1.5 bajó 2.04 puntos. También mejora en las cuatro dimensiones de IndiVibe : utilidad, fluidez, fidelidad al idioma y a la escritura, y verbosidad apropiada. IndiVibe es el benchmark abierto de Sarvam AI de prompts estilo asistente en idiomas de la India. En conjunto, estas evaluaciones examinan tanto lo que el modelo puede hacer como qué tan bien se comunica en los idiomas de la India.
 Figura 4. Rendimiento en tareas índicas y calidad del idioma entre generaciones de Nemotron Super. Izquierda: seis benchmarks de tareas. Derecha: puntuaciones preliminares de preferencia condicional de IndiVibe, no tasas de victoria directas cara a cara. Las etiquetas muestran cambios en puntos porcentuales, excepto WMT24++, que usa puntos chrF. Consulte el informe técnico índico complementario para los detalles de los benchmarks y la evaluación.
Comience a construir
Cargue el corpus
Comience con los idiomas y escrituras que su modelo necesita, inspeccione una muestra y revise la tarjeta del conjunto de datos y la licencia antes de entrenar. Las configuraciones usan etiquetas de idioma, escritura y región: por ejemplo, hi-Deva-IN denota hindi en Devanagari, mientras que hi-Latn-IN denota hindi romanizado.
El ejemplo siguiente solicita el ID del repositorio de la tarjeta del conjunto de datos, luego descubre los splits disponibles y transmite una muestra.
from datasets import get_dataset_split_names, load_dataset

dataset_id = input("Repository ID from the dataset card: ").strip()
config = "hi-Deva-IN"

splits = get_dataset_split_names(dataset_id, config_name=config)
print("Available splits:", splits)

data = load_dataset(
    dataset_id, name=config, split=splits[0], streaming=True
)
print(next(iter(data)))
Hugging Face Datasets admite streaming, de modo que los lectores puedan inspeccionar registros sin descargar el corpus completo. Una vez que el lanzamiento esté disponible, fije una revisión del conjunto de datos para experimentos reproducibles.
Para un primer estudio de entrenamiento, compare mezclas con un presupuesto fijo de tokens y registre las proporciones natural/sintético y nativo/romanizado. Siga los resultados por idioma junto con la retención de capacidades en inglés y la calidad del idioma/escritura. Al crear splits de retención, tenga en cuenta los registros derivados de la misma fuente en distintos idiomas y escrituras.
Para construir una receta más completa, combine el corpus con datos de post-entrenamiento de Nemotron, como las colecciones Chat & Instruction o Post-Training Blends . Para datos sintéticos específicos de la India, siembre NeMo Data Designer con Nemotron-Personas-India, personas sintéticas en inglés y hindi basadas en distribuciones del mundo real para la India.
Adapte la receta de generación
El plugin de traducción de código abierto Nemotron Bharat translation plugin para NeMo Data Designer proporciona prompts de traducción y evaluación, reescritura opcional basada en retroalimentación, ventanas de documentos y soporte de remapeo de escritura. Use su referencia de configuración para elegir modelos e idiomas, adaptar los prompts a su dominio y establecer los parámetros de reescritura. La nota para desarrolladores adjunta explica el flujo de trabajo y las decisiones de ingeniería.
Comience con una muestra pequeña de sus propios documentos fuente. Inspeccione la calidad de la traducción y la preservación del código, las matemáticas y el formato, y luego refine los prompts y las comprobaciones con revisores de lengua nativa antes de escalar. Trate la generación y la aceptación del corpus como pasos separados: el plugin devuelve candidatos y puntuaciones, mientras que su política de filtrado determina qué registros entran en el corpus de entrenamiento.
Alcance y limitaciones
La traducción amplía el acceso al material fuente, pero no reemplaza el texto escrito originalmente en lenguas indias ni garantiza la cobertura del conocimiento y la cultura locales. Recomendamos combinar este corpus con texto indio natural de fuentes apropiadas y evaluar la mezcla resultante para el caso de uso previsto.
La evaluación de calidad es principalmente automatizada, complementada por revisión humana por muestreo cuya cobertura varía según los idiomas. En el flujo de trabajo de doce idiomas (Figura 2), el traductor también actúa como juez. El texto retenido todavía puede contener errores, y el flujo de trabajo de diez idiomas necesita una validación más amplia por hablantes nativos. Las comprobaciones de Source-ID eliminan duplicados de procesamiento; no constituyen una desduplicación semántica de contenido similar.
Junto con el corpus, AI4Bharat en IIT Madras, con el apoyo de NVIDIA, está construyendo Indic-LLM-Eval-Suite, una colección abierta y en evolución de benchmarks para las capacidades de los modelos indios. Ayuda a los creadores de modelos a evaluar tanto el rendimiento en tareas como la calidad lingüística. Vea el blog complementario, Better Models Need Better Benchmarks: Introducing Indic-LLM-Eval-Suite.
Explore las configuraciones de idiomas, pruebe una mezcla de entrenamiento o adapte la receta abierta a un nuevo dominio. Compartir resultados por idioma y mejoras en el flujo de generación puede ayudar a la comunidad a construir sobre este trabajo.
Lecturas adicionales y agradecimientos
Los informes complementarios, Scaling Synthetic Pre-training Data and Evaluation for Indic LLMs y el Nemotron 3.5 Super VL and Lightning technical report, proporcionan el inventario del corpus, los métodos de generación, los experimentos y los detalles de evaluación. La evaluación es la otra mitad de este trabajo. Para el lado de los benchmarks, vea el blog complementario de AI4Bharat y NVIDIA, Better Models Need Better Benchmarks: Introducing Indic-LLM-Eval-Suite.
Este trabajo reúne a NVIDIA, IIT Madras, AI4Bharat y Bodhan AI. También agradecemos las contribuciones de modelos y herramientas utilizadas en el flujo: Gemma de Google, Indic Translate de Bodhan AI y NeMo Data Designer. Hay recursos de datos adicionales de NVIDIA disponibles en la Nemotron Pre-Training Datasets collection.