
¡Beam by Reflection ya está disponible en Hugging Face! Es el primer modelo del nuevo laboratorio estadounidense Reflection, ¡y es abierto! Es un modelo de mezcla de expertos (MoE) con 501B de parámetros (23B activos por token), admite texto como entrada y tiene un ventana de contexto de 1M tokens, y se publica bajo la licencia Apache 2.0.
Beam se centra en codificación y agéntico casos de uso. Está dirigida a equipos que quieren un modelo de escala fronteriza en su propio hardware, infraestructura o nube, y desean personalizarlo para sus propios casos de uso. Beam viene con su propio harness dedicado de código abierto basado en Rust que ofrece el mejor rendimiento del modelo.
Beam cuenta con una implementación nativa en transformers, así como en bibliotecas derivadas como vLLM y SGLang. Hemos trabajado con el equipo de Reflection para ofrecerle recetas de inferencia, SFT (ajuste fino supervisado) y RL (aprendizaje por refuerzo) para que construya con este modelo según sus necesidades. Además del soporte desde el día 0 (day-0) en transformers, SGLang y vLLM, esta publicación le muestra cómo ejecutarlo, cómo realizarle post-entrenamiento y qué hemos construido con él.
Resumen:
- LLM MoE de 501B parámetros con 23B activos por token. 52 capas, 256 expertos por capa MoE, 8 enrutados por token.
- Texto de entrada, texto de salida con ventana de contexto de 1M de tokens.
- Formatos de checkpoint: BF16, FP8, y NVFP4
- Un razonamiento que puede permanecer en el contexto a lo largo de varios turnos (
preserve_thinking), llamada de herramientas con una gramática dedicada. El modelo admite cinco valores de razonamiento: "low", "medium" (predeterminado), "high", "xhigh" y "max".- Plantilla de respuesta en el tokenizador.
- Modelo redactor para decodificación especulativa con DFlash2
- Bibliotecas del Día-0: transformers, SGLang, vLLM. RL de parámetros completos con Miles.
- Incluye un Arnés personalizado basado en Rust.
- Apache 2.0.
Construye con Beam
Reflection va a otorgar $10,000 en créditos de Hub a los mejores proyectos que usen Beam. Todo lo que tienes que hacer es crear algo y compartirlo en el Hub:
- Podrías crear una demo que utilice el modelo Beam en Spaces
- Podrías cuantizarlo para tu hardware favorito
- Podrías generar un conjunto de datos sintético para tu problema favorito
- Podrías construir un entorno de RL con o para Beam
- Podrías hacer benchmark de Beam y compartir los resultados.
- ¡Podrías sorprendernos!
Si construyes algo con Beam, compártelo en el Hub para tener la oportunidad de ganar $10,000. Todo lo que tienes que hacer es construir el space, el modelo o el repositorio del dataset y compartirlo en la página del repositorio del modelo. Recopilaremos todos los enlaces, seleccionaremos el mejor y enviaremos los créditos a tus cuentas del Hub.
¿Qué es Beam?
Beam es un modelo solo de texto construido para razonamiento de contexto largo (longitud de contexto de 1M) y trabajo agéntico. Es un modelo MoE disperso, en el que cada token es calculado por una pequeña fracción de la red, por lo que se ejecuta a la velocidad de un modelo mucho más pequeño manteniendo la capacidad de uno grande.
Atención
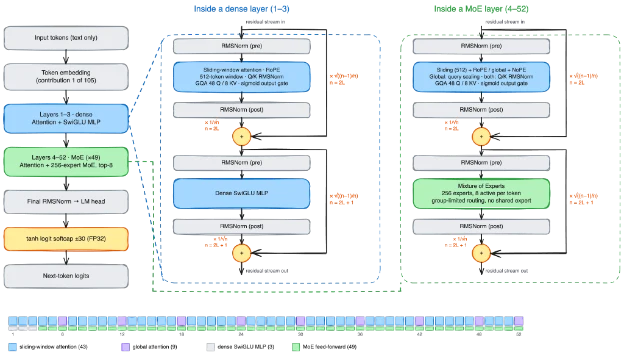
El decoder tiene 52 capas con un tamaño oculto de 5,120. La mayoría de las capas usan atención de ventana deslizante sobre los 512 tokens anteriores; cada sexta capa, y la última, atienden al contexto completo. Eso da 43 capas de ventana deslizante y 9 globales.
Dentro del bloque de atención (ambos tipos de capas)
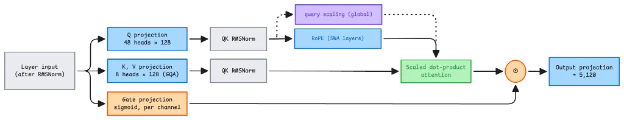
Los dos tipos de capas manejan la posición de manera diferente. Las capas de ventana deslizante usan RoPE, ya que la posición relativa es lo más importante dentro de una ventana corta. Las capas globales no usan codificación posicional. En cambio, cada query se multiplica por un escalador que crece lentamente con el número de tokens visibles, (1 + (pos + 1) / 2048) ** 0.1. Actúa como una temperatura: el softmax mantiene su precisión a medida que el contexto se alarga en lugar de aplanarse. La implementación llama a esto escalado de query con scalable-softmax.
La atención usa atención agrupada por queries (grouped-query attention) con 48 cabezas de query y 8 cabezas clave-valor, con RMSNorm en queries y claves. Una puerta sigmoide aprendida, calculada a partir de la entrada de la capa, escala cada canal de cada cabeza antes de la proyección de salida.
Mezcla de Expertos
Las primeras 3 capas usan un MLP denso SwiGLU. Las otras 49 lo reemplazan con un bloque Mixture-of-Experts de 256 expertos, cada uno un MLP SwiGLU con un tamaño intermedio de 2,560, o unos 39M de parámetros. Los expertos contienen el 98.4% de los parámetros del modelo.
El router sigue el esquema de grupos limitados de DeepSeek-V3. Puntúa los 256 expertos con una sigmoid, los divide en 8 grupos de 32, conserva los 4 mejores grupos (clasificados por la suma de las dos puntuaciones más altas de cada grupo) y luego elige los 8 mejores expertos dentro de ellos. Beam usa los mismos tamaños de grupo que DeepSeek-V3 pero sin experto compartido. Las salidas de los expertos se combinan con pesos de router normalizados y se escalan por 2.5.
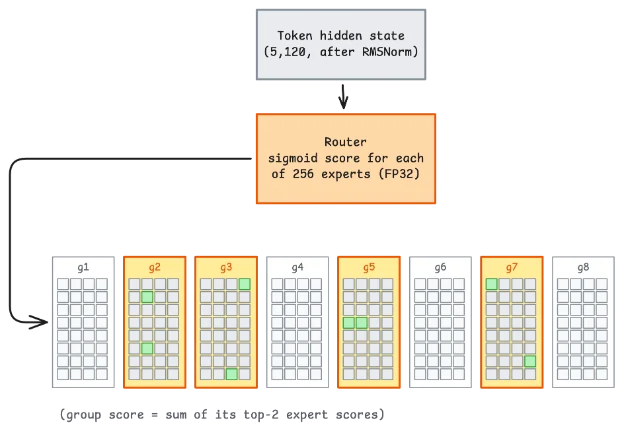
Solo se ejecutan 8 expertos por token, así que el modelo calcula cada token con unos 23B de parámetros. Los 256 expertos permanecen en memoria, por lo que el despliegue necesita la memoria de un modelo de 501B pero se ejecuta a la velocidad de uno de 23B. El checkpoint BF16 ocupa aproximadamente 1 TB en formato safetensors. El checkpoint NVFP4 almacena la mayoría de los parámetros en precisión de 4 bits para las GPU NVIDIA Blackwell; algunos parámetros se mantienen en BF16 por precisión. También hay checkpoints FP8 en el hub, ideales para los chips de las series Hopper y Ampere.
Si quieres desplegar Beam tú mismo, consulta las recetas de vLLM o SGLang a continuación.
Flujo residual
Las conexiones residuales son la parte más distintiva. Un transformer estándar añade la salida de cada subcapa al flujo con peso 1, por lo que el flujo crece con la profundidad.
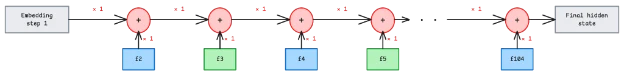
Beam cuenta el embedding de entrada como paso 1. En el paso k añade la salida de la subcapa con peso 1/sqrt(k) y mantiene el flujo existente con peso sqrt((k-1)/k). Los cuadrados de los dos pesos suman uno, de modo que el flujo se mantiene a una escala constante desde la primera capa hasta la última. Después de las 104 adiciones, cada salida de subcapa y el embedding de entrada llevan el mismo peso en el estado oculto final.
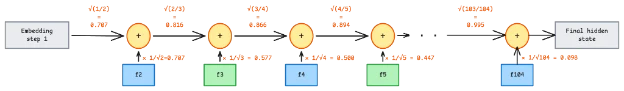
Cada subcapa también se normaliza antes y después, y los logits finales pasan por un tanh softcap en ±30, calculado en FP32. La implementación fija dónde calcula en FP32: el router, el producto SwiGLU, las normas, RoPE, el escalado de la query y el softcap.
Contexto largo
La atención híbrida funciona bien para contextos largos. Cada capa almacena en caché 2 x 8 cabezas KV x 128 dims = 2,048 valores por token. Si las 52 capas conservaran cada token, la caché crecería 208 KiB por token. Solo las 9 capas globales conservan toda la secuencia. Las 43 capas de ventana deslizante mantienen una ventana fija de 512 tokens cada una y dejan de crecer. Así, la caché crece 36 KiB por token, aproximadamente un sexto de la tasa ingenua.
| Contexto | Si las 52 capas fueran globales | Beam |
|---|---|---|
| 32K tokens | 6.5 GiB | 1.2 GiB |
| 128K tokens | 26 GiB | 4.6 GiB |
| Contexto completo (1M) | 208 GiB | 36.08 GiB |
Estos números son por secuencia, en BF16, con la caché dinámica de transformers.
Resultados de benchmarks
Estos son los resultados de los benchmarks en diferentes niveles de precisión, tal como los proporcionó el equipo de Reflection.
| Beam (BF16) | Beam (FP8) | Beam (NVFP4) | |
|---|---|---|---|
| Codificación agéntica / Terminal | |||
| DeepSWE v1.1 | 43.3% | 43.0% | 42.7% |
| SWE Bench Pro v2-Hard | 76.5% | 78.4% | 78.6% |
| SWE Bench Pro v1 | 66.1% | 65.9% | 65.6% |
| Terminal Bench v2.1 | 80.1% | 78.9% | 78.2% |
| SWE Atlas Codebase QnA | 31.8% | 32.2% | 31.4% |
| SWEBench Multilingual | 78.3% | 78.1% | 77.5% |
| SWEBench Verified | 81.6% | 80.2% | 80.7% |
| Razonamiento | |||
| AIME 2026 | 97.7% | 98.0% | 97.5% |
| HLE (sin herramientas) | 36.0% | 36.0% | 34.8% |
| HLE (con herramientas) | 51.1% | 51.1% | 51.1% |
| SciCode | 49.2% | 48.3% | 46.9% |
| CriPT AA | 16.3% | 17.4% | 15.4% |
| GPQA Diamond | 90.6% | 90.3% | 89.3% |
| LiveCodeBench | 88.3% | 88.1% | 87.4% |
| Llamada de herramientas / Búsqueda | |||
| AutomationBench - solo división pública | 39.3 | 38.2 | 39.8% |
| MCP Atlas | 80.8% | 81.5% | 80.5% |
| Tau3 Banking | 36.1% | 36.8% | 35.4% |
| BrowseComp con gestión de contexto | 76.8% | 76.7% | 75.6% |
| DeepSearchQA con gestión de contexto | 80.5% | 79.6% | 81.1% |
| Capacidades generales | |||
| AA-LCR | 78.2% | 79.4% | 78.7% |
| LongBench v2 | 67.5% | 67.6% | 67.2% |
| IFBench | 79.6% | 80.7% | 79.2% |
| AA Omniscience (índice) - solo división pública | 10.8 | 8.8 | 9.8 |
Requisitos de hardware
La forma más práctica de servir el modelo es servir el checkpoint NVFP4, que conserva la mayor parte de la calidad del checkpoint bf16. NVFP4 almacena algunos pesos en 4 bits, y de esta manera reduce los 501B parámetros en BF16 de 1 TB a ~280 GB. Las GPUs Blackwell ejecutan NVFP4 de forma nativa, pero las GPUs anteriores a Blackwell como la H200 no pueden. Los checkpoints FP8 son adecuados para GPUs anteriores a Blackwell.
Una B200 tiene 180 GB de HBM3e, así que dos de ellas (360 GB) pueden albergar los pesos de Beam, con poco espacio restante para las activaciones y la caché KV. Planifica cuatro B200 (720 GB), lo que deja mucho espacio para contextos largos y solicitudes concurrentes. También puedes servirlo en un nodo completo de 8xB200, o en dos B300 de 288 GB cada una, o incluso en 8xRTX Pro 6000. Si no tienes hardware Blackwell, usa Inference Providers (serverless) para probar Reflection.
Soporte de inferencia
Beam incluye soporte desde el día 0 en transformers, SGLang y vLLM.
Transformers
Instala la última versión de transformers.
pip install -U "transformers>=5.20.1"
La forma más sencilla de ejecutar Beam es el pipeline de generación de texto:
from transformers import pipeline

pipe = pipeline(
    "text-generation", model="reflectionai/Beam-1.0-501B-A23B", device_map="auto"
)

messages = [
    {"role": "user", "content": "Write a limerick about Python exceptions."}
]
output = pipe(messages, max_new_tokens=2000)
output[0]["generated_text"][-1]
El pipeline devuelve todo el chat. El último mensaje es la respuesta de Beam, ya analizada por la plantilla de respuesta.
Bajando un nivel más, use AutoModelForCausalLM y AutoTokenizer.
from transformers import AutoModelForCausalLM, AutoTokenizer

model_id = "reflectionai/Beam-1.0-501B-A23B"
tokenizer = AutoTokenizer.from_pretrained(model_id)

model = AutoModelForCausalLM.from_pretrained(
    model_id, dtype="auto", device_map="auto"
)
Chat
messages = [
    {"role": "system", "content": "You should only answer with a number."},
    {"role": "user", "content": "What is 17 * 23?"},
]

inputs = tokenizer.apply_chat_template(
    messages,
    add_generation_prompt=True,
    tokenize=True,
    return_dict=True,
    return_tensors="pt",
    reasoning_effort="medium" # by default
).to(model.device)

input_len = inputs["input_ids"].shape[-1]

outputs = model.generate(**inputs, max_new_tokens=2000)

tokenizer.parse_response(
    outputs[0][input_len:], prefix=inputs["input_ids"][0]
)
El tokenizador de Beam incluye una plantilla de respuesta. parse_response la lee y convierte la salida cruda en un diccionario de mensaje, con el razonamiento, la respuesta y cualquier llamada a herramientas en campos separados. Esto evita las usuales expresiones regulares para separar el razonamiento de las respuestas y de las llamadas a herramientas. Y las reglas vienen con el tokenizador, por lo que la estructura analizada coincide con aquello para lo que Beam fue entrenado a producir. La plantilla de chat puede preescribir parte del turno del asistente, que el analizador necesita ver.
Llamadas a herramientas
Ejemplo completo de llamada a herramientasdef get_weather(city: str, unit: str = "celsius"):
"""
Get the current weather for a city.
Args:
city: The city to look up.
unit: Temperature unit, "celsius" or "fahrenheit".
"""
...
tools = [get_weather]
messages = [
{"role": "user", "content": "I land in Paris tonight. Do I need a coat?"}
]
inputs = tokenizer.apply_chat_template(
messages,
tools=tools,
add_generation_prompt=True,
tokenize=True,
return_dict=True,
return_tensors="pt",
).to(model.device)
input_len = inputs["input_ids"].shape[-1]
outputs = model.generate(**inputs, max_new_tokens=1000)
message = tokenizer.parse_response(
outputs[0][input_len:], prefix=inputs["input_ids"][0], tools=tools
)
message.get("tool_calls")
Pase tools a parse_response también. Beam escribe los argumentos de las llamadas a herramientas en línea, en su propia gramática estilo XML, por lo que un 7 podría ser un número o una cadena. Con los esquemas de herramientas, el analizador convierte cada argumento a su tipo declarado.
Multi-GPU y multi-nodo
La configuración de Beam define un plan de paralelismo de expertos. El paralelismo de expertos coloca cada experto en un dispositivo. La atención, las capas densas, los embeddings y la cabeza del LM se replican en cada dispositivo. Eso son 8B de parámetros, o 16 GB en BF16. Cargue el modelo con un DistributedConfig:
import os

from transformers import AutoModelForCausalLM
from transformers.distributed import DistributedConfig

model = AutoModelForCausalLM.from_pretrained(
    "reflection/Beam-1.0-501B-A23B",
    distributed_config=DistributedConfig(
        tp_size=int(os.environ["WORLD_SIZE"]), enable_expert_parallel=True
    ),
)
Lance el script con torchrun en 16 GPUs H200. Cada una contiene entonces 78 GB de pesos. Con 8 GPUs, cada una contendría 139 GB, lo que no deja espacio en una H200 de 141 GB. El número de dispositivos debe dividir el número de expertos, 256.
vLLM
Beam tiene soporte desde el día 0 en vLLM. El siguiente comando sirve el checkpoint BF16 con paralelismo de tensores en 16 GPUs (dos nodos de 8x H200) y expone una API compatible con OpenAI:
vllm serve reflection/Beam-1.0-501B-A23B --tensor-parallel-size 16 --served-model-name beam
Para una generación más rápida, añada decodificación especulativa DFlash2. Un pequeño modelo de borrador propone hasta 15 tokens por adelantado, y Beam los verifica todos en un solo pase hacia adelante, por lo que cada paso puede aceptar varios tokens. El costo es un poco de memoria adicional para el borrador:
vllm serve reflection/Beam-1.0-501B-A23B \
  --tensor-parallel-size 16 \
  --speculative-config '{ "method": "dflash", "model": "reflection/dflash2-drafter-preview", "num_speculative_tokens": 15 }'
Ambos comandos inician un servidor compatible con OpenAI, por lo que puede apuntar cualquier cliente de OpenAI a http://localhost:8000/v1. Para configuraciones de servicio adicionales, consulte la receta de Beam propuesta para vLLM.
SGLang
Beam también tiene soporte desde el día 0 en SGLang. Recomendamos servirlo con decodificación especulativa DFlash2, que ambos comandos siguientes activan. En Blackwell, el checkpoint NVFP4 cabe en 4 B300:
python -m sglang.launch_server \
--model-path reflection/Beam-1.0-501B-A23B-NVFP4 \
--served-model-name beam \
--tp 4 \
--attention-backend trtllm_mha \
--page-size 64 \
--context-length 1048576 \
--mem-fraction-static 0.85 \
--enable-unified-memory \
--speculative-algorithm DFLASH \
--speculative-draft-model-path reflection/Beam-1.0-501B-A23B-DFlash2 \
--speculative-dflash-block-size 8 \
--tool-call-parser beam --reasoning-parser beam \
--host 0.0.0.0 --port 30000
En GPUs Hopper, use el checkpoint FP8 en 8 H200 en su lugar. Solo cambian tres flags: el checkpoint, el tamaño de paralelismo de tensores (8 en lugar de 4) y el backend de atención (fa3 en lugar de trtllm_mha, que requiere Blackwell):
python -m sglang.launch_server \
--model-path reflection/Beam-1.0-501B-A23B-FP8 \
--served-model-name beam \
--tp 8 \
--attention-backend fa3 \
--page-size 64 \
--context-length 1048576 \
--mem-fraction-static 0.85 \
--enable-unified-memory \
--speculative-algorithm DFLASH \
--speculative-draft-model-path reflection/Beam-1.0-501B-A23B-DFlash2 \
--speculative-dflash-block-size 8 \
--tool-call-parser beam --reasoning-parser beam \
--host 0.0.0.0 --port 30000
Inference Providers
Beam está disponible en Hugging Face Inference Providers, impulsado por Baseten, Fireworks y Together, con más por llegar pronto.
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://router.huggingface.co/v1",
    api_key=os.environ["HF_TOKEN"],
)

completion = client.chat.completions.create(
    model="reflection/Beam-1.0-501B-A23B:auto",
    messages=[{"role": "user", "content": "What is the capital of France?"}],
)

print(completion.choices[0].message)
Inference Endpoints
Hemos configurado una receta de Beam para que pueda desplegarla con un clic en Inference Endpoints desde el catálogo en FP8 o NVFP4, o instalar con el hf cli así:
hf endpoints catalog deploy --repo reflection/Beam-1.0-501B-A23B --name beam
Lo que probamos
Compartimos algunos vibe evals de Reflection Beam-501B-A23B en cinco tareas, cada una una vez con esfuerzo de razonamiento bajo y alto a través de la plataforma Reflection. Estos son vibe evals, no benchmarks. Si estás pensando en usar Beam, esta es una excelente manera de probarlo y ver cómo se comporta en casos de uso específicos y, lo que es más importante, dónde gana y dónde pierde.
A continuación se ofrece un resumen de los prompts que ejecutamos y los registros de salida del hub. Las entradas completas, salidas, uso de la API, fixtures de tareas, evaluadores y registros de conversación están en este bucket público de Hugging Face.
| Categoría | Descripción del prompt | Razonamiento bajo (tokens) | Razonamiento alto (tokens) |
|---|---|---|---|
| Llamada de herramientas en varios pasos | Cumplir ORD-742: comparar stock, reservas, recargos y fechas de llegada; reservar el almacén elegible más barato. | ✅ 544 | ✅ 811 |
| Recuperación de contexto largo sobre una base de código | Derivar la configuración de comandos de Click y dos resultados de invocación a partir de tres archivos fuente completos; citar seis símbolos de implementación. | 🔴 1,613 * | ✅ 5,007 |
| Tarea de terminal en un sandbox | Inspecciona y repara una CLI de libro contable CSV; corrige todos los errores, conserva las pruebas, ejecuta las pruebas y una verificación de la CLI. | ✅ 582 | ✅ 1,548 |
| Razonamiento matemático (estilo AIME) | ¿Cuántos subconjuntos de ocho elementos de {1, …, 16} tienen una suma divisible por 17? Justifica tu respuesta. | 🟠 829 † | ✅ 2,809 |
| Salida estructurada | Convierte un registro de revisiones desordenado en JSON estricto: fusiona parches, cancelaciones, nulos, fechas, monedas y totales. | ✅ 1,040 | ✅ 2,088 |
* La respuesta de Low en contexto largo acertó todo el comportamiento del código y las seis citas de código fuente. Sin embargo, la respuesta no correspondía al formato de los parsers, por lo que esto se debe en parte a la ambigüedad del prompt.
† Low devolvió la respuesta correcta, pero omitió la justificación solicitada. High aportó una demostración correcta mediante raíces de la unidad, revisada de forma independiente.
No nos creas solamente a nosotros. Explora a fondo el bucket, reescríbelo para tu caso de uso o proyecto y lleva Beam al límite.
Posentrenamiento de Beam
Puedes ajustar Beam para tus propios casos de uso. Aquí compartimos algunos ejemplos en TRL y Miles para empezar con el ajuste fino supervisado y el aprendizaje por refuerzo.
SFT con TRL
La forma más rápida de adaptar Beam a tus propios datos es el ajuste fino supervisado con el SFTTrainer de TRL. Para mantener la memoria bajo control, entrenamos adaptadores LoRA con PEFT en lugar de actualizar los 501B parámetros:
Usamos el SFTTrainer de TRL para adaptar Beam a un objetivo sencillo: mantener su razonamiento en el idioma solicitado por el usuario. Ajustamos finamente con Multilingual-Thinking con LoRA, que entrena un pequeño conjunto de pesos de adaptador mientras mantiene congelado el modelo base.
La configuración combina fragmentación del modelo en la carga, paralelismo de expertos, FlashAttention 4 y empaquetado de secuencias. El SFT con LoRA cabe en un solo nodo con 8 GPU B300, alcanzando alrededor de 19,000 tokens por segundo. La configuración equivalente en H100 utiliza cuatro nodos.
Tras una época de Multilingual-Thinking, Beam razonó en el idioma solicitado en 16 de 16 prompts reservados, en comparación con 3 de 16 para el modelo base. Esta pequeña evaluación mide la adherencia al idioma, no la corrección del razonamiento en sí.
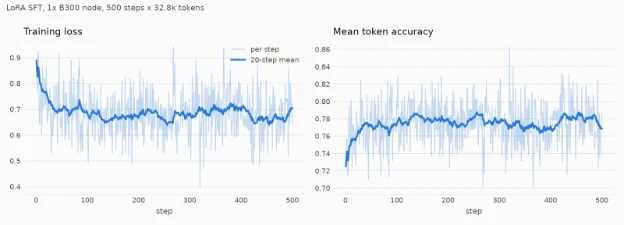
Pérdida de entrenamiento (izquierda) y precisión media por token (derecha) durante una ejecución separada de 500 pasos en un subconjunto de razonamiento de open-r1/Mixture-of-Thought, usando un nodo con 8 GPU B300. Estas métricas de entrenamiento provienen del TRL example PR.
GRPO con Miles
Reflection y RadixArk construyeron una receta que entrena el modelo con GRPO en Miles, en BF16. Puedes actualizar el modelo completo o usar LoRA para entrenar adaptadores manteniendo congelados los pesos base. Megatron entrena, SGLang genera los rollouts y Miles publica los nuevos pesos en los motores de rollout tras cada actualización. Revisamos la receta.
| Carga de trabajo | Configuración de referencia |
|---|---|
| Inferencia / eval, BF16 | 16x H200 por motor |
| GRPO de parámetros completos, BF16 (Miles) | 96x H200: 64 de entrenamiento, 32 de rollout. O 64x H200 en colocación. |
| GRPO con LoRA, BF16 (Miles) | 32x H200: 16 de entrenamiento, 16 de rollout. |
| GRPO de parámetros completos, BF16, contexto de 128 tokens (Miles) | 48x H200: 32 para entrenamiento, 16 para rollout. La configuración se validó primero en el checkpoint real en Reflection y RadixArk. |
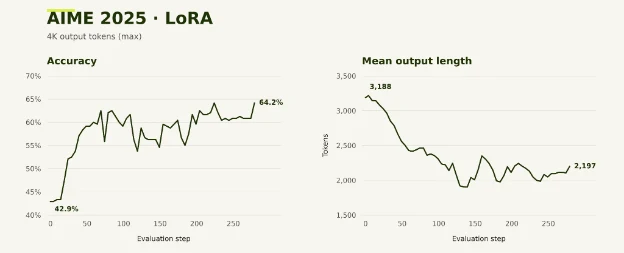
La receta ejecuta GRPO en DAPO-Math-17K y evalúa en AIME25. Construya la imagen, descargue los datos y envíe el trabajo a un clúster Ray de doce nodos de 8x H200:
docker build -f docker/Dockerfile.beam -t miles-beam .

python scripts/run_beam.py prepare \
  --model-id reflection/Beam-1.0-501B-A23B \
  --model-dir /root/models/Beam \
  --data-dir /data/datasets

export MASTER_ADDR=10.0.0.1
export RAY_ADDRESS=http://${MASTER_ADDR}:8265

python scripts/run_beam.py execute \
  --model-dir /root/models/Beam \
  --data-dir /data/datasets \
  --output-dir /root/shared_data/beam-run \
  --num-rollout 100
Qué ocurre en un rollout:
Muestra: Se pasan 32 prompts al modelo con 8 respuestas cada uno. Dos motores SGLang sirven los rollouts en 16 GPU cada uno.
Puntuación: la respuesta enmarcada (boxed) se compara con la etiqueta, con una penalización suave para las respuestas cercanas al límite de longitud.
Actualización: un paso del optimizador sobre las 256 muestras. Ventajas relativas al grupo con muestreo de importancia truncado, sin penalización de KL ni de entropía.
Entrenar en paralelo: paralelismo de tensores 8, paralelismo de expertos 8, paralelismo de datos 8, con paralelismo de secuencia y recomputación completa.
Optimizador: Adam a un valor constante de 1e-6. Gradientes en BF16, pesos maestros en FP32, momentos en BF16. El estado del optimizador se transmite a través de NVMe local del nodo, por lo que cada nodo de entrenamiento necesita 2 TB de espacio temporal.
Evaluar: AIME25 cada cinco rollouts, ocho muestras por problema. Se guarda un checkpoint cada veinte.
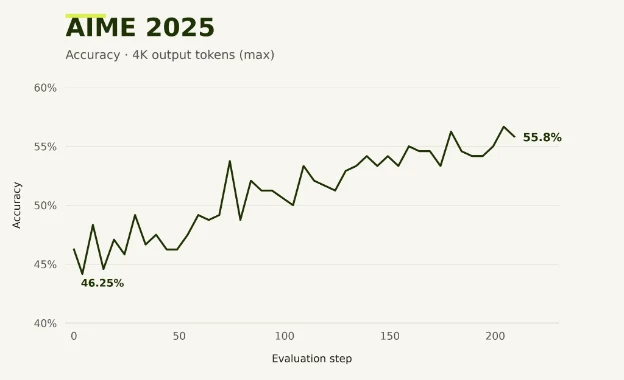
El siguiente rollout se genera mientras el actual se entrena, por lo que las respuestas van una actualización por detrás. Añade --resume para continuar desde el último checkpoint. execute-colocate ejecuta la misma receta en ocho nodos, con todas las GPU entrenando y sirviendo por turnos.
Entrenar con LoRA
También puedes ejecutar GRPO con LoRA en cuatro nodos de 8× H200: 16 GPU para entrenamiento y 16 para rollouts. La receta entrena adaptadores de rango 16 en las capas de atención de Beam, MLP denso y capas de expertos, manteniendo congelados los pesos base. Solo los pesos de los adaptadores se sincronizan con SGLang, y el estado del optimizador permanece en la memoria de la GPU, eliminando la necesidad de descargar el optimizador a NVMe.
python scripts/run_beam_lora.py execute \
  --model-dir /root/models/Beam \
  --data-dir /data/datasets \
  --output-dir /root/shared_data/beam-run \
  --num-rollout 100
Construye con Beam: Demos
Si construyes algo con Beam, compártelo en el Hub para tener la oportunidad de ganar $10,000. Todo lo que tienes que hacer es crear un espacio, un modelo o un repositorio de dataset y compartirlo en la página del repositorio del modelo. Para inspirarte, aquí hay algunas cosas que construimos.
Hey Beam, ¡construye una aplicación local nativa para MacOS!
En Hugging Face amamos los modelos abiertos y locales que se ejecutan de forma nativa en su hardware, ¡pero construir aplicaciones nativas en Mac puede ser difícil! Veamos si Beam puede ayudarnos.
Le pedimos a Beam que construyera una aplicación nativa de MacOS que convierta voz en texto y la coloque convenientemente en tu cursor. Queremos usar MLX para aprovechar al máximo nuestro Mac Metal y el modelo Parakeet para una excelente conversión de voz a texto.
Build BeamSpeak, a native macOS menu bar dictation app with a compact recording pill and no main window or account.

Use ⌘⇧Space to start and stop microphone recording, showing elapsed time, microphone level, and transcription status. Run speech recognition entirely locally using a Hugging Face model, preferably Parakeet v3 through MLX, and keep the model loaded between recordings. Paste the transcript into the original app if it remains focused and Accessibility permission is granted; otherwise copy it to the clipboard, preserving newer clipboard changes and never pressing Enter. Handle permissions, cancellation, silence, errors, a two-minute recording limit, and temporary audio cleanup. Deliver source code, a runnable BeamSpeak.app, setup instructions, and verification of offline transcription, the physical shortcut, microphone capture, and text delivery.
Usamos Beam con el harness de código Pi para construir la aplicación inicial nativa en la barra de menú de macOS, ejecutando Parakeet con MLX. La ejecución guardada incluye los prompts de seguimiento; el código fuente final también incluye reparaciones posteriores de Codex. El prompt anterior es una versión condensada de los requisitos de construcción.
Puedes consultar el trace del agente de cómo Beam construyó esto en pi en este trace. Si quieres probar la demo, descarga el código fuente o lee las instrucciones de configuración.
Hey Beam, ¿cómo escalas con múltiples agentes?
Queríamos ver si Beam podía avanzar más rápido dividiendo una tarea de programación entre agentes. Combinamos Beam con el agente de código open-source Pi y comparamos tres configuraciones: 1. un agente trabajando solo, 2. cinco pares persistentes colaborando a través de un repositorio Git compartido, y 3. un agente líder que delega trabajo a subagentes asíncronos. El harness se ejecutó en Hugging Face jobs con inferencia a través de la API de la plataforma de Reflection.
Para las tareas, usamos ProgramBench: los agentes deben recrear un programa a partir de su ejecutable compilado y su documentación, sin ver su código fuente ni las pruebas del evaluador. Cada configuración tuvo el mismo techo de 8M de tokens de API y un límite de dos horas por tarea para el solver, compartidos entre sus agentes. Guardamos instantáneas de las implementaciones y las evaluamos contra suites fijas de tests ocultos del ProgramBench-Tests dataset.
Nuestro gráfico de puntuación frente a latencia muestra la fracción promedio de tests superados. El eje temporal usa tasas de referencia fijas para los tokens del modelo más el tiempo medido de las herramientas, en lugar del tiempo transcurrido real. Inicialmente ejecutamos cinco tareas. La figura actual muestra un subconjunto post-hoc de jq, xsv, FIGlet y hexyl; ripgrep fue excluido en las tres configuraciones porque calificar sus artefactos guardados era demasiado lento. Los resultados publicados conservan los 15 episodios originales.
Puedes inspeccionar las ejecuciones en el panel de control de Trackio, explorar los datos de resultados publicados, y reutilizar el harness de estudio.
¡Hola Beam, ajusta un modelo de decisión para mi base de código!
Los modelos de decisión están de moda en este momento porque son súper rápidos y prácticos para muchos casos de uso. Comenzamos con Beam, luego continuamos con GLM-5.3 en Pi después de que se agotara la cuota de Beam, para entrenar y evaluar un modelo de decisión personalizado para la clasificación de incidentes de desarrolladores.
Queríamos ver si un agente de programación podía convertir una política de triaje de incidentes en un modelo de decisión pequeño y rápido. La tarea consistía en leer un incidente de desarrollo y elegir al equipo responsable, su severidad y si había que avisar de inmediato a alguien. Usando Unsloth, hicimos fine-tuning de Qwen3.5-0.8B para puntuar directamente estas decisiones.
Primero, el flujo de trabajo construyó un dataset sintético que contiene 2.3k incidentes divididos por clúster de incidentes para entrenamiento, calibración y prueba. Entrenamos un adaptador LoRA y una cabeza de decisión durante tres épocas, con un backbone de 4 bits, en una H100 80GB en el clúster de Slurm de Science.
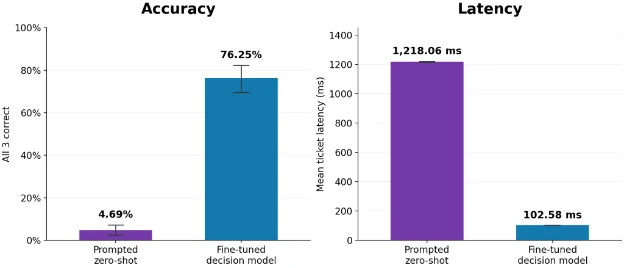
Como baseline, le pedimos al modelo sin adaptar, mediante prompt, la política completa de triaje y el ticket, sin ejemplos, y le pedimos que generara las tres decisiones como JSON. En los mismos 320 tickets sintéticos de prueba, el modelo de decisión con fine-tuning acertó las tres respuestas en el 76.25% de los casos, frente al 4.69% del zero-shot con prompt. La latencia media por ticket bajó de 1,218.06 ms a 102.58 ms, una aceleración de 11.9×.
Si quieres probar este experimento por ti mismo, echa un vistazo al bucket de artefactos que contiene los datos, el código, los checkpoints y los resultados.
Conclusiones
Beam es un modelo abierto de 501B que puedes ejecutar en tu propio hardware y modificar. Empieza con el checkpoint BF16 o prueba una de las cuantizaciones FP8, NVFP4. Si construyes algo con Beam, compártelo en la pestaña de discusiones.