
TL;DR: Beam de Reflection es un MoE de 501B parámetros con 23B parámetros activos por token. vLLM lo soporta desde el día 0 y lo optimiza en NVIDIA Blackwell:
- Soporte completo de funciones. Razonamiento, llamadas a herramientas y salidas estructuradas funcionan desde el primer momento, y puede ejecutar el modelo con paralelismo de tensores, de datos o de expertos.
- Optimización impulsada por agentes. Agentes de programación optimizaron el modelo de forma autónoma, haciendo que la decodificación batch-1 sea 2.71× más rápida y el prefill 1.87× más rápido que nuestra primera implementación.
- DFlash2 con verificación adaptativa. Con el drafter DFlash2 de Beam, una sola solicitud alcanza 708 tokens/s en TP8, con una longitud de aceptación de 3.7. La verificación adaptativa, que decide en cada paso cuántos tokens borrador vale la pena verificar, añade un 10% más de rendimiento con alta concurrencia.
Para probarlo, use nuestra imagen de Docker vllm/vllm-openai:reflection-beam:
docker run --gpus all --ipc=host -p 8000:8000 \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  vllm/vllm-openai:reflection-beam \
  reflection/Beam-1.0-501B-A23B-NVFP4 \
  -tp 4 \
  --max-num-seqs 128 \
  --reasoning-parser beam \
  --tool-call-parser beam --enable-auto-tool-choice \
  --kv-cache-dtype fp8 \
  --attention-config '{"backend":"FLASHINFER"}' \
  --kernel-config '{"enable_flashinfer_autotune":false}' \
  --speculative-config '{
    "method": "dflash",
    "model": "reflection/Beam-1.0-501B-A23B-DFlash2",
    "num_speculative_tokens": 7,
    "attention_backend": "FLASH_ATTN"
  }'
Arquitectura del modelo
Beam es un decodificador MoE de 52 capas con tamaño oculto 5120. El enrutamiento MoE sigue DeepSeek-V3. Las principales diferencias están en las capas de atención y en cómo se normaliza el flujo residual.
Figura 1: La pila de capas de Beam y una capa decodificadora dispersa. Las marcas doradas indican las partes que difieren de un MoE pre-norm estándar. Abrir en pantalla completa.
Atención
- Capas híbridas de ventana deslizante y NoPE. 43 capas usan atención de ventana deslizante sobre los últimos 512 tokens, con RoPE. Las otras 9 (cada sexta capa, más la última) atienden sobre el contexto completo con sin codificación posicional (NoPE).
- SSMax en las capas NoPE. Sin RoPE, la atención se aplana a medida que crece el número de claves. SSMax escala cada query por
(1 + p/2048)^0.1, dondepes la posición basada en 1, de modo que el softmax se agudiza a medida que crece el contexto. - GQA con norma Q/K por cabeza. 48 cabezas de query, 8 cabezas KV, dimensión de cabeza 128. Q y K se normalizan con RMS por cabeza antes de RoPE o SSMax.
- Puerta de salida sigmoide. Antes
o_proj, la salida de cada cabeza se multiplica por σ(gate + bias), donde la puerta proviene de su propia proyección de ancho completo con un sesgo aprendido por cabeza. Una cabeza puede atenuarse o apagarse token por token. - KV cache pequeño. Solo las 9 capas de atención completa conservan KV para toda la secuencia:
- 9 × 2 × 8 × 128 valores por token, o 36 KiB en BF16 y 18 KiB en FP8.
- Alrededor de 18 GiB de KV en FP8 para un contexto completo de 1M de tokens, antes del sharding.
MoE y flujo residual
- MoE al estilo DeepSeek-V3. 256 expertos enrutados (d_ff 2,560, NVFP4), enrutados de la misma manera que DeepSeek-V3: puntuaciones sigmoideas más un sesgo de corrección seleccionan los mejores 4 de 8 grupos de expertos, luego los 8 mejores expertos, y los pesos renormalizados se escalan por 2.5. A diferencia de DeepSeek-V3, no hay experto compartido. Las capas 0–2 usan un MLP SwiGLU denso (d_ff 20,480) en su lugar.
- Router en FP32. Los pesos del router de 5120 × 256, la acumulación y los logits son todos FP32.
- Norma sándwich. Cada subcapa tiene un RMSNorm antes y otro después.
- Residuos escalados por profundidad. La n-ésima suma residual calcula
h ← √((n−1)/n)·h + x/√nen lugar deh + x. Con salidas de subcapa de varianza unitaria, el flujo residual mantiene la varianza unitaria en cada profundidad en lugar de crecer con ella.
Optimización dirigida por agentes
Nuestra versión inicial de la implementación era una versión del modelo casi pura en PyTorch, sin optimizar. Luego la optimizamos de forma autónoma con agentes de codificación: perfilaban el modelo, escribían los kernels y evaluaban cada cambio. En TP8, los siete cambios siguientes redujeron el decode con batch-1 de 8.95 ms a 3.30 ms por paso, y un prefill de 8 × 2K de 328 ms a 176 ms.
Figura 2: latencia de model-forward en TP8 en GB200 después de cada cambio, para decode con batch-1 y un prefill de 8 × 2,048 tokens a ~100K de contexto. Los dos paneles usan escalas diferentes. Muestra la tabla para ver los valores exactos, o ábrela a pantalla completa.
- Norma → residual → norma fusionadas (−40% en decode). La post-norma, la suma residual escalada y la siguiente pre-norma en cada uno de los 104 límites de subcapa ahora se ejecutan como un solo kernel de Triton, con matemáticas en FP32 y los puntos de redondeo BF16 de la referencia.
- Norma Q/K, RoPE/SSMax y puerta de salida fusionadas. El RMSNorm de Q/K por cabeza y RoPE (o SSMax) se ejecutan como un solo kernel, y la puerta sigmoidea como otro.
- All-reduce fusionado en las normas. Ambos all-reduce de TP en cada capa se ejecutan dentro del kernel de norma, construido sobre el all-reduce multicast de FlashInfer. Después del MoE, el mismo kernel también combina las salidas de los 8 mejores expertos.
- Kernel GEMM especializado para el router en FP32. El router solía recurrir a una ruta genérica. El kernel de router FP32 para lotes pequeños de vLLM ahora admite la forma 5120 × 256 de Beam, manteniendo pesos, acumulación y logits en FP32.
- Proyección QKV + puerta combinada con un GEMM de baja latencia. Los pesos de Q, K, V y la puerta se empaquetan en una sola matriz al momento de cargar, de modo que las cuatro proyecciones se ejecutan como un solo GEMM. Para lotes pequeños usa un GEMM de baja latencia en CuTe DSL o el TinyGEMM de FlashInfer.
- Actualización fused de la caché KV. El kernel de norma Q/K y RoPE ahora también escribe K y V en la caché KV, por lo que no hay un kernel separado de escritura en la caché.
- Activación dense-MLP en un solo kernel para las tres capas dense.
El grafo fusionado
Después de estos cambios, una capa MoE se ejecuta como 13 kernels en decodificación batch-1 en TP8.
Figura 3: Kernels en orden de lanzamiento para una capa MoE, a partir de un trace de rank-0 de decodificación batch-1 TP8. Los kernels dorados fueron escritos, fusionados o extendidos para Beam. Cada kernel enumera las operaciones que calcula. Ábrelo a pantalla completa.
- 6 kernels fueron escritos, fusionados o extendidos para Beam. Cada pequeña operación específica de Beam se fusiona con un vecino, y ambos all-reduces viven dentro de kernels de norma.
- 7 kernels provienen de bibliotecas: atención TRTLLM-gen, la proyección de salida de cuBLAS y la ruta TRTLLM NVFP4 MoE (cuantización, dos kernels de routing, dos GEMMs agrupados). La mayor parte del tiempo restante está aquí, así que son lo siguiente.
Attention DP + MegaMoE
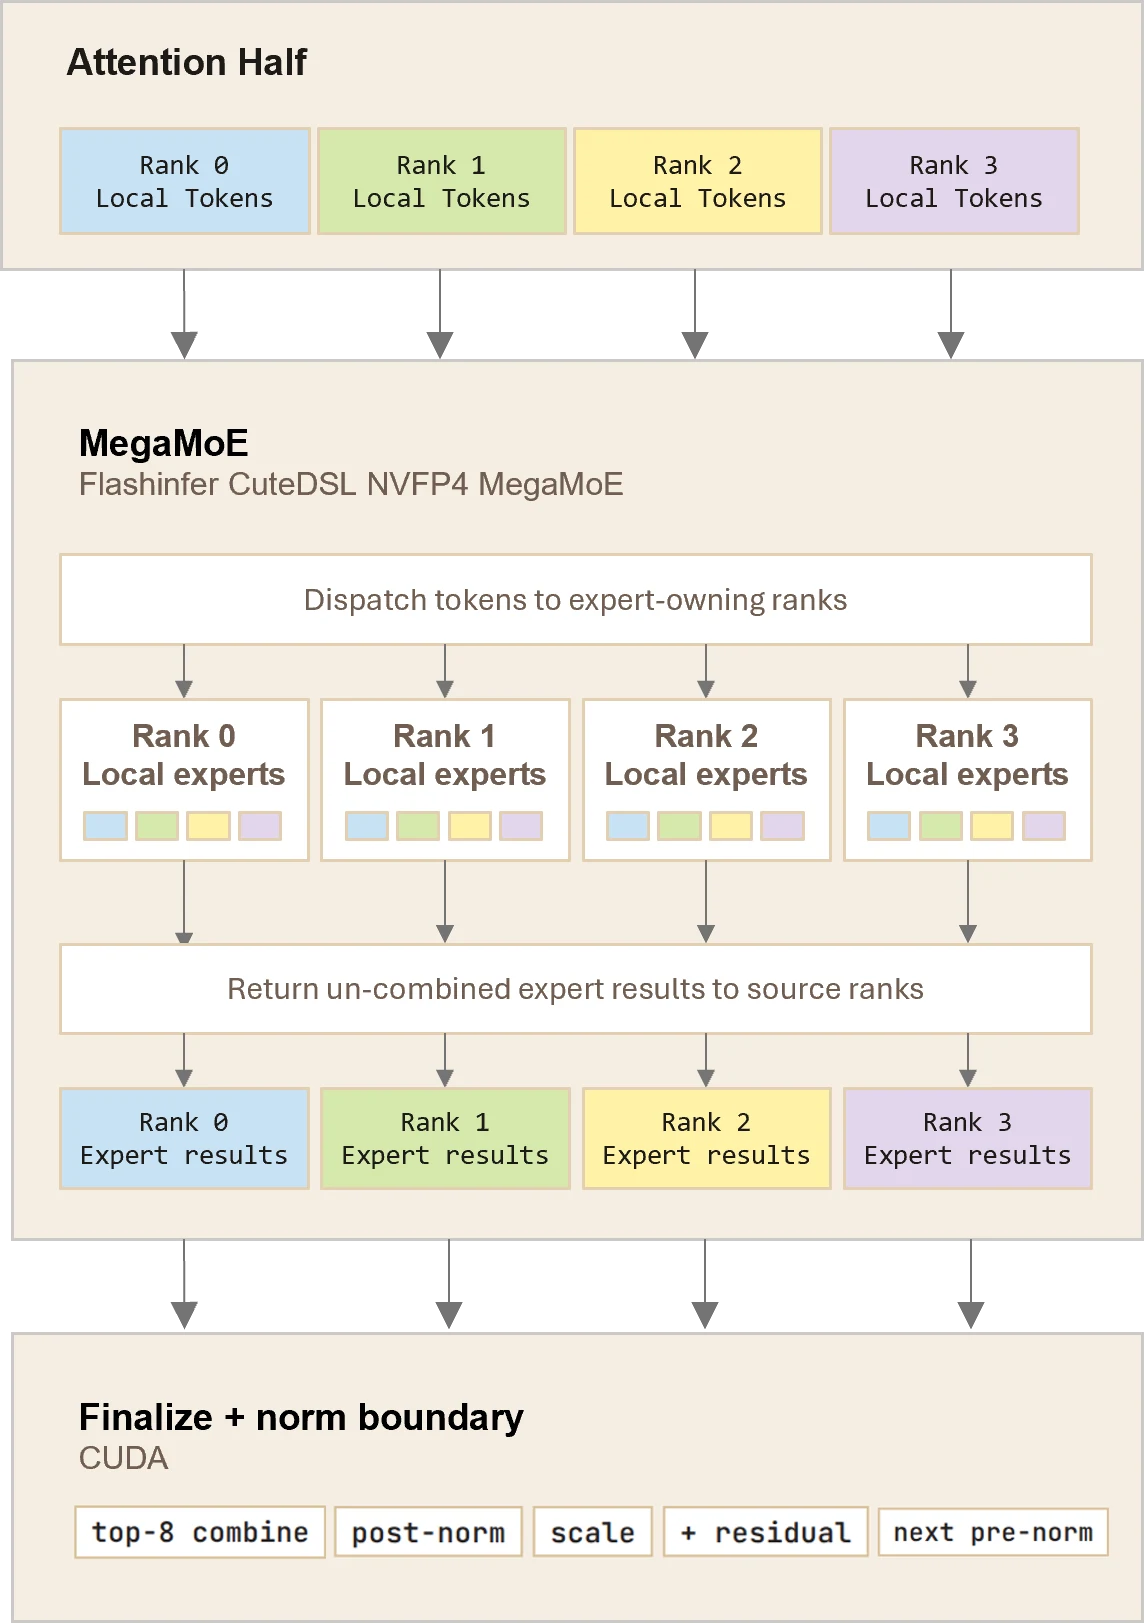
Figura 4: FlashInfer CuteDSL NVFP4 MegaMoE puede fusionar las comunicaciones con el cálculo de los expertos.
En la región de alta concurrencia, el rendimiento de Beam puede mejorarse aún más combinando Attention DP con MegaMoE, impulsado por el kernel CuTe DSL NVFP4 MegaMoE de FlashInfer. La fusión de frontera Finalize + norm sigue siendo aplicable.
| Configuración | Throughput máximo de tokens de entrada |
|---|---|
| Attention DP + MegaMoE | 168.8K tokens / segundo |
TP (flashinfer_trtllm, flashinfer_nvlink_one_sided) | 98.7K tokens / segundo |
Attention DP con MegaMoE entregó un throughput máximo de prefill 1.71× mayor que TP4. Configuración del benchmark: 4×GB300, con una longitud de secuencia de entrada de 32K tokens y una longitud de secuencia de salida de 1 token para aislar el rendimiento de prefill.
Para habilitar Attention DP + MegaMoE, reemplaza las configuraciones de MoE y paralelismo con:
  --moe-backend flashinfer_moe_ep_cutedsl \
  --data-parallel-size 4 \
  --enable-expert-parallel
Decodificación especulativa DFlash2
Beam se envía con una DFlash2 cabeza de borrador, que vLLM soporta desde el día 0. En lugar de redactar un token a la vez, predice un bloque completo de tokens en una sola pasada hacia adelante a partir de los estados ocultos del modelo objetivo.
- Borrador. 5 capas sliding-window que leen estados ocultos de 5 capas objetivo y comparten el embedding y el LM head del objetivo. Una convolución agrupada y un pequeño selector de candidatos restauran parte de la dependencia de izquierda a derecha que un borrador paralelo pierde.
- Verificación adaptativa. Con
"enable_adaptive_verification": true, vLLM predice cuán probable es que se acepte cada token borrador y verifica solo los que valen su costo, en lugar de un número fijo por paso. DFlash2 no tiene cabeza de confianza, por lo que la estimación de aceptación proviene de los propios logits del borrador (véase nuestra publicación reciente sobre verificación adaptativa). - Kernels. La convolución del borrador, las normas y las escrituras KV están fusionadas, y todo el paso de borrador se ejecuta en un grafo CUDA. La caché KV FP8 también funciona para el borrador, sin cambio en la aceptación.
Resultados de servicio en TP8, con y sin verificación adaptativa, en la categoría de baja entropía de SPEED-Bench's throughput_1k split: prompts de ~1K tokens, principalmente finalización de código y ordenamiento de texto, con decodificación greedy y hasta 4K tokens de salida. El texto de baja entropía es más fácil de predecir, así que espere una aceptación menor en chat abierto.
| Concurrency | Fixed draft (tok/s) | Adaptive (tok/s) | Change | Acceptance length |
|---|---|---|---|---|
| 1 | 708 | 707 | −0.1% | 3.71 → 3.61 |
| 8 | 3,232 | 3,221 | −0.3% | 3.67 → 3.57 |
| 32 | 7,744 | 8,275 | +6.9% | 3.68 → 3.29 |
| 128 | 15,012 | 16,632 | +10.8% | 3.68 → 3.23 |
La verificación adaptativa rinde bajo carga. A una concurrencia de 128 aumenta el rendimiento de salida en 10.8% y reduce el p99 TPOT en 9%, mientras verifica menos tokens borrador por paso, lo que reduce ligeramente la longitud de aceptación pero ahorra más cómputo del que pierde. A baja concurrencia, donde los tokens borrador adicionales son casi gratuitos, es neutral.
Cómo empezar
El comando al principio de esta publicación es un buen valor predeterminado: TP4 en un solo nodo GB300, con DFlash2 y caché KV FP8. Para habilitar la verificación adaptativa, añada "enable_adaptive_verification": true a la --speculative-config. Las demás optimizaciones anteriores están activadas por defecto.
- Elección de la configuración paralela.
- Para la menor latencia, usa TP4 o TP8.
- Para mayor rendimiento, usa atención en paralelo de datos con paralelismo de expertos, p. ej.
-dp 4 --enable-expert-parallel.
- Razonamiento y llamadas a herramientas. Los
beamparsers leen la plantilla de respuesta que viene con el checkpoint. Por defecto, vLLM también restringe cada respuesta a esa plantilla, de modo que las llamadas a herramientas siempre se analizan y coinciden con el esquema JSON de cada herramienta.response_formatythinking_token_budgetfuncionan como de costumbre. Para desactivar la restricción predeterminada, configuraVLLM_BEAM_ALWAYS_CONSTRAIN_OUTPUT=0.
Soporte desde el Día 0 para RL con SkyRL
También colaboramos con el equipo de SkyRL para habilitar el soporte desde el Día 0 para RL en Beam. LoRA, el ajuste fino completo en BF16 y el RL en MXFP8 son compatibles de fábrica, con una pila de RL mejorada para la escala de 500B.
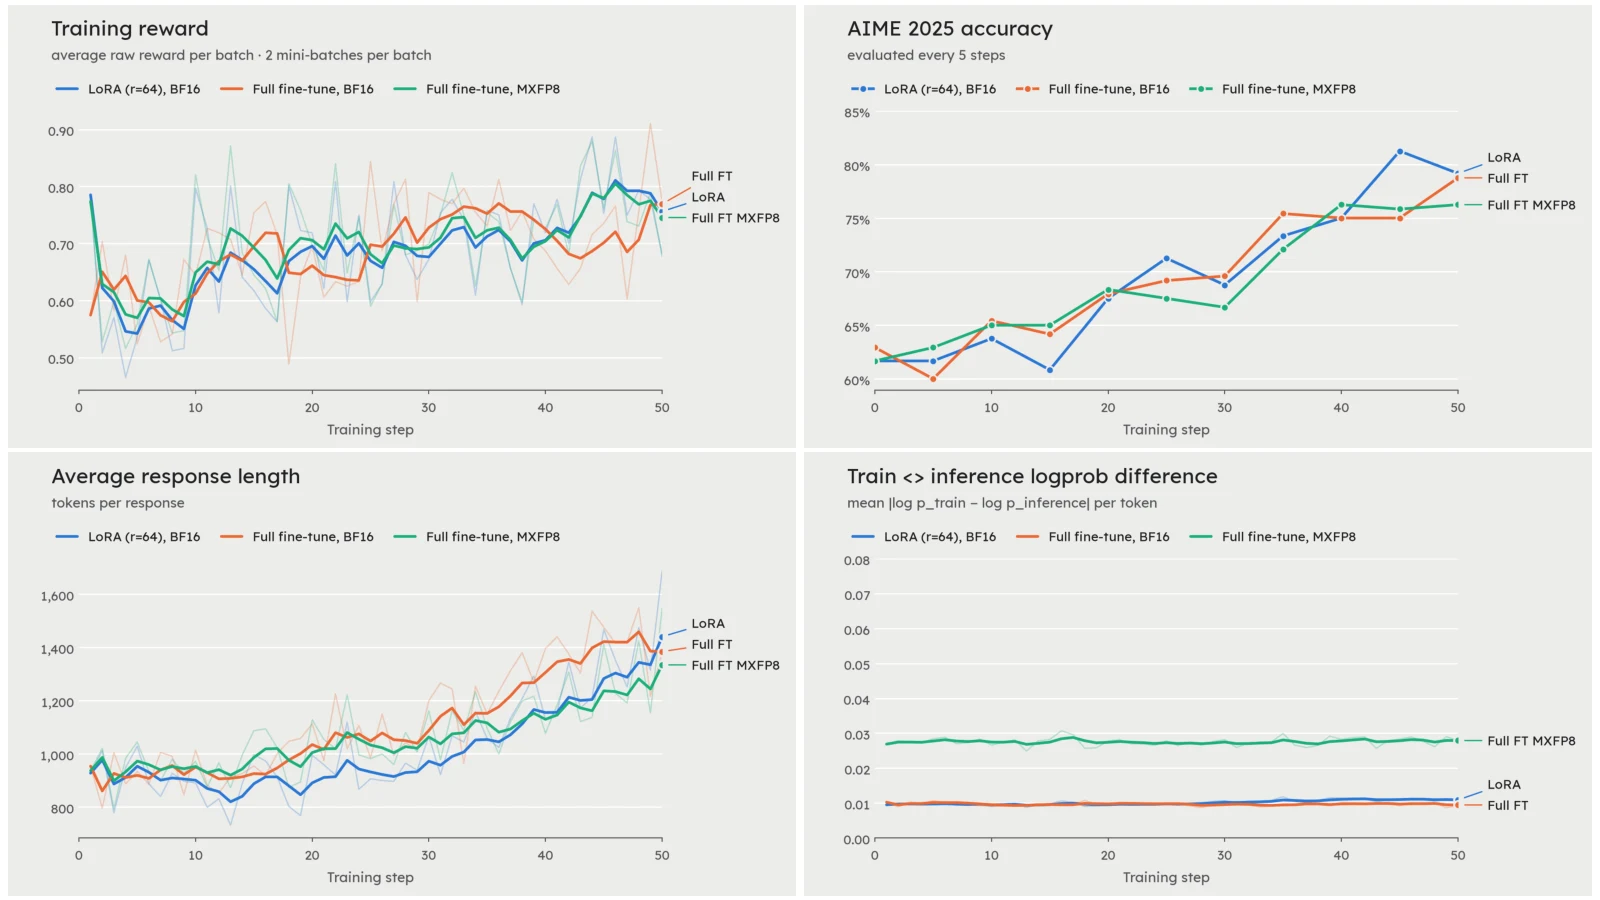
El equipo de SkyRL realizó el post-entrenamiento del modelo Beam con la receta DAPO usando vLLM para inferencia y Megatron para entrenamiento. LoRA, el ajuste fino completo y el RL en MXFP8 logran mejoras similares de rendimiento en 50 pasos de entrenamiento, o 100 actualizaciones del optimizador (razonamiento minimal), con un salto en la precisión promedio (avg@8) de ~61% a ~79% en AIME25. La diferencia absoluta promedio de log-probabilidad entre Megatron y vLLM se mantiene por debajo de 0.01 con Rollout Routing Replay (R3) habilitado para LoRA y el ajuste fino completo en BF16, y por debajo de 0.03 para el RL en MXFP8.
¡Echa un vistazo al blog de SkyRL para más detalles!
Agradecimientos
Este trabajo fue una estrecha colaboración entre los equipos de Inferact, Reflection y Nvidia:
- Inferact: Woosuk Kwon, Ziqi Zhao, Ao Shen, Tiezhen Wang
- Reflection: Kaixing Wu, Yoni Gozlan, Neil Gollapudi, Thibaut Barroyer, Aymen Kallala, Matthias Reso, Florent Gbelidji
- Nvidia: Siyuan Fu