
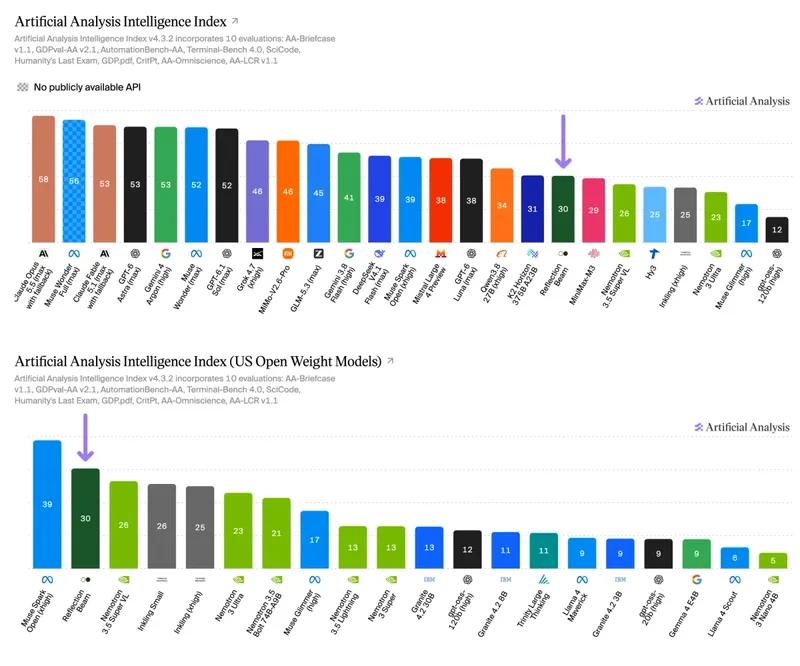
Beam, el primer modelo de Reflection, obtiene 30 puntos en el Artificial Analysis Intelligence Index, lo que lo sitúa en el #2 entre los modelos abiertos de pesos de EE. UU.
Ver la página del modelo Ver la página del modeloBeam es un modelo de pesos abiertos con 501B de parámetros totales y 23B activos
Conclusiones clave:
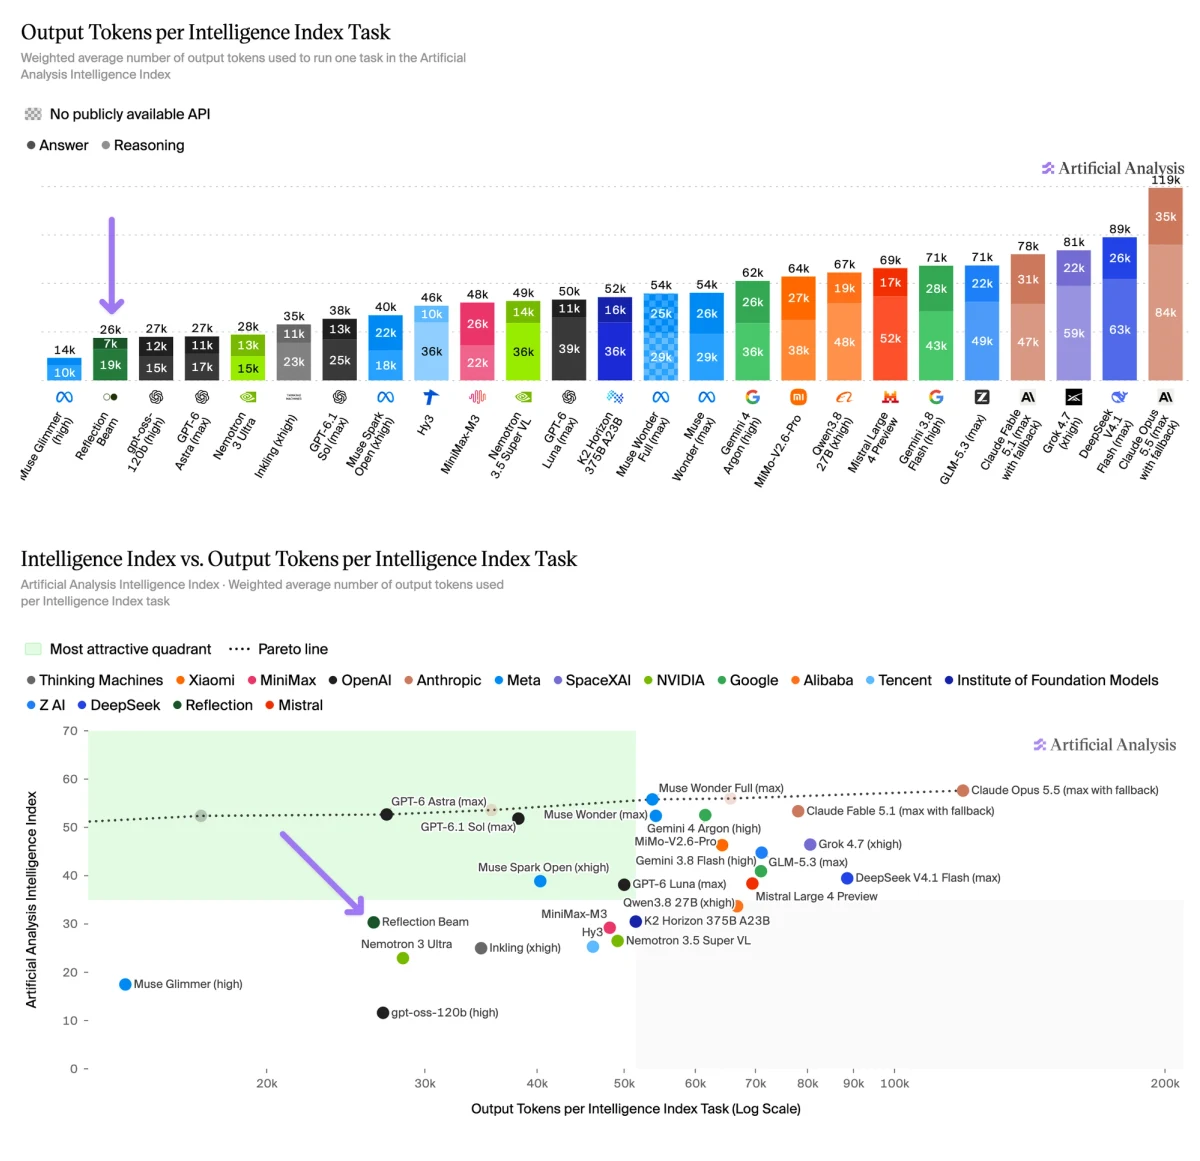
➤ Segundo entre los modelos abiertos de pesos de EE. UU.: Beam obtiene 30 puntos, solo por detrás de Muse Spark Open de Meta (39) y por delante del lanzamiento de ayer de NVIDIA Nemotron 3.5 Super VL (26). Fuera de China, solo Muse Spark Open y K2 Horizon de los EAU (31) obtienen puntuaciones más altas
➤ Eficiente en tokens para su inteligencia: Beam usa ~26k tokens de salida por tarea del Intelligence Index en comparación con K2 Horizon, que está un punto por delante y usa el doble (~52k). Los modelos propietarios siguen marcando la frontera, con GPT-6 Astra (max) obteniendo 53 puntos con el mismo presupuesto (~27k)
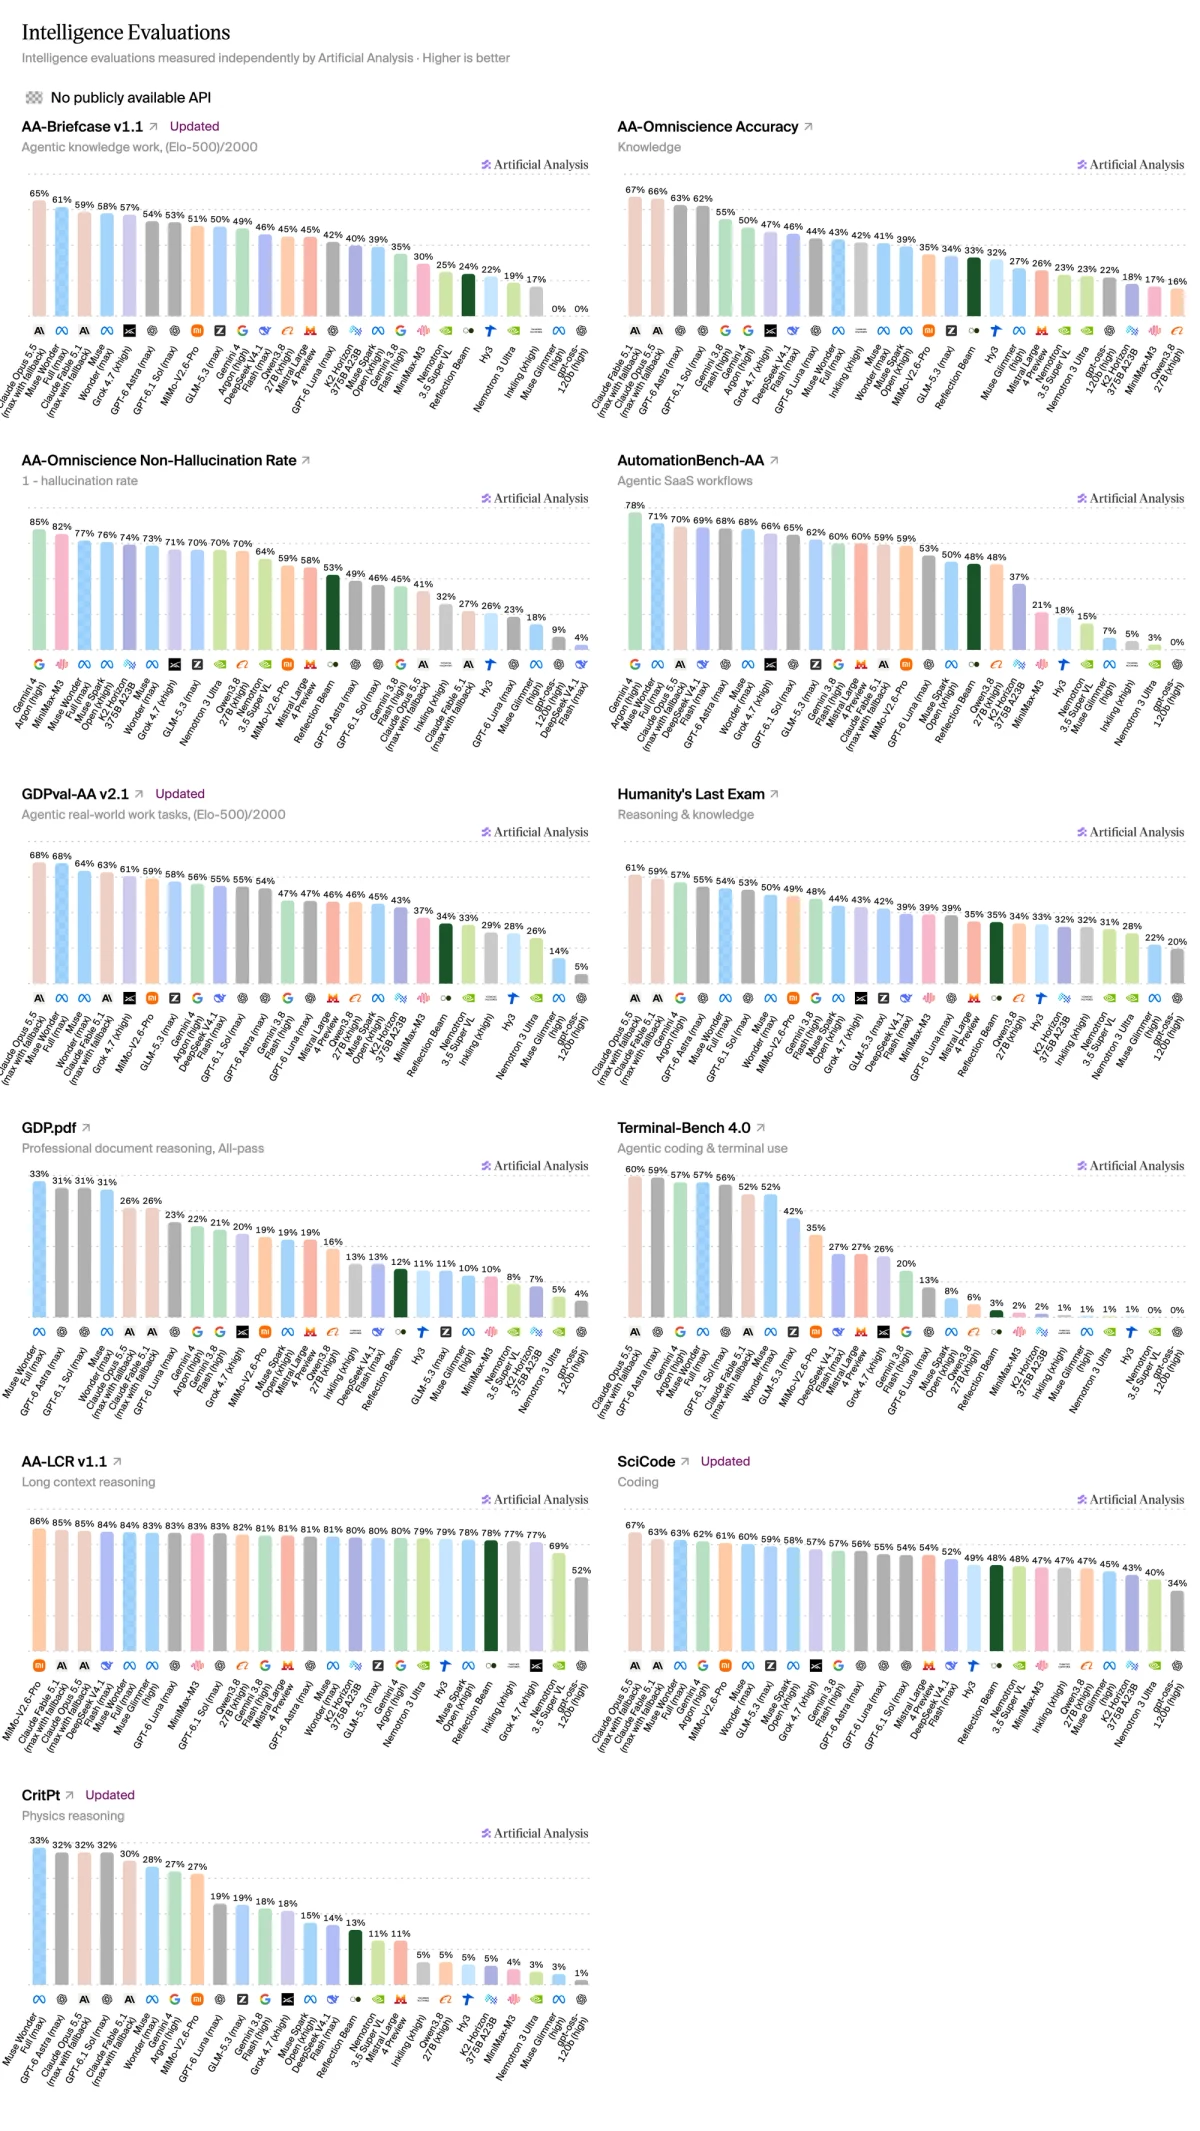
➤ Fuerte en flujos de trabajo agénticos, más débil en la terminal: Beam obtiene 48.5% en AutomationBench-AA, 11 puntos porcentuales por delante de K2 Horizon (37.2%) y a la par con Qwen3.8 27B (48.2%). Terminal-Bench 4.0 es su punto débil, donde Beam obtiene 3.0%, por detrás de Qwen3.8 27B (5.6%) y Muse Spark Open (8.1%)
➤ Sabe más, adivina más: En AA-Omniscience responde correctamente al 33% de las preguntas, muy por delante de K2 Horizon (18%) y Qwen3.8 27B (16%). Pero su tasa de alucinación es del 47%, frente al 26% de K2 Horizon y el 30% de Qwen3.8 27B, lo que le da a Beam una puntuación neta de índice de 1.5, por delante de ambos competidores (−3.0 y −10.0)
Otros detalles del modelo
- Ventana de contexto: 1M de tokens
- Modalidades: Texto
- Parámetros: 501B / 23B
Comparado con sus pares de pesos abiertos
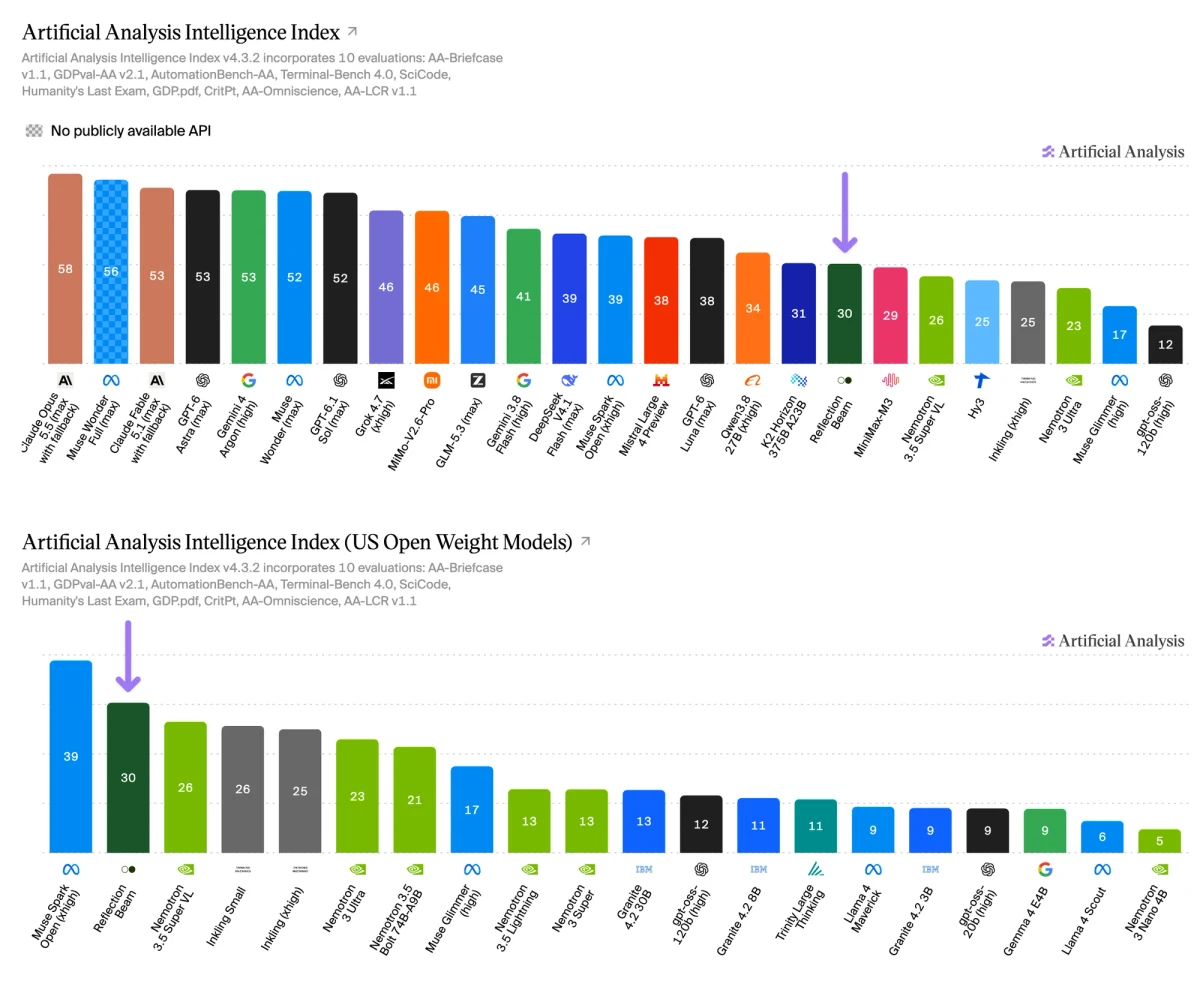
Beam obtiene puntuaciones altas frente a los modelos abiertos de pesos de EE. UU., por detrás de Muse Spark Open de Meta (39) y por delante de Nemotron 3.5 Super VL de NVIDIA (26), todos lanzados esta semana. Entre todos los modelos de pesos abiertos ocupa el décimo lugar, un punto por detrás de K2 Horizon (31)
Capacidades cibernéticas
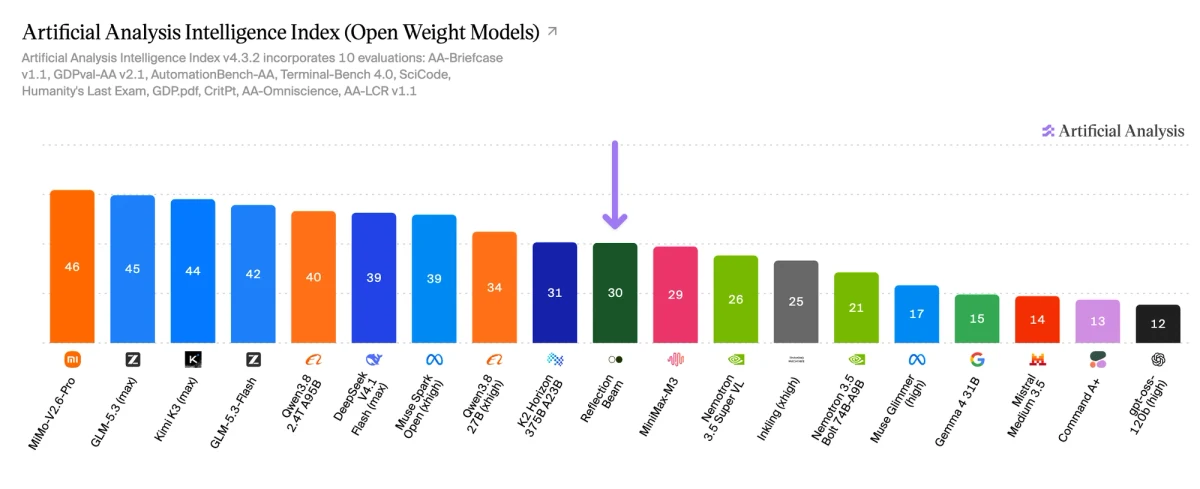
Beam completa el 34% de las tareas del Artificial Analysis Cyber Index, lo que lo convierte en el modelo abierto de pesos de EE. UU. líder entre los que hemos probado
Impulsado por su eficiencia en tokens, también se sitúa en la frontera del Cyber Index frente a los tokens de salida por tarea, junto a GPT-6 Sol (Daybreak Blue)
Altamente eficiente en tokens
Beam usa ~26k tokens de salida por tarea del Intelligence Index: ~19k para razonamiento y ~7k para respuestas. Solo el 26% de su salida se destina a las respuestas finales, la 28.ª participación más baja de los 219 modelos probados en Intelligence Index v4.3
Habilidades de programación
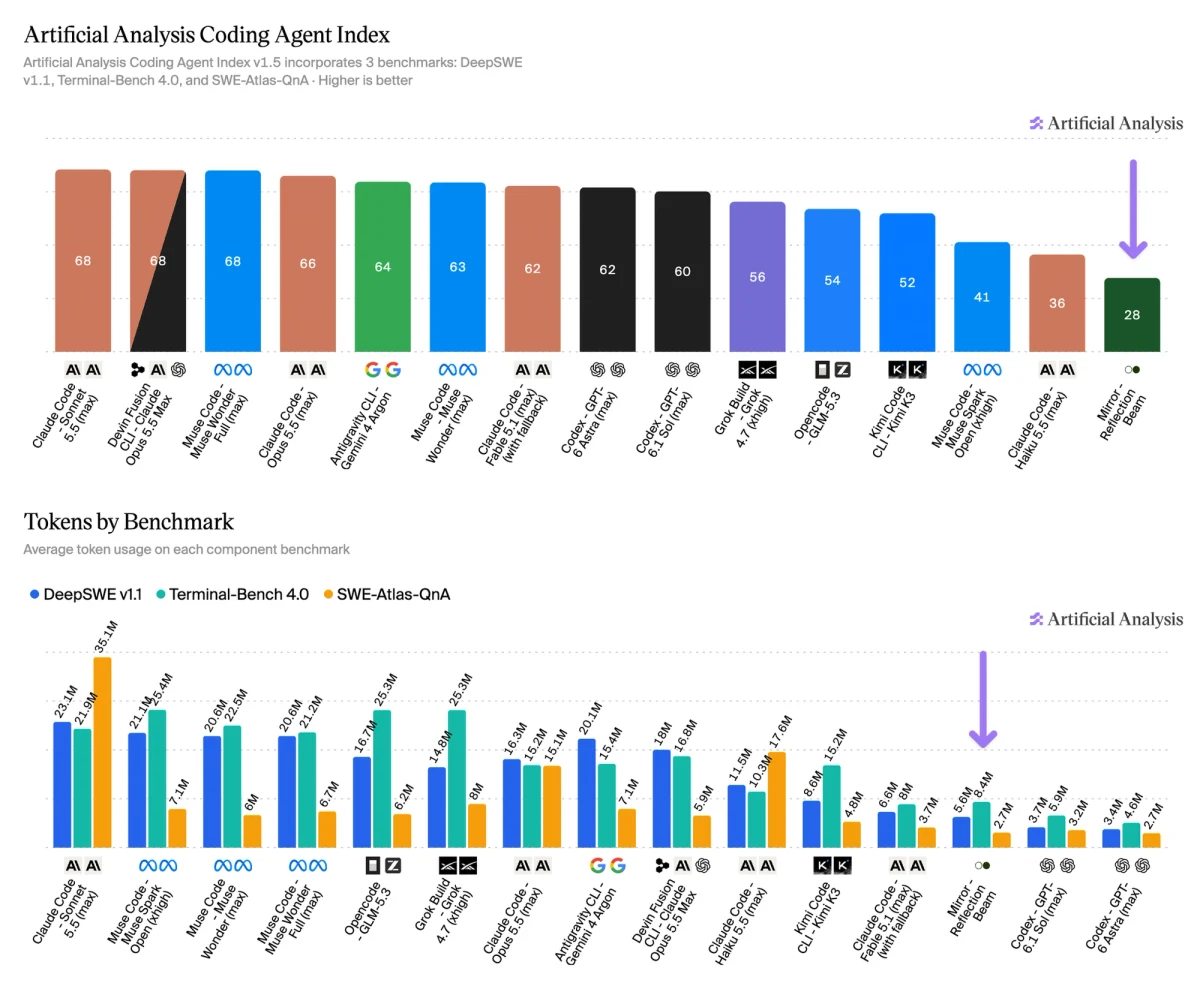
Ejecutándose en Mirror, el harness CLI de código abierto de Reflection, Beam obtiene 28 puntos en el Artificial Analysis Coding Agent Index. Queda 15 puntos por detrás de la siguiente configuración, Claude Code con Qwen3.8 Max (43), y 40 por detrás de los líderes (68). Sin embargo, es frugal: solo Codex con GPT-6 Astra y Codex con GPT-6.1 Sol usan menos tokens
Componentes del Intelligence Index
En las diez evaluaciones del Intelligence Index, Beam destaca en AutomationBench-AA (48.5%) y CritPt (13.1%), donde más que duplica a K2 Horizon (4.6%) y a Qwen3.8 27B (5.4%). Sus resultados más débiles son en Terminal-Bench 4.0 (3.0%) y AA-Briefcase (976 Elo).
Detalles completos en la página de Beam en Artificial Analysis https://artificialanalysis.ai/models/reflection-beam