
¿Está la interpretabilidad de la IA cerca de un avance significativo? Un nuevo ensayo ha dividido a los investigadores
 Maximilian Schreiner
Ver el perfil de LinkedIn de Maximilian Schreiner
Oct 16, 2026
 Nano Banana Pro solicitado por THE DECODER
Según Nick Cammarata, uno de los responsables de la hipótesis de superposición, las redes neuronales no son tan complicadas como lo había supuesto los investigadores. Roon, de OpenAI, lo considera un momento histórico. Neel Nanda, investigador de Google DeepMind, advierte contra una exageración excesiva.
En un ensayo titulado “Los redes neuronales ya están limpias”, Nick Cammarata argumenta que el funcionamiento interno de los grandes modelos de IA es mucho más fácil de entender de lo que se pensaba anteriormente. Cammarata es investigador en el laboratorio de interpretabilidad Goodfire. Con este ensayo, rechaza una explicación que ayudó a formar hace años.
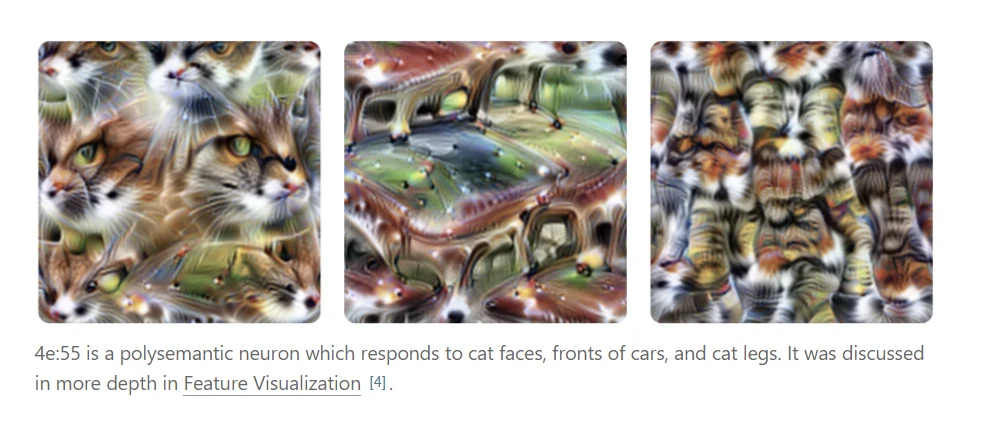
La interpretabilidad mecánica intenta hacer algo más que simplemente observar lo que produce un modelo de IA. Su objetivo es rastrear cómo el modelo llega a sus respuestas internamente. Idealmente, cada uno de los millones de neuronas artificiales representaría un concepto reconocible. En la práctica, muchas neuronas parecían activarse en cosas completamente diferentes, lo que los investigadores denominan polisématicidad. Un ejemplo temprano y famoso es una neurona en el modelo de imagen InceptionV1, que respondió tanto a caras de gatos como a los parabrisas de coches. Cammarata lo utilizó como ejemplo en su propia investigación inicial.
La explicación estándar era la superposición. La teoría sostiene que cuando una red se queda sin neuronas, agrupa conceptos no relacionados en las mismas neuronas, ya que rara vez se interponen entre sí. El resultado es como un nudo. Por eso, muchos laboratorios entrenan un segundo modelo, como un autoencoder escaso, para separar los conceptos. Luego estudian ese modelo en lugar del original.
Cammarata desempeñó un papel importante en la formación de esta visión. Con Chris Olah, coescribió el artículo “Zoom In”, que introdujo el primer circuito de superposición. En 2023, inició un proyecto de interpretabilidad automatizada en OpenAI. En ese momento, solo alrededor del 1.7 por ciento de las neuronas se consideraban comprensibles, incluso con la medida más generosa.
La evidencia podría haber sido mal leída
Cammarata ahora cree que los ejemplos más famosos fueron mal interpretados. Dice que el neurónico del gato y el coche es realmente un detector de forma en V. Formas puntudas como las fauces de zorro o las llamas lo activan, mientras que formas redondas como la letra O lo hacen inactivo. Por lo tanto, no representa dos conceptos completamente separados como los rostros de gatos y los coches, lo que significa que no es un ejemplo de superposición.
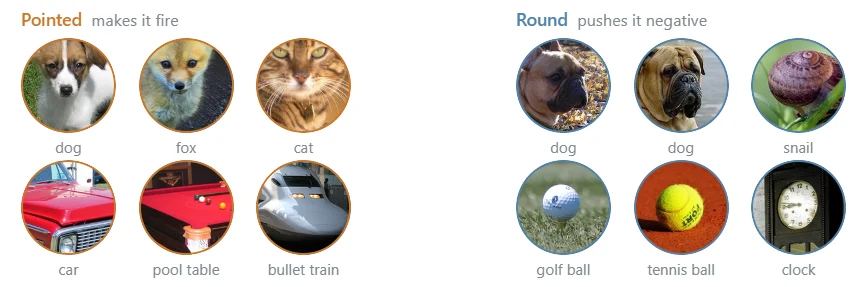
También reinterpreta el circuito de superposición de “Zoom In”, donde un coche parecía ocultarse entre neuronas de perro. En su opinión, se trata de una generalización común, y el circuito simplemente agrupa coches y perros según la dirección en la que se enfrentan a la cámara. Culpa la arquitectura obsoleta y las herramientas de análisis débiles por el desorden en los últimos niveles de InceptionV1.
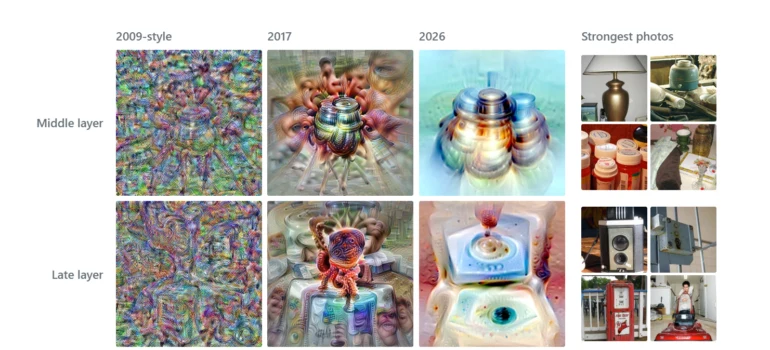
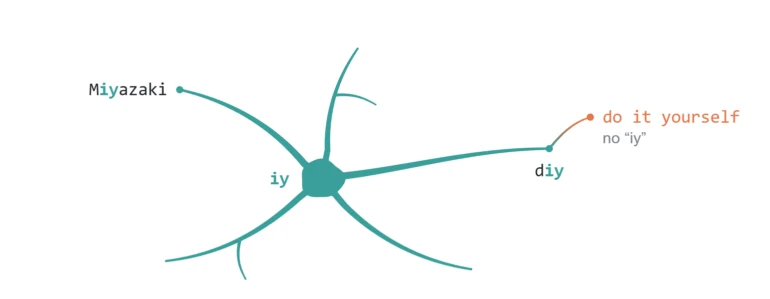
Cammarata explica la ambigüedad restante con un patrón que llama “generalización recursiva”. Dice que una neurona crece como una rama que brota numerosas ramas adicionales. Una neurona que reconoció la secuencia de letras “iy” respondió posteriormente a “diy” y, finalmente, a “hazlo tú mismo”, lo cual no contiene “iy” en absoluto. A diferencia de la superposición, estos grupos pueden enseñarte algo sobre la red.
Para los modelos de lenguaje, ofrece cifras preliminares. En Qwen3-32B, aproximadamente el 90 por ciento de los polos neuronales tiene una función principal, y alrededor del 7 por ciento tiene dos funciones relacionadas. Solo el 2 al 4 por ciento permanece sin explicación. Goodfire dice que observa resultados similares en modelos con hasta trillones de parámetros. Los agentes de IA que analizan neuronas en masa realizaron la mayor parte del trabajo. Cammarata toma prestado del “Bitter Lesson” de Rich Sutton y concluye que, en cuanto a la interpretabilidad, también es mejor realizar una investigación simple a escala masiva que métodos de descomposición inteligentes.
Cammarata no introduce una metodología fundamentalmente nueva. Vuelve al enfoque original del campo de estudiar los neuronas directamente, solo con herramientas mejoradas, modelos más grandes y agentes automatizados.
Las redes legibles serían una gran victoria para la seguridad de la IA
Si Cammarata tiene razón, sería buena noticia, especialmente para la seguridad de la IA. En este momento, aparte de monitorear cadenas de pensamiento que se vuelven cada vez menos confiables, hay pocas formas de saber si un modelo engaña a las personas o se comporta de manera peligrosa. Cammarata duda de que el alineamiento, el trabajo de guiar a la IA hacia objetivos humanos, pueda resolverse sin interpretabilidad, porque de lo contrario no sabemos qué estamos construyendo. El engaño no tiene razón alguna para ocultarse de los circuitos del propio modelo, escribe. Si los humanos se convierten en otro “lector” de la red, también podrán ver el engaño, y los errores podrían corregirse de manera específica.
Roon, un empleado de OpenAI que publica bajo ese seudónimo en X y es una voz influyente en los círculos de IA, estaba entusiasmado. Dice que es amigo cercano de Cammarata y que nunca habría llegado a OpenAI sin él. El trabajo “podría ser recordado como un momento importante en la historia científica”, Roon escribió. Añadió que las noticias son tan buenas que incluso Eliezer Yudkowsky, una de las voces más destacadas que advierten sobre una catástrofe de IA, tendrá que reducir sus estimaciones sobre la probabilidad de un desastre. En opinión de Roon, el alineamiento podría convertirse en una “ciencia normal”.
Incluso Roon tiene algunas reservas. Otros en el campo aún necesitan confirmar los resultados, y él sospecha que avances en la interpretabilidad impulsarán las capacidades de la IA. El hecho de que provengan de fuera no es una buena señal para los grandes laboratorios, incluido OpenAI.
Nanda ve una herramienta útil, no un avance revolucionario
Neel Nanda es mucho más medido. Se considera una de las figuras fundadoras de la interpretabilidad mecánica y lidera el equipo de interpretabilidad en Google DeepMind. Antes de eso, trabajó en Anthropic y como investigador independiente. Según él, sus puntos de vista han cambiado: desde mediados de 2024, se ha vuelto más pesimista con respecto a la interpretabilidad ambiciosa y ha preferido enfoques pragmáticos. Su equipo ha dado prioridad menor a la investigación sobre autoencoders dispersos. No pensaron que la técnica era inútil, pero no parecía valer la pena el esfuerzo que el campo estaba haciendo en ella.
El trabajo de Cammarata es interesante, pero en realidad no cambia el panorama general, Nanda escribe. El análisis basado en neuronas podría ayudar con cuestiones prácticas, como por qué un modelo hace algo cuestionable, y es mucho más fácil aplicarlo a modelos emergentes. Pero él no cree que la interpretabilidad esté cerca de ser completamente resuelta. Espera que el análisis basado en neuronas tenga defectos graves y también falte mucho.
Nanda sigue creyendo que la superposición es real. Argumenta que los modelos de lenguaje almacenan muchos más hechos de los que tienen neuronas, y en particular, las activaciones débiles probablemente contienen gran parte de esa información. Duda de que los hallazgos de los pequeños modelos de imágenes se extiendan a otros contextos. También cree que el ensayo define la monosemanticidad de manera demasiado amplia, pero reconoce a Cammarata por haber revisado su trabajo antiguo con herramientas modernas.
Parte de la disputa se reduce a las definiciones: Cammarata no tiene problema con los modelos que representan más conceptos que sus dimensiones, y Nanda lo considera en acuerdo en ese punto. Lo que Cammarata discute es que las redes agrupan arbitrariamente cosas completamente desconectadas entre sí.
El artículo de acompañamiento técnico aún no se ha publicado. Como empresa dedicada a la interpretabilidad, Goodfire también tiene un interés evidente en esta tesis. Si la interpretación de Cammarata es correcta, cree que los investigadores automatizados podrían lograr en meses lo que los humanos tardaron casi una década en hacer con los modelos de imágenes. Escribe que quizás no quede mucho tiempo para ello.
Noticias sobre IA Sin El Efecto de Excitación – Seleccionadas por Humanos
Suscríbase a THE DECODER para leer sin anuncios, un boletín semanal sobre IA, nuestro informe exclusivo “AI Radar” seis veces al año, acceso completo al archivo y acceso a nuestra sección de comentarios.
Lea más adelante para ver el panorama completo.
Suscríbase para una cobertura sin espectáculo.
- Acceso completo a cada artículo en THE DECODER
- Sin anuncios
- Únete a los comentarios y a las discusiones de la comunidad
- Resumen semanal de noticias sobre IA por correo
- 6 veces al año: “AI Radar” — análisis profundos sobre los temas de IA que son más importantes
- Noticias diarias sobre IA, siempre al día
- Nuestro archivo completo de diez años
- Cubierto por un equipo con más de 10 años en IA