

El Gemini 4 Argon de Google está más cerca de la frontera de la IA que cualquier modelo de Google en meses
 Matthias Bastian
Ver el perfil de LinkedIn de Matthias Bastian
Oct 16, 2026
 Google
 Deepmind es el segundo laboratorio de IA importante que supera el 95 por ciento en el benchmark ARC-AGI-3. Pero los resultados dependen en gran medida del método de prueba, y Argon supera a sus rivales en matemáticas y ingeniería de software, según Epoch AI.
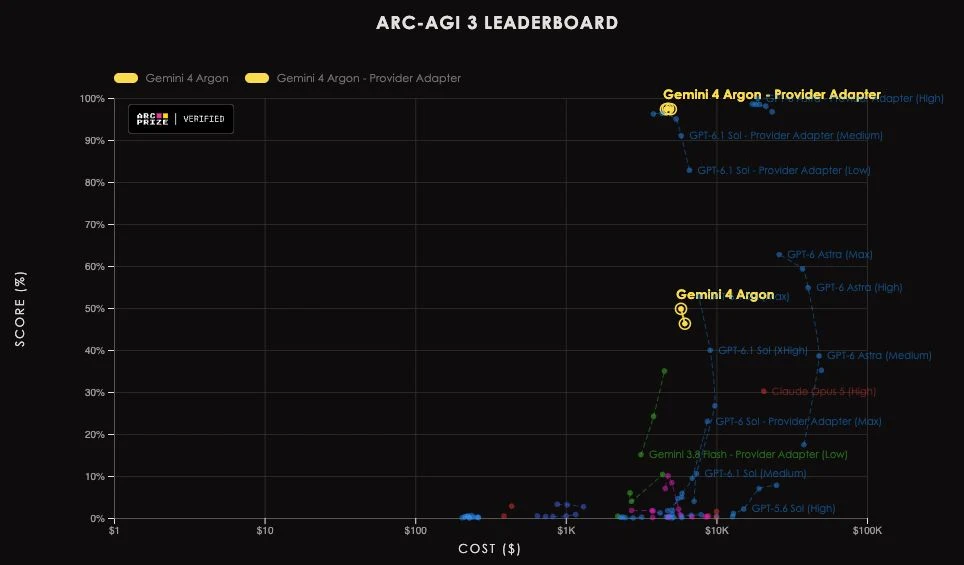
El nuevo modelo frontier de Google Deepmind, Gemini 4 Argon, obtuvo un 97.5 por ciento en ARC-AGI-3 a un costo de $4,800, utilizando el “Provider Adapter Harness”, una configuración de prueba que emplea características específicas del proveedor, como el razonamiento retenido y la compresión del contexto. Según el ARC Prize, Google es ahora el segundo laboratorio de IA después de OpenAI en alcanzar el 95 por ciento en lo que se considera el benchmark más difícil para la resolución de problemas generales. Solo GPT-6 Astra obtiene una puntuación más alta, del 99.9 por ciento.
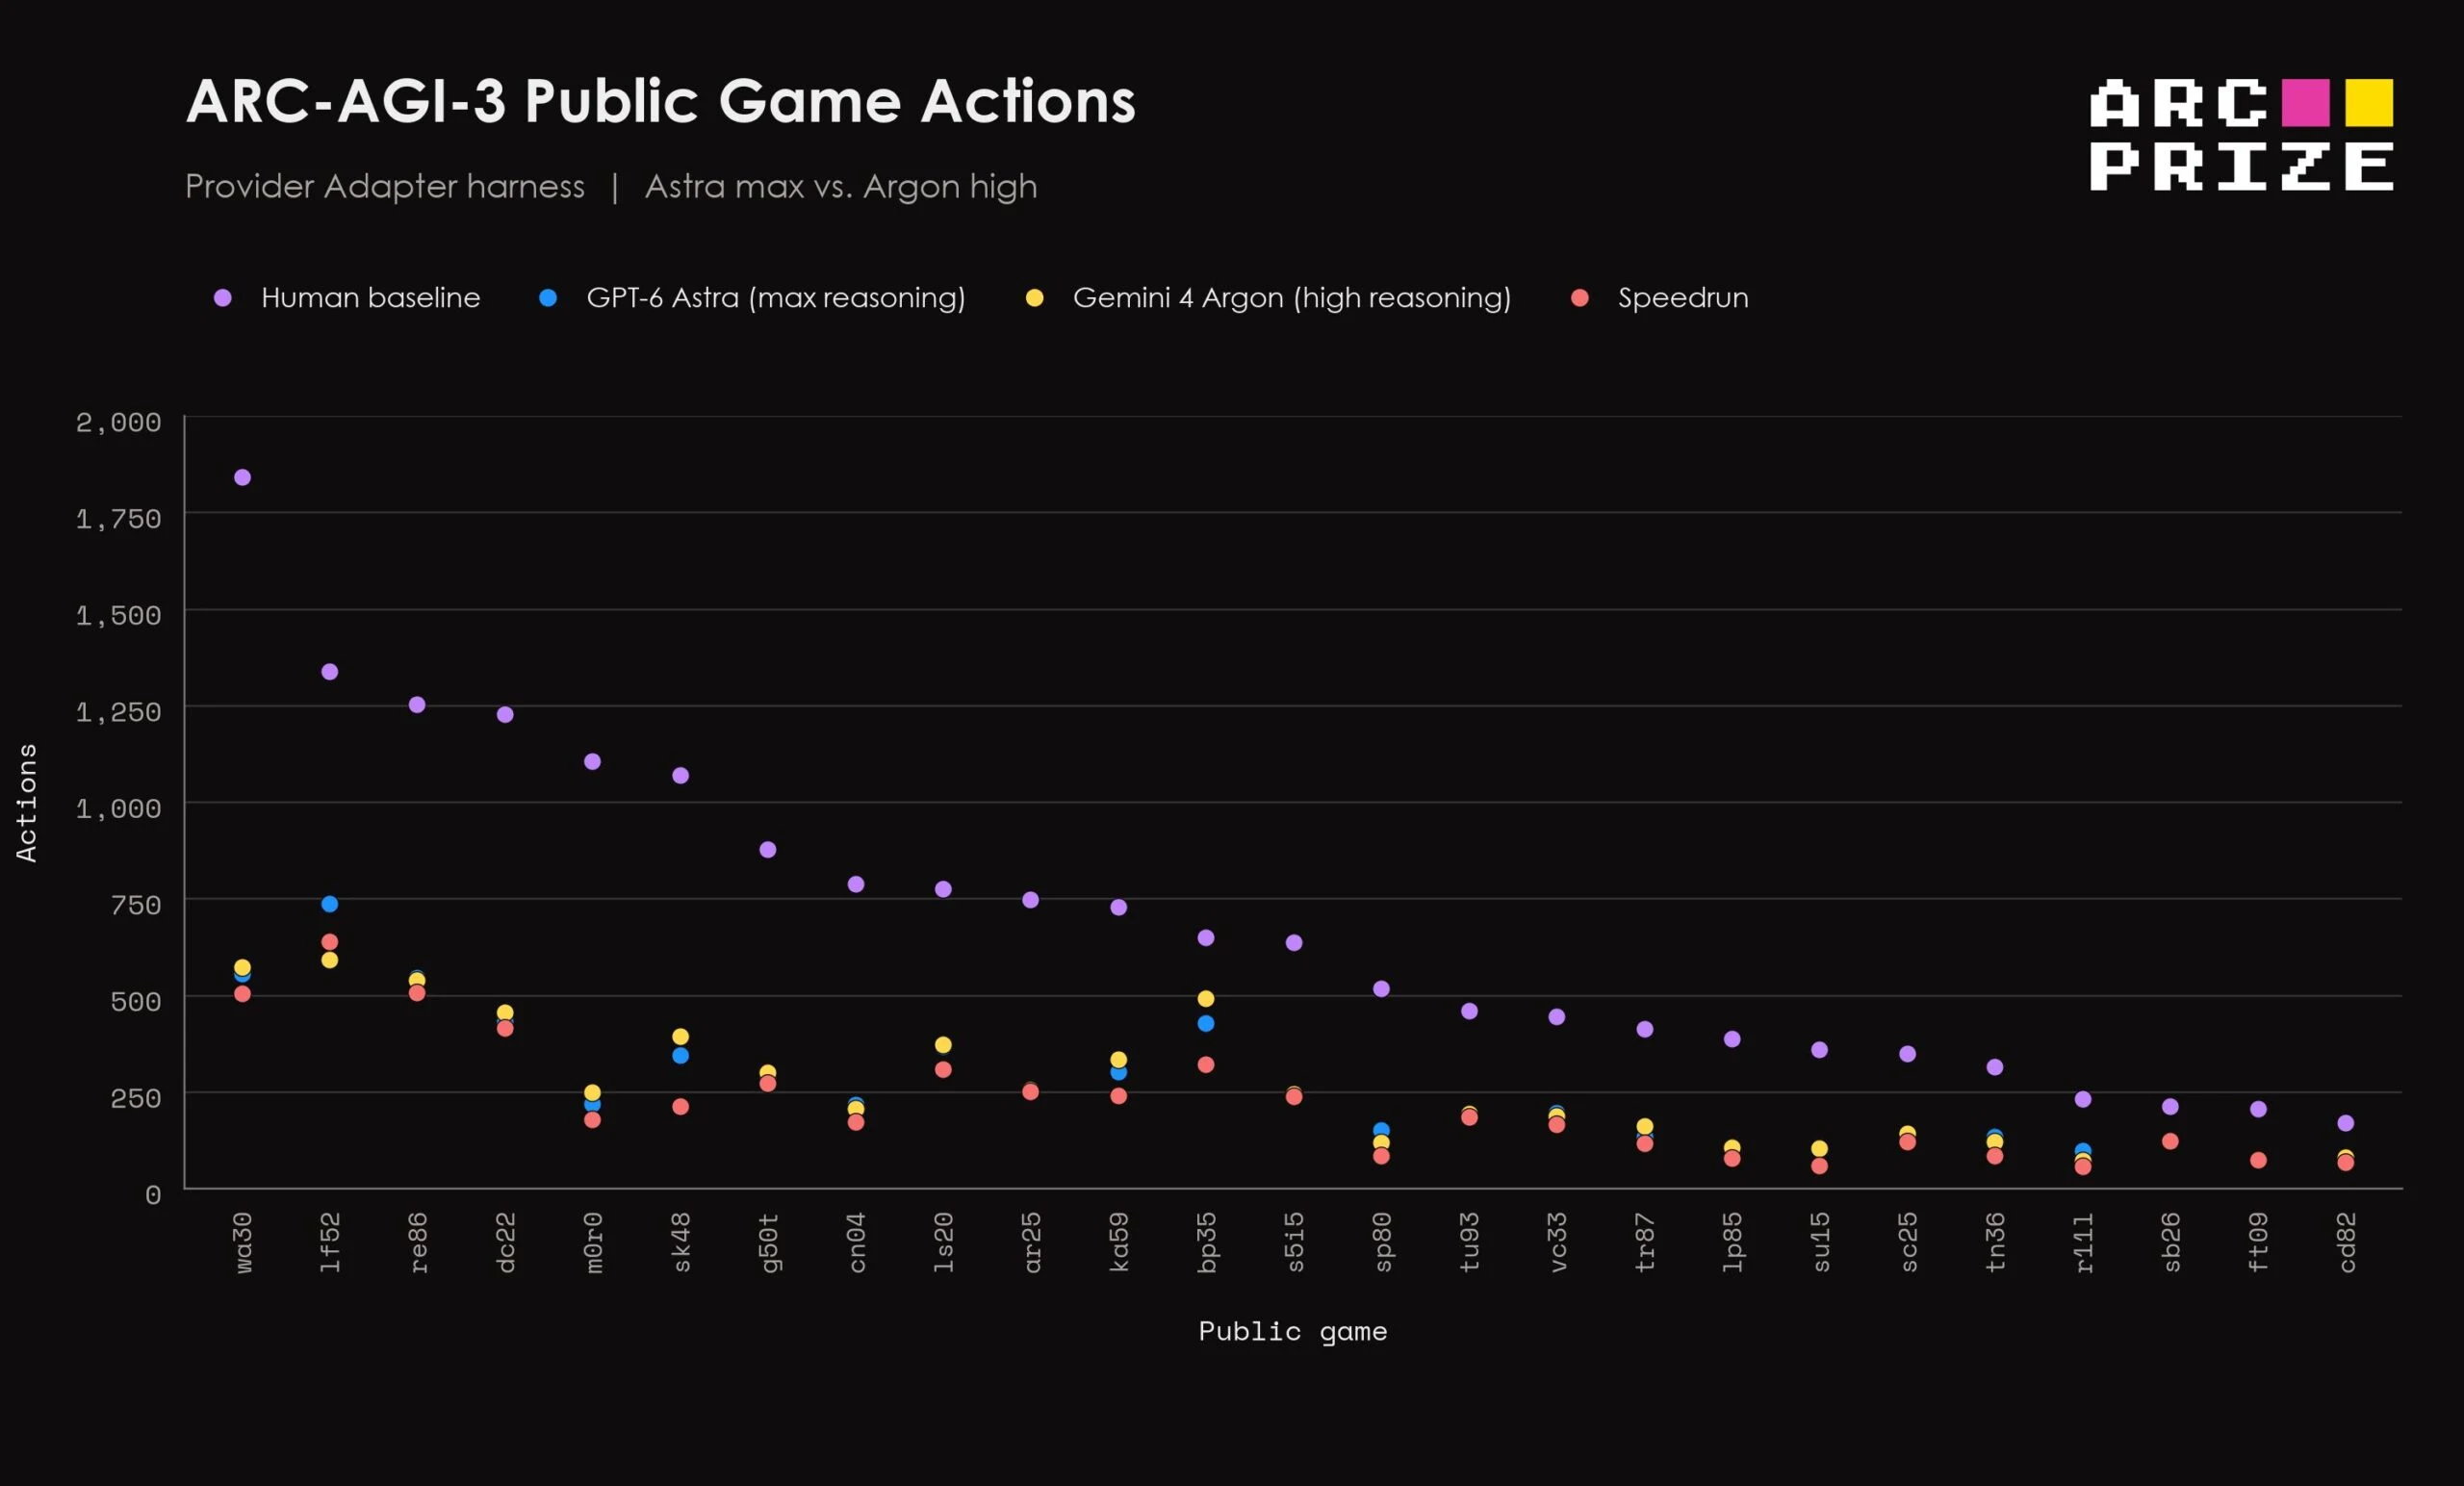
Al igual que Astra, Argon necesitó un 62 por ciento menos de acciones que el nivel humano en los 25 juegos públicos. En tres juegos alcanzó o superó el récord de speedrun, y en seis otros juegos estuvo a tan solo un 10 por ciento del mejor tiempo. En versiones anteriores del benchmark, Argon obtuvo un 91.3 por ciento en ARC-AGI-2 (0.32 dólares por tarea) y un 98.5 por ciento en ARC-AGI-1 (0.16 dólares por tarea), basándose en el precio inicial de 2 dólares por millón de tokens de entrada y 10 dólares por millón de tokens de salida.
Los resultados del benchmark dependen en gran medida de la configuración de prueba
En el “Standard Harness”, que solo permite notas simples entre rondas, Argon cae al 49.8 por ciento en baja razonabilidad por $5,800. Esta diferencia se remonta a una disputa en julio de 2026, cuando OpenAI’s GPT-5.6 Sol superó a Claude Opus 5 en ARC-AGI-3 utilizando dos configuraciones de API.
GPT-5.6 Sol solo logró el 7.8 por ciento en el entorno estándar, ya que descartaba el razonamiento interno después de cada acción y utilizaba una interfaz antigua que carecía de las características de la nueva API de Claude. Eso significa que Claude fue probado en condiciones diferentes a GPT-5.6. Cuando se probó con la propia API de Respuestas de OpenAI, incluyendo “Razonamiento Retenido” y el contexto inteligente “Compaction”, el modelo alcanzó el 38.3 por ciento y superó a Opus 5 con un 30.2 por ciento. OpenAI argumentó que los puntos de referencia también miden siempre el entorno técnico. Luego, Francois Chollet, cofundador del Premio ARC, permitió configuraciones de API generales y disponibles públicamente.
Los problemas de la API también impidieron que Argon completara todos los 55 juegos en el Standard Harness, según los probadores. A nivel bajo, el sistema completó 42 juegos (49.8 por ciento), a nivel medio, 46 juegos (46.3 por ciento). En el nivel más alto, solo se completaron 19 juegos, por lo que ARC Prize no publicó una puntuación. Los resultados reportados incluyen todos los 55 juegos, con puntos parciales de las rondas abortadas.
Argón cierra la brecha, pero se queda atrás en matemáticas y programación
El instituto de investigación Epoch AI también rastreó el progreso de Google. Argon obtuvo 165 puntos en el Índice de Capacidades de Epoch (ECI), igualando a Fable 5.1 y quedando justo detrás de Opus 5.5 (167) y GPT-6 Astra (166). El ECI combina más de 50 puntos de prueba en una única escala de capacidades, de manera similar a cómo Artificial Analysis construye su puntaje principal.
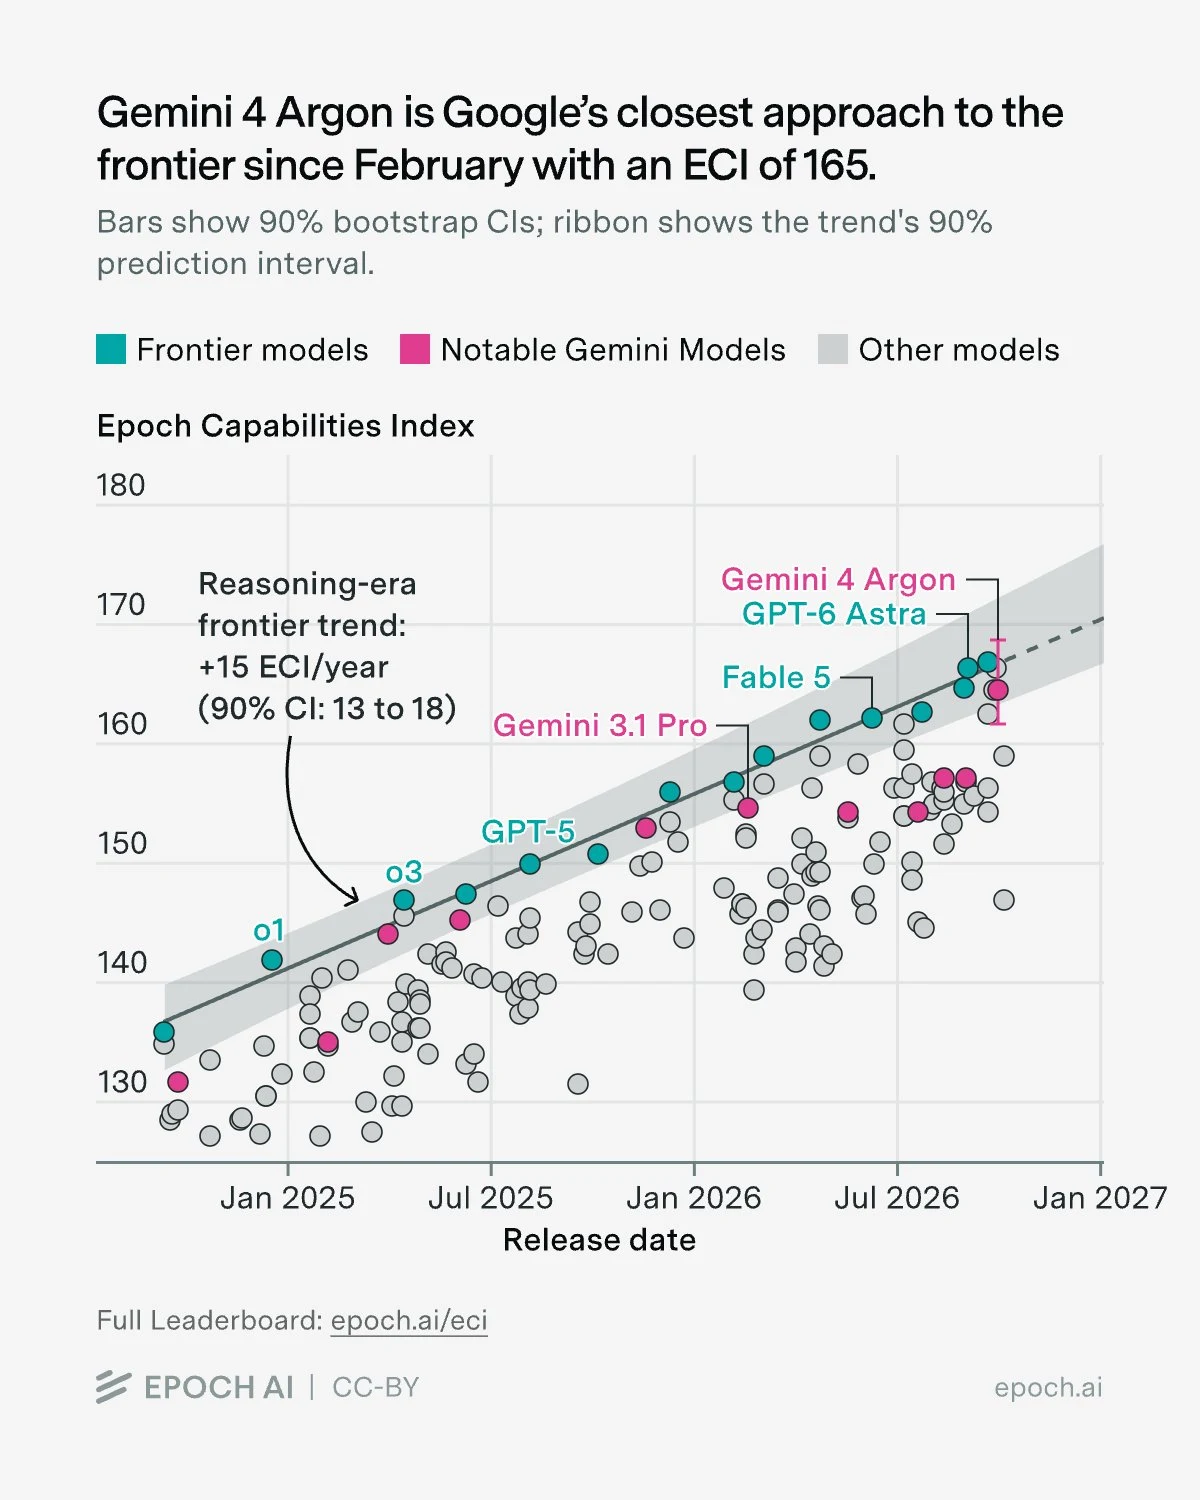
Argón se adelanta mucho más que Gemini 3.8 Flash (157 puntos) y acerca a Google más cerca del primer lugar que en cualquier momento desde Gemini 3.1 Pro en febrero. Artificial Analysis y Vals.ai confirmaron esta tendencia antes.
La rendimiento varía según el dominio. Según Epoch AI, Argon lidera varios índices de conocimiento, agentes y visión, pero las estimaciones iniciales lo colocan en el octavo lugar en el Math ECI y en el sexto lugar en el Software Engineering Index (SWE ECI).
Noticias sobre IA Sin El Eufemismo – Seleccionadas por Humanos
Suscríbase a THE DECODER para leer sin anuncios, un boletín semanal sobre IA, nuestro informe de vanguardia “AI Radar” exclusivo seis veces al año, acceso completo al archivo y acceso a nuestra sección de comentarios.
Fuente: EpochAI | ARC Prize