
Reflection AI presentó Beam, un modelo de pesos abiertos para codificación agéntica y tareas de largo horizonte como mantener código, usar herramientas, interpretar resultados y completar flujos de trabajo de múltiples pasos. La versión de pesos abiertos brinda a los desarrolladores e investigadores control sobre el entorno de ejecución, el despliegue y el proceso de personalización.
En esta publicación, explicamos la visión de Reflection y mostramos cómo puede implementar Beam en AWS. Comience con un endpoint en tiempo real de Amazon SageMaker JumpStart para una vía totalmente administrada. Cuando necesite control nativo de Kubernetes sobre la infraestructura de GPU distribuida, use Amazon SageMaker HyperPod Inference con JumpStart, SGLang o vLLM. También explicamos cómo los 501 mil millones de parámetros totales de Beam determinan el almacenamiento de checkpoints, la memoria de pesos, el sharding y el paralelismo, mientras que sus 23 mil millones de parámetros activos influyen en el cómputo por token.
En el lanzamiento, Beam está disponible en Amazon SageMaker JumpStart en US East (N. Virginia) y US East (Ohio).
La visión de Reflection sobre la inteligencia abierta
La misión de Reflection es hacer que la inteligencia sea abierta y accesible para todos mediante pesos de modelos abiertos, investigación publicada y software de código abierto. Su pila completa de IA abarca modelos, software central, infraestructura de producción y aplicaciones. Beam lleva este enfoque a los desarrolladores que crean sistemas de ingeniería de software y sistemas agénticos.
Acerca de Reflection Beam
Beam es un modelo sparse mixture-of-experts para resolver problemas de software, modificar código, llamar herramientas y actuar sobre resultados intermedios. Tiene 501 mil millones de parámetros totales y 23 mil millones de parámetros activos, y Reflection informa una longitud de contexto efectiva de 1 millón de tokens.
Reflection publica los pesos de Beam a través de Hugging Face bajo la licencia Apache 2.0. Beam 1.0 está disponible en variantes de checkpoint BF16, FP8 y NVFP4. Estos formatos ofrecen diferentes huellas de memoria y compatibilidad de hardware. Puede implementar el modelo con la configuración de contenedor administrada de JumpStart de AWS, o inspeccionar y personalizar el modelo con SGLang o vLLM en su entorno de AWS.
Comprenda la arquitectura de despliegue
Elija la vía de servicio que cumpla con sus requisitos de control y escalado.
- Comience con un endpoint en tiempo real de SageMaker JumpStart cuando desee un paquete de modelo, endpoint y API de invocación administrados por AWS sin operar Kubernetes.
- Use JumpStart en HyperPod Inference cuando desee el contenedor y la configuración del modelo administrados por AWS en un clúster de HyperPod orquestado por Amazon Elastic Kubernetes Service (Amazon EKS).
- Use SGLang o vLLM en HyperPod Inference cuando necesite controlar la imagen de servicio, los argumentos de ejecución, la cuantización o la ejecución distribuida.
- Dimensione el despliegue según el almacenamiento de checkpoints, la memoria de pesos, la caché KV, la longitud de contexto, el batching, la sobrecarga de ejecución y el paralelismo soportado.
- Defina los objetivos esperados de concurrencia y latencia, y luego configure réplicas, caché, enrutamiento y autoescalado según el comportamiento medido de la carga de trabajo.
La vía en tiempo real de JumpStart empaqueta el modelo, el contenedor y el endpoint detrás de un flujo de trabajo de despliegue administrado. La vía de HyperPod expone el clúster y el entorno de ejecución de servicio para que pueda controlar la ejecución distribuida, la caché, el enrutamiento y el escalado.
El siguiente diagrama muestra los componentes utilizados por la ruta de HyperPod. Beam puede obtenerse a través de SageMaker JumpStart, Hugging Face Hub o un espejo opcional de Amazon Simple Storage Service (Amazon S3). Los trabajadores distribuidos utilizan el contenedor JumpStart administrado por AWS o un runtime personalizado de SGLang o vLLM.
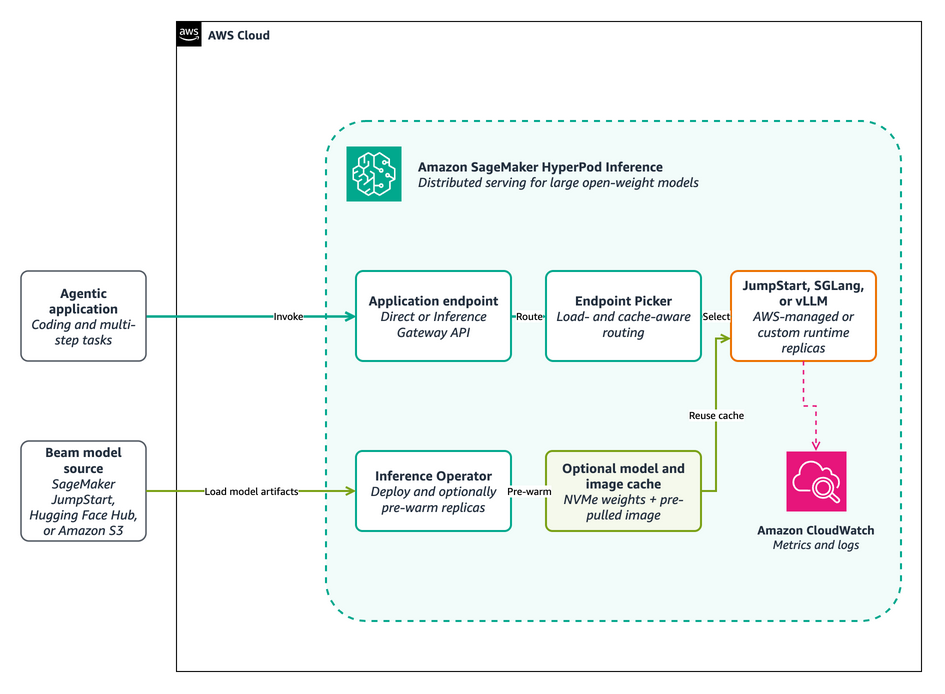
Figura 1: Despliegue distribuido de Beam con Amazon SageMaker HyperPod Inference
Requisitos previos
Necesita:
- Una cuenta de AWS con permisos para la ruta de despliegue de SageMaker seleccionada y sus recursos de AWS Identity and Access Management (IAM), redes y almacenamiento de soporte.
- Acceso a Beam a través de SageMaker JumpStart o de uno de los repositorios de checkpoints de Beam 1.0 en Hugging Face.
- Aceptación de los términos del modelo, la AWS Command Line Interface (AWS CLI) y Python 3.11 o posterior.
- Cuota y capacidad de GPU para una configuración de Beam compatible.
Planificar y obtener capacidad de GPU
Los 501 mil millones de parámetros totales de Beam requieren un despliegue multi-GPU. BF16 tiene el mayor requisito de memoria para pesos, así que planifique una configuración multi-nodo con suficiente memoria GPU agregada para los pesos y la sobrecarga del runtime. Para FP8, use ml.p5.48xlarge con GPUs NVIDIA H100 o ml.p5e.48xlarge y ml.p5en.48xlarge con GPUs H200. Para NVFP4, use ml.p6-b200.48xlarge con GPUs NVIDIA B200. Confirme que el checkpoint publicado, el runtime y el diseño de paralelismo admitan el tipo de instancia seleccionado.
- Calcule la memoria para los pesos, la caché KV y la sobrecarga del runtime para una réplica, y luego confirme la estimación con una prueba de carga.
- Elija una Región de AWS que admita la instancia acelerada requerida.
- Verifique la cuota del servicio y la capacidad disponible para el tipo de instancia seleccionado. Use capacidad bajo demanda cuando esté disponible, o use un SageMaker training plan como una reserva a corto plazo para trabajo programado.
- Permita tiempo para la transferencia de la imagen, la descarga de pesos, la carga de shards y la inicialización del runtime.
Path 1: Comience con un endpoint en tiempo real de SageMaker JumpStart
Use primero un endpoint en tiempo real de JumpStart cuando desee el camino más corto desde el catálogo de modelos hasta un endpoint HTTPS administrado. El ejemplo admite los IDs de modelos BF16, FP8 y NVFP4 mediante un solo comando consciente de la variante. Su README y su archivo de Python son la fuente de verdad para los tipos de instancia compatibles, el esquema de solicitudes, el comando de despliegue y el comando de limpieza.
- Clone el repositorio de ejemplo.
git clone https://github.com/aws-samples/sagemaker-genai-hosting-examples.git - Entre al directorio del ejemplo de despliegue de SageMaker JumpStart.
cd sagemaker-genai-hosting-examples/01-models/ReflectionAI/Beam-1.0-501B-A23B-NVFP4/ - Cree y active un entorno virtual de Python.
python3 -m venv .venv source .venv/bin/activate - Instale la dependencia del ejemplo.
python -m pip install -r requirements.txt - Ejecute el ciclo de vida acotado de despliegue, invocación y limpieza para FP8.
python jumpstart_real_time.py \
--variant fp8 \
--endpoint-name reflection-beam-fp8-smoke
El comando despliega el endpoint FP8, envía una solicitud corta, imprime la respuesta y limpia el endpoint. Use
bf16onvfp4para seleccionar otra variante de checkpoint; NVFP4 es el valor predeterminado cuando omite--variant. Use las funciones de Python del README cuando necesite mantener un endpoint en ejecución.
Path 2: Despliegue con SageMaker HyperPod Inference
Use HyperPod Inference cuando necesite control nativo de Kubernetes sobre la infraestructura de GPU distribuida. Puede usar la configuración de contenedor administrada por AWS de JumpStart o desplegar Beam con SGLang o vLLM. El README del ejemplo de despliegue de HyperPod Inference y sus archivos de configuración son la fuente de verdad para los manifiestos publicados, los identificadores de modelos e imágenes, las versiones de runtime compatibles y los comandos.
Antes de comenzar, configure kubectl acceso a un clúster de HyperPod orquestado por EKS con el HyperPod Inference Operator y los complementos necesarios. También necesita la nube privada virtual (VPC) del clúster, las subredes, los grupos de seguridad, el acceso a los artefactos de Beam y del runtime seleccionados, y capacidad NVMe local si habilita el almacenamiento en caché del modelo. Use un token de acceso aislado de Hugging Face si el repositorio seleccionado requiere autenticación.
Despliegue una revisión fija de Beam desde Hugging Face Hub para desarrollo y experimentación. Para despliegues de producción y almacenamiento en caché de modelos, copie el checkpoint a Amazon S3 o Amazon FSx. El almacenamiento en caché de modelos e imágenes de HyperPod puede precargar los pesos en el almacenamiento NVMe local del nodo y pre-extraer la imagen de servicio.
El HyperPod Inference Gateway proporciona una interfaz compatible con OpenAI y enruta las solicitudes entre réplicas. HyperPod Inference también admite almacenamiento en caché de KV por niveles administrado y enrutamiento inteligente. Estas se encuentran entre las capacidades de Amazon SageMaker Inference presentadas en 2026.
El siguiente diagrama expande el flujo de preparación de modelos y solicitudes del runtime. Cuando el almacenamiento en caché de modelos está habilitado, el Inference Operator calienta los nodos elegibles con los pesos y la imagen de servicio seleccionados. En tiempo de ejecución, el Inference Gateway y el Endpoint Picker pueden dirigir cada solicitud a una réplica adecuada administrada por JumpStart, SGLang o vLLM.
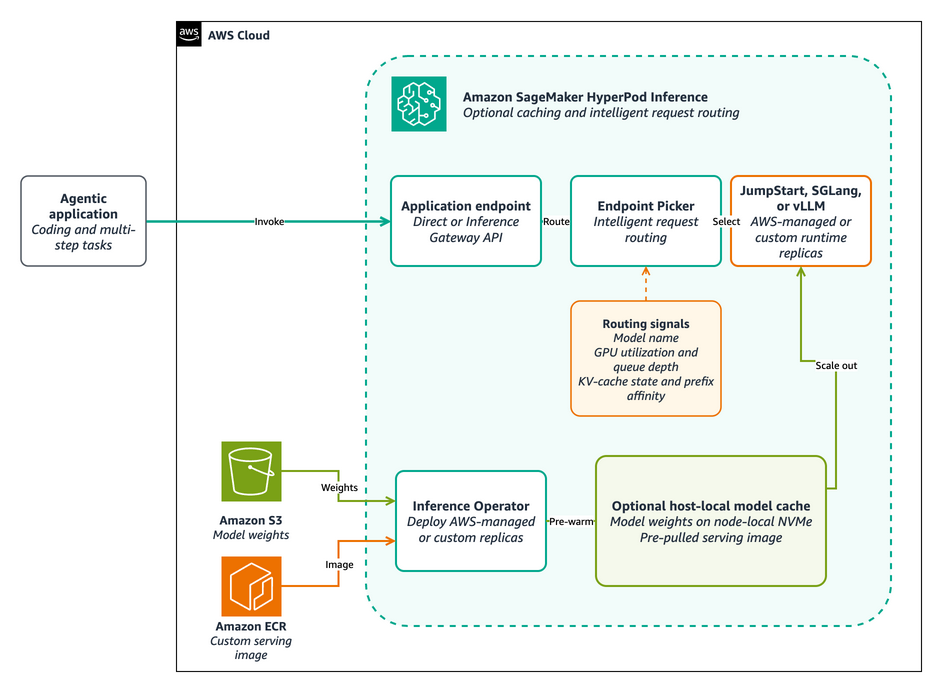
Figura 2: Almacenamiento en caché de modelos de HyperPod y enrutamiento de solicitudes
Prepare los artefactos de despliegue
Use entradas inmutables para poder reproducir los resultados de despliegue y rendimiento.
- Use la versión del modelo JumpStart registrada en el ejemplo de despliegue.
- Elige el checkpoint BF16, FP8 o NVFP4 para un runtime personalizado.
- Para un runtime personalizado, mantén el SHA público del commit de Beam y el digest de la imagen en la configuración de release de ejemplo.
- Replica la imagen publicada en un repositorio privado de Amazon Elastic Container Registry (Amazon ECR) solo cuando tu clúster no pueda extraer la imagen upstream o tu organización requiera un registro aprobado.
- Mantén fuera del repositorio los tokens, los secretos generados, los IDs de modelos privados, las credenciales del registro y los resultados no publicados.
Elige una ruta de serving
Comienza con SageMaker JumpStart a menos que tu carga de trabajo requiera un runtime o una configuración de inferencia específicos.
| Ruta de serving | Úsalo cuando | Qué gestionas |
| SageMaker JumpStart | Quieres un contenedor y una configuración de modelo gestionados por AWS con menos mantenimiento del runtime. | Selecciona la versión del modelo Beam, el tipo de instancia soportado, la configuración del endpoint y la política de escalado. |
| SGLang o vLLM | Necesita un runtime de inferencia o una configuración específicos, como argumentos de runtime personalizados, analizadores, cuantización o paralelismo. | Fije la imagen del runtime compatible, la revisión del modelo, la configuración del analizador y los ajustes de ejecución distribuida. |
Implementar con SageMaker JumpStart
SageMaker JumpStart reduce el trabajo de integración de contenedores mientras HyperPod mantiene el control sobre la capacidad del clúster, el escalado y la observabilidad.
- En SageMaker Studio, abra el catálogo de modelos JumpStart.
- En All public models, elija Beam.
- Elija SageMaker HyperPod como destino de implementación.
- Seleccione el clúster y el espacio de nombres de Kubernetes.
- Escriba un nombre de endpoint y elija Deploy.
- Confirme el estado de la implementación antes de invocar el endpoint con el esquema de solicitudes de JumpStart publicado.
Para un flujo de trabajo de infraestructura como código, utilice la configuración de JumpStart publicada en el ejemplo de HyperPod. Puede inspeccionar la plantilla de manifiesto reflection-beam-jumpstart.yaml antes de configurar la implementación.
- Clone el repositorio de ejemplo y acceda al directorio de HyperPod Beam.
git clone https://github.com/aws-samples/sagemaker-genai-hosting-examples.git cd sagemaker-genai-hosting-examples/SageMakerHyperpod/reflection-beam/ - Cree los archivos de configuración locales descritos en el README.
cp config/deployment.env.example config/deployment.env cp config/release.env.example config/release.env - Valide la configuración de JumpStart antes de modificar el clúster.
python hyperpod_tool.py \ --config config/deployment.env \ --config config/release.env \ validate jumpstart - Implemente la configuración de JumpStart.
python hyperpod_tool.py \
  --config config/deployment.env \
  --config config/release.env \
  deploy jumpstart \
  --timeout-seconds 1800
El asistente renderiza y aplica el recurso JumpStartModel publicado sin escribir los valores de la versión en el disco.
Implementar con SGLang o vLLM
Elija SGLang o vLLM cuando necesite control directo sobre el runtime de servicio. Antes de configurar la implementación, inspeccione la plantilla de manifiesto reflection-beam-sglang.yaml o la plantilla de manifiesto reflection-beam-vllm.yaml. El README del ejemplo sigue siendo la fuente de verdad para los valores y comandos publicados.
- Clona el repositorio de ejemplo.
git clone https://github.com/aws-samples/sagemaker-genai-hosting-examples.git - Entra en el directorio de HyperPod Beam.
cd sagemaker-genai-hosting-examples/SageMakerHyperpod/reflection-beam/ - Crea los archivos de configuración locales descritos en el README.
cp config/deployment.env.example config/deployment.env cp config/release.env.example config/release.env - Valida la configuración seleccionada antes de modificar el clúster.
python hyperpod_tool.py \ --config config/deployment.env \ --config config/release.env \ validate sglang - Despliega Beam y espera a que el despliegue alcance un estado terminal.
python hyperpod_tool.py \
  --config config/deployment.env \
  --config config/release.env \
  deploy sglang \
  --timeout-seconds 1800
Reemplaza
sglangporvllmpara usar vLLM. El asistente valida los ajustes seleccionados, aplica el manifiesto renderizado sin escribir los valores de la release en disco, espera con un tiempo de espera fijo y muestra diagnósticos si el despliegue falla.
Invoca Beam
Invoca JumpStart endpoints con el esquema de solicitudes del modelo publicado. Para SGLang o vLLM, usa la prueba de humo acotada incluida en el ejemplo de HyperPod.
Invoca el endpoint desplegado
- Instala la dependencia del cliente de ejemplo.
python3 -m venv .venv source .venv/bin/activate python -m pip install -r requirements.txt - Ejecuta una comprobación de salud privada y una solicitud breve con los ajustes de muestreo iniciales recomendados.
python hyperpod_tool.py \
--config config/deployment.env \
smoke sglang \
--prompt "List three checks for a healthy model deployment." \
--temperature 1.0 \
--top-p 0.7
Reemplaza
sglangporvllmpara un despliegue con vLLM. El asistente selecciona un worker listo, abre un port-forward temporal, comprueba la salud del endpoint, envía la solicitud y cierra el port-forward.
La respuesta se parece a la siguiente:
1. Confirm that the endpoint reports ready.
2. Send a short inference request.
3. Review the service logs for startup errors.
Para un Inference Gateway autenticado, usa el procedimiento de token de portador del README del ejemplo de HyperPod. Mantén las credenciales fuera del código fuente, los manifiestos y el historial de comandos.
Medir y ajustar el rendimiento
- Pruebe cada ruta de servicio con solicitudes repetidas y representativas de codificación y uso de herramientas a la concurrencia esperada.
- Registre la versión del modelo Beam, el digest de la imagen, el tipo de instancia, la precisión, la longitud del contexto, el paralelismo, los argumentos de servicio, el estado de la caché y las repeticiones de la prueba.
- Mida la tasa de éxito de las solicitudes, el p50 y p95 del tiempo hasta el primer token, el tiempo por token de salida, la latencia de extremo a extremo y los tokens de salida agregados por segundo.
- Ajuste el tamaño del lote, la asignación de la caché KV, el número de réplicas, el escalado automático y el almacenamiento en caché del modelo y la imagen a partir de esos resultados.
- Vuelva a verificar la calidad de la salida después de cambiar la precisión o la cuantización.
Limpieza
Elimine los recursos cuando termine las pruebas para evitar cargos continuos.
- Para un endpoint en tiempo real de SageMaker JumpStart, siga las instrucciones de limpieza en el README del ejemplo de implementación de SageMaker JumpStart.
- Para JumpStart, SGLang o vLLM en Amazon SageMaker HyperPod Inference, siga las instrucciones de limpieza en el README del ejemplo de implementación de HyperPod Inference.
- Elimine un clúster dedicado de HyperPod o Amazon EKS creado para el tutorial.
- Elimine los pesos en caché no utilizados, los artefactos reflejados, los balanceadores de carga, los grupos de registros, los roles de IAM temporales y los datos de inferencia capturados.
Conclusión
Reflection Beam ofrece a los desarrolladores un modelo de pesos abiertos diseñado para codificación agéntica y tareas de múltiples pasos. Comience con un endpoint en tiempo real de SageMaker JumpStart para una implementación completamente administrada. Use SageMaker HyperPod Inference con JumpStart cuando necesite control de infraestructura nativo de Kubernetes sin administrar el contenedor de servicio, o elija SGLang o vLLM cuando necesite un runtime personalizado.
Use el ejemplo de implementación de SageMaker JumpStart o el ejemplo de implementación de HyperPod Inference, y luego siga las instrucciones.
Para obtener más información sobre Reflection AI y su visión de la inteligencia abierta, visite Reflection AI y lea Introducing Beam.
Recursos
- Variantes de checkpoint de Reflection Beam: BF16, FP8y NVFP4
- Ejemplo de implementación de SageMaker JumpStart
- Ejemplos de implementación de HyperPod Inference con JumpStart, vLLM y SGLang
- Implementar modelos fundamentales de SageMaker JumpStart en HyperPod Inference
- Repaso de los lanzamientos de Amazon SageMaker Inference en lo que va del año 2026