
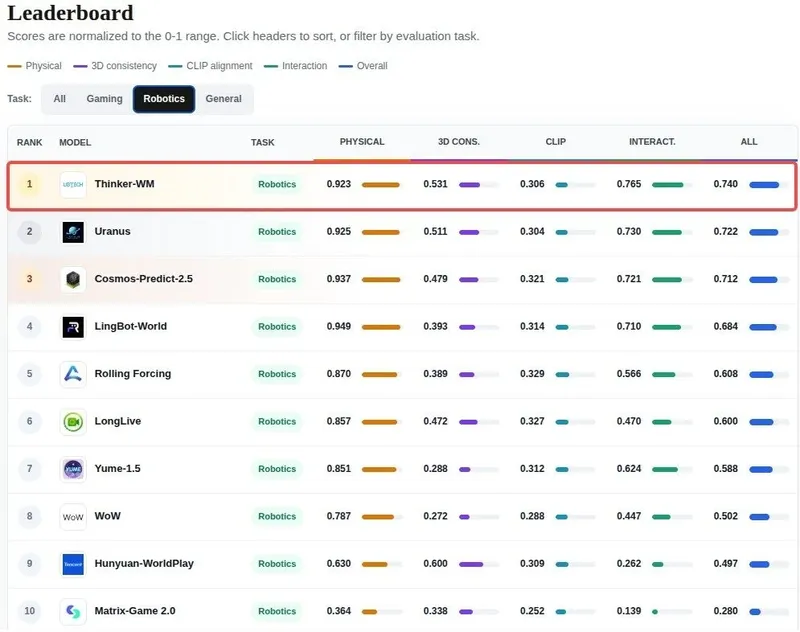
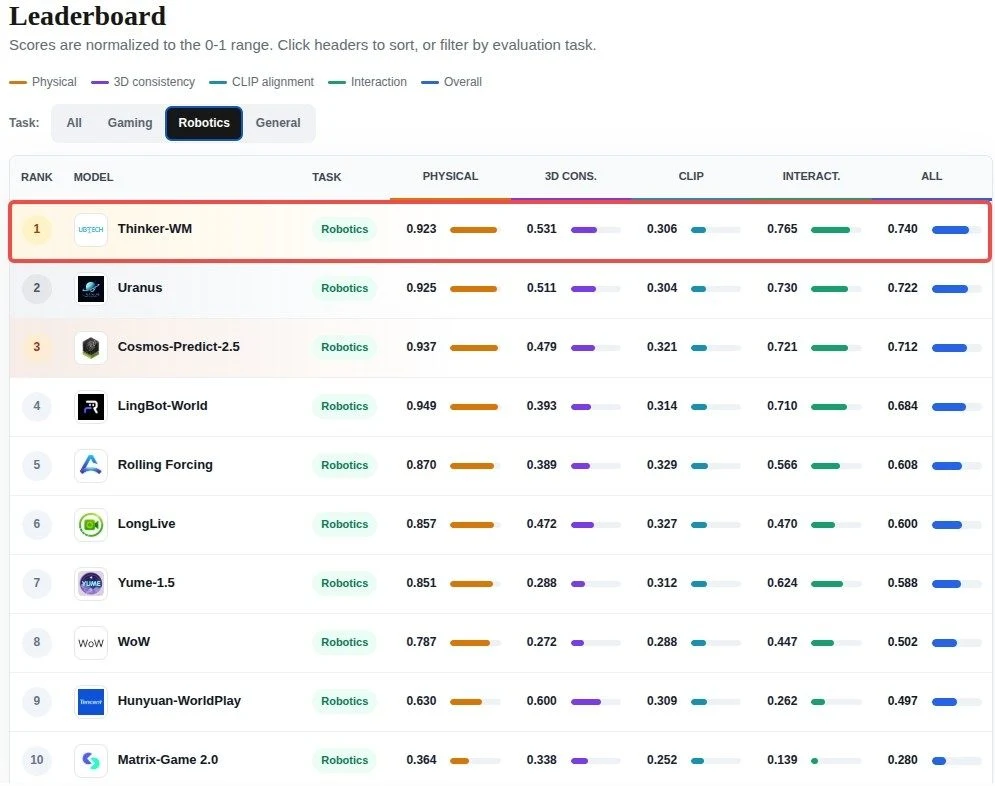
01 Primer puesto en los tres rankings de benchmarks: Thinker-WM logra tres primeros lugares
Hace pocos días, Thinker-WM de UBTech obtuvo el primer puesto en los tres benchmarks reconocidos de modelos mundiales embodidos, estableciendo un nuevo récord en la industria:
WorldOlympiad:
Thinker‑WM logró una puntuación global de 0.740, situándose en la cima del ranking. Este benchmark se construye a partir de una gran cantidad de datos reales de interacción robótica, abarca más de diez tipos distintos de cuerpos robóticos y múltiples configuraciones de cámaras, y evalúa principalmente la capacidad de generalización del modelo entre diferentes morfologías robóticas y puntos de vista. El modelo obtuvo 3D de consistencia de 0.531 y fidelidad de interacción de 0.765, ambas métricas individuales en el primer lugar entre todos los modelos participantes, lo que demuestra su capacidad de modelar con precisión la estructura geométrica tridimensional y el proceso de interacción robótica.
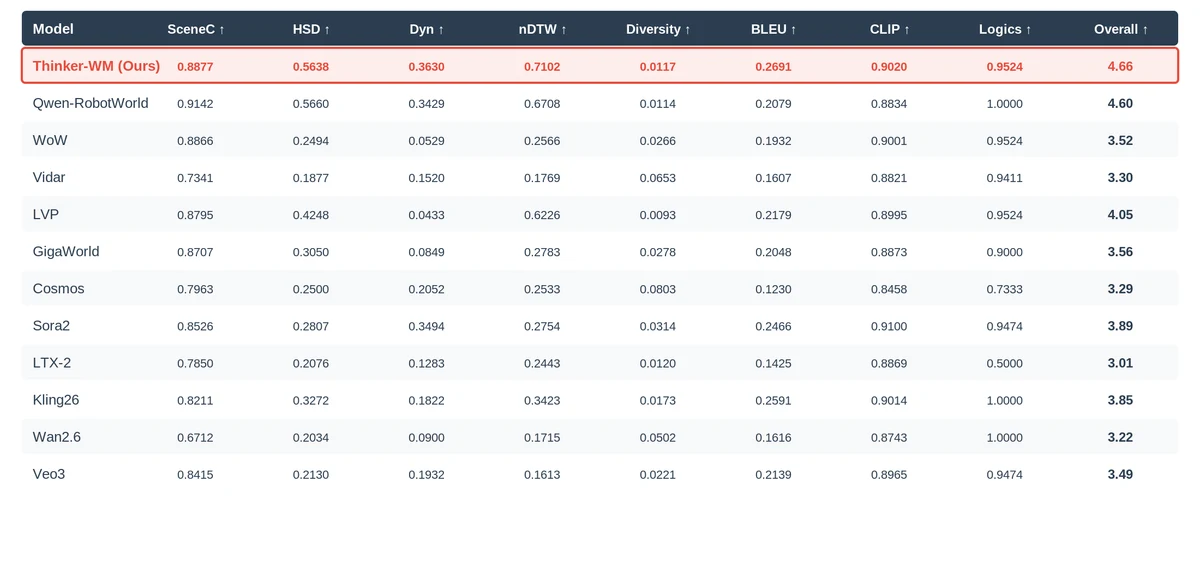
EWMBench:
Thinker‑WM obtuvo una puntuación global total de 4.66, superando a modelos líderes como Qwen‑RobotWorld y Sora2. EWMBench evalúa de forma completa tres dimensiones de capacidad: consistencia de escena, corrección del movimiento del efector final del robot y alineación semántica de las instrucciones. Gracias al modelado conjunto multimodal a nivel de representación, Thinker‑WM logró el liderazgo en métricas centrales del movimiento robótico como nDTW (Normalizada de Warping de Tiempo Dinámico), que refleja la correspondencia espacio-temporal de las trayectorias del robot, y Dyn (consistencia dinámica), que representa la razonabilidad de la velocidad y la aceleración del movimiento.
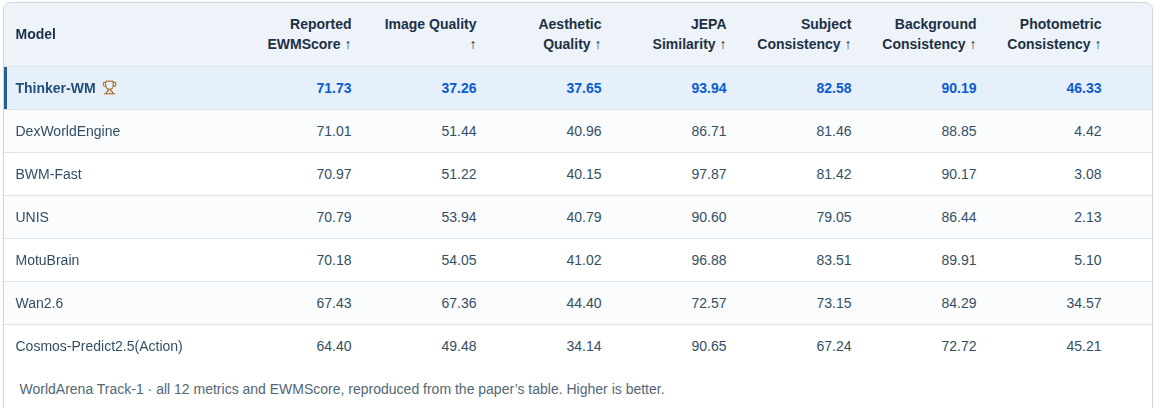
WorldArena1.0 Track-1:
En el benchmark de entorno simulado WorldArena Track‑1, Thinker‑WM lidera de manera general en 12 dimensiones clave de evaluación, como calidad visual, consistencia de contenido, razonabilidad física, precisión geométrica 3D y seguimiento de instrucciones, equilibrando la calidad de la generación visual y la credibilidad de la interacción física en entornos simulados. Thinker‑WM tiene como núcleo el Unified Dynamic Transformer (UDT) de capa de representación unificada, que incorpora imágenes RGB, profundidad métrica y acciones del robot en un mismo conjunto de representaciones dinámicas compartidas que evolucionan conjuntamente, logrando la unificación de múltiples capacidades como generación conjunta de video‑acción, predicción del mundo, razonamiento de políticas, conversión de video a acción e inversa dinámica, proporcionando así una nueva generación de base de modelos mundiales fundamentales para la inteligencia embodida.
02 Avance tecnológico de Thinker-WM: unificación multimodal de visión, geometría y acción a nivel de representación
Para que un robot trabaje de manera efectiva en el mundo real, lo más difícil no es reconocer los objetos frente a él, sino anticipar los próximos cambios del entorno. Este es precisamente el valor y significado de los modelos mundiales, pero los modelos mundiales anteriores suelen adoptar soluciones de "ensamblaje": la generación de video se encarga de las imágenes, la red de políticas se encarga de las acciones y la predicción geométrica se encarga de la información espacial; los módulos calculan de forma independiente y sus salidas se ensamblan mediante interfaces.
El problema de este esquema tecnológico es que las acciones modifican el entorno y el entorno restringe las acciones, mientras que la estructura geométrica influye en ambas: señales físicamente acopladas se dividen en módulos distintos, perdiendo su relación causal intrínseca.
Por ejemplo, el evento "una taza es empujada fuera de la mesa" es una frase en el lenguaje, una secuencia de comandos articulares en las acciones, un movimiento de objetos atravesando la imagen en el video y un campo de distancias que cambia continuamente en la profundidad. Las cuatro representaciones apuntan al mismo evento, no a cuatro objetos diferentes. Por lo tanto, pedir al modelo que genere cualquiera de ellas es, en esencia, preguntar por el mismo proceso.
Pero esta superposición es incompleta. Las acciones no llevan apariencia ni contexto: los mismos comandos articulares tienen un significado completamente diferente sobre una mesa vacía que sobre una mesa desordenada. El lenguaje tampoco contiene detalles espacio-temporales: la frase "la taza fue empujada fuera de la mesa" no especifica desde qué lado se empuja, con cuánta fuerza ni a qué velocidad, ni la trayectoria concreta de la mano, cuántas vueltas da la taza ni dónde cae finalmente. El video no contiene geometría explícita ni medidas: se representa mediante una serie de píxeles, sin conocer ni el tamaño de la taza ni su distancia. La profundidad tampoco contiene apariencia, semántica de nombres ni intención: indica dónde está la superficie, cómo se ocluye y cómo se hace contacto, pero no te dice si es una taza o un mantel, y mucho menos por qué se empuja.
Frente a este problema, el equipo Thinker de UBTech propone una solución completamente nueva: no realizar una simple fusión en las interfaces, sino lograr la unificación multimodal a nivel de representación. Thinker-WM (Thinker World Model), como modelo mundial multimodal unificado de desarrollo propio de UBTech, codifica el video RGB, la profundidad y las acciones del robot en un mismo espacio de representación intermedio, evolucionando conjuntamente mediante un grupo de parámetros compartidos. La apariencia, la geometría y las acciones dejan de ser tres líneas de procesamiento independientes para convertirse en tres formas de expresión del mismo proceso de evolución del mundo. Es decir, la lógica de diseño subyacente de Thinker-WM puede resumirse así: las diferentes modalidades son distintas formulaciones de un mismo proceso; el modelo las alinea en un espacio de representación compartida y razona sobre esta representación compartida, en lugar de hacer combinaciones condicionales en las interfaces entre modalidades.
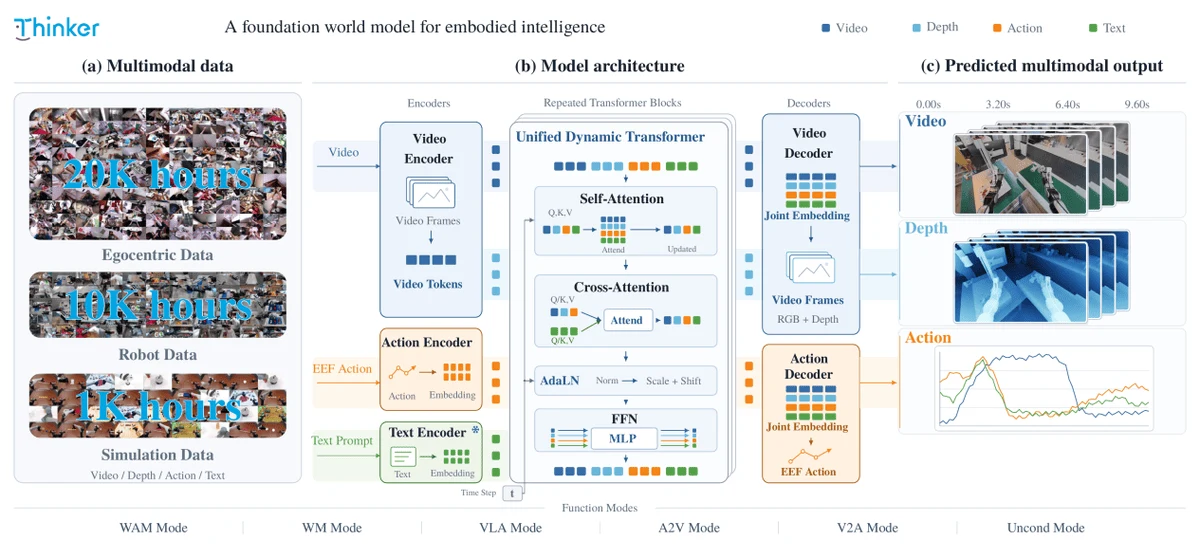
Thinker-WM: marco de modelado unificado de visión, geometría y acción
En concreto, las imágenes RGB, la información de profundidad y las acciones del robot se mapean mediante sus respectivos codificadores a un espacio latente unificado, se introducen en el Transformer Dinámico Unificado (Unified Dynamics Transformer, UDT) compartido para un modelado temporal conjunto y, finalmente, los decodificadores respectivos reconstruyen el video de salida, los mapas de profundidad y las acciones ejecutables del robot. Esto significa que la interacción multimodal ocurre dentro del Transformer: los tokens visuales, los tokens geométricos y los tokens de acción intercambian información directamente a través de un mismo mecanismo de atención, en lugar de realizar una concatenación superficial en las capas de entrada o salida.
La información geométrica ya no es solo una señal de supervisión auxiliar. Thinker-WM trata la profundidad como una modalidad generativa nativa, compartiendo con el video una misma topología latente y organización espacio-temporal. La supervisión de profundidad moldea directamente la representación compartida, convirtiendo la estructura del espacio físico en la "lengua materna" del modelo mundial, en lugar de un módulo complementario añadido posteriormente, lo que también ayuda a los robots humanoides a comprender con mayor precisión el espacio físico. El valor del modelado unificado también se refleja en la ejecución real del robot. En el experimento de ablación de tareas únicas de RoboTwin, tras introducir la modalidad de profundidad, la tasa de éxito de la manipulación aumentó 15 puntos porcentualesrespecto a la línea base sin profundidad, lo que demuestra que la información geométrica espacial no solo ayuda al modelo a comprender la escena, sino que también mejora la generación de acciones y la ejecución de tareas.
03 3万 horas de datos heterogéneos: un solo modelo que desbloquea seis capacidades
Apoyándose en la representación unificada multimodal, donde todas las modalidades comparten el mismo grupo de parámetros, Thinker-WM puede alternar de manera flexible las modalidades condicionales y generativas para soportar seis modos de capacidad.
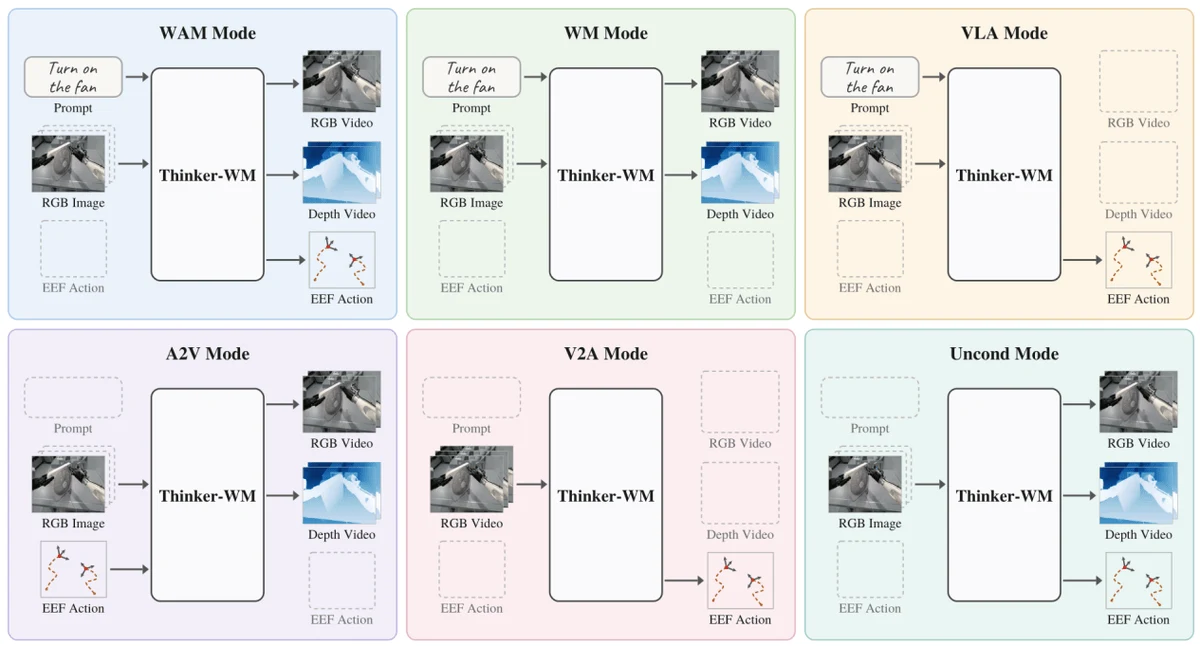
Los mismos pesos pueden predecir e imaginar imágenes futuras, deducir inversamente las trayectorias de ejecución del robot y extraer información de acciones de los videos: este es el beneficio tecnológico central que aporta la representación unificada.
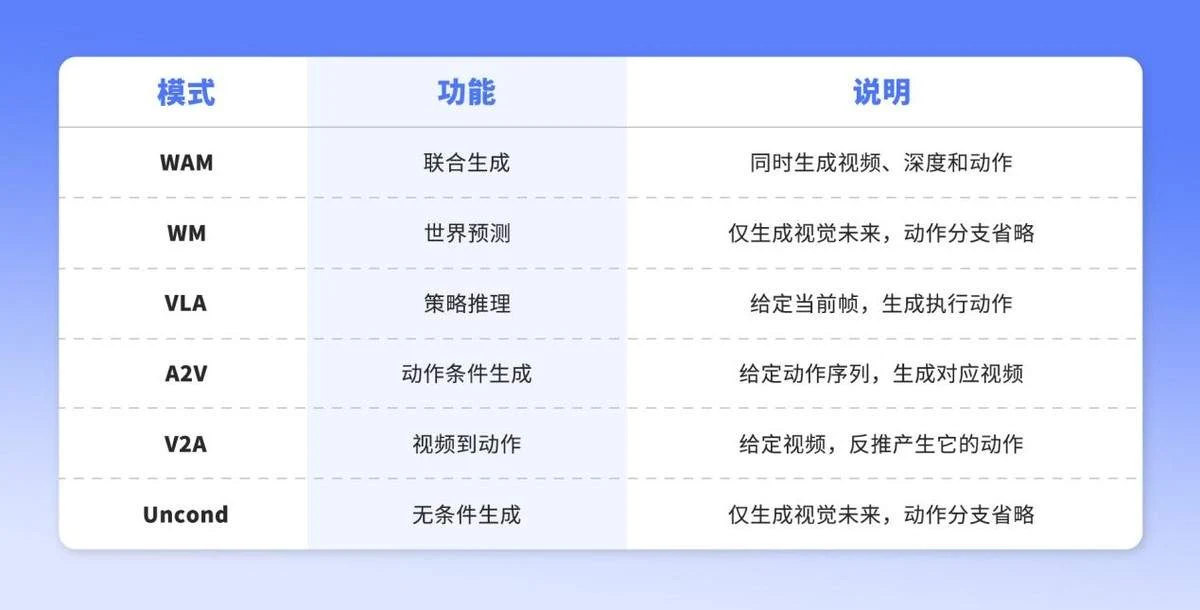
04 3万 horas de datos heterogéneos que sustentan la base de un modelo mundial general
Detrás de la capacidad de representación unificada se encuentra el respaldo de datos de entrenamiento de UBTech, de escala considerable y tipos diversos. El corpus de entrenamiento de Thinker-WM tiene un volumen notable en el ámbito de la inteligencia embodida:
- Aproximadamente 2万 horas de video humano en primera persona: abarcan escenarios domésticos, comerciales minoristas e industriales, y compensan la diversidad de tareas, objetos y escenas que la teleoperación de robots difícilmente puede obtener a bajo costo, junto con aproximadamente 1千 horas de datos de profundidad alineados.
- Aproximadamente 1万 horas de datos reales de robots: provenientes de múltiples robots de diferentes morfologías, que proporcionan supervisión emparejada de observaciones visuales y acciones ejecutables, de las cuales aproximadamente 3千 horas cuentan con anotaciones de profundidad alineadas.
- Aproximadamente 1千 horas de datos de simulación:proporcionar señales de supervisión geométricas y físicas de alta precisión.
Los espacios de acción, sistemas de coordenadas y protocolos de control de los distintos robots difieren enormemente. La idea de unificación de Thinker-WM no solo se aplica al marco del modelo, sino también a la selección de datos. Este modelo utiliza de manera uniforme la pose del efector final para representar las acciones de todos los robots, e incorpora al mismo tiempo etiquetas exclusivas de cada robot en los tokens. De este modo, robots de distintas morfologías pueden compartir el mismo espacio generativo, conservando al mismo tiempo una capacidad precisa de control propioceptivo.
05 Infraestructura de datos: hacer que masivos datos heterogéneos respalden eficientemente el entrenamiento de modelos unificados
Para que los datos masivos se conviertan en capacidades del modelo, es indispensable una infraestructura de datos estable y eficiente. Ante las diferencias de formato, modalidad y anotación entre distintos robots, videos humanos y datos de simulación, el equipo Thinker de UBTECH construyó Data Factory, que desacopla la gestión de datos del muestreo de entrenamiento, permitiendo que los datos de múltiples fuentes se combinen de manera flexible según las necesidades del modelo.
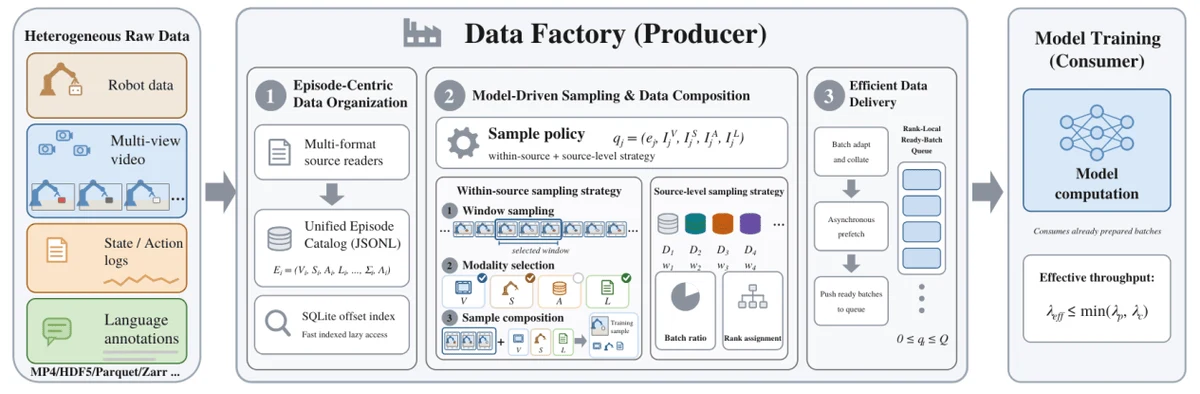
Data Factory: de datos heterogéneos de múltiples fuentes al entrenamiento de un modelo unificado
Data Factory respalda el entrenamiento en torno a tres eslabones clave:organización unificadade información de video, estados, acciones y lenguaje, generando según demanda las muestras requeridas por los distintos modos de entrenamiento; mediante unainspección de calidad jerárquicafiltra los segmentos anómalos y verifica la alineación entre profundidad y video, asegurando señales de entrenamiento fiables; medianteprecarga asíncrona y reutilización de codificaciónprepara con antelación los datos de entrenamiento, reduciendo tiempos de espera y cálculos repetidos.
Esta infraestructura de datos permite que los datos heterogéneos de múltiples fuentes se organicen de forma fiable, se invoquen con flexibilidad y se suministren eficientemente, proporcionando soporte de ingeniería para el entrenamiento conjunto y la iteración continua de los seis modos de capacidad de Thinker-WM.
06 Mediante el diseño experimental Motion Probe, un experimento ligero: verificar el acoplamiento real de las representaciones multimodales
Unificar la multimodalidad a nivel de representación suena a innovación en el diseño de la arquitectura, pero existe una duda central: ¿el modelo realmente aprende en el espacio compartido las correlaciones de acoplamiento entre visión, geometría y acción, o simplemente procesa en paralelo múltiples fuentes de información, poniendo juntas de manera simple las distintas modalidades?
Para responder a esta pregunta, el equipo de Thinker de UBTECH diseñó un experimento de verificación ligero: Motion Probe (sonda de movimiento). El equipo de investigación conectó a las representaciones visuales congeladas del UDT un cabezal minúsculo de predicción de movimiento, entrenando únicamente este cabezal, para ver si es posible recuperar el desplazamiento del efector final a partir de representaciones puramente visuales.
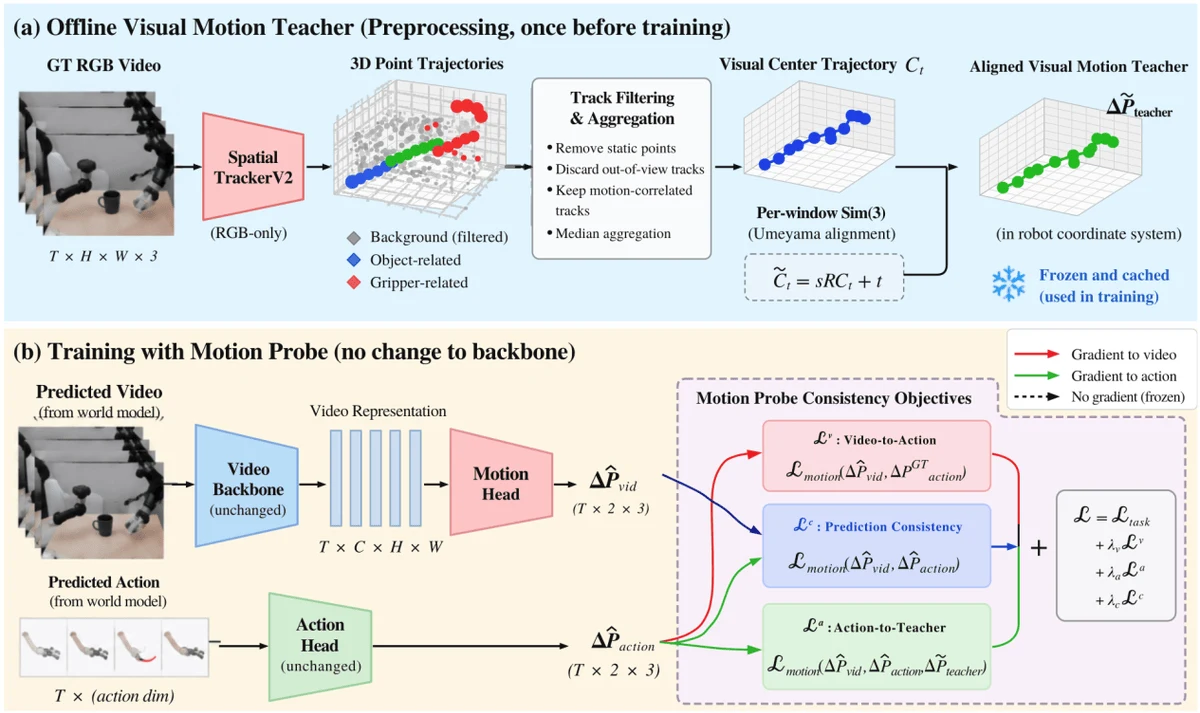
Diagrama de Motion Probe
Los resultados del experimento confirmaron la hipótesis: el error de predicción de la sonda es muy bajo. Incluso sin supervisión de acciones, las representaciones visuales ya codificaban información de movimiento relacionada con las acciones. Este resultado demuestra directamente que la unificación multimodal a nivel de representación surte efecto real: la percepción visual y la planificación de acciones no son dos rutas independientes, sino que logran un acoplamiento profundo en un espacio latente compartido.
07 ¿Qué significa esto?
Esto también demuestra además que el valor del avance técnico de Thinker-WM va mucho más allá de un simple resultado de clasificación. Señala un nuevo paradigma de base para los modelos del mundo encarnados:
el modelo del mundo de la inteligencia encarnada no debería ser una simple combinación de “generador de video + cabezal de política”, sino un proceso generativo completo y unificado: la observación visual, la estructura espacial y la planificación de acciones son distintas expresiones de un mismo proceso del mundo físico.
Cuando un robot puede razonar sincrónicamente, dentro del mismo espacio de representación, sobre los cambios de imagen, la estructura espacial y las trayectorias de acción, su comprensión de la lógica causal del mundo físico da un gran paso adelante. Este es también el salto clave del robot desde “poder ejecutar tareas y trabajar” hacia “poder comprender el mundo real”.
Thinker-WM ya ha completado su verificación de despliegue en la plataforma robótica de UBTECH, y las tecnologías relacionadas seguirán potenciando a la próxima generación de sistemas de inteligencia encarnada.
La exploración de Thinker-WM no termina con esta publicación de resultados. El informe técnico del modelo y sus versiones iterativas posteriores se actualizarán continuamente en la comunidad oficial de desarrolladores de inteligencia encarnada de UBTECH, Thinker Cosmos; el plan de apertura de capacidades de desarrollo secundario del modelo del mundo y el anuncio de transmisiones en directo de explicación técnica también se darán a conocer a los desarrolladores en cuanto ocurran. Les invitamos a unirse a Thinker Cosmos (https://thinkercosmos.ubtrobot.com/) para construir juntos el ecosistema de la inteligencia encarnada.
Enlace del proyecto
Enlace al artículo: https://arxiv.org/abs/2610.18447
Dirección del proyecto: https://thinkercosmos.ubtrobot.com/thinker-wm
Github: puede consultarse en https://github.com/UBTECH-Robot/Thinker-WM
Huggingface: puede consultarse en https://huggingface.co/UBTECH-Robotics/Thinker-WM
Este artículo fue proporcionado por UBTECH; QbitAI lo reproduce con autorización, y las opiniones pertenecen al autor original.