
16 de octubre, Pekín – La empresa范式智能技术集团有限公司 (“范式” o “Grupo”, código bursero: 6682.HK) en colaboración con Beijing RuiSi Zhilian Technology Co., Ltd. (“RuiSi Zhilian”) anunció que la plataforma de despliegue de IA de nivel de producción “ModelSphere” está oficialmente disponible. La plataforma está disponible gratuitamente y de código abierto para usuarios empresariales, integrando la gestión de capacidad de cálculo, el despliegue de modelos y la optimización del funcionamiento en una plataforma unificada, lo que ayuda a las empresas a reducir los obstáculos de despliegue y operación, y a transformar de manera más eficiente la capacidad de cálculo en servicios de IA seguros, estables y útiles para el negocio real. La plataforma ya está open source en GitHub.
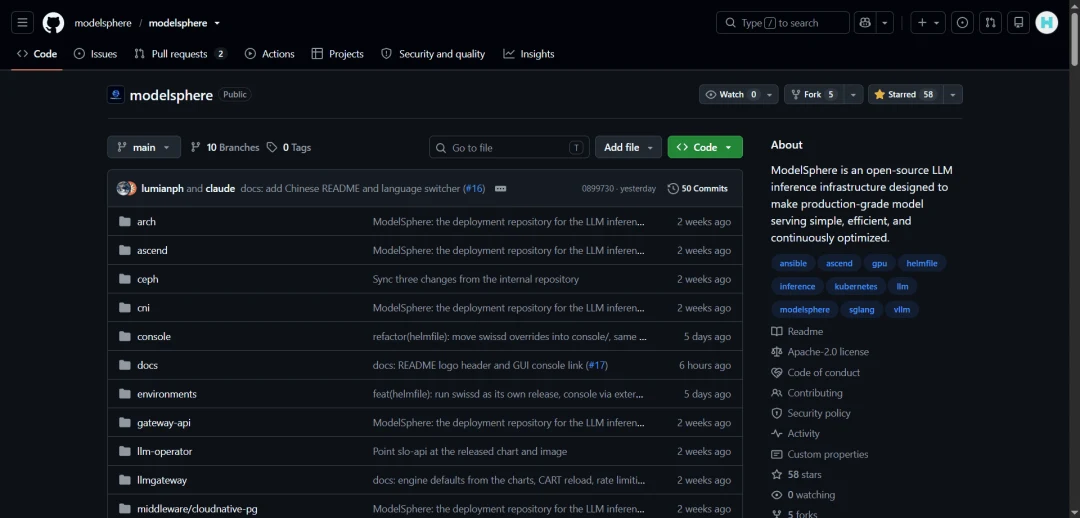
Dirección de Github: https://github.com/modelsphere/modelsphere
A medida que los grandes modelos entran en la etapa de comercialización a gran escala, las empresas enfrentan problemas como el bajo rendimiento de los recursos, la fragmentación de la ecología de chips, el alto umbral de despliegue y la dificultad para optimizar el entorno de producción. El dominio de modelos se dedica a integrar estos trabajos en un proceso de despliegue y gestión unificado, reduciendo la inversión repetida que las empresas deben realizar en la adaptación al sistema subyacente, la asignación de recursos y el mantenimiento diario. De esta manera, las empresas no necesitan dominar en profundidad tareas complejas como la compilación de drivers y la adaptación al hardware, y pueden integrar diversos modelos de gran tamaño open source en sus procesos de negocio clave, permitiendo que los equipos tecnológicos se concentren más en el desarrollo de aplicaciones y en las necesidades comerciales.
El dominio de modelado posee cuatro ventajas clave:
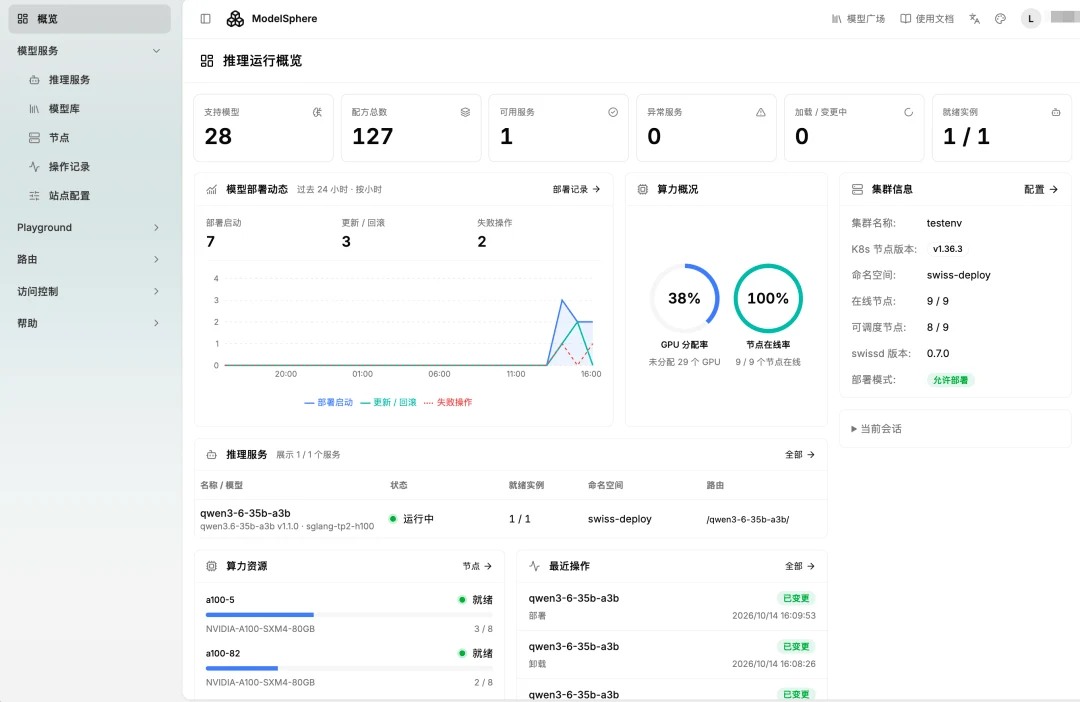
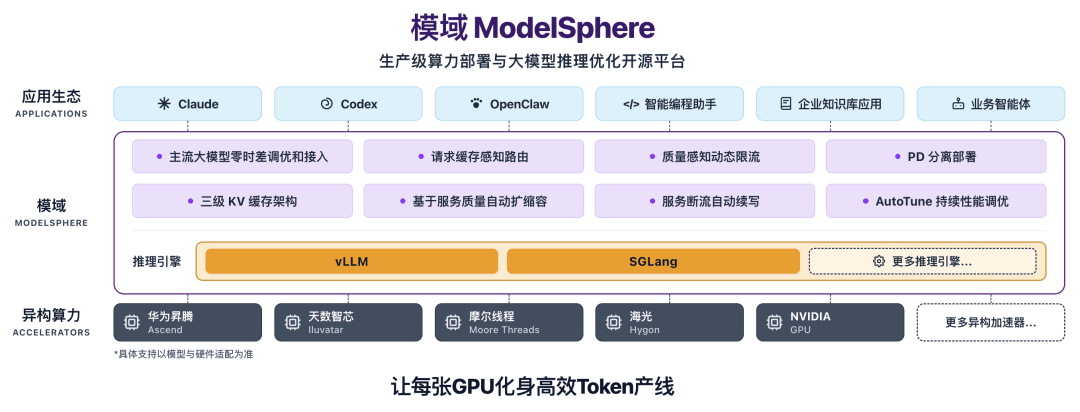
1. Simplificar la implementación y garantizar el funcionamiento estable del servicio de modelo: ModoField proporciona una pantalla de operación gráfica y capacidades de implementación preconfiguradas, reduciendo la complejidad del código de configuración ambiental. Esto ayuda a los desarrolladores a establecer rápidamente servicios de inferencia para modelos grandes y simplifica las diferentes agrupaciones de chips. La plataforma incluye capacidades empresariales como escalabilidad automática y flexible, implementación separada de PD, caché KV de tres niveles, equilibrio de carga de alta disponibilidad y continuación automática en caso de interrupción del servicio, lo que permite que el servicio de modelo funcione establemente en entornos de producción.
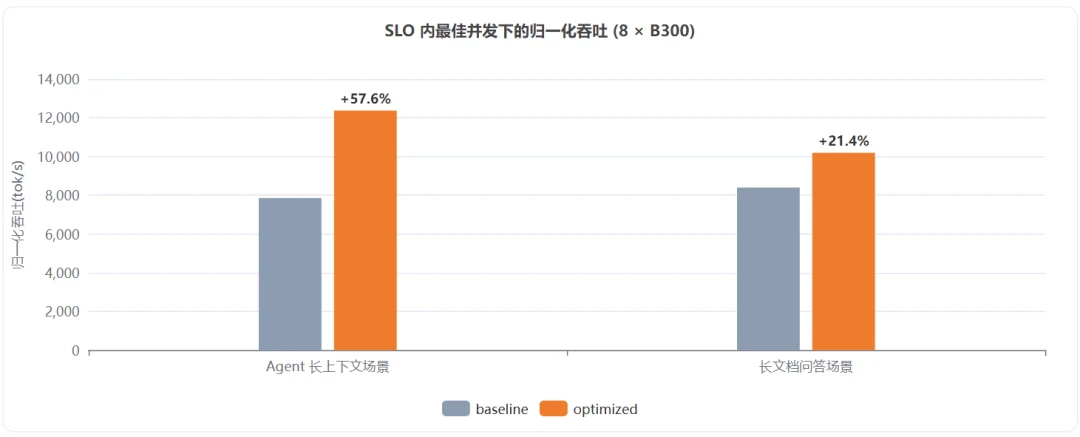
2. Automatización continua para la optimización, mejorando la eficiencia de funcionamiento del modelo: La plataforma incluye una estrategia inteligente de planificación de modelos AutoTune, así como un ajuste adaptativo de equilibrio de carga que integra la capacidad de aceleración hardware. Esto optimiza la capacidad de procesar solicitudes del modelo y la velocidad de respuesta inicial, y la eficiencia de consumo máximo del sistema aumenta aproximadamente un 285% en comparación con el estándar. El rendimiento se multiplica por 4, logrando así una liberación total de la capacidad de cálculo.
3. Gestión unificada de varios chips, reduciendo la adaptación repetida: La plataforma integra el motor de inferencia EngineX, lo que permite una optimización profunda para diversos chips de potencia computacional. Se puede gestionar y mezclar los recursos de potencia computacional nacionales como Huawei Ascend, Tiande Smart Chip, Moore Thread, Haiguang DCU, sin que los usuarios necesiten reescribir el código lógico de base para diferentes chips.
4. Optimizar continuamente la adaptación a modelos principales y acelerar la implementación de aplicaciones: El equipo de domain de modelos sigue de cerca las iteraciones de la comunidad de código abierto, y ya ha adaptado y optimizado modelos principales como DeepSeek-V4/V4-Flash, Qwen, Kimi, MiniMax y GLM. Permite una implementación rápida después de la publicación del modelo, así como una optimización del rendimiento para el entorno de producción, ayudando a las empresas a implementar nuevos modelos en sus operaciones reales.
En el nivel técnico, el dominio de modelos coopera con motores de inferencia como vLLM y SGLang: los motores de inferencia se encargan de mejorar la eficiencia de cálculo de un servidor individual, mientras que el dominio de modelos se ocupa de la gestión y optimización a nivel de arquitectura de clúster, incluyendo el enrutamiento de solicitudes con conciencia de carga y caché, un grupo unificado de caché KV, una expansión/reducción automática basada en calidad de servicio, la continuación automática de servicios en caso de interrupción, una optimización automática del rendimiento basada en datos en línea, el monitoreo de operación y la gestión de servicios, asegurando el alto rendimiento y la alta disponibilidad del sistema en un entorno de producción.
El dominio de modelos utiliza el protocolo relajado de Apache 2.0 y es completamente abierto. Permite que más empresas y desarrolladores tengan acceso a la capacidad de despliegue y optimización de grandes modelos, al mismo tiempo que reúne las fuerzas de la industria para mejorar continuamente el soporte para diferentes chips y modelos. Esto reduce los obstáculos en la adaptación de hardware y disminuye el umbral de aplicación de grandes modelos, ayudando a las empresas a utilizar eficazmente su capacidad de cálculo existente y liberar el potencial comercial de la capacidad de cálculo heterogénea.
Este artículo fue proporcionado por Fanzhen, Quantumbit tiene autorización para reproducirlo, y las opiniones pertenecen al autor original.