
Jin Lei, desde Shenzhen
Quantum Bit | Perfil público QbitAI
El miedo es una forma muy mala de tomar decisiones.
Cuando las empresas temen perder la ventana de transformación en IA, Werner Vogels, CTO de Amazon, advierte que cuanto más apresurado sea el proceso, más necesario es pensar claramente: ¿qué problema específico debe resolver la empresa y qué puede ayudar la IA?
Hoy en día, cada semana aparecen nuevos modelos, y todos se sienten más ansiosos, temiendo que cada paso sea lento. La necesidad de aumentar la eficiencia y fomentar la innovación es cada vez mayor, pero no se entiende bien qué puede hacer realmente la tecnología.
En una reunión en Shenzhen, expresó abiertamente que las empresas no cerrarán inmediatamente porque en este momento no están utilizando la IA. Por lo tanto, antes de tomar una decisión, las empresas deben permitir que ingenieros y gerentes aprendan completamente sobre las capacidades tecnológicas.
Pero cuando estas palabras salen de la boca de Werner, hay algo un poco contradictorio en ellas.
Después de todo, este veterano técnico que ha sido CTO de Amazon durante más de veinte años, nunca ha querido aceptar lo imposible. Al hablar sobre las historias detrás del cloud computing, incluso citó expresamente un dicho de la pionera en computación Grace Hopper, recordando a los desarrolladores que deben estar alerta ante la frase “Siempre hemos hecho esto”.
Una persona que constantemente anima a los ingenieros a romper las normas, ¿por qué, en el caso de la IA, les pide primero tomarse un descanso?
La falla de la base de datos que él mencionó podría explicar esta actitud aparentemente contradictoria.
¿Debería la IA volver a superar los problemas que ya ha superado en la base de datos?
El 12 de diciembre de 2004, Amazon se encontraba en un punto clave de la temporada de compras navideñas. En ese momento, los usuarios podían disfrutar de entrega gratuita si sus compras superaban los 25 dólares, pero el envío tomaba tiempo. Si se hacía la orden demasiado tarde, los paquetes podrían no llegar a tiempo para Navidad.
Justo en ese día, el disco compartido detrás de la base de datos de clientes sufrió un error, por lo que los usuarios no podían iniciar sesión ni hacer pedidos. Según los recuerdos de Werner, el problema duró más de doce horas, y Amazon perdió millones de dólares.
El proveedor de bases de datos llegó más tarde. Werner pensaba que el otro lado se disculparía seriamente, pero lo que escuchó fue: “Deberían hacer bien los tests”.
Si hay un problema con el producto propio, ¿cómo se culpa al cliente?
Werner, por supuesto, estaba enojado, pero más tarde se dio cuenta de que el tamaño de Amazon realmente había superado con creces el alcance del software comercial diseñado para este sistema. Continuar discutiendo con los proveedores tampoco resolvería el próximo problema.
Así, el equipo comenzó a investigar un problema más básico. ¿Cómo utiliza Amazon realmente la base de datos?
Los resultados de la investigación muestran que aproximadamente el 70% de las escenas de uso de bases de datos relacionales requieren solo acceso por clave-valor.
En el caso del carrito de compras, el sistema generalmente solo necesita obtener el carrito correspondiente basándose en la identificación del usuario. Amazon no necesita mostrar todos los carritos de compras de los usuarios para realizar una consulta compleja.
Dado que es así, ¿podría el equipo encontrar otra forma de implementación? Pensando en la forma real de acceso, construyeron un sistema de almacenamiento de claves-valores Dynamo, que es el precursor de DynamoDB.
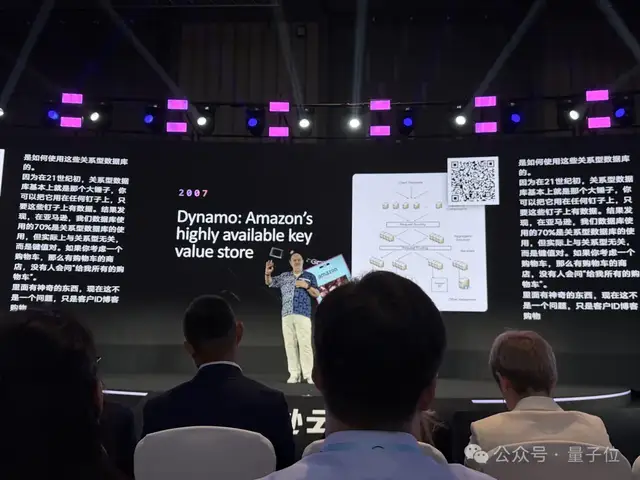
Esta experiencia, si la comparamos con hoy en día, nos resulta bastante familiar. En aquel entonces, todos usaban los bases de datos relacionales como un gran martillo para resolver diversos problemas de datos, y ahora, los modelos grandes también se han convertido fácilmente en ese martillo útil.
Al hablar sobre la implementación de IA en las empresas, lo que Werner repetidamente preguntaba eran preguntas similares. ¿Qué es exactamente lo que las empresas quieren resolver? ¿Es adecuada la IA? ¿Es adecuada la IA actual de esta generación?
Le recordó que en áreas como el reconocimiento de imágenes, el procesamiento de voz y la predicción, ya se han acumulado numerosas técnicas efectivas. Antes de elegir una tecnología, las empresas deben considerar el propio objetivo del trabajo. Incluso si se utiliza un gran modelo, no es necesario competir por ser el número uno en las listas.
Werner tiene reservas respecto a las pruebas de referencia, ya que existe una distancia entre las pruebas creadas intencionalmente y el negocio real. Si un modelo es suficiente para completar la tarea, las empresas deben reconsiderar los beneficios si continúan pagando por un ranking más alto.
Además, Werner ha hecho este cálculo,ya hace más de veinte años.
Cuando el tema de conversación se desplaza hacia los cambios fundamentales que trae el cloud computing, él da especial importancia al cambio en el modelo económico.
En el pasado, al comprar software empresarial, las empresas solían tener que firmar contratos de cinco o diez años. Los gerentes tenían dificultades para predecir las necesidades del próximo año, pero tenían que pagar primero. Werner considera que esto es como cuando un cliente entra en un restaurante y deja mil dólares, sin comerlo y sin devolver el dinero.
El cloud computing relaciona el uso de recursos con los pagos, y también le da un significado real al “reducción”. Cuando hay menos usuarios por la noche, las empresas pueden desactivar los recursos que no son necesarios. Los costos finalmente pueden entrar en el debate de la arquitectura, y los departamentos de negocios también deben responder sobre cuánto vale realmente invertir en cada habilidad.
En la era de la IA, este asunto tiene nuevos proyectos.
Por ejemplo, cuando se preguntó en QuantumBit, “¿Por qué incluso el olvido se ha convertido en un problema importante de ingeniería?”, Werner dijo abiertamente que si el agente tuviera que escanear todo lo que sabe antes de cada trabajo, el costo de sistema sería muy alto; los desarrolladores necesitan encontrar una manera para que el agente conserve solo lo que es realmente importante para la tarea.
También mencionó que algunos herramientas de programación, al volver a iniciarse, vuelven a cargar el contenido del proyecto. Los usuarios ya pagaron por estos preparativos ayer, y hoy tienen que hacerlo de nuevo. La memoria entre sesiones de Kiro es precisamente para reducir este trabajo repetitivo.
Así que, además de lo inteligente que sea el modelo, los desarrolladores deben preguntarse cuánto trabajo inútil ha realizado en repetidas ocasiones para completar una tarea.
Esto también explica por qué Werner está dispuesto a trabajar con modelos más pequeños, así como con modelos de peso abierto como DeepSeek, Tongyi Qianwen y Kimi. Según sus observaciones, algunos clientes, después de experimentos continuos, descubrieron que modelos más pequeños ya pueden satisfacer las necesidades, y el costo de uso es mucho menor.
¿Con qué, cómo y cuánto dinero se invierte? Estas viejas preguntas siguen siendo difíciles de superar para las empresas cuando se trata de la IA.
¿Quién cubrirá las culpas del Agente?
Incluso si la empresa calcula los costos, hay otro problema que espera al equipo de desarrollo.
El robot de chat proporciona un texto que la persona puede leer antes de decidir qué hacer. El agente, por su parte, tomará medidas en nombre del usuario: modificar el itinerario, llamar a herramientas o ejecutar programas. Si el modelo da una respuesta incorrecta, el error podría convertirse en consecuencias reales a lo largo del proceso de ejecución.
Werner, durante la conversación, expresó que estaba dispuesto a dejar que el Agent ayudara a modificar el billete, pero también tenía requisitos específicos. El sistema debe saber cómo operar, recordar sus preferencias y, al mismo tiempo, estar sujeto a restricciones.
Y este apego a los límites ya se menciona en la historia de Nitro que él cuenta.
El cloud en sus inicios dependía de la virtualización, que dividía un servidor físico entre varios usuarios; sin embargo, el software que gestiona las máquinas virtuales, maneja el acceso a redes y al almacenamiento también consume recursos. A medida que aumenta el número de máquinas virtuales, la gestión podría convertirse en un punto de estancamiento.
Después, AWS desarrolló Nitro, deslocalizando una gran cantidad de funciones de red y almacenamiento en hardware especializado, y eliminando el entorno de gestión de Linux completo dom0 original. El equipo redujo las limitaciones de rendimiento y, al mismo tiempo, disminuyó significativamente su superficie de ataque.
Nitro también tiene un diseño interesante llamado “comunicación pasiva”. Según la explicación de Werner, el monitor de máquinas virtuales espera que el controlador de Nitro envíe comandos. Si actúa de forma activa para contactar al controlador, se produce un comportamiento que no debería ocurrir en el proceso normal; la plataforma puede entonces retirar el servicio del sistema relacionado y iniciar una investigación.
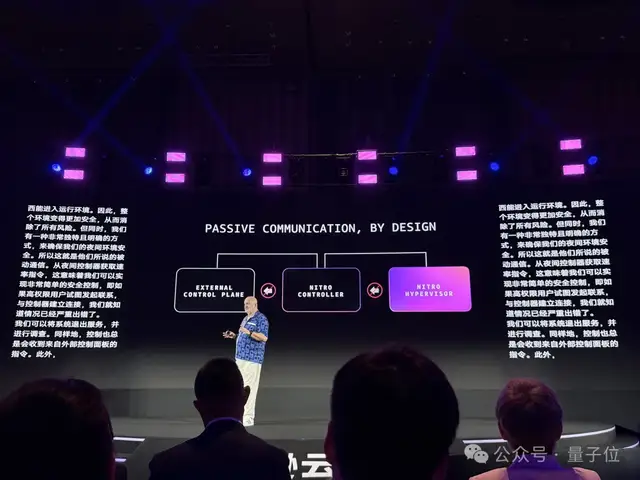
Siguiendo este enfoque, también es fácil entender los requisitos de Werner para el Agente. Lo que el sistema debe permitir a los usuarios debe estar claro de antemano. Él dio un ejemplo sencillo: los usuarios pueden establecer que el Agente no debe gastar más de 100 dólares al día; si se supera ese límite, es necesario que haya intervención humana en la toma de decisiones.
Según su presentación, Amazon ha diseñado un mecanismo de ejecución de reglas para el Agent. Este mecanismo verifica las operaciones del Agent, como el acceso a herramientas y la ejecución de scripts, con el fin de limitar sus acciones dentro del alcance de la autorización explícita del cliente.
La autorización del usuario para actuar de manera autónoma establece un marco específico; incluso si el modelo determina que algo es valioso, el sistema de ejecución debe verificar si tiene la autoridad para llevarlo a cabo.
Pero, ¿estarían estos restricciones en detrimento de la eficiencia del Agent? Ante esta cuestión, Werner comenzó hablando sobrela responsabilidad.
Si lo construyes, eres responsable de él. (Si lo construyes, lo posees.)
En su opinión, los desarrolladores del Agent deben poder controlarlo. Lo que hace el sistema y si supera los límites, en última instancia, sigue dependiendo de las personas.
Werner también ha devuelto su confianza en la IA a la experiencia con los sistemas distribuidos. Los ingenieros nunca supongan que cada componente será siempre confiable, por eso son necesarias la replicación, la separación y los diversos mecanismos de fiabilidad. El equipo debe estar alerta con respecto a cada componente individual para poder establecer una confianza en todo el sistema.
Sin embargo, los ingenieros tienen que crear estos mecanismos de protección como algo que los clientes puedan pagar y que no retrase significativamente las tareas, lo que implica muchas decisiones difíciles. Lambda también ha enfrentado problemas similares.
En sus inicios, WeTransfer necesitaba mantener activas un grupo de instancias de cálculo para procesar los archivos subidos a S3, esperando la llegada de nuevos archivos. Los clientes tenían que mantener todo un sistema de infraestructura solo para esperar que esto ocurriera.
AWS espera tomar estas tareas, permitiendo a los clientes enviar código y pagar según el tiempo de ejecución y el uso de memoria. El equipo ha decidido cómo se realizarán los cobros y cómo se implementará de manera eficiente en la capa subyacente, pero sigue siendo un desafío.
Para aislar a diferentes clientes, las máquinas virtuales utilizadas en los inicios de Lambda eran demasiado grandes y costosas para las tareas de función. Más tarde, el equipo creó unidades de aislamiento más ligeras mediante Firecracker, lo que permitió mejorar la utilización de recursos.
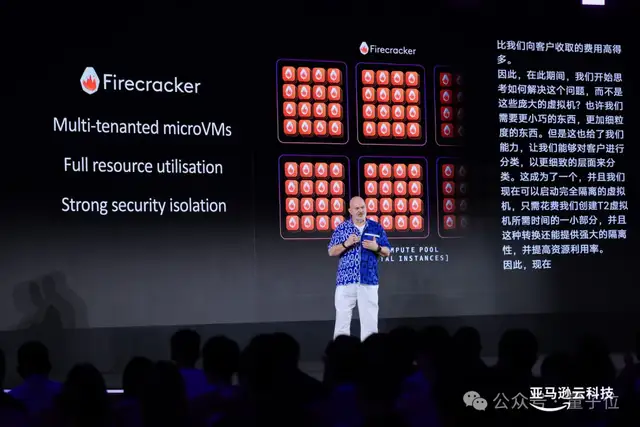
Después de que se resuelva el problema de aislamiento, el equipo debe manejar el arranque en frío. Antes de que la función se ejecute realmente, el sistema necesita preparar el entorno de ejecución, el código y las dependencias. SnapStart, al guardar una captura de escena del entorno inicializado, reduce este costo de preparación y mejora el rendimiento del arranque.
Lo que el cliente ve, podría ser solo una llamada a una función. Sin embargo, el equipo de ingeniería debe trabajar en secreto para mejorar las medidas de aislamiento, la asignación de recursos, el inicio y los mecanismos de red.
Werner llama a estos trabajos “la innovación de ingeniería invisible”.
Para que el agente pueda entrar en el negocio real, el equipo de desarrollo no puede prescindir de estas tareas detalladas. Después de que la demostración funcione correctamente, el equipo debe seguir definiendo cómo se restringen los permisos, cómo se manejan las excepciones y qué alcance de tareas el usuario está dispuesto a encomendarle.
La experiencia no tiene algoritmos de compresión
Cuando el agente comienza a escribir código, estas cuestiones vuelven a recaer sobre el propio equipo de desarrollo.
En cuanto al empleo de ingenieros principiantes, Werner respondió que Amazon contrata a ingenieros principiantes en la misma cantidad que en el pasado. Luego, cambió el tema hacia el aprendizaje de los nuevos miembros después de unirse al equipo.
Una persona recién graduada se une al equipo de S3, y podría enfrentarse a código de hace veinte años. Es difícil que la escuela le enseñe de antemano cómo entender un sistema así, así como cómo colaborar con las personas que lo mantienen.
Por lo tanto, Werner valora la curiosidad, la capacidad de aprendizaje y las experiencias en proyectos de código abierto. Que un novato haya participado en colaboración de código abierto significa que su código ha sido revisado por otros, y también necesita resolver problemas junto con otras personas.
La IA puede ayudar a los novatos a explicar las reglas del equipo, lo que permite que los ingenieros experimentados dedican menos tiempo a repetir explicaciones. Cuando Werner presenta a Kiro, también enfatiza el enfoque basado en descripciones de especificaciones. Los desarrolladores primero deben aclarar las necesidades, la arquitectura y las reglas de desarrollo, antes de permitir que el sistema funcione.
Sin embargo, la velocidad con la que la IA genera código ha aumentado, y la velocidad con la que el equipo comprende e inspecciona el código no necesariamente se alinea con esa.
Werner mencionó un concepto que vale la pena que el equipo de desarrollo tenga en cuenta: la verificación de deudas.
En el pasado, para acelerar el progreso, los desarrolladores tomaron atajos, anotando que serían corregidos posteriormente. Lo que se acumuló fue deuda técnica. Ahora, en los códigos generados por IA, algunas partes aún no han sido verificadas, y el equipo ha dejado otra deuda.
Un elemento de interfaz se desvió unos milímetros, en comparación con un código que podría revelar información del cliente, las consecuencias son muy distintas. El equipo de desarrollo debe realizar inspecciones según el riesgo, y concentrar su esfuerzo en las áreas que requieren mayor verificación.
Desde la perspectiva de Werner, es fácil que el equipo aumente la producción de código, pero si se puede comprender ese código y asumir las consecuencias que implica, eso debe medirse por separado. De lo contrario, el tiempo que los desarrolladores ahorran hoy podría ser desperdiciado en futuros reparos y trabajos adicionales.
Esto es también por qué Werner insiste en que los ingenieros principiantes lean el código, y que los ingenieros experimentados lo examinen y discutan junto con ellos. Las herramientas pueden explicar el conocimiento, pero la capacidad de juicio necesaria para enfrentar problemas específicos sigue requiriendo un acumulación gradual.
No existe un algoritmo de compresión para la experiencia.
La frase de Werner es muy adecuada para responder a la ansiedad de los desarrolladores.
Sin embargo, al hablar del viaje a China, contó otro ejemplo que lo hizo más optimista sobre las aplicaciones de la IA. Pasó mucho tiempo explicando las experiencias que tuvo con “arroz y mijo”.
La institución ofrece servicios de intervención para niños que tienen necesidades de apoyo en el desarrollo, como el autismo y la discapacidad por déficit de atención con hiperactividad. Según Werner, la institución utiliza el análisis de IA de los registros de enseñanza y observa el progreso de los niños, y proporciona sugerencias a los terapeutas. Los terapeutas, combinando su juicio profesional, deciden qué sugerencias implementar.
Lo que lo impresionó fue que la IA ayudó a los profesionales a reducir el trabajo administrativo, permitiéndoles dedicar más energía a sus hijos y a su familia.
Al hablar de esto, la optimismo de Werner tiene un objeto concreto. ¿Quién puede reducir la carga y quién puede recibir ayuda que antes era difícil obtener? Estas aplicaciones concretas le hicieron ver el valor de la IA.
Mirando atrás, la frase “primero presionar el botón de pausa” hace que las cosas que una empresa necesita detenerse para pensar claramente sean más concretas. Si es adecuado encomendar la tarea a la IA, si los costos son soportables, cuál debe ser el alcance de las acciones y quién debe verificar los resultados, todo el equipo de desarrollo debe responder a cada uno de estos puntos.
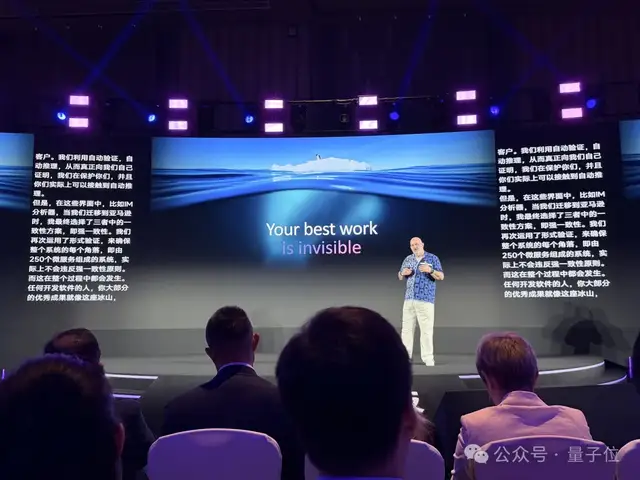
Werner dijo que el trabajo más destacado de los desarrolladores, a menudo, se esconde en lugares donde otros no pueden verlo.
La IA escribió un fragmento de código en lugar de las personas, y los ingenieros deben saber qué sucederá una vez que este código se lancee.