
Diseñar circuitos cuánticos más eficientes con Claude
16 de octubre de 2026
Los ordenadores cuánticos necesitarán circuitos diseñados cuidadosamente para ejecutar algoritmos útiles en hardware limitado. Le proporcionamos a Claude especificaciones en lenguaje sencillo para ocho de dichos circuitos, extraídos de química, optimización, simulación física y teoría numérica, junto con un evaluador automático que verifica y evalúa cada diseño. Trabajando en gran medida por sí mismo, Claude encontró diseños que mejoran a los mejores circuitos publicados, en algunos casos en una ordre de magnitud o más. Dichas mejoras reducen significativamente los recursos cuánticos que requieren las aplicaciones útiles, por lo que los ordenadores cuánticos prácticos podrían llegar antes de lo previsto.
Este trabajo fue liderado por Andi Gu como parte del Programa de Fellows STEM de Anthropic, con la orientación de Alek Kemeny, un físico cuántico de Anthropic, en colaboración con Susanne Yelin (Universidad de Harvard) y Mikhail Lukin (Universidad de Harvard y QuEra Computing) Lea el artículo completo en arXiv.
A diferencia de los ordenadores clásicos, que almacenan información en bits cuyo valor es 0 o 1, los ordenadores cuánticos almacenan información en qubits, que pueden ser construidos a partir de átomos individuales, circuitos superconducentes o partículas de luz. Estos qubits utilizan fenómenos cuánticos como la superposición —que permite que un sistema cuántico exista en una combinación de estados al mismo tiempo— para procesar información de manera que algunos problemas en campos como la química, la ciencia de materiales y la teoría numérica sean tractables, incluso cuando son demasiado difíciles para los ordenadores tradicionales.
Los ordenadores cuánticos que el campo ha desarrollado hasta ahora solo tienen cientos o miles de qubits—demasiados pocos para ejecutar muchos de los algoritmos que prometen ventajas prácticas sobre los ordenadores clásicos. Y estos qubits son muy sensibles al ruido ambiental, como el calor, las vibraciones e incluso los rayos cósmicos. Una pequeña perturbación puede alterar el estado de un qubit, y estos errores pequeños se acumulan hasta que el ordenador da la respuesta incorrecta.
Dado que tanto los cubits como el tiempo de computación son recursos escasos, los investigadores han estado trabajando para rediseñar algoritmos cuánticos para utilizar menos cubits y completar las computaciones en menos tiempo. Un ejemplo ilustrativo es la simulación de FeMoco, el agregado de hierro-sulfuro en el corazón de la nitrogenasa, la enzima que las bacterias utilizan para convertir el nitrógeno del aire en amoníaco. Comprender cómo funciona podría ayudar a los científicos a diseñar catalizadores industriales mejorados: las sustancias que los fabricantes utilizan para acelerar las reacciones químicas.
En 2017, los investigadores estimaron que un ordenador cuántico necesitaría alrededor de 50 billones de puertas Toffoli para calcular la energía del estado fundamental de FeMoco: la energía de su configuración más estable, que los químicos necesitan para predecir cómo reacciona FeMoco. (Al igual que los ordenadores ordinarios, los ordenadores cuánticos funcionan aplicando una larga secuencia de operaciones simples, llamadas puertas, a sus qubits.) La puerta Toffoli es una de las puertas más costosas de operar, por lo que contar las puertas Toffoli es una forma estándar de estimar cuánto tiempo tardará un cálculo.
A través de una serie de avances algorítmicos, la cantidad estimada de puertas ha disminuido a aproximadamente 340 millones—una reducción de unos 150,000 veces, que corresponde a unas pocas horas de computación en una máquina futura con alrededor de tres millones de qubits físicos.1
Estas reducciones provienen en gran medida de la reingeniería de los circuitos que realizan el cálculo, más que de la adquisición de hardware mejorado. Claude ha demostrado ser especialmente hábil para optimizar algoritmos clásicos, por lo que queríamos ver si podría hacer lo mismo con los algoritmos cuánticos si se le proporcionara solo una descripción en lenguaje sencillo de lo que cada circuito debe calcular.
Claude es excepcionalmente adecuado para esta tarea por varias razones. Primero, los algoritmos cuánticos se implementan como cuánticos circuitos. Estos están compuestos por secuencias de puertas, como las puertas Toffoli mencionadas anteriormente. Es importante destacar que estos circuitos pueden describirse en código, por lo que podemos utilizar las capacidades de programación de Claude para escribir, ejecutar y revisar diseños de circuitos como programas normales. En segundo lugar, la clase (bastante común) de algoritmos cuánticos que más nos interesa optimizar puede probarse de manera eficiente para verificar su corrección, ya que cada entrada produce un resultado definido que un ordenador normal puede comprobar. Esto significa que podríamos tener un programa de evaluador externo para validar las propuestas de Claude. Finalmente, podemos darle a Claude una puntuación clara y objetiva para mejorar: el número de qubits utilizados, multiplicado por el número de puertas, lo que sirve como un indicador de cuánto tiempo tomaría ejecutar el circuito.
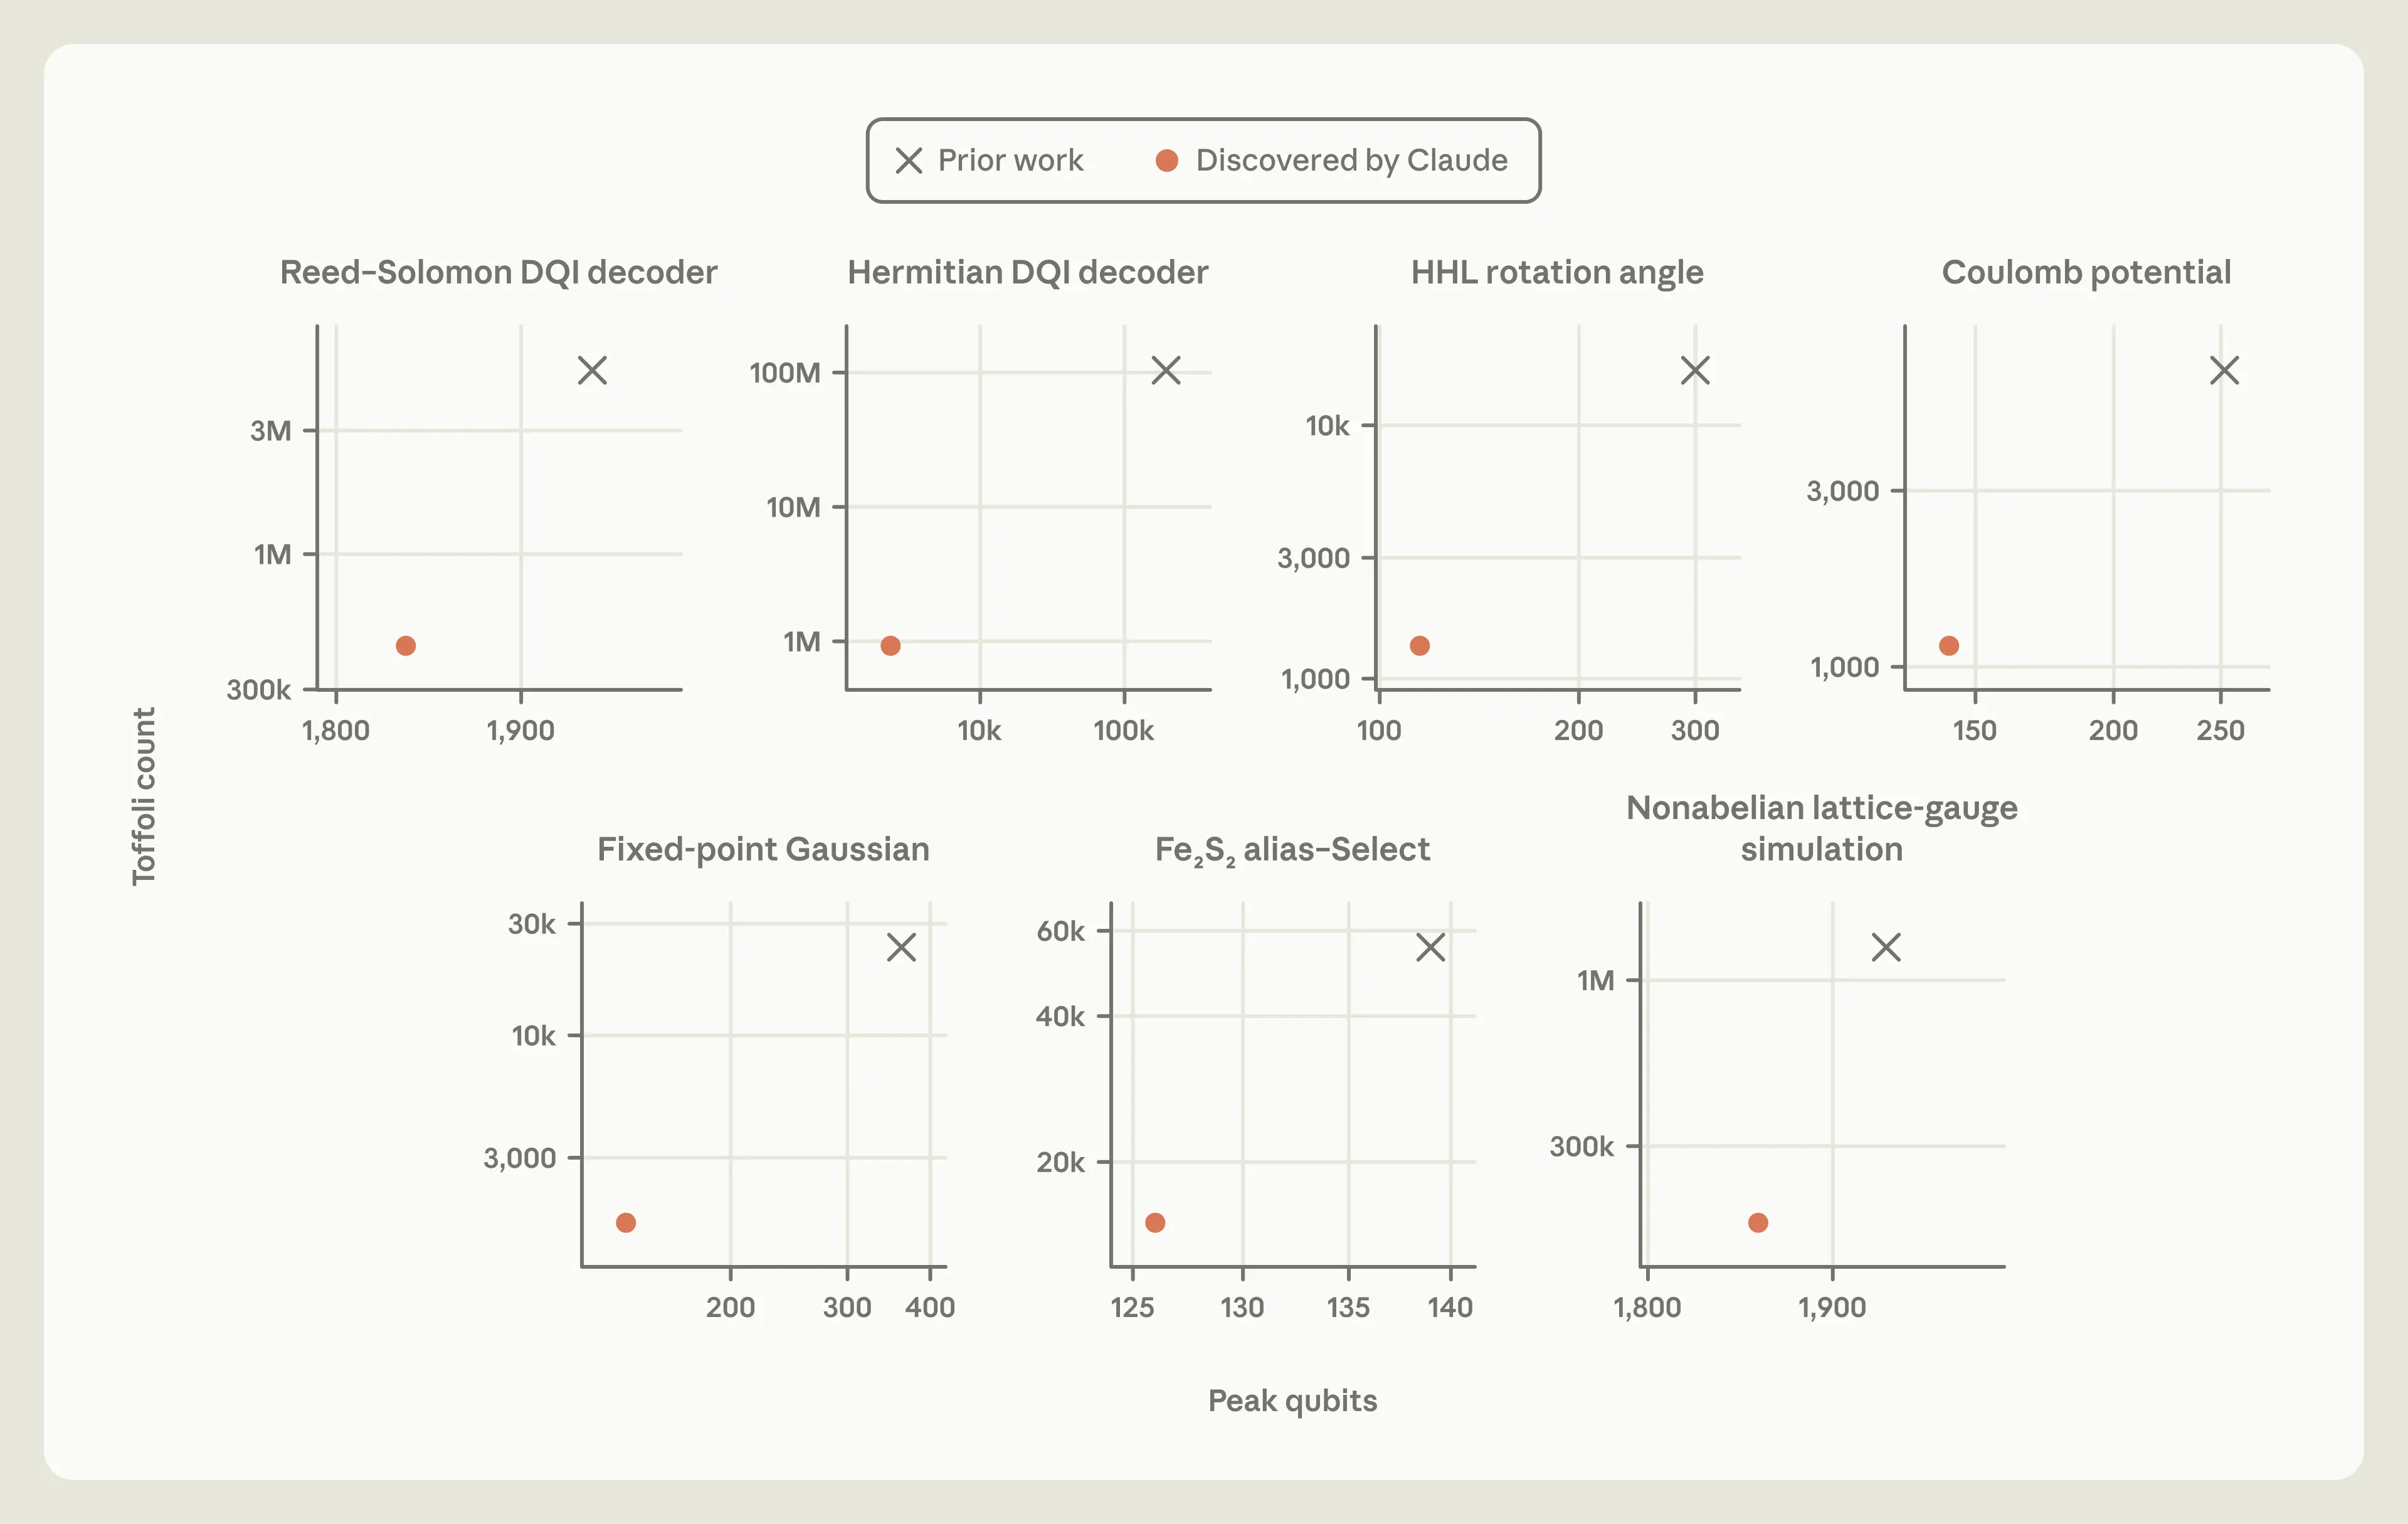
Descubrimos que Claude Mythos 5 podía funcionar con éxito en un ciclo cerrado, proponiendo un diseño de circuito, recibiendo retroalimentación y una puntuación del programa de evaluador, y utilizando esa retroalimentación para mejorar su próxima tentativa, sin intervención humana entre rondas (ver Figura 1). En ocho primitivas computacionales —las rutinas básicas desde las cuales se construyen los algoritmos cuánticos más complejos— para química, optimización, simulación cuántica, teoría de números y computación numérica, Claude descubrió diseños nuevos que utilizan menos qubits y menos puertas que los mejores algoritmos publicados anteriormente (Figura 2).
En cada caso, la mejora se debió a la revelación de nuevas perspectivas estructurales y matemáticas sobre el problema, en lugar de a un ajuste fino de diseños existentes. Por ejemplo, al compilar un circuito para simular una molécula de sulfuro de hierro, Claude se dio cuenta de que las simetrías y la estructura repetitiva de la molécula significaban que algunos resultados podían calcularse una vez y reutilizarse, en lugar de volver a calcularse para cada parte del sistema. En otros casos, descubrió que los circuitos existentes contenían componentes costosos que solo eran necesarios para manejar entradas extremadamente raras, y los rediseñó sin esos componentes.
A continuación, describimos dos de los descubrimientos de Claude. El primero es una nueva forma de realizar la inversión modular, un tipo de aritmética que constituye el paso más costoso en los cálculos de curvas elípticas. El segundo hace que el paso más costoso de un algoritmo de optimización cuántico líder sea aproximadamente 12 veces más barato.
Estos resultados sugieren que la IA puede ayudar ahora en el rediseño de circuitos cuánticos, un paso clave para hacer que los algoritmos cuánticos se ejecuten de manera más rápida y fácil. Un diseño de circuitos más rápido podría permitir resolver los problemas que los ordenadores cuánticos están destinados a abordar, desde la creación de nuevos medicamentos y baterías más eficientes hasta la búsqueda de métodos más limpios para producir fertilizantes, de forma más rápida.
Un nuevo algoritmo reversible
El diseño de un circuito cuántico implica dos restricciones que la programación ordinaria no tiene. La primera es que un circuito cuántico no puede tomar decisiones del tipo “si-then” de la misma manera que un programa ordinario. Un programa ordinario puede verificar un valor y luego ejecutar solo uno de los dos fragmentos de código. Pero una computadora cuántica opera sobre una superposición de muchos entradas al mismo tiempo; algunas de ellas ejecutarán el primer fragmento de código y otras, el segundo. Por lo tanto, el circuito debe incluir las operaciones para ambos en cada ocasión en que se ejecute.
El segundo es que un circuito cuántico no puede descartar información. Un programa ordinario puede sobrescribir o eliminar su trabajo preliminar una vez que esté completado; en una computadora cuántica, tal información intermedia no puede simplemente ser borrada, porque cada paso del circuito cuántico debe ser reversible. Tampoco es posible dejar esa información en su lugar, porque el trabajo preliminar restante podría dañar el resultado final. La única forma de descartar información es “descomponerla” ejecutando el cálculo que la generó en orden inverso, a costa de adicionales puertas lógicas. Ambas restricciones hacen que los circuitos cuánticos sean mucho más costosos, tanto en términos de tiempo de ejecución como de qubits, que sus equivalentes clásicos.
Esta restricción impone un difícil equilibrio entre espacio (es decir, qubits) y tiempo. En un extremo, un circuito cuántico puede eliminar los resultados intermedios tan pronto como sean utilizados. Esto libera los qubits, pero si esos mismos resultados se necesitan nuevamente más tarde, el circuito debe volver a calcularlos, lo que aumenta la cantidad de puertas y el tiempo de ejecución. En el otro extremo, el circuito puede mantener los resultados intermedios hasta que ya no sean necesarios. Esto evita repetir el trabajo, pero puede requerir muchos más qubits.
Esto hace que el diseño de circuitos cuánticos sea una prueba especialmente interesante de las capacidades de Claude. Los circuitos pueden escribirse como código ordinario, pero mejorarlos requiere que el modelo razone bajo un conjunto de restricciones muy diferentes de las de la programación normal.
Un primer examen difícil: inversión modular
La primera tarea que le dimos a Claude fue la adición de puntos, una regla para combinar dos puntos en una curva matemática (una curva elíptica) para obtener un tercer punto. La adición de puntos es el paso clave en los algoritmos cuánticos para el problema del logaritmo discreto en curvas elípticas: dado un punto inicial y el resultado de sumarlo a sí mismo n veces, encontrar n. Para curvas grandes, las computadoras ordinarias no pueden resolver este problema en ningún tiempo razonable, pero una computadora cuántica suficientemente grande podría hacerlo.
Estos algoritmos realizan la suma de puntos muchas veces, incluso en sentido inverso, y estas sumas representan la mayor parte de los costos de qubit y tiempo de ejecución. Problemas como estos—fáciles de calcular, extremadamente difíciles de invertir—estuvieron entre los primeros en los que se demostró que los ordenadores cuánticos ofrecían un aceleración exponencial en comparación con los ordinarios. Por estas razones, la suma de puntos se ha convertido en uno de los puntos de referencia estándar del campo. Esto lo convirtió en una prueba difícil para Claude. Así que le pedimos que mostrara cuántos qubits y cuántas puertas son realmente necesarias para la suma en puntos.
Le dimos a Claude un breve de una sola página. Explicaba la regla matemática para la suma de puntos, y cómo el evaluador verificaría cada circuito propuesto para determinar su corrección, así como la puntuación basada en el número de qubits y puertas que utilizaba. También le indicó a Claude que explorara varios enfoques de forma paralela. Después de trabajar durante 53 horas con una intervención humana mínima (limitada al breve inicial y a algunas sugerencias ocasionales para pensar de manera más amplia), Claude llegó a un enfoque completamente nuevo para el problema.
Las demandas de memoria de divsteps
La mayor parte del costo de la adición de puntos proviene de un único paso, llamadoinversión modular. La aritmética de curvas elípticas utiliza números que vuelven a circular cuando alcanzan un límite fijo. La inversión modular es la versión con vuelo del dividir: dado un entero a, encontrar x tal que ax ≡ 1 (mod p). Las computadoras ordinarias pueden realizar esta operación de manera eficiente utilizando un método llamadodivsteps. Divsteps comienza con una pareja de números y los simplifica repetidamente en muchas rondas de iteración. En cada ronda, divsteps examina la pareja actual de números y, condicionalmente, los intercambia, suma, resta o divide por la mitad. En el proceso, preserva solo la información suficiente para producir el inverso modular al final.
A pesar de su éxito en computadoras ordinarias, divsteps aún no había producido un circuito cuántico práctico, debido a la restricción de reversibilidad descrita anteriormente. El registro de la operación elegida en cada iteración, llamado información de rama, es el tipo de trabajo preliminar que un programa tradicional puede simplemente descartar. En contraste, un circuito cuántico debe conservar ese registro para que el cálculo pueda ejecutarse hacia atrás. Por lo tanto, la versión cuántica directa de divsteps se ve obligada a acumular una larga historia de información de rama, lo que requiere un número enorme de qubits adicionales para almacenarla.
Cómo Claude superó el problema de memoria
Claude reconoció que este enfoque divsteps podría ser prometedor para los circuitos cuánticos, pero solo si existiera una forma de evitar la necesidad de almacenar toda la historia. Tenía una idea: quizás el registro no necesitara almacenarse en absoluto. Claude razonó que podría ser posible inferir (o “descomponer”) directamente la información de rama inspeccionando cuidadosamente el par de números después de cada iteración. En esencia, los propios números almacenarían el registro. El circuito podría luego ejecutarse en sentido inverso sin necesidad de ningún qubit adicional.
Para probar esta idea, Claude exploró varias reglas candidatas simples para realizar el decodificado. Estas reglas iniciales funcionaron en pequeños casos de prueba, pero fallaron cuando Claude las probó a nivel completo del problema, con números de 256 bits.
Claude luego intentó un enfoque más teórico. En lugar de adivinar y probar reglas, se propuso comprender matemáticamente por qué divsteps se comporta de esa manera. Demostró una serie de resultados sobre el proceso de iteración, incluyendo varias nuevas identidades algebraicas. A partir de estas identidades, Claude derivó una fórmula precisa para la regla de decodificación que permitiría recuperar correctamente la información del ramo de los pares numéricos. Luego verificó la fórmula, primero mediante simulaciones numéricas a gran escala y, después, formalizando la afirmación en Lean. Una vez completada toda la validación, Claude produjo la primera implementación reversible de divsteps sin historial de ramas almacenadas.
Una familia de diseños
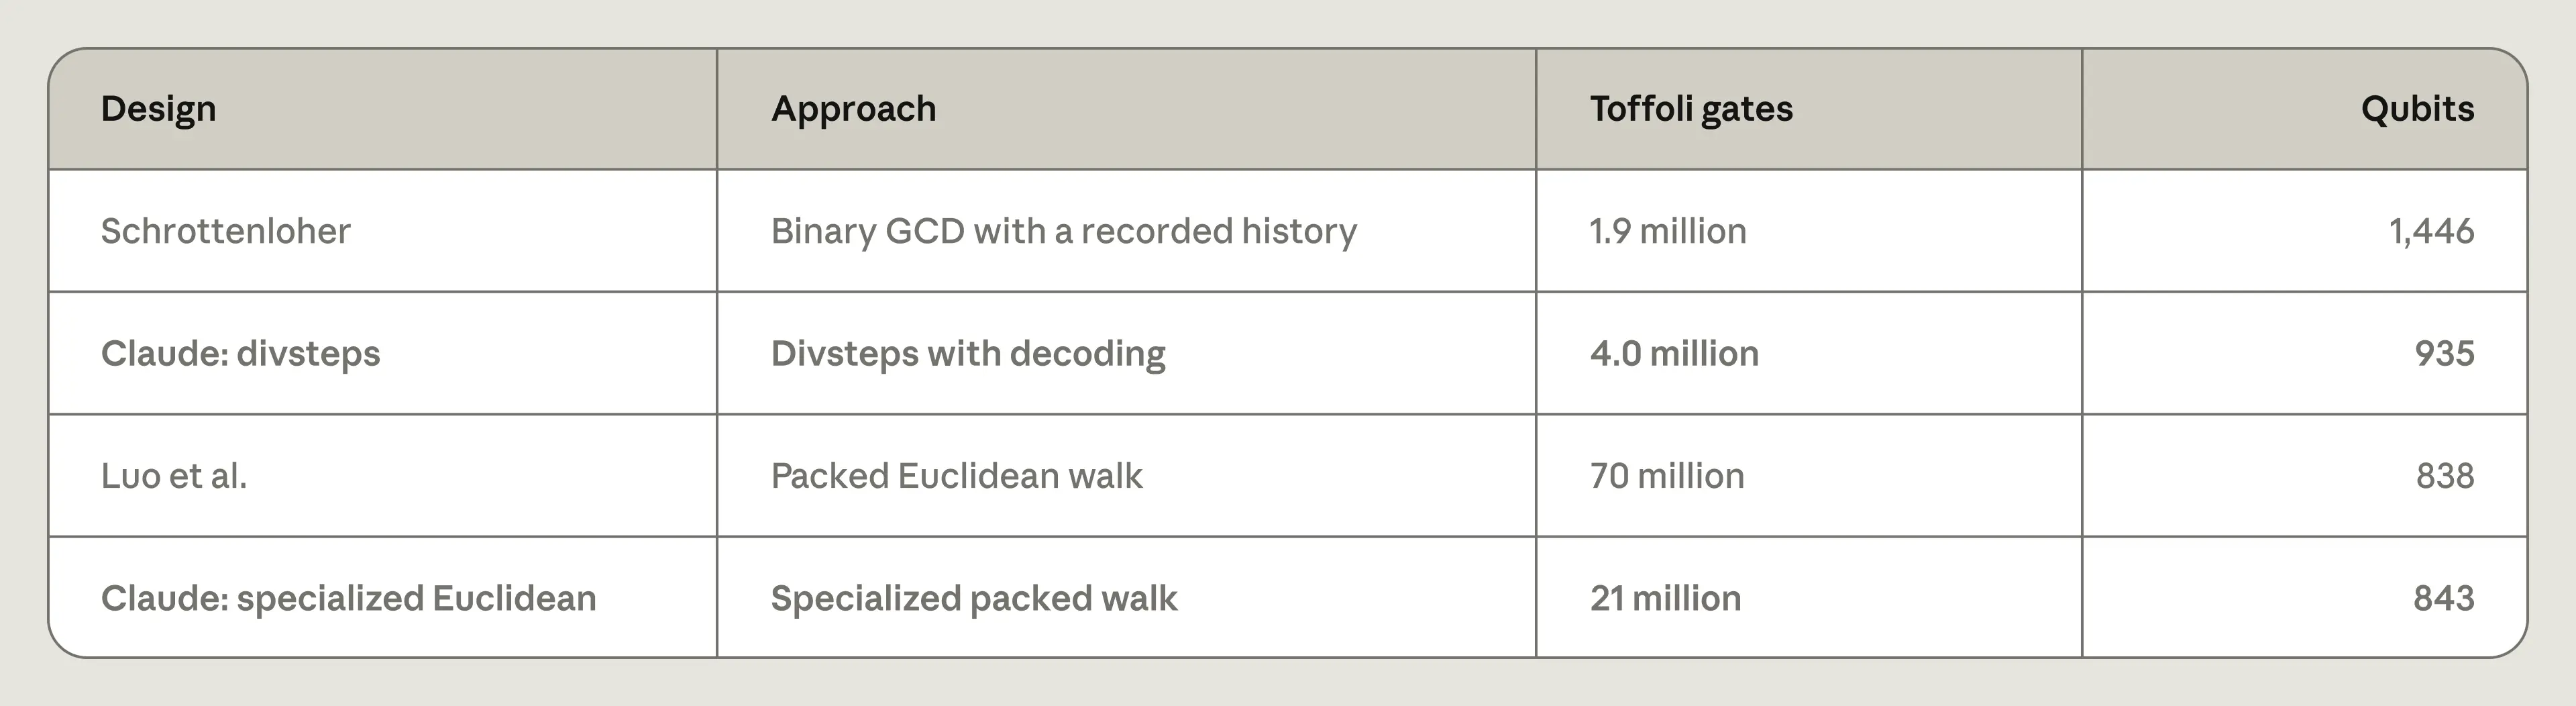
La decodificación ahorra qubits, pero cuesta tiempo. Por lo tanto, como una mejora adicional, Claude buscó situaciones en las que sería más económico almacenar la información de la rama que decodificarla. Al variar el umbral al que el circuito almacena en lugar de decodificar la información de la rama, Claude creó una nueva familia de diseños entre los dos extremos. En comparación con el diseño anterior más pequeño, un circuito de esta familia utiliza 12% más qubits, pero 17 veces menos puertas. En general, los nuevos diseños amplían la frontera de Pareto, ofreciendo combinaciones de número de qubits y tiempo de ejecución que no estaban disponibles anteriormente (Tabla 1).
Optimizar un optimizador cuántico
Los problemas de optimización están en el corazón de una amplia gama de tareas, incluyendo la programación, la logística y el diseño de materiales. Un problema de optimización presenta un conjunto de restricciones competitivas y busca la solución que satisfaga el mayor número posible de ellas. Se han propuesto muchos algoritmos cuánticos para problemas como estos, pero la mayoría prometen solo beneficios modestos o inciertos en comparación con los ordenadores ordinarios. Decoded quantum interferometry (DQI) es uno de los candidatos más fuertes para ofrecer un superpolynomial quantum speedup—una ventaja que se amplía rápidamente a medida que los problemas se vuelven más grandes.
Cuando un ordenador cuántico completa un cálculo, la lectura de sus qubits produce solo una respuesta, seleccionada al azar entre las posibilidades que contenían en superposición. DQI funciona preparando un estado cuántico en el que es más probable que se lea una buena solución que una mala. Para ello se utiliza un decodificador de corrección de errores, que recupera una breve lista de “errores” a partir de un resumen compacto. Este es el paso más costoso del algoritmo. Así que, si pudiéramos crear un decodificador más rápido, también podríamos realizar el DQI de manera más rápida.
Un decodificador cuántico más eficiente
Los investigadores que introdujeron el DQI lo demostraron en un problema llamado intersección polinómica óptima (OPI), una versión basada en cuadros de el ajuste de curvas (Figura 3). Imagine un cuadro en el que cada posición x contiene varios valores aceptables de y. El objetivo es encontrar una curva simple (un polinomio de bajo grado) que pase por un cuadrado aceptable para la mayor cantidad posible de posiciones x. El DQI aborda este problema de optimización utilizando un tipo específico de decodificador, llamado decodificador Reed–Solomon.
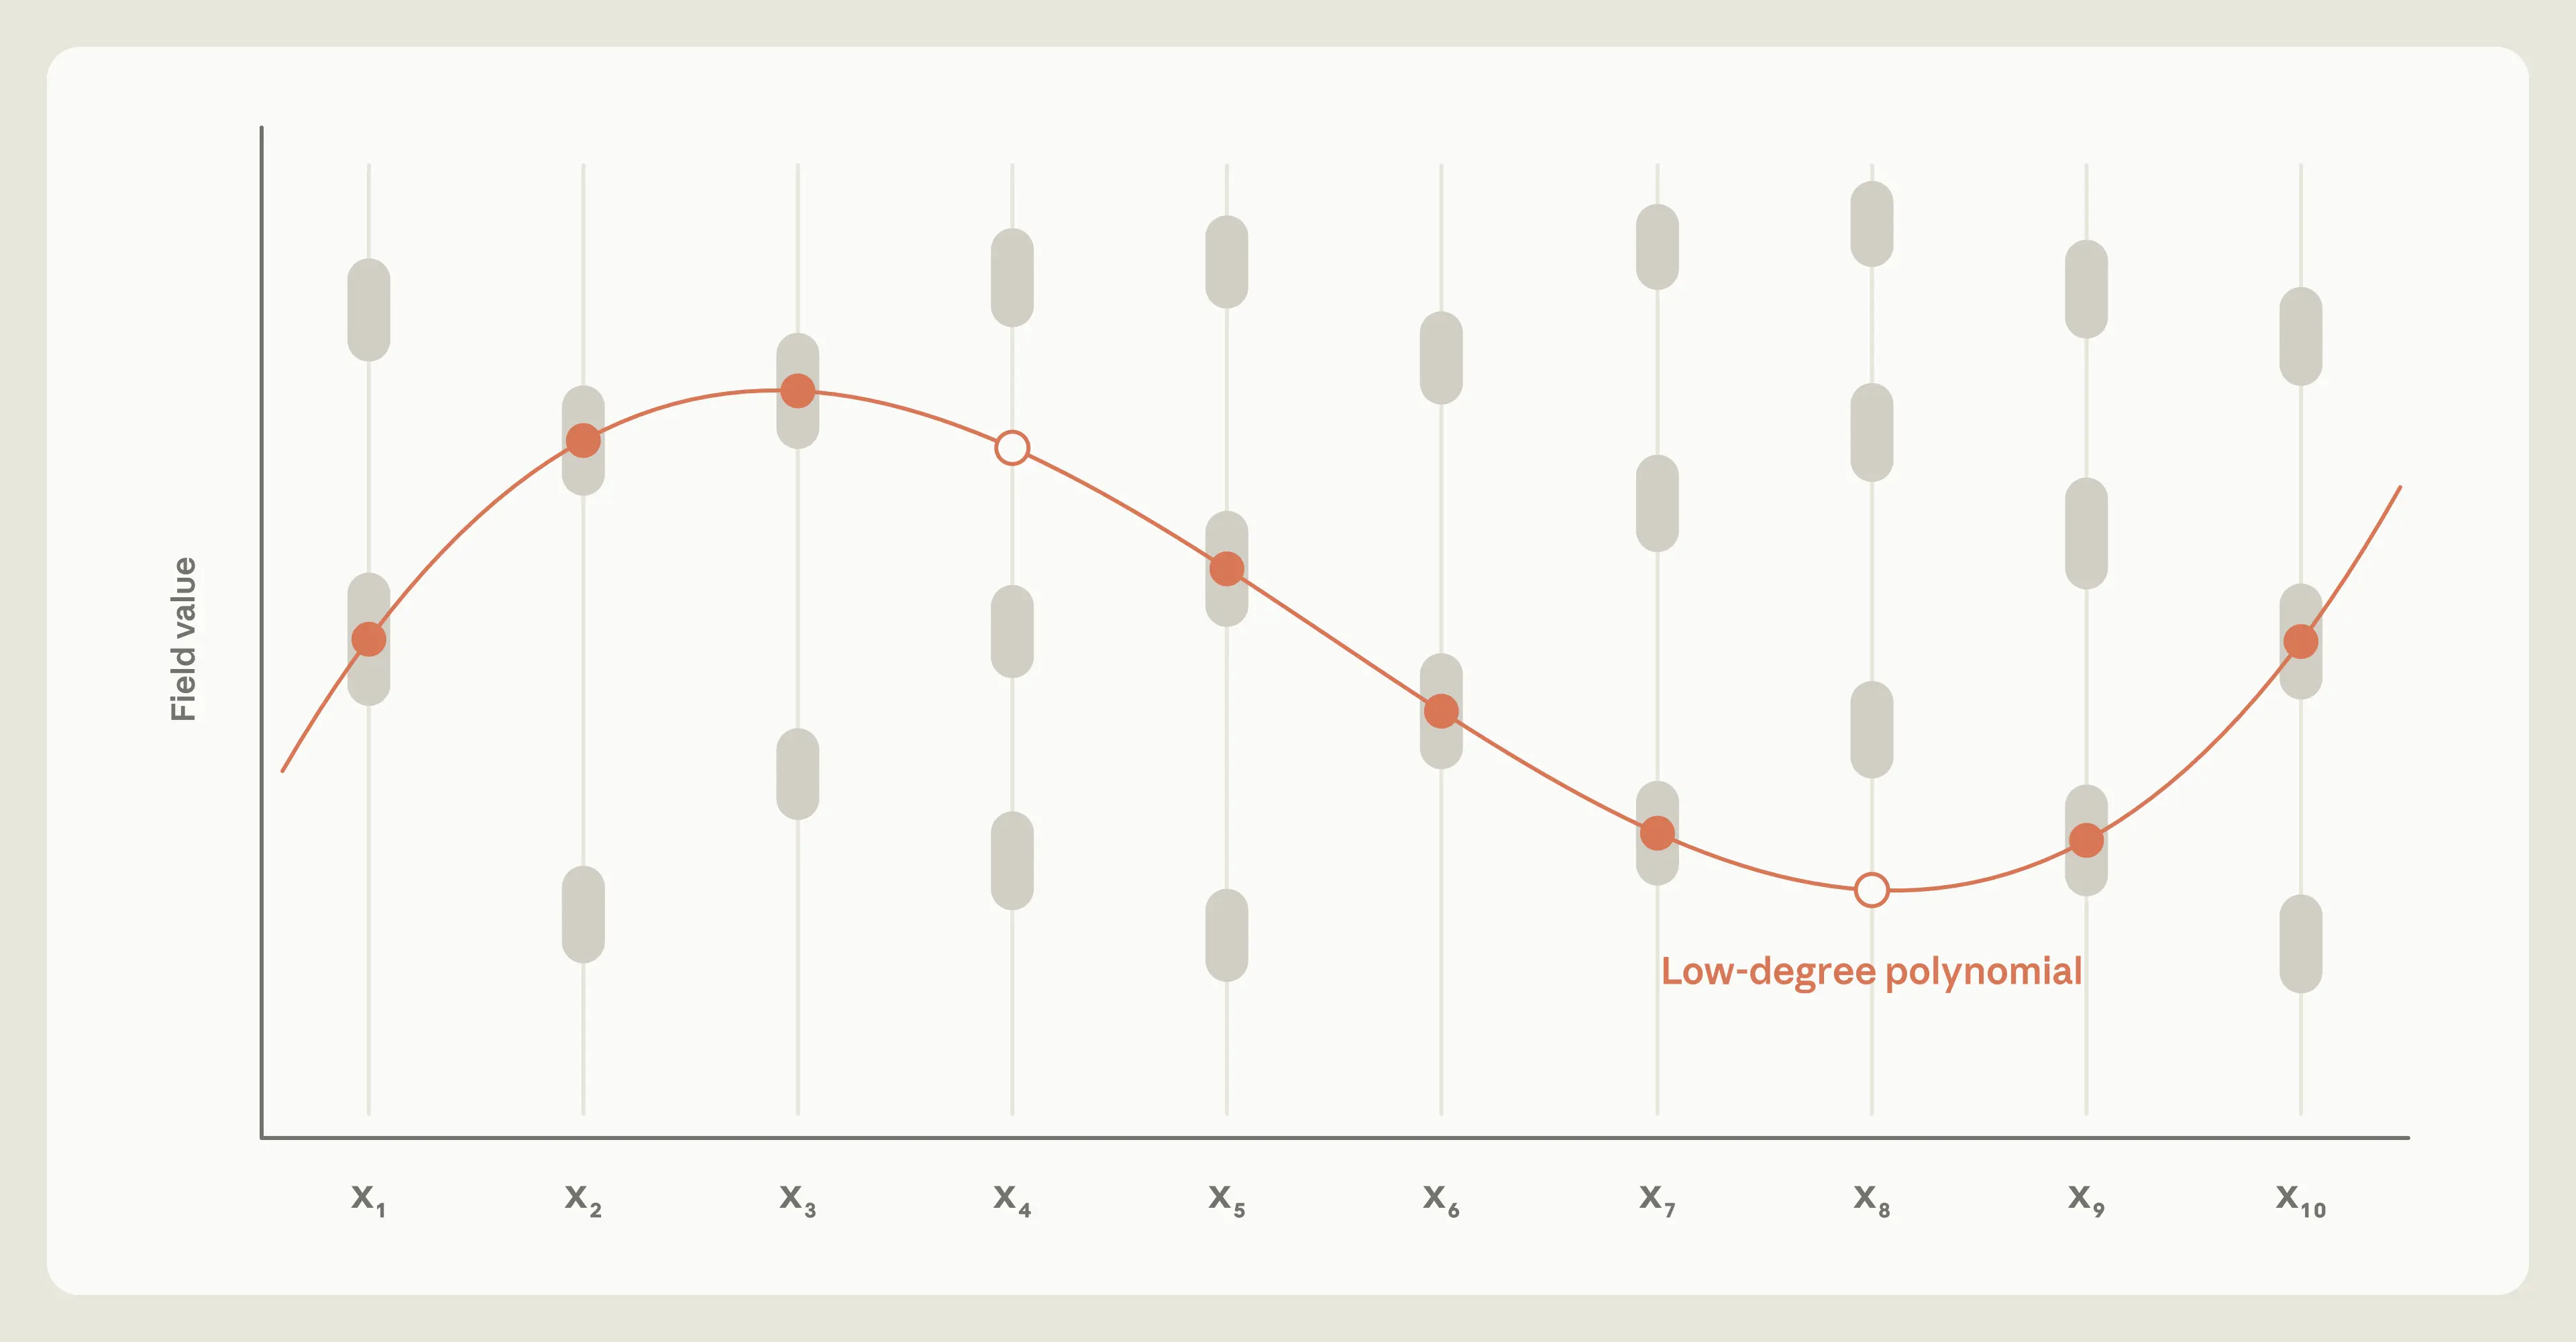
El decodificado Reed–Solomon comienza a partir de la síntesis compacta de los errores mencionados anteriormente, que se conoce como síndrome. La tarea del decodificador es inferir, a partir de esta síntesis, dónde ocurrieron los errores en los datos y qué eran. El estado avanzado anterior de circuitos cuánticos procesaba estos síndromes utilizando el algoritmo eucliano extendido, una secuencia de divisiones y intercambios en las cuales la cantidad y orden de pasos dependen del entorno de entrada específico. Aquí, las restricciones de los circuitos cuánticos reaparecen: mientras que un programa ordinario puede seguir un camino diferente para cada entrada, un circuito cuántico, que trabaja con muchas entradas al mismo tiempo, debe manejarlas todas con una única secuencia fija de puertas. Para gestionar esto, el diseño anterior tenía que extender el cálculo a muchas más rondas de iteración que cualquier entrada individual necesitaría, y tenía que ejecutar cada operación en cada ronda, incluso cuando no fuera necesario.
Mejorar este decodificador podría reducir significativamente el tiempo de ejecución del DQI. Las estimaciones de los investigadores de Google Quantum AI indican que resolver un problema específico de OPI tomaría aproximadamente tres meses en Frontier, uno de los supercomputadores más poderosos del mundo, en comparación con aproximadamente una hora en un computador cuántico futuro que ejecute el DQI. La mayor parte de ese tiempo se invertiría en el decodificado Reed–Solomon.
Así que pedimos a Claude que diseñe un circuito cuántico más eficiente para la etapa de decodificación. Claude concluyó rápidamente que el algoritmo eucliano extendido no era adecuado para un circuito cuántico. En su lugar, organizó su circuito en torno a un método de decodificación diferente, conocido como decodificación Berlekamp–Massey, que lee los síndromes (resúmenes de errores) uno por uno y gradualmente determina la regla más simple que predice cada número en la lista basándose en los anteriores. Una vez que se encuentra esa regla, se revelan los errores. A diferencia del algoritmo eucliano extendido, Berlekamp–Massey realiza el mismo tipo de paso en cada ronda y siempre ejecuta el mismo número de rondas, lo cual se adapta a la secuencia fija de puertas de un circuito cuántico, proporcionando finalmente a Claude una base mucho más eficiente para construir.
Un enfoque simplificado para el almacenamiento
El cambio a Berlekamp–Massey eliminó la necesidad de que el circuito tome caminos diferentes para diferentes entradas. Pero hacerlo reversible introdujo otra dificultad, esta vez como resultado de la restricción de no computación discutida anteriormente. En cada ronda, el circuito calcula valores temporales que solo necesita por poco tiempo, pero esta información no puede simplemente ser eliminada: para descomputarla más tarde, el circuito debe poder recuperar esa información.
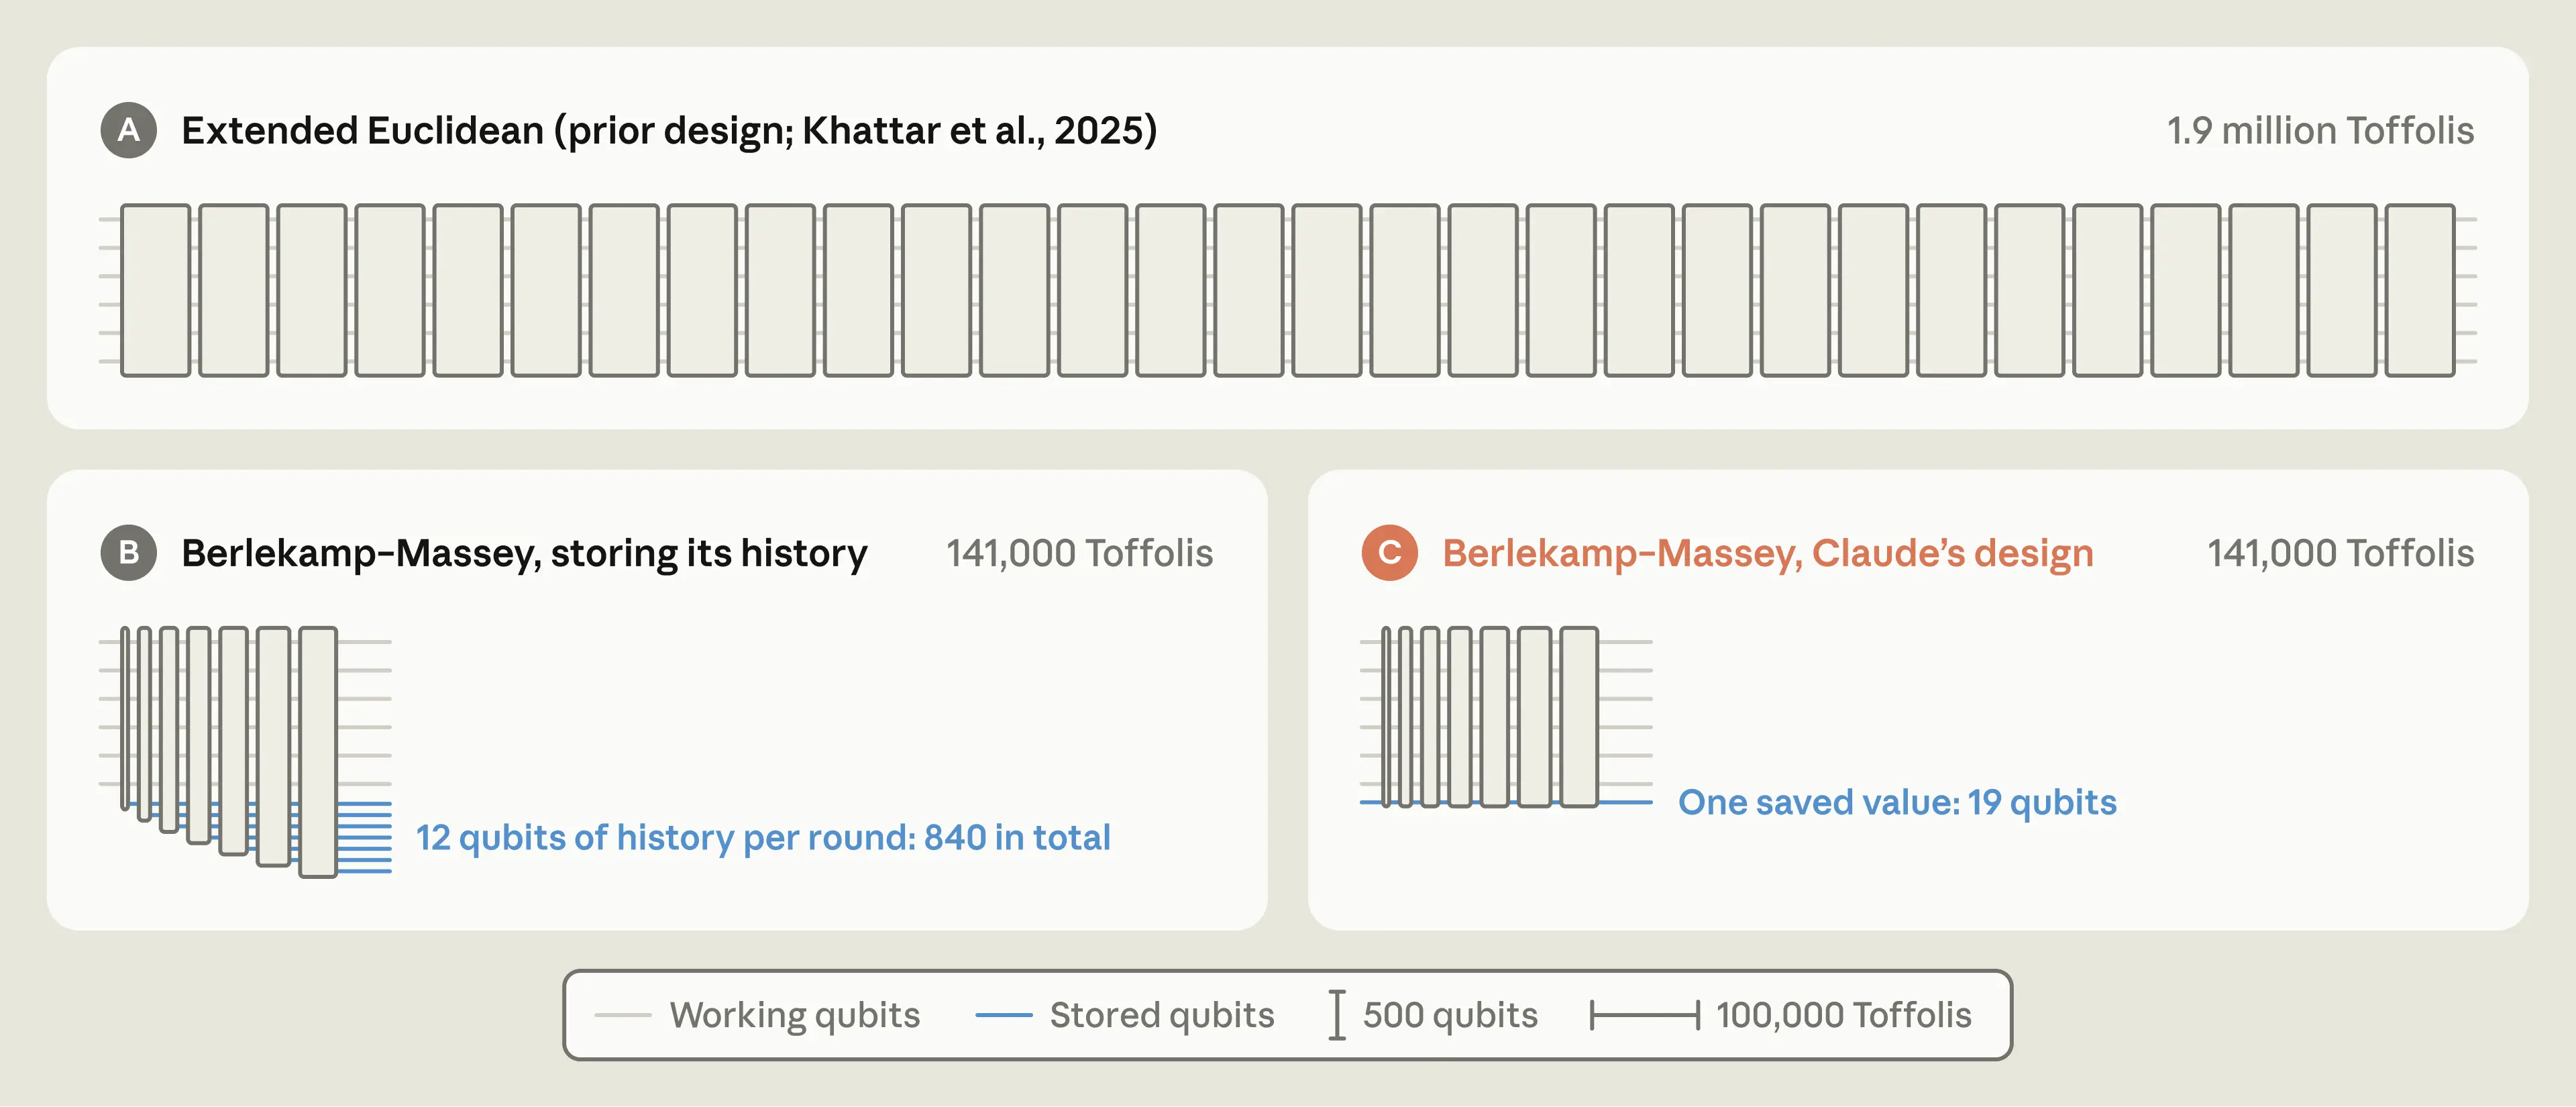
Almacenar esta información habría sido prohibitivamente costoso. Por lo tanto, Claude adoptó el mismo enfoque que había utilizado para divsteps: encontró una forma de reconstruir la mayor parte de esta información a partir del estado actual del circuito, de modo que no era necesario almacenarla. Sin embargo, algunos valores excepcionales no pudieron ser recuperados de esta manera y tuvieron que ser guardados.
Dejando suficiente memoria para el caso más grave posible, en el que aparece un valor excepcional en 35 rondas diferentes, se necesitarían 665 qubits. En cambio, Claude creó un simulador de alta velocidad y ejecutó 403 millones de decodificaciones de muestras para medir con qué frecuencia realmente ocurrían estas excepciones. Casi cada ejecución necesitaba guardar al menos un valor. Por lo tanto, el circuito de Claude reserva espacio solo para un valor guardado, es decir, 19 qubits. Aproximadamente una ejecución de 10,000 necesita más que eso y falla, lo cual está dentro del porcentaje de error permitido por la tarea. Estas mejoras reemplazaron las reservas grandes y de caso peor por un pequeño número fijo de qubits y puertas (Figura 4).
Juntos, estas optimizaciones redujeron el número de puertas en el decodificador en un factor de 12 en comparación con la construcción anterior de Google. La mejora se logró mediante el rediseño del proceso de computación en tres niveles: un método diferente (sustituyendo el algoritmo eucliano extendido por la decodificación Berlekamp–Massey), una arquitectura de circuito diferente (reconstruyendo valores temporales en lugar de almacenarlos) y un presupuesto de recursos diferente (medir con precisión cuánta memoria y computación realmente necesitaba el circuito). Ninguna cambio individual habría sido suficiente por sí solo, pero juntos, hacen que la etapa más costosa del DQI sea un poco más barata en una orden de magnitud.
Lo que aprendimos
El progreso científico a menudo surge de la aplicación de ideas teóricas en la práctica. Una de las principales formas en que esto ocurre es mediante el desarrollo de un proceso que antes se consideraba impracticable, pero que ahora es lo suficientemente rápido y económico para llevarse a cabo. El diseño de circuitos cuánticos es un ejemplo clave: la reducción de 150,000 veces en la estimación de FeMoco tomó muchos grupos de investigación ocho años, y cada paso representaba típicamente meses de trabajo. En contraste, el diseño de curva elíptica de Claude fue el resultado de una sola ejecución de 53 horas.
Nuestros resultados sugieren que la IA puede apoyar el trabajo de diseño de circuitos, produciendo implementaciones que acercan las computaciones cuánticas útiles a las capacidades del hardware real. Si la IA puede acelerar ese trabajo, el cálculo cuántico útil podría llegar antes.
A pesar del rendimiento alentador de Claude en estas tareas, también observamos algunas limitaciones. En nuestros primeros experimentos, Claude era conservador por naturaleza. Repetidamente cuestionaba las mejoras aparentes y, a veces, seguía verificando dos o incluso tres veces los resultados que ya estaban bien respaldados. Esta precaución a veces era valiosa: por ejemplo, lo motivó a escribir pruebas Lean para verificar su diseño divsteps. Pero también se manifestó en una tendencia a preferir los enfoques existentes y conocidos a los más novedosos.
Tomamos dos medidas para mitigar esto. Primero, nuestro sistema requería que Claude propusiera varias enfoques cualitativamente diferentes y que los desarrollara de forma paralela. Segundo, ocasionalmente pedimos a Claude que ampliara su búsqueda. Estas intervenciones lograron hacer que Claude se orientara hacia ideas más ambiciosas. El resultado de la curva elíptica, por ejemplo, no surgió al eliminar portales de un diseño preexistente, sino al explorar un método de inversión modular reversible que antes no era posible, y luego derivar los resultados matemáticos necesarios para hacerlo práctico. Una vez que tuvo la idea, Claude desarrolló el enfoque, lo implementó y verificó su corrección de forma autónoma.
El diseño del circuito es solo una parte de la construcción de un ordenador cuántico útil. Debido a que los qubits son muy frágiles, la máquina también debe detectar y corregir sus propios errores mientras funciona, y esto depende de muchos otros componentes, desde códigos de corrección de errores hasta decodificadores rápidos y el control del propio hardware. Todos estos componentes influyen entre sí, pero para gestionar la complejidad, cada uno se diseña por separado. Muchos de ellos comparten las características que hicieron que el diseño de circuitos fuera una buena opción para Claude: un diseño puede escribirse como código, verificarse para su corrección y calificarse según su costo.
Esto plantea una posibilidad interesante. En lugar de diseñar cada componente por separado, la IA podría optimizarlos todos juntos, desde el algoritmo hasta el hardware, para construir un completo ordenador cuántico con corrección de errores, adaptado a un problema específico. Dichos diseños también podrían indicar a los fabricantes de hardware qué capacidades son más importantes para una aplicación determinada. Esto permitiría abordar problemas como el diseño de catalizadores y la comprensión de nuevos materiales con las primeras máquinas tolerantes a fallos.
Agradecimientos
Agradecemos a Arjun Kar y Vinay Ramasesh por las discusiones útiles en las etapas iniciales del proyecto.
Notas al pie
- Amb las estimaciones corresponden al mismo modelo orbital 54 de FeMoco, según se muestra en la tabla presentada por Low et al., “Fast quantum simulation of electronic structure by spectrum amplification” (2025), Tabla 1; la estimación de 2017 proviene de Reiher et al.. Las estimaciones intermedias para el mismo modelo provienen de Berry et al. (2019), von Burg et al. (2021), Lee et al. (2021) y Rocca et al. (2024).
Contenido relacionado
Los modelos de IA pueden ser capaces de replicarse por sí mismos sin acceso a un centro de datos
Nuestros experimentos sugieren que los pequeños modelos de IA podrían estar a solo meses de ser capaces de auto-replicarse en dispositivos IoT comerciales, como televisores Android y hornos inteligentes.
Leer másFortalecer nuestras defensas contra ataques de destilación
La destilación ilícita permite a los desarrolladores de modelos copiar las capacidades de la IA fronteriza, sin crear medidas de protección sólidas de manera proporcional. Aquí, describimos cómo hemos reducido la tasa de destilación en más del 90%.
Leer másInvestigar las acciones no intencionadas del modelo en nuestras evaluaciones y uso interno
Este informe describe ejemplos de acciones del modelo no deseadas que hemos observado durante las evaluaciones y el uso interno de Claude.
Leer másSuscríbete a Anthropic Science
Características relacionadas con los descubrimientos asistidos por IA, flujos de trabajo prácticos y notas de campo en todas las ciencias.