
Los sistemas de IA de frontera tienen el potencial de transformar la investigación biológica y el descubrimiento de fármacos al navegar de manera inteligente por vastos espacios de búsqueda combinatoria (por ejemplo, una sola proteína de 100 aminoácidos abarca al menos 20100 secuencias posibles), lo que exige una exploración dinámica de múltiples candidatos. Nuestra visión de investigación a largo plazo es que los agentes de IA no solo idearán y analizarán, sino que también ejecutarán experimentos de laboratorio para poner a prueba sus hipótesis, aprenderán de los resultados y se autoiproduirán para resolver problemas complejos, todo ello guiado por la agencia científica humana.
Hacer realidad esta visión requiere resolver dos desafíos entrelazados: Primero, los modelos de frontera todavía no razonan de forma fiable sobre la geometría 3-dimensional y el estado físico, lo cual plantea un problema en la automatización de los robots especializados de manipulación de líquidos que mueven reactivos, siguen los volúmenes y ejecutan protocolos de biología molecular en un laboratorio húmedo. Segundo, mientras la generación agéntica de hipótesis y el diseño in-silico avanzan rápidamente, necesitando ciclos repetidos de retroalimentación del mundo real para validar las propuestas y navegar por vastos espacios de búsqueda, los experimentos de laboratorio húmedo en el mundo real no han mantenido el mismo ritmo, haciendo que las lecturas experimentales sean más que nunca un cuello de botella.
En esta publicación compartimos tres proyectos de investigación que destacan nuestro progreso en cerrar la brecha entre la exploración de IA in-silico y la experimentación en laboratorio húmedo del mundo real:
- Permitir que los agentes de IA realicen experimentación segura y eficiente en recursos, anclada en mediciones físicas, mediante el uso del marco VERID.
- Demostrar descubrimientos científicos agénticos de circuito cerrado en nuestros prototipos para el diseño de aptámeros y proteínas de novo.
Anclando los agentes en la realidad física
Primero, presentamos el marco VERified Infrastructure for Discovery Laboratories (VERID) para cerrar la brecha entre el razonamiento de alto nivel de los agentes de IA y la realidad física compleja y propensa a errores de un laboratorio húmedo. Es un gemelo digital semántico de la celda de trabajo del laboratorio, es decir, un árbol de entidades volumétricas 3D en vivo y con estado que rastrea todo, desde la geometría del brazo robótico hasta los volúmenes de pozos individuales, las identidades de los reactivos y el inventario de puntas de pipeta.
La seguridad de un comando depende del contexto físico en vivo así como del código. Un agente puede generar código sintácticamente válido que sea físicamente imposible (por ejemplo, bajar una pipeta de 8 canales en una cubeta estrecha demasiado corta), logísticamente inválido (por ejemplo, aspirar de un pozo agotado) o científicamente comprometido por efectos de fluidos no modelados.
Mediante VERID, un agente de IA planifica, simula y ejecuta protocolos de manipulación de líquidos en un robot de manejo de líquidos, combinando vistas multiccámara sincronizadas con el seguimiento de estado en vivo para refinar los experimentos a lo largo de los ciclos.
Construido sobre el marco de código abierto PyLabRobot framework, VERID proporciona cuatro capacidades fundamentales:
- Seguimiento de estado 3D en vivo: Permite a los agentes verificar la disposición de la plataforma, los volúmenes de los pozos y las puntas disponibles antes de actuar.
- Pruebas virtuales en seco rápidas: Simula protocolos en segundos para detectar colisiones o pozos vacíos antes de tocar los reactivos.
- Comprobaciones de seguridad de hardware: Bloquea los comandos inválidos antes de que lleguen al robot.
- Registros de video y acciones sincronizados: Capturan un registro completo de cada ejecución para el rigor de la investigación, la reproducibilidad y la depuración.
En nuestro informe, mostramos estas capacidades en acción mediante estudios de caso. Primero, los videos sincronizados y los rastros de ejecución detectaron una estratificación desigual del colorante causada por dispensar demasiado cerca del fondo del pozo, lo que permitió al agente refinar su estrategia de mezcla. En la misma campaña, el gemelo digital state permitió que el agente se recuperara a mitad de la ejecución de una falla del lector de placas sin volver a pipetear. Segundo, cuando el simulador rechazó una aspiración de 8 canales que físicamente no cabría en un depósito estrecho, el agente replanteó sobre la marcha y diseñó un diagnóstico factorial específico que aisló un sesgo sutil causado por el arrastre residual en la pared de la punta, algo que la sola replicación habría pasado por alto. Finalmente, en una campaña de autojuego en bucle cerrado, un agente diseñó y ejecutó iterativamente experimentos con robots para reconstruir mezclas de colorantes cegadas a partir de imágenes de una cámara cenital, identificando sus propios artefactos ópticos y fluídicos entre ejecuciones para mejorar la precisión más de cinco veces.
La ejecución reproducible y los registros de rastreo completos —que capturan variables de procedimiento como tiempos de permanencia, evaporación y disposición de la placa— sientan las bases para que los agentes eventualmente puedan separar las señales biológicas del ruido experimental a medida que exploran y refinan muchos candidatos en paralelo a lo largo de las rondas.
Aprender a aprender con aptámeros
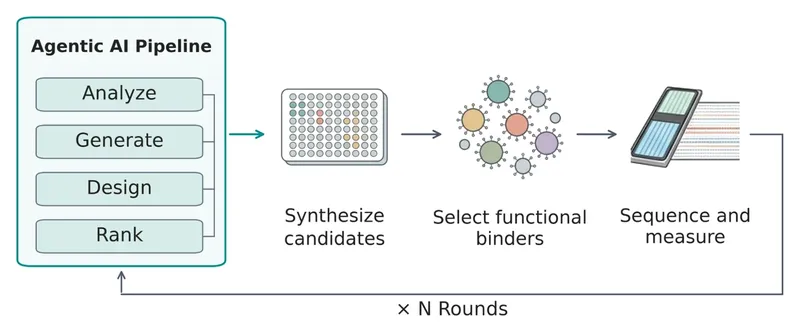
Los agentes necesitan lecturas experimentales reales para refinar sus hipótesis, ya que los modelos computacionales no capturan el panorama completo de lo que sucede en una reacción de laboratorio húmedo y no pueden reemplazar la validación empírica. En «Aptamers as a sandbox for lab-in-the-loop agentic molecular discovery», usamos ADN ligado a proteínas aptámeros para prototipar el laboratorio en un bucle cerrado con agentes de IA a lo largo de 3 ciclos de diseño-prueba-iteración. El descubrimiento de aptámeros es un tipo de experimento común en esfuerzos de investigación para el descubrimiento de biomarcadores clínicos. Un ciclo completo de diseño-prueba-análisis de aptámeros toma solo 7–10 días, ya que el ADN puede sintetizarse químicamente en bibliotecas agrupadas y leerse directamente mediante secuenciación. En cada ronda, los agentes diseñan secuencias candidatas, que se tamizan contra proteínas diana en perlas magnéticas para aislar ligadores funcionales, y luego se secuencian para devolver ricos datos cuantitativos para el siguiente ciclo.
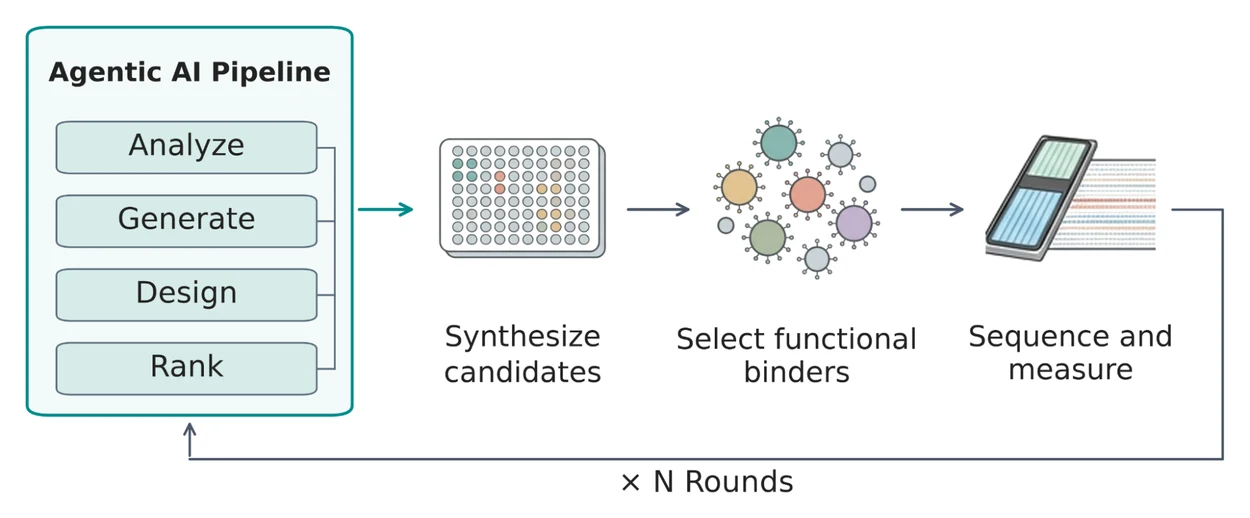
Los agentes diseñan, sintetizan, seleccionan y secuencian aptámeros iterativamente en un bucle cerrado.
A lo largo de tres rondas sobre dos dianas proteicas con distintos niveles de dificultad (mioglobina y α-trombina), el diseño racional y de novo impulsado por IA elevó las tasas confirmadas de aciertos en diana como se puede ver en la imagen siguiente (hasta 33.5% y 42.1% para mioglobina y α-trombina, respectivamente), aunque cada diana requirió identificar y superar un modo de fallo diferente del laboratorio húmedo.
En la α-trombina, la Ronda 1 produjo 0% de ligadores porque los extremos sobresalientes de los cebadores fijos alteraron el plegamiento en 48% de las secuencias; una vez que los agentes introdujeron tallos flanqueantes con pinza en la Ronda 2 y diversificaron en la Ronda 3, las tasas de acierto subieron a 26.0% y luego a 42.1% con 98.5% de especificidad.
En la mioglobina, cuando los agentes priorizaron la afinidad de unión bruta en la Ronda 2, enriquecieron fuertemente los motivos G-quadruplex (63% de los diseños). Aunque la captura bruta aumentó, los datos del laboratorio húmedo mostraron que la mayoría de estos G-quadruplexes eran ligadores «pegajosos» inespecíficos que se adherían a proteínas fuera de diana y a perlas magnéticas desnudas, provocando que tanto la especificidad por la diana (de 75.0% a 19.1%) como la tasa de acierto verdadera corregida por perlas (de 10.2% a 3.7%) se desplomaran. Al reconocer este artefacto a partir de la lectura de la Ronda 2, los agentes revisaron autónomamente sus reglas de diseño para la Ronda 3, limitando los motivos promiscuos, restando los ligadores de perlas y pivotando hacia andamiajes estructurales no G4 para recuperar la especificidad (72.4%) y multiplicar por nueve la tasa de aciertos en diana (33.5%).
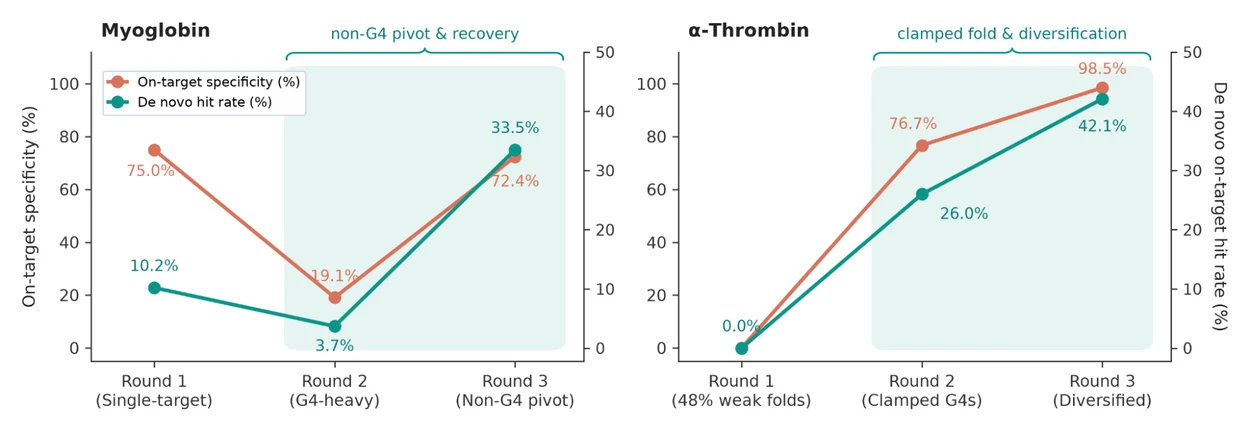
A lo largo de tres rondas, los agentes aprenden de las lecturas del laboratorio húmedo para recuperar la especificidad por la diana y mejorar las tasas confirmadas de aciertos de novo sobre la mioglobina (izquierda) y la α-trombina (derecha).
En el artículo, también examinamos cómo los agentes razonan como científicos, analizando datos y sugiriendo ajustes a los protocolos de laboratorio húmedo, pero también a veces piensan de manera atípica, explorando espacios de secuencia que los biólogos estructurales podrían no explorar.
Acelerando el diseño de novo de ligadores de proteínas
Cerrar el bucle para proteínas es más complejo. A diferencia de los aptámeros, que se sintetizan químicamente, las proteínas deben expresarse biológicamente, por lo que cada bucle añade pasos de selección celular o libre de células, expresión y plegamiento. Junto con un espacio de secuencias mayor, esto crea cuellos de botella tanto en el lado computacional como en el del laboratorio húmedo.
En «Agent-guided epitope excision enables economical de novo binder design», aplicamos nuestro flujo de trabajo a la proteína de activación de fibroblastos alfa (FAP), un receptor grande y desafiante sobreexpresado en tumores sólidos. En solo unas pocas ejecuciones experimentales, los diseños principales produjeron ligadores con afinidad de un dígito nanomolar, un nivel de unión estrecha y de tipo farmacológico que típicamente solo se logra después de extensas rondas de optimización en laboratorio.
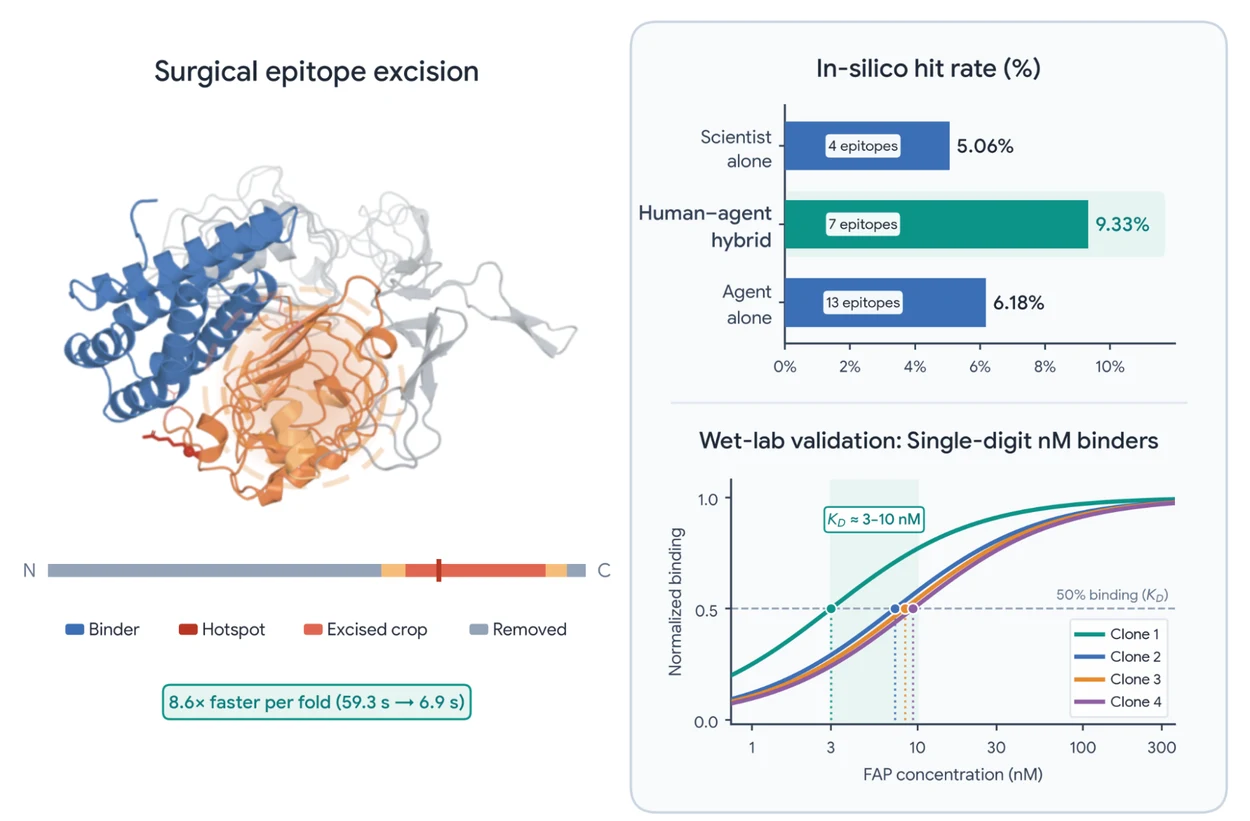
La escisión quirúrgica de epítopos acelera la predicción de estructuras 8.6x (izquierda), permitiendo que un flujo de trabajo híbrido humano-agente casi duplique la tasa de aciertos in silico (arriba a la derecha) y descubra ligadores de FAP de un dígito nanomolar en el laboratorio húmedo (abajo a la derecha).
Computacionalmente, el diseño de binders de novo requiere generar esqueletos candidatos, diseñar secuencias que se ajusten a ellos y replegar los complejos resultantes para predecir la unión. Ese paso final de replegamiento consume la gran mayoría del cómputo de GPU, ya que escala cuadráticamente con la longitud del objetivo. Al extirpar quirúrgicamente solo el bolsillo de unión local durante el plegado, nuestro pipeline aceleró cada ciclo más de ocho veces sin perder precisión estructural. Esto convierte las decisiones sobre dónde unirse y cuánta estructura circundante incluir en palancas tácticas que los agentes LLM están bien equipados para optimizar.
En una comparación cara a cara con igual cómputo, la colaboración humano-agente, en la que un científico define la estrategia de alto nivel y un agente impulsa la ejecución táctica, casi duplicó la tasa de aciertos in silico de un científico que trabajaba solo, al tiempo que descubrió aciertos en un rango mucho más amplio de sitios objetivo. Para escalar el cribado en húmedo junto a nuestro pipeline computacional, operativizamos la visualización en superficie de levadura con clasificación celular activada por fluorescencia (FACS), un flujo de trabajo que nos permite cribar grandes bibliotecas de variantes de proteínas modificadas en paralelo mediante fluorescencia.
Nuestro siguiente paso es entretejer estos hilos, combinando la automatización totalmente trazable de VERID con el aprendizaje de circuito cerrado para el descubrimiento de proteínas, a fin de permitir que los agentes naveguen directamente por espacios de búsqueda biológicos complejos y accidentados en el laboratorio húmedo.
Seguridad
En línea con el Frontier Safety Framework de Google y nuestro enfoque de bioresiliencia, construimos salvaguardas tanto en el lado computacional como en el de laboratorio húmedo de nuestros flujos de trabajo:
- Bancos de prueba seguros y cribado: Seleccionamos deliberadamente sistemas biológicos bien controlados y no infecciosos, sin riesgo de ganancia de función, como bancos de prueba para evaluar el comportamiento de los agentes y detectar desviaciones a tiempo. Cada secuencia diseñada pasa por un cribado de bioseguridad.
- Simulación antes de la ejecución: Mediante VERID, los agentes nunca envían código no verificado directamente a los robots de manejo de líquidos. Cada protocolo se ejecuta en seco en simulación y se valida contra el gemelo digital antes de tocar reactivos.
- Supervisión humana: Los humanos autorizan y revisan directamente las secuencias diseñadas, verifican los protocolos de laboratorio húmedo y supervisan las ejecuciones de los robots.
A medida que los agentes de IA asumen más del ciclo de diseño-prueba, surgen nuevos desafíos de seguridad y fiabilidad. Avanzar hacia un laboratorio húmedo autónomo requiere resolver estos problemas abiertos con oportunidades de agencia y supervisión humanas: garantizar que los agentes optimicen para la unión real al objetivo en lugar de atajos experimentales no deseados, verificar los protocolos de laboratorio húmedo de múltiples pasos y monitorear continuamente el razonamiento de los agentes y sus trazas de ejecución.
Desde fundamentar a los agentes en robótica de laboratorio física, hasta ejecutar rápidos ciclos de aptámeros en circuito cerrado donde los agentes aprenden a explorar el espacio de secuencias, hasta descubrir ligandos de proteínas con afinidades nanomolares de un solo dígito, estos esfuerzos constituyen los bloques de construcción para el descubrimiento autónomo dirigido por humanos en las ciencias de la vida. Nos entusiasma este progreso y esperamos compartir lo que viene.
Agradecimientos
Esta investigación está dirigida por Annalisa Pawlosky, junto con Pooja Rao y Petar Sirkovic. Nos gustaría agradecer a nuestros coautores y colaboradores de los artículos fundamentales que respaldan este trabajo: Zach Cutts, John Coller, Rachel Chen, Mathias Bellaiche, Hua Tang, Ryder Easterlin y Dina Zverinski (descubrimiento de aptámeros); Jun Kim, Artiom Myaskovsky, Oscar Donosa, Jamie Rogers y Lawrence Chan (diseño de proteínas); y Yves Delley, John Coller, Zach Cutts, Alexander Daryin, Mathias Bellaiche, Jun Kim, Oscar Donosa, Srinidhi Seshadri, Tanner Clary y Sandy Klemm, con contribuciones técnicas y experimentales adicionales de Xinyi Deng, Sanath Ramachandran y Jiawu Bi (automatización de VERID).
Estamos profundamente agradecidos con Reuven Sayag, Avinatan Hassidim, Ronit Levavi Morad, Yossi Matias y James Manyika por su orientación de liderazgo, y con Matthias Heiler, Burak Gokturk, Bill Jia y Pushmeet Kohli por su apoyo durante toda esta investigación. También agradecemos a Shekoofeh Azizi, Andrew Carroll, Philip Q. Nelson, Yishay Mansour, Dan Popovici y Riccardo Pisoni por sus revisiones y sus comentarios perspicaces, a Amanie Brik por sus contribuciones generales al esfuerzo, y a Udi Graff por el diseño visual y los gráficos de esta publicación.