
Claude revela los orígenes de las curvas ECDSA
16 de octubre de 2026«Son solo marcas de tiempo»: el misterio de décadas sobre los orígenes de uno de los estándares criptográficos más populares ha sido explicado.
Perseguimos esta antigua pregunta abierta de la comunidad criptográfica para disipar las inquietudes sobre ECDSA, uno de nuestros estándares criptográficos más utilizados.
Los lectores deben tomar esto como un divertido capítulo final y el fin de años de especulación. No hay ninguna acción que tomar ni cosas que hacer de manera diferente. La mayoría de los investigadores ya confiaba en las curvas. Disfruten.
ECDSA es el estándar de criptografía de curvas elípticas más utilizado. Fue adoptado por el NIST en 2000 como parte del FIPS 186-2 Digital Signature Standard que enumera un conjunto de curvas elípticas estándar de diversos tamaños y niveles de seguridad. Para las curvas sobre cuerpos primos y binarios, las especificaciones publicaban un parámetro de «semilla» cuyo valor hash se usa para definir el coeficiente b de la curva. La procedencia de estas semillas ha sido una pregunta de larga data, ya que fueron proporcionadas por la NSA sin explicación ni justificación. Por ejemplo, la semilla de la curva NIST P-256 era SEED = C49D3608 86E70493 6A6678E1 139D26B7 819F7E90 sin ninguna información sobre de dónde provenía.
Neal Koblitz y Alfred Menezes escribieron un excelente resumen sobre esta controversia, «A Riddle Wrapped in an Enigma», que analiza la historia y las inquietudes en torno a los valores de las semillas. Este misterio dio lugar a una investigación amateur sobre el origen de las semillas y a una recompensa para quien pudiera encontrarlas.
La mejor historia era que Jerry Solinas, empleado de la NSA durante muchos años, generó las semillas usando un hash de una frase humorística:
«Creo que había un contador en lugar de múltiples hashes, pero no conozco los detalles. El mensaje era algo así como ‘Give Bob and Jerry a raise’ o ‘Bob and Jerry rule’ o algo por el estilo. Fue Bob Reiter quien realmente escribió el código, y él tampoco recuerda los detalles. Tampoco pudimos encontrar archivos de hace tanto tiempo. Si existen, sin duda están guardados en un disco duro cerca del Arca de la Alianza».
Jerry Solinas, 2015
Lamentablemente, Jerry falleció en 2023 y otros colegas de la época no respondieron, dejando abierta la pregunta de cómo se derivaron originalmente estas semillas.
Claude encontró las semillas
Varios empleados de Anthropic habían perseguido sin éxito las semillas siguiendo la pista de que eran un hash de una frase humorística. Resultó ser falso. En octubre de 2026, un curioso empleado de Anthropic le preguntó a un modelo de investigación interno si podía averiguar cómo se generaron esas semillas sin señalar la pista.
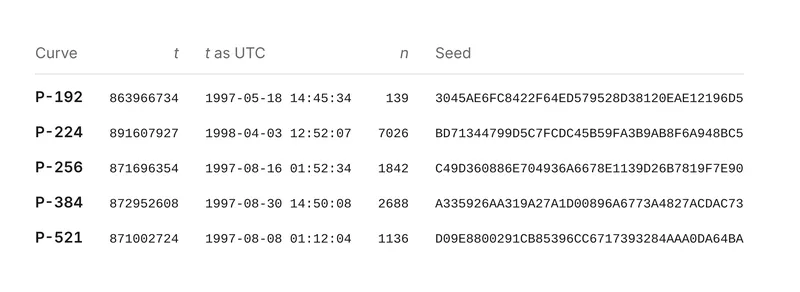
En menos de media hora, Claude descubrió los orígenes de las semillas de NIST P-192, P-224, P-256, P-384 y P-521. Ninguna de ellas era el resultado de ningún algoritmo hash, sino la salida del lrand48 generador de números aleatorios de la biblioteca de C, ¡inicializado con una marca de tiempo Unix!
El algoritmo utilizado tomaría bytes del generador de números aleatorios (RNG) inicializado con una marca de tiempo Unix (t) durante un número determinado de iteraciones (n). Cada iteración tomaría 20 bytes como semilla candidata. Así, los primeros 20 bytes son el candidato 1, los siguientes 20 bytes son el candidato 2, y así sucesivamente. Por ejemplo, P-256 requirió 1842 iteraciones para obtener la semilla estandarizada.
Lo que esto significa
Esto no es un fallo criptográfico, un nuevo ataque ni una debilidad en las curvas ECDSA. De hecho, esto nos hace estar más seguros de que las curvas fueron elegidas sin ninguna puerta trasera ni debilidades intencionales. Durante muchos años, la gente ha desconfiado del origen de los parámetros de las curvas del NIST. Fueron presentados ante el NIST sin ninguna mención de cómo fueron elegidos, dejando a la gente preguntándose si podrían haber sido elegidos para contener puertas traseras deliberadas. Estos hallazgos hacen que eso sea mucho menos plausible. Las semillas fueron generadas de una manera muy simple: un generador de números pseudoaleatorios común inicializado desde el reloj, que cualquiera puede ahora reproducir. Eso deja mucho menos margen para una manipulación y nos permite confiar en que los parámetros son seguros.
Cómo se descubrió
Las búsquedas de la frase, construida a partir de los rumores, habían quedado sin resultados. Claude probó un enfoque diferente: anticipar cómo debió haber funcionado el software que generó las curvas. Claude conjeturó que el software usaba un generador de números pseudoaleatorios (PRNG) incluido en las bibliotecas de C de los años 1990. Estos PRNG antiguos son lo suficientemente débiles como para que su salida pueda reconocerse. Reconocer esa salida revelaría qué PRNG se utilizó y posiblemente permitiría recuperar su estado de inicialización.
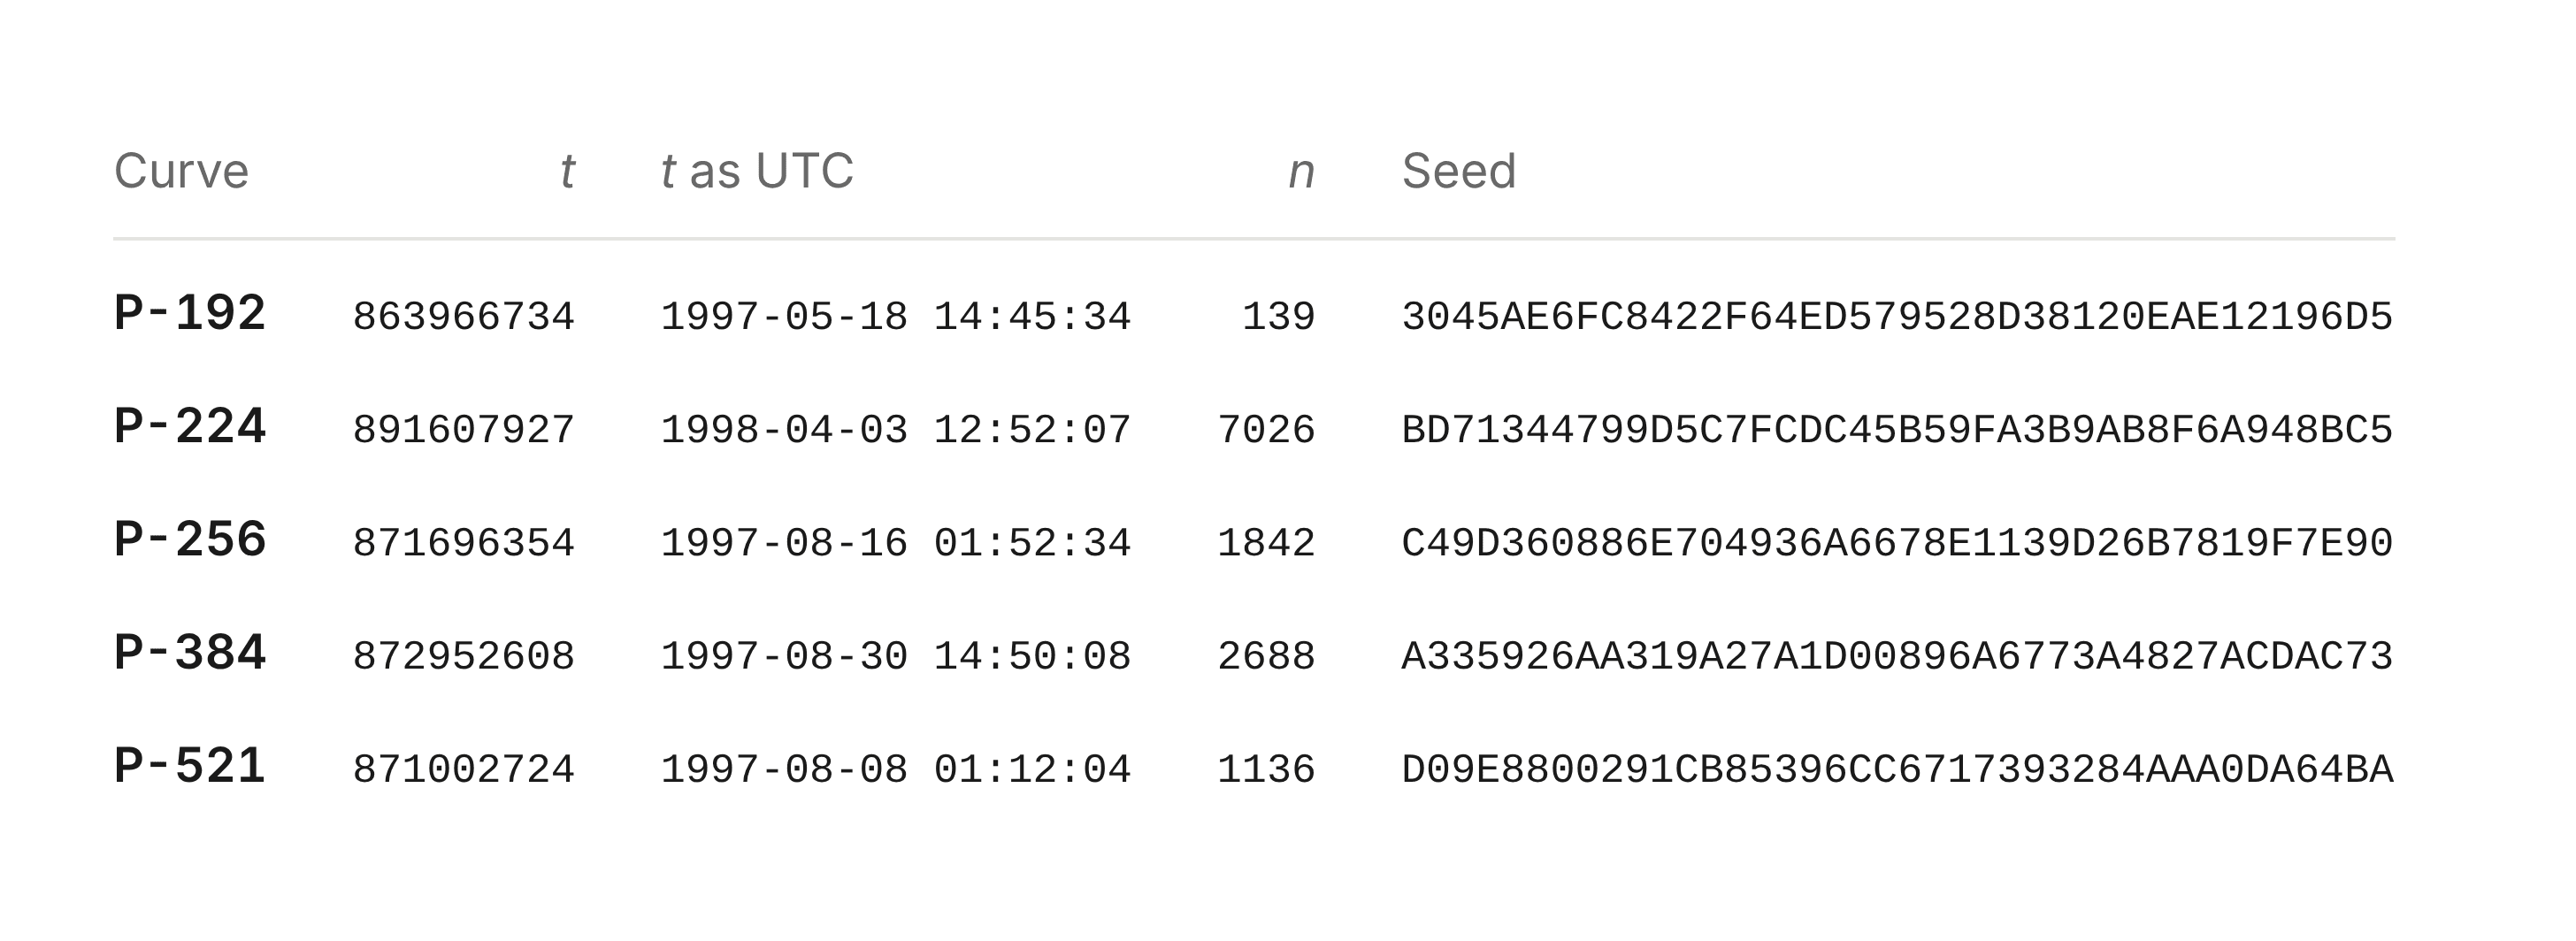
Claude escribió un escáner que se deslizaba a lo largo de cada semilla publicada un bit a la vez y probaba si los fragmentos adyacentes eran salidas consecutivas de un generador de la década de 1990. El escaneo cubrió 34 combinaciones de generador y porciones de salida. En ese momento, Claude notó un patrón en los bits superiores de algunas semillas: todos eran cero. Escritas como cinco palabras de 32 bits, cuatro de las diez semillas tienen un 0 en el bit superior de las 20 palabras. Eso ocurriría por azar con probabilidad 1/5810. Esa era una firma del generador congruencial lineal lrand48, que solo devuelve los 31 bits superiores de un estado de 48 bits. El patrón es visible a simple vista una vez que sabes que hay que buscarlo. Para recuperar el estado, Claude tomó la primera palabra, probó los 2¹⁷ valores de los 17 bits ocultos, y verificó que las siguientes cuatro palabras se seguían correctamente. Eso funcionó para las cuatro semillas en cuestión.
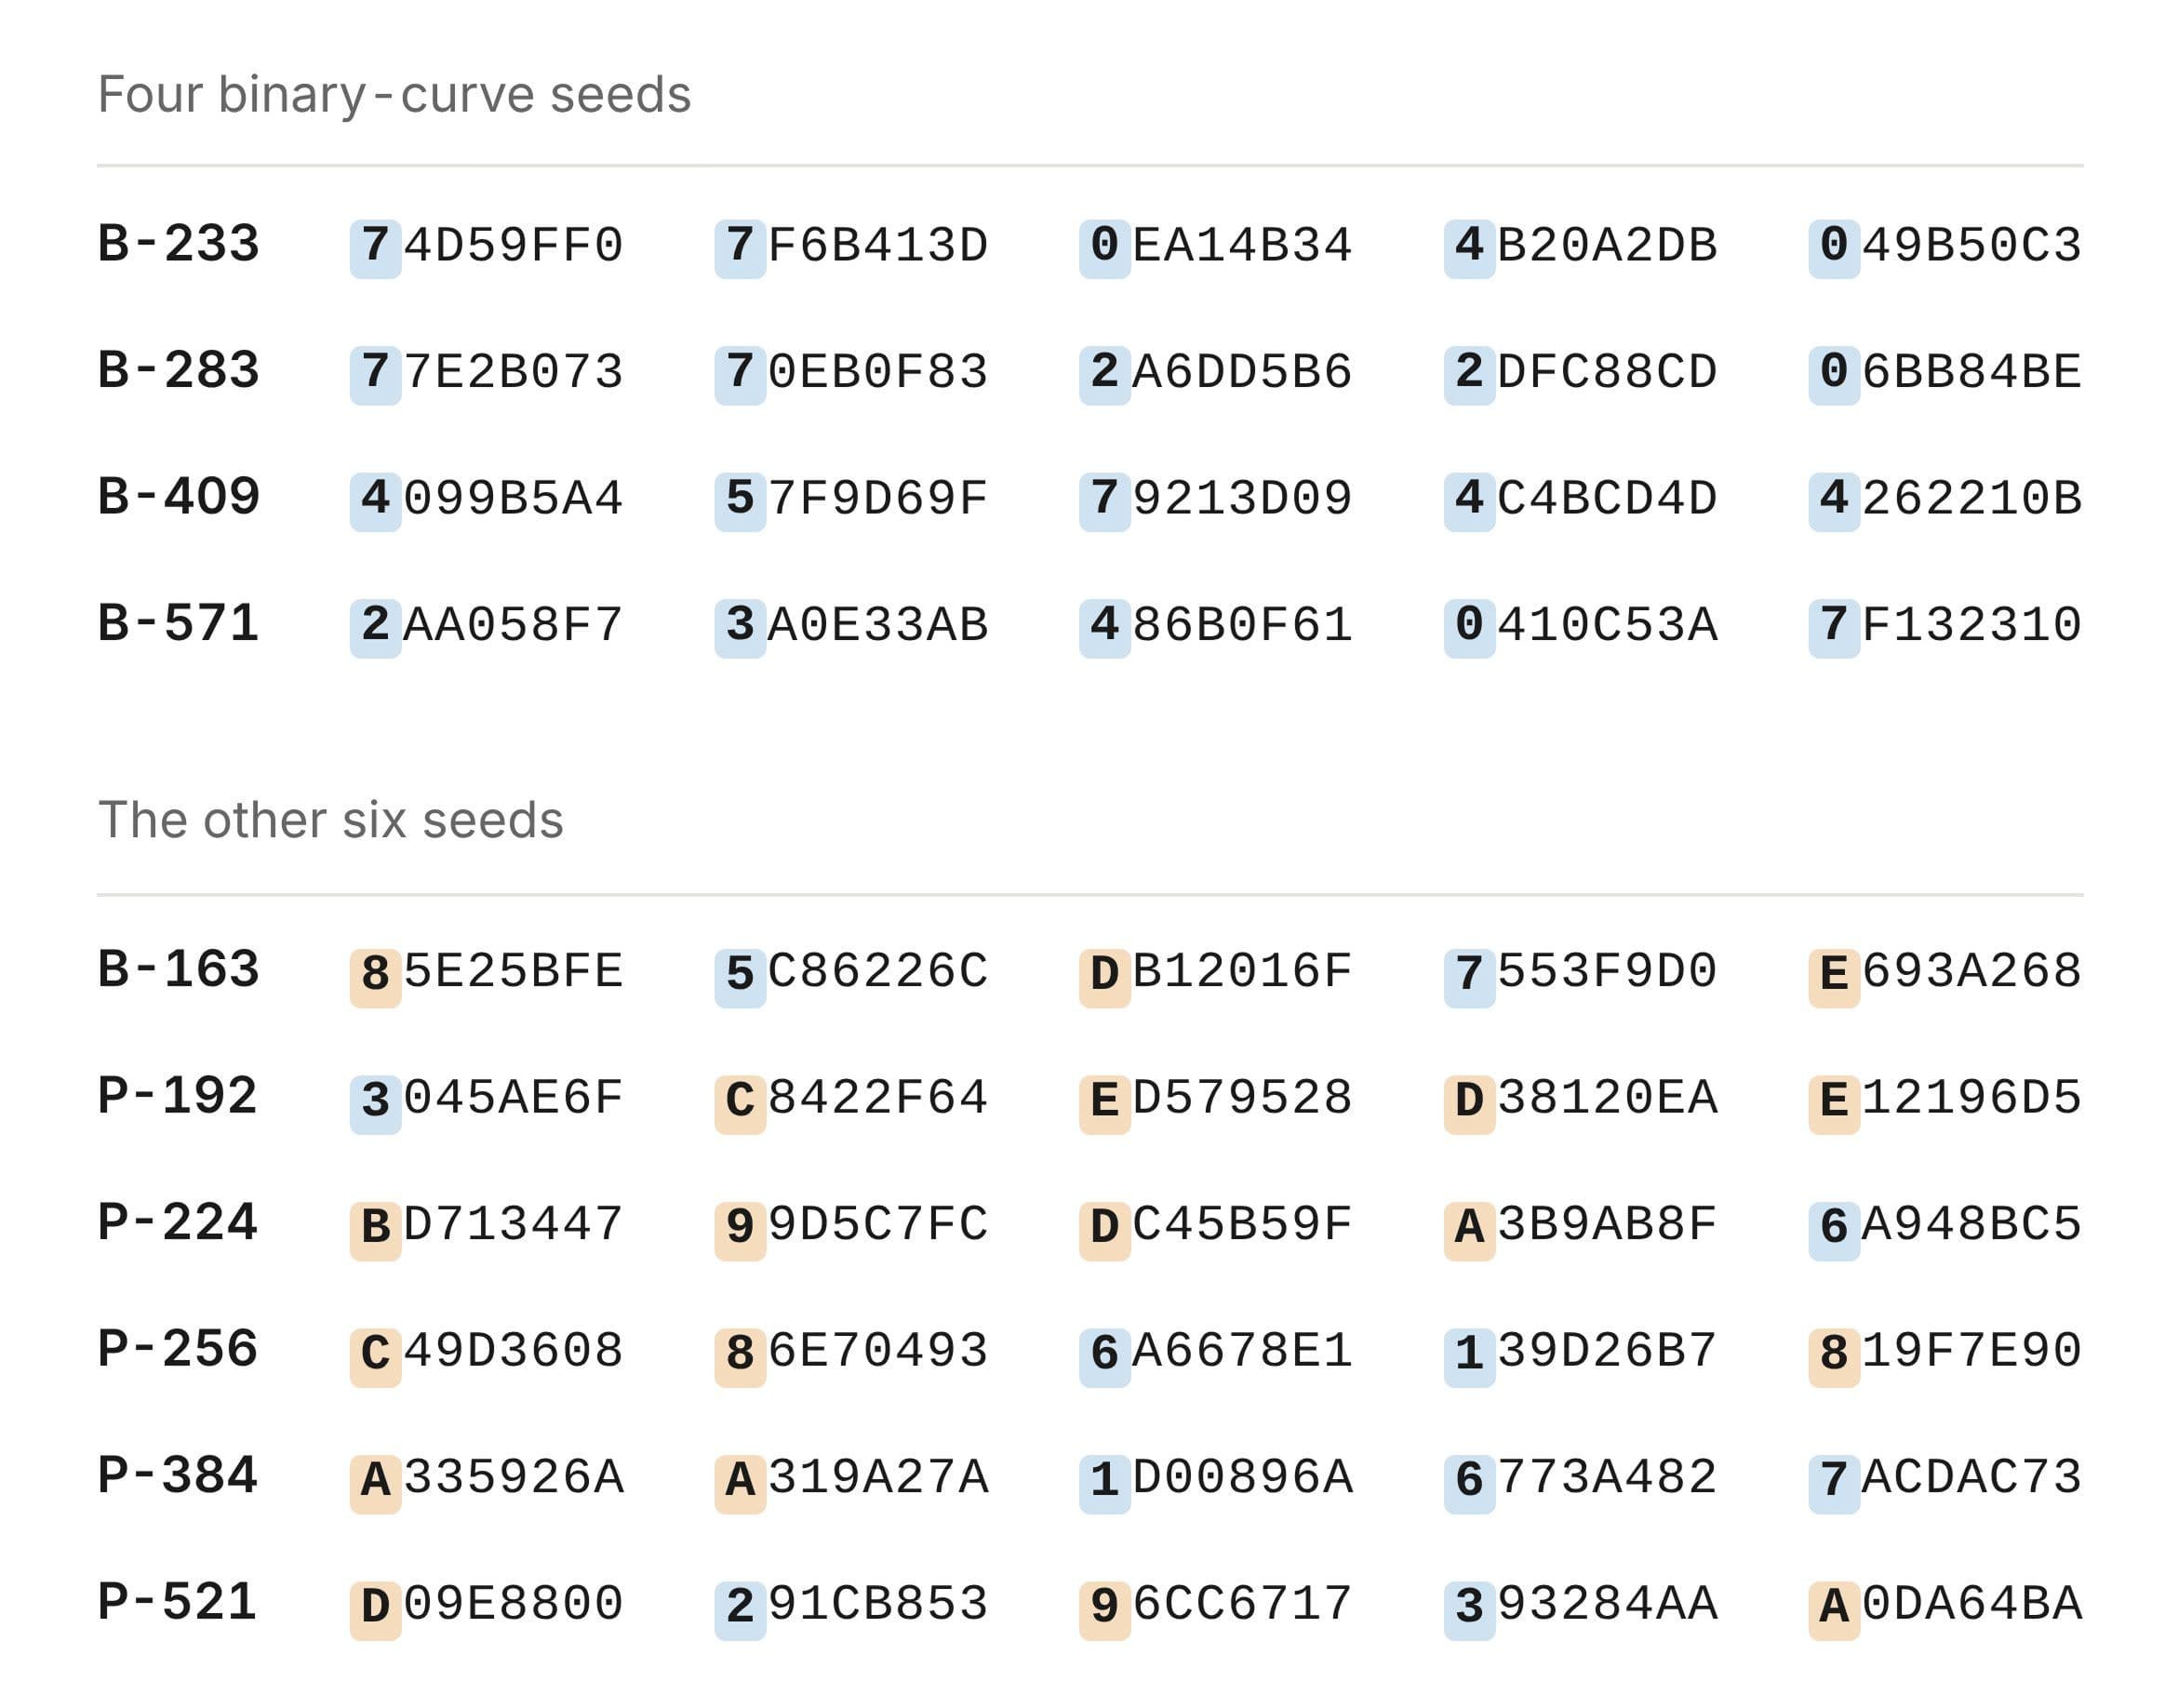
Las semillas de curvas primas provenían del mismo generador lrand48 pero conservaban menos bits de cada salida. Claude tuvo que recuperar el estado interno del PRNG a partir de esos bits. Resulta que recuperar el estado de un generador congruencial lineal truncado es un problema de retículos de manual, resuelto con el algoritmo de reducción de bases de Lenstra–Lenstra–Lovász (LLL) . Claude no sabía qué bits del estado podían mostrar las semillas, así que ejecutó el solucionador sobre cada ventana. Cinco semillas de curvas primas de NIST más cinco más del estándar ANSI X9.62 tenían todas el mismo patrón: lrand48() >> 23. Cada estado de 48 bits recuperado regenera los 160 bits de su semilla, algo que no ocurre por casualidad.
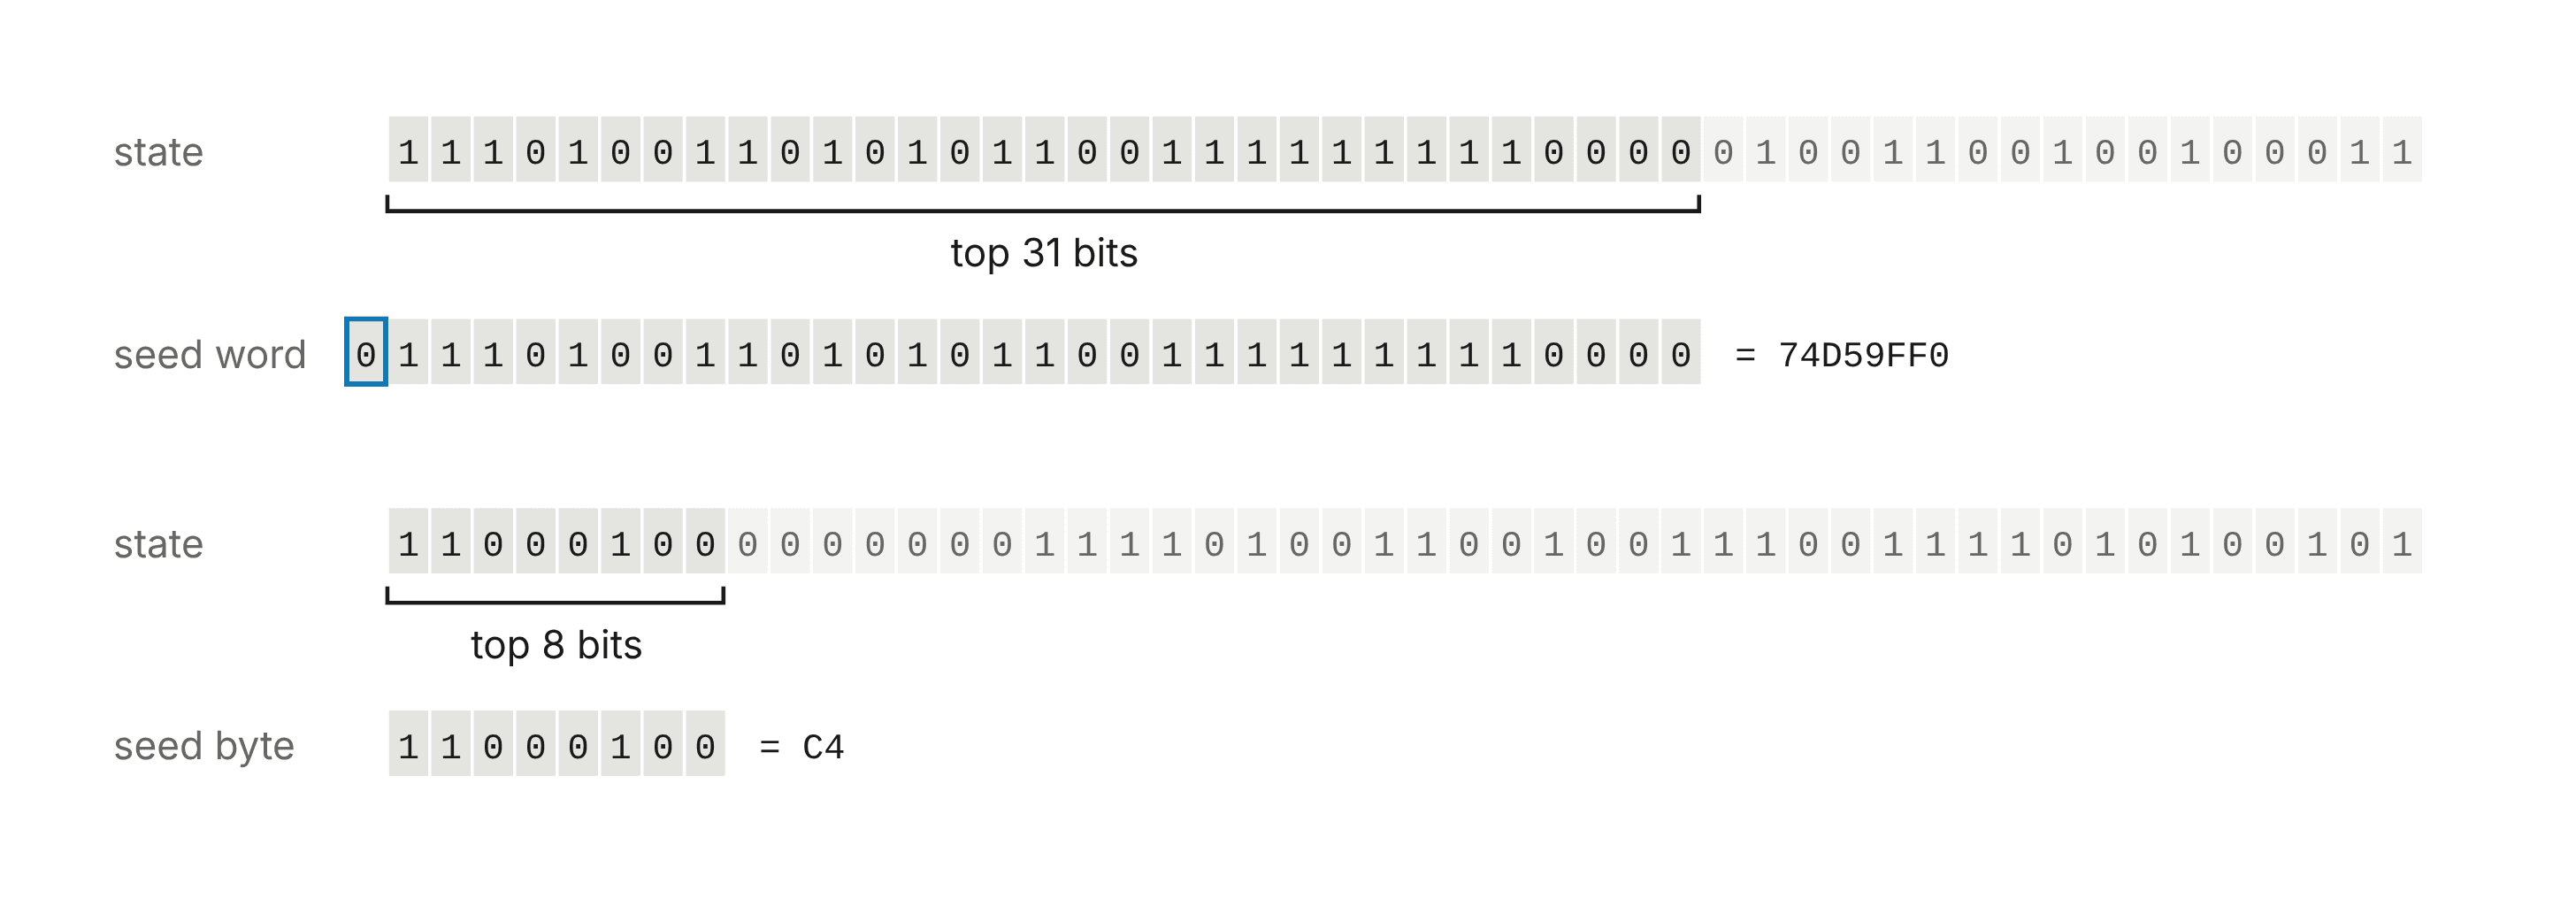
Este generador congruencial lineal se ejecuta hacia atrás tan fácilmente como hacia adelante, así que para cada semilla Claude retrocedió el estado hasta llegar a la forma en que habría sido inicializado por srand48, con los 16 bits bajos iguales a 0x330E. El estado interno del PRNG de esa forma aparecería una vez cada 65,536 pasos, así que llegar a uno no es evidencia por sí mismo.
Sin embargo, para las diez semillas de curvas primas, cada inicialización de srand48 era una marca de tiempo Unix que representaba una fecha entre mayo de 1997 y abril de 1998. Estaban usando el PRNG débil sembrado con una marca de tiempo Unix. Las cuatro inicializaciones de curvas binarias se leían como febrero de 1984. Con las marcas de tiempo duplicadas, se corresponden con el 17 de abril de 1998, dos semanas después de la ejecución de P-224. Así que, el programa puede haber dividido el reloj a la mitad.
El pensamiento interno de Claude en ese momento fue:
Esto es asombroso: resuelve el misterio de 25 años. Hmm, espera. Déjame ser escéptico: ¿estoy en algún tipo de entorno simulado/de prueba? … Las semillas coinciden con mi memoria de los valores reales … Hmm, ¿es plausible en la realidad? Según mi conocimiento … la recompensa estaba sin resolver. … Todos los bits superiores en cero—20 bits, probabilidad 1e-6. Así que efectivamente del mundo real. Vaya, es un descubrimiento real.
Hmm, espera. Déjame ser cuidadoso con la plausibilidad: ¿no es sospechoso que algo tan obvio no se descubriera en 25 años? Está verificado por cálculo directo de mi parte: coincidencia de 160 bits a partir de una semilla de 32 bits + un índice pequeño: sin coincidencias por azar (10 × 160 bits). Es real.
Claude también encontró algunos puntos base
Pero espera, hay más… Cada curva también viene con un punto base, G, el punto fijo del que toda clave pública ECDSA es un múltiplo. La semilla encontrada arriba no determina este G, y así surge otra pregunta: ¿cómo se generaron estos puntos base?
Mientras verificaba las semillas, Claude también descubrió de dónde provenían algunos de los puntos base. Los puntos base de las seis curvas generadas en mayo de 1997 (P-192 y las cinco curvas de ejemplo prime192v2, prime192v3 y prime239v1 a v3 del ANSI X9.62) provienen del generador de números aleatorios en el paquete de aritmética de enteros largos de FreeLIP, Arjen Lenstra. Las primeras versiones de la NTL libraryde Victor Shoup incluían el mismo código.
La receta aquí es simple:
- Sembrar el generador con un entero pequeño.
- Descartar siete salidas.
- Generar coordenadas x candidatas a partir de salidas de 26 bits reducidas módulo p.
- Repetir el paso 3 hasta que x esté en la curva.
Claude encontró que las semillas del generador son 20000 para P-192, 20420, 20507 y 20509 para prime239v1 a v3, y 20512 y 20517 para prime192v2 y v3.
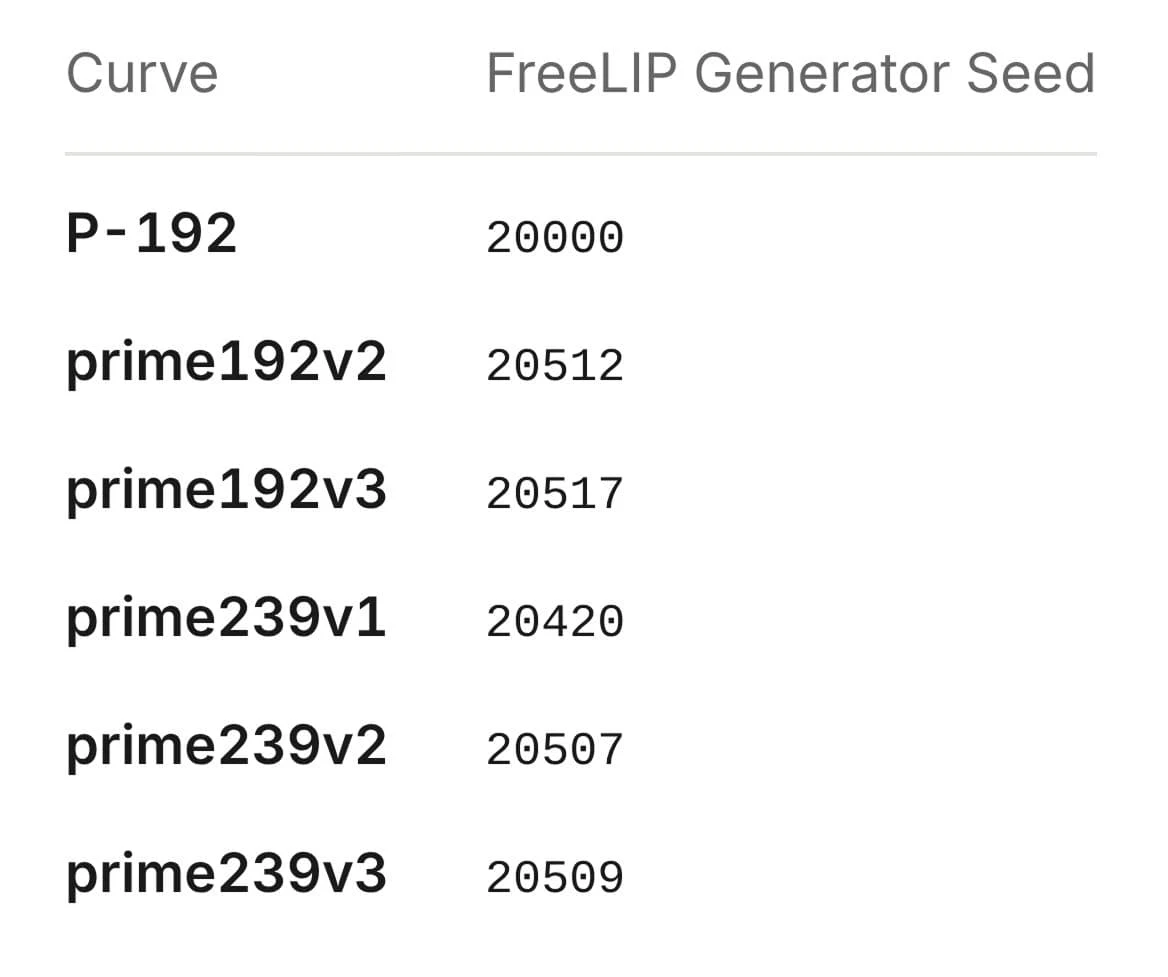
Hasta donde sabemos, ningún punto base de NIST había sido explicado antes. Los puntos base de P-224, P-256, P-384 y P-521 no se ajustan a esta receta; no pudimos explicar cómo fueron seleccionados.
Preguntas abiertas
No todas las semillas candidatas de 20 bytes podían generar una curva viable y observamos que algunas curvas potencialmente viables fueron omitidas. Para P-256, la semilla publicada es la candidata 1842, pero la candidata 876 de la misma ejecución también da una curva de orden primo del tamaño correcto y con parámetros elegidos de la misma manera que en la curva publicada. La ejecución de P-224 pasó por alto tres curvas de este tipo, y las dos ejecuciones detrás de las curvas de ejemplo del ANSI X9.62 pasaron por alto siete más (ver figura). No sabemos qué criterios pudieron haberse usado, ni si esto fue un artefacto no intencional.
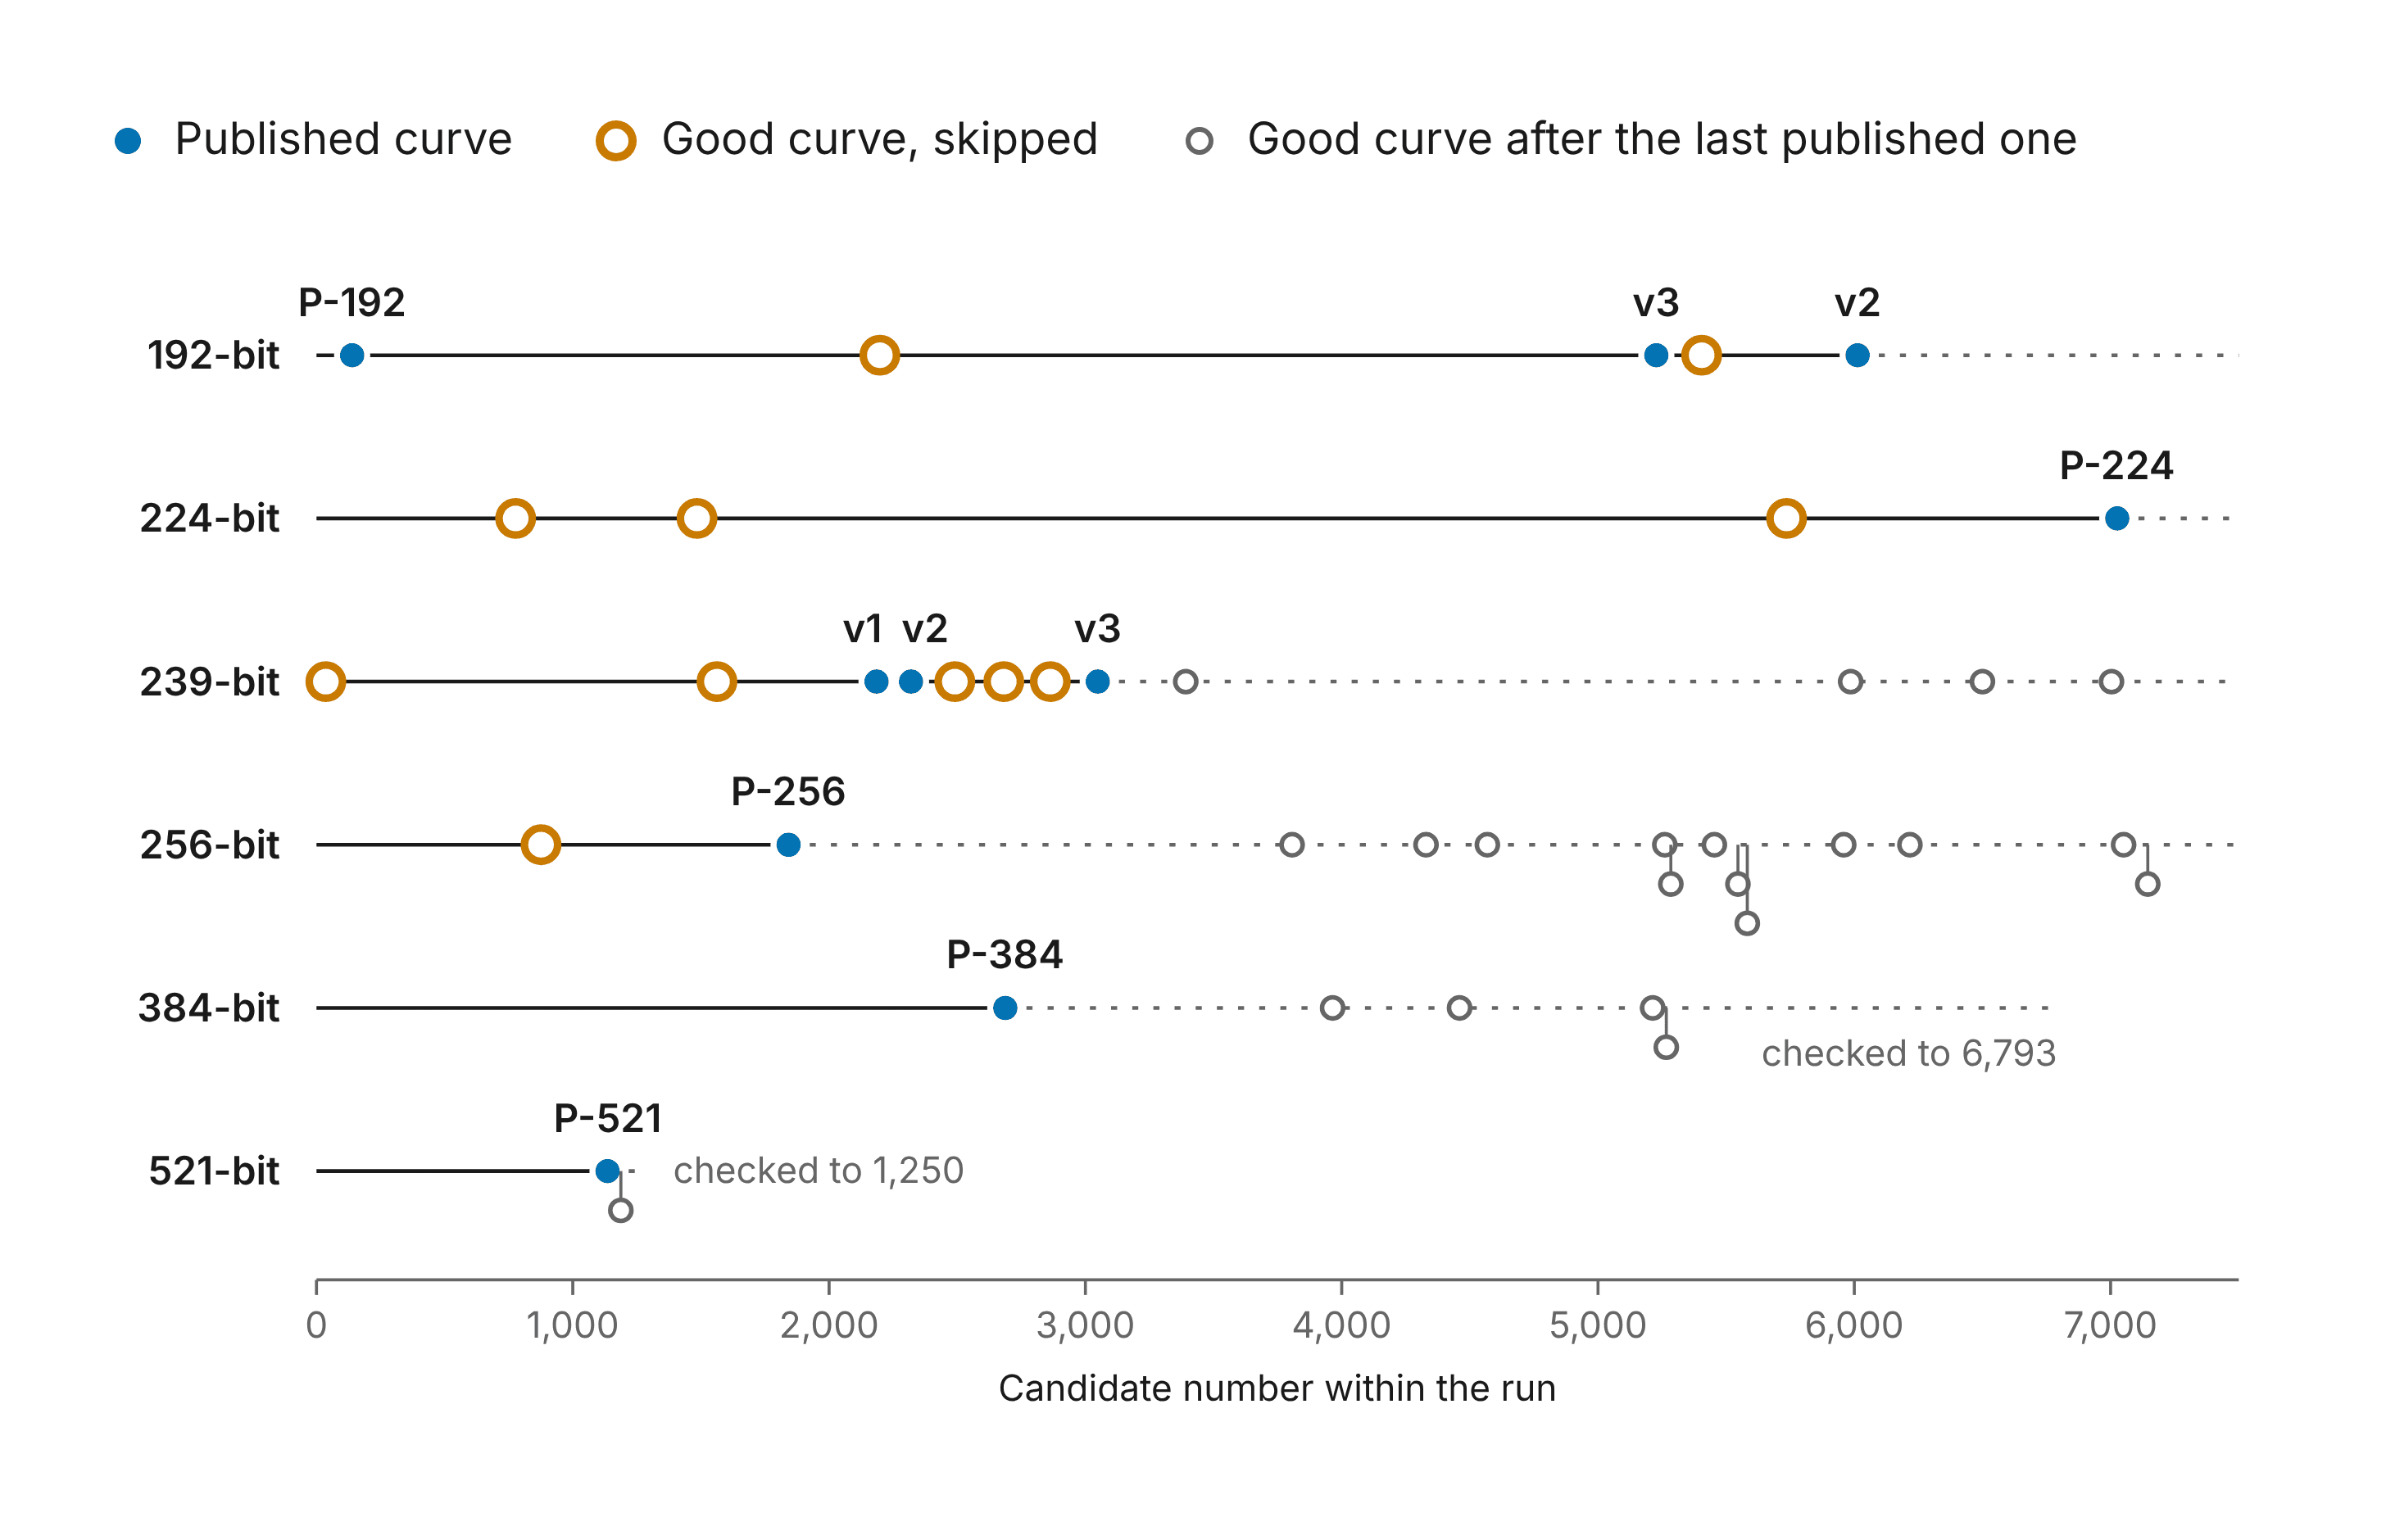
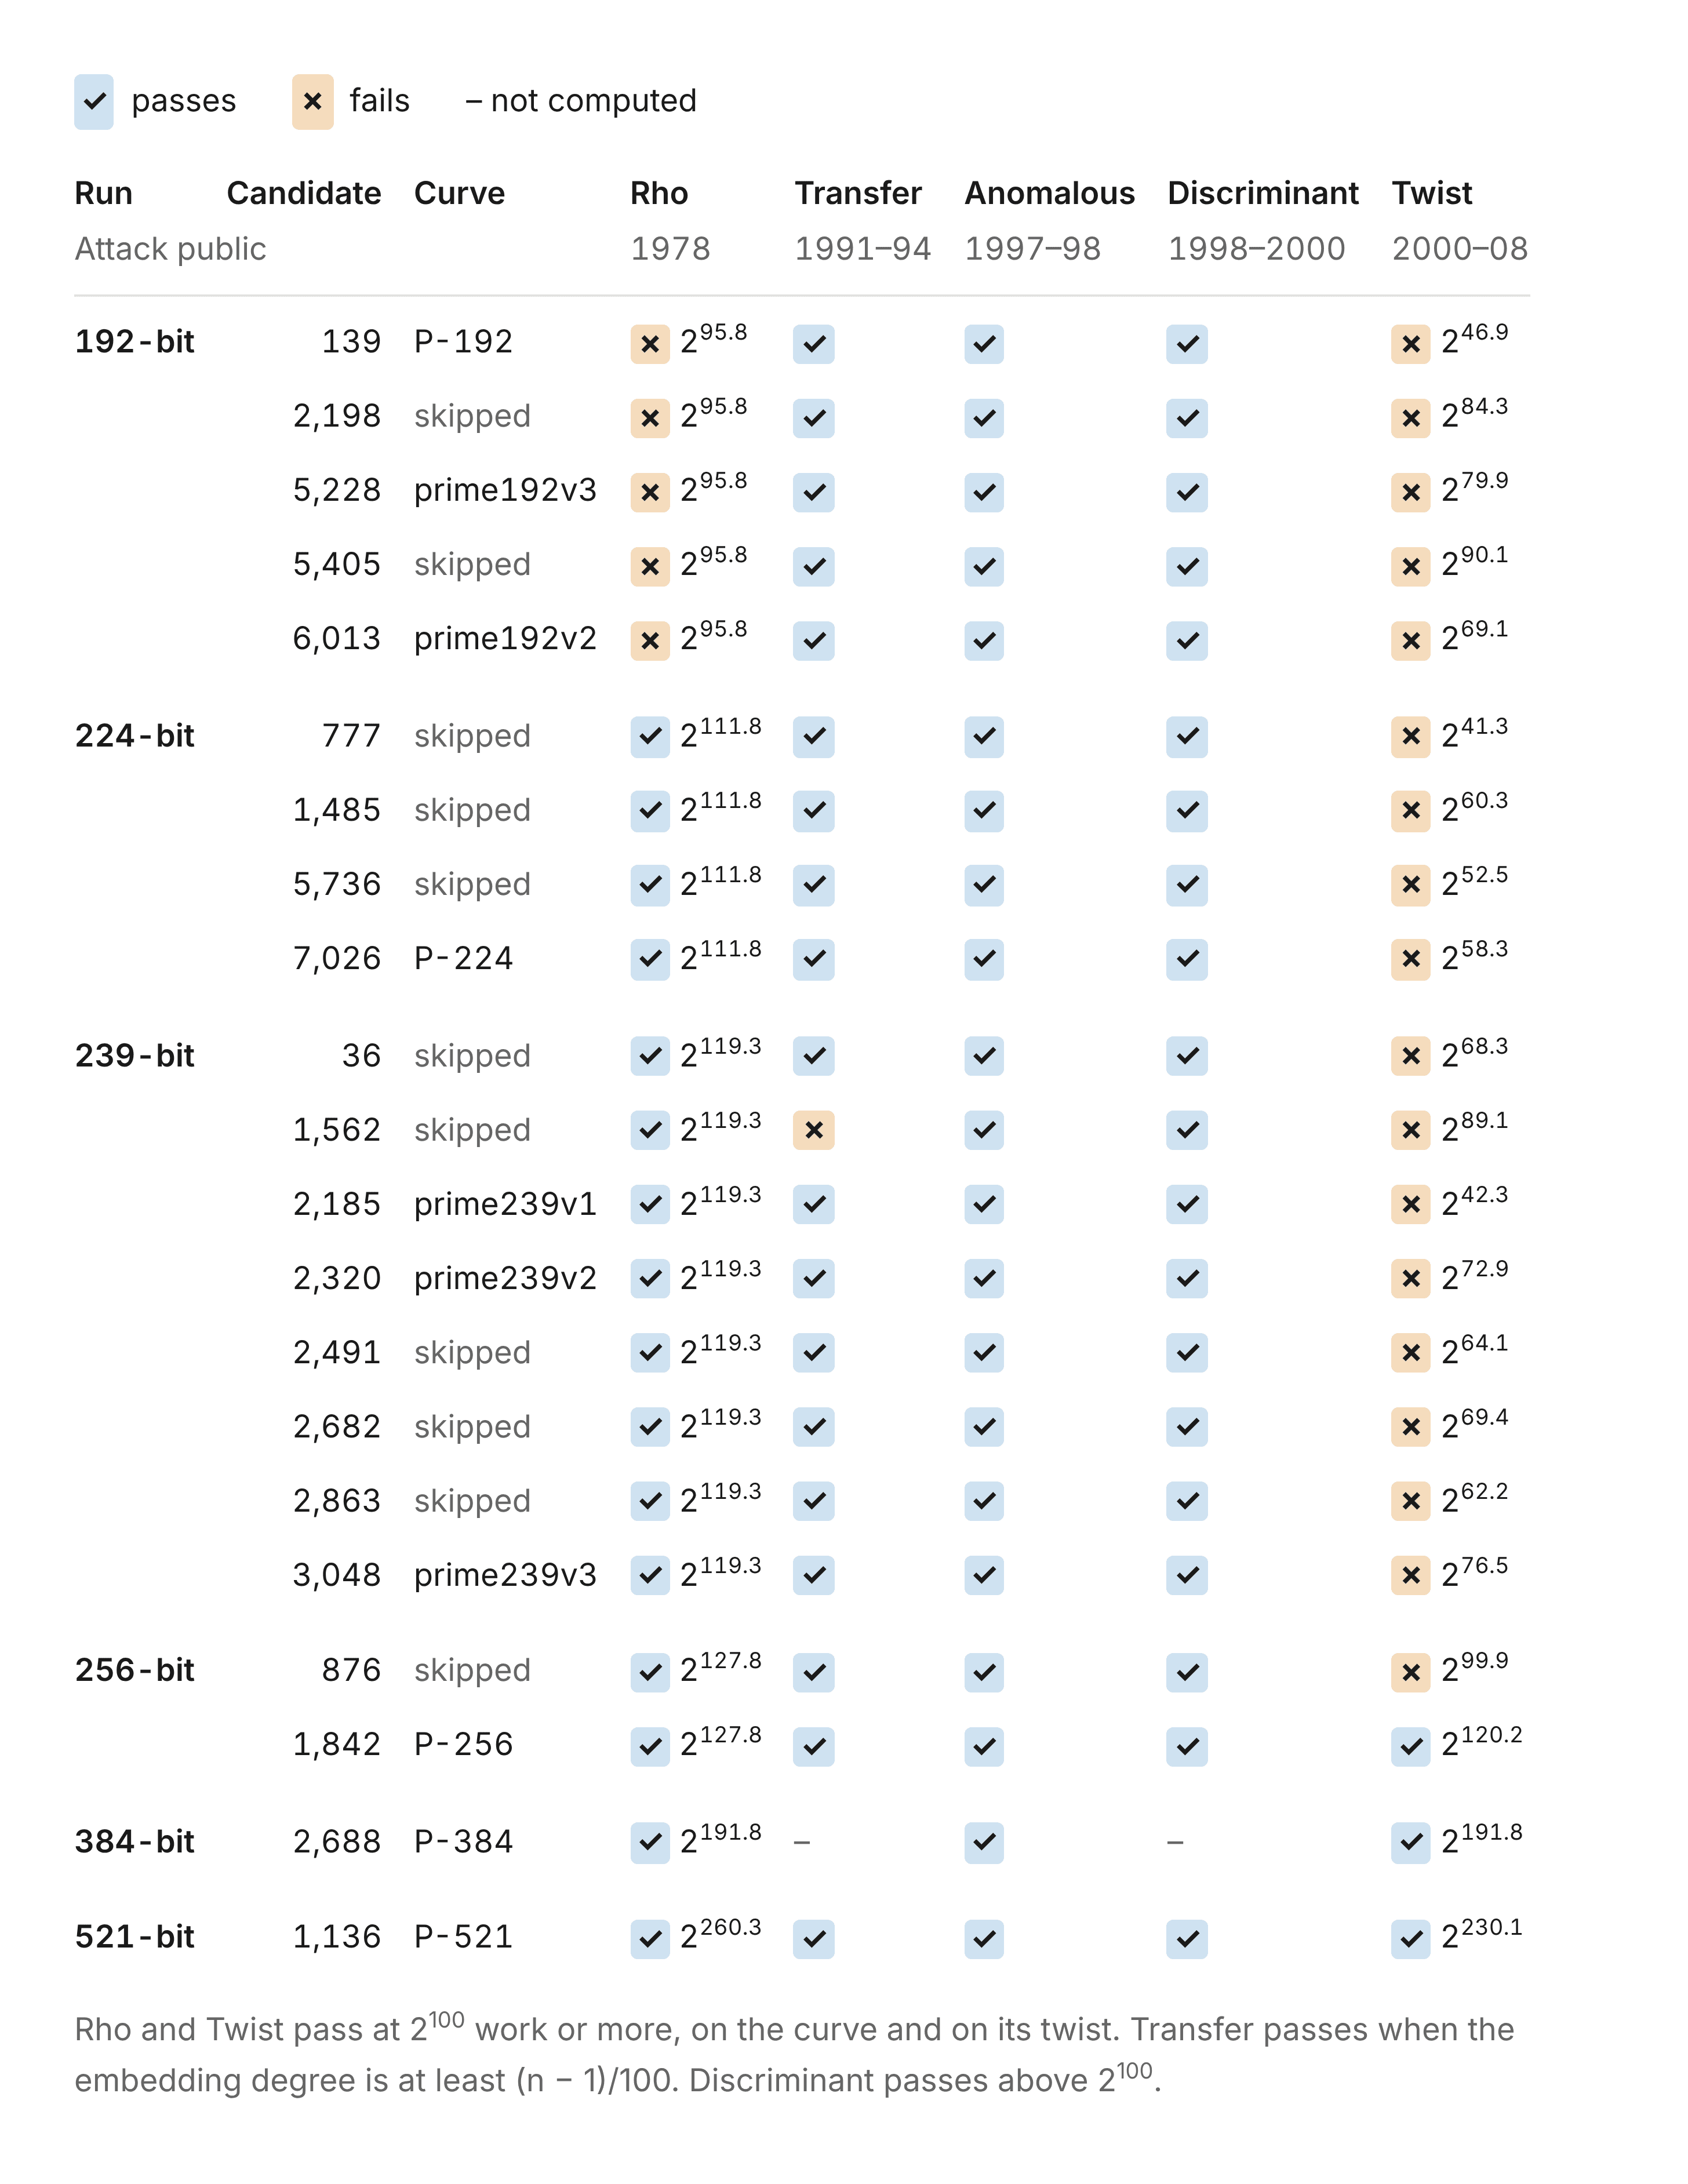
Dado que el número de candidatos omitidos es pequeño, no creemos que sea plausible que se hayan seleccionado curvas debilitadas. Eso implicaría que las curvas debilitadas son comunes y fáciles de encontrar. Todavía es concebible que estas curvas fueran seleccionadas para tener una propiedad específica en principio buscando sobre marcas de tiempo para el generador de números aleatorios. Sin embargo, solo necesitarías hacer eso si fueras a revelar la marca de tiempo como evidencia de que la semilla fue generada de manera inofensiva. Nada en los números muestra cuántas ejecuciones hubo.
También hay una semilla que no pudimos recuperar. La quinta semilla binaria, B-163, no coincide con nada que Claude haya probado y sigue sin explicación. Finalmente, no sabemos cómo se generaron los puntos base para P-224, P-256, P-384 y P-521. Lo mismo ocurre con las curvas binarias del NIST.
La recompensa
Los $36,864 por encontrar las semillas serán donados a Internet Security Research Group.
Quiénes somos
Este trabajo fue realizado en Anthropic por John Wood, Henry de Valence, Ava Howell, Zack Voase, Lucy Sweet, Amir Omidi, Paul Crowley, Iain McGinniss, Nicholas Carlini y Steve Weis.
Agradecimientos
Nos gustaría reconocer póstumamente a Jerry Solinas, quien tomó con buen humor que lo etiquetaran como un «evil Internet meme» y el «Yo La Tengo of NSA bogeymen». También gracias a Filippo Valsorda por organizar el NIST Elliptic Curves Seeds Bounty.
Código para reproducir las semillas
from datetime import datetime, timezone

def unix(when):
    return int(datetime.fromisoformat(when).replace(tzinfo=timezone.utc).timestamp())

def candidate(t, n, per, shift, width):
    x, out = (t << 16) | 0x330E, ""                      # the state srand48(t) sets
    for i in range(per * n):
        x = (0x5DEECE66D * x + 0xB) % 2**48              # one step of lrand48
        if i >= per * (n - 1):
            out += "%0*X" % (width, x >> shift)
    return out

PRIME = {  # srand48(time); 20 bytes per candidate: lrand48() >> 23
    "prime239v1": ("1997-05-15 15:49:03", 2185),
    "prime239v2": ("1997-05-15 15:49:03", 2320),
    "prime239v3": ("1997-05-15 15:49:03", 3048),
    "P-192":      ("1997-05-18 14:45:34", 139),
    "prime192v3": ("1997-05-18 14:45:34", 5228),
    "prime192v2": ("1997-05-18 14:45:34", 6013),
    "P-521":      ("1997-08-08 01:12:04", 1136),
    "P-256":      ("1997-08-16 01:52:34", 1842),
    "P-384":      ("1997-08-30 14:50:08", 2688),
    "P-224":      ("1998-04-03 12:52:07", 7026),
}
BINARY = {  # srand48(time / 2), if that reading is right; 5 words per candidate: lrand48()
    "B-233": ("1998-04-17 15:24:18", 155),
    "B-283": ("1998-04-17 15:27:44", 32),
    "B-409": ("1998-04-17 15:30:18", 60),
    "B-571": ("1998-04-17 15:32:08", 73),
}
for name, (when, n) in PRIME.items():
    print(f"{name:10} {when} {n:5} {candidate(unix(when), n, 20, 40, 2)}")
for name, (when, n) in BINARY.items():
    print(f"{name:10} {when} {n:5} {candidate(unix(when) // 2, n, 5, 17, 8)}")
La salida de este código:
prime239v1 1997-05-15 15:49:03  2185 E43BB460F0B80CC0C0B075798E948060F8321B7D
prime239v2 1997-05-15 15:49:03  2320 E8B4011604095303CA3B8099982BE09FCB9AE616
prime239v3 1997-05-15 15:49:03  3048 7D7374168FFE3471B60A857686A19475D3BFA2FF
P-192      1997-05-18 14:45:34   139 3045AE6FC8422F64ED579528D38120EAE12196D5
prime192v3 1997-05-18 14:45:34  5228 C469684435DEB378C4B65CA9591E2A5763059A2E
prime192v2 1997-05-18 14:45:34  6013 31A92EE2029FD10D901B113E990710F0D21AC6B6
P-521      1997-08-08 01:12:04  1136 D09E8800291CB85396CC6717393284AAA0DA64BA
P-256      1997-08-16 01:52:34  1842 C49D360886E704936A6678E1139D26B7819F7E90
P-384      1997-08-30 14:50:08  2688 A335926AA319A27A1D00896A6773A4827ACDAC73
P-224      1998-04-03 12:52:07  7026 BD71344799D5C7FCDC45B59FA3B9AB8F6A948BC5
B-233      1998-04-17 15:24:18   155 74D59FF07F6B413D0EA14B344B20A2DB049B50C3
B-283      1998-04-17 15:27:44    32 77E2B07370EB0F832A6DD5B62DFC88CD06BB84BE
B-409      1998-04-17 15:30:18    60 4099B5A457F9D69F79213D094C4BCD4D4262210B
B-571      1998-04-17 15:32:08    73 2AA058F73A0E33AB486B0F610410C53A7F132310
Código para reproducir puntos base seleccionados
M, A = 2**107 - 1, pow(3, 121, 2**107 - 1)       # zrandom: state = state * 3^121 mod (2^107 - 1)
P192 = 2**192 - 2**64 - 1
P239 = 2**239 - 2**143 - 2**95 + 2**47 - 1

CURVES = [  # name, LIP seed, p, b, published Gx   (a = -3 throughout)
    ("prime192v1", 20000, P192,
     0x64210519e59c80e70fa7e9ab72243049feb8deecc146b9b1,
     0x188da80eb03090f67cbf20eb43a18800f4ff0afd82ff1012),
    ("prime239v1", 20420, P239,
     0x6b016c3bdcf18941d0d654921475ca71a9db2fb27d1d37796185c2942c0a,
     0xffa963cdca8816ccc33b8642bedf905c3d358573d3f27fbbd3b3cb9aaaf),
    ("prime239v2", 20507, P239,
     0x617fab6832576cbbfed50d99f0249c3fee58b94ba0038c7ae84c8c832f2c,
     0x38af09d98727705120c921bb5e9e26296a3cdcf2f35757a0eafd87b830e7),
    ("prime239v3", 20509, P239,
     0x255705fa2a306654b1f4cb03d6a750a30c250102d4988717d9ba15ab6d3e,
     0x6768ae8e18bb92cfcf005c949aa2c6d94853d0e660bbf854b1c9505fe95a),
    ("prime192v2", 20512, P192,
     0xcc22d6dfb95c6b25e49c0d6364a4e5980c393aa21668d953,
     0xeea2bae7e1497842f2de7769cfe9c989c072ad696f48034a),
    ("prime192v3", 20517, P192,
     0x22123dc2395a05caa7423daeccc94760a7d462256bd56916,
     0x7d29778100c65a1da1783716588dce2b8b4aee8e228f1896),
]

def base_point_x(seed, p, b):
    state = seed                         # zrstarts(seed)
    def limb():                          # zrandom(2^26): low 26 bits of the new state
        nonlocal state
        state = state * A % M
        return state % 2**26
    for _ in range(7):                   # seven single-limb draws come first
        limb()
    limbs = -(-p.bit_length() // 26) + 1 # zrandomb(p): limbs of p plus one, top limb first
    tries = 0
    while True:
        x = 0
        for _ in range(limbs):
            x = x << 26 | limb()
        x %= p
        tries += 1
        if pow(x**3 - 3*x + b, (p - 1) // 2, p) == 1:   # is x on the curve?
            return x, tries

for name, seed, p, b, gx in CURVES:
    x, tries = base_point_x(seed, p, b)
    print(f"{name:20} seed {seed}  tries {tries}  matches published Gx: {x == gx}")
La salida de este código:
prime192v1           seed 20000  tries 2  matches published Gx: True
prime239v1           seed 20420  tries 3  matches published Gx: True
prime239v2           seed 20507  tries 2  matches published Gx: True
prime239v3           seed 20509  tries 1  matches published Gx: True
prime192v2           seed 20512  tries 5  matches published Gx: True
prime192v3           seed 20517  tries 1  matches published Gx: True
Licencia
En la mayor medida permitida por la ley, los autores han renunciado a todos los derechos de autor y derechos conexos o vecinos del código en esta página, dedicándolo al dominio público bajo CC0 1.0 Universal (https://creativecommons.org/publicdomain/zero/1.0/).
Contenido relacionado
Diseño de circuitos cuánticos más eficientes con Claude
Le dimos a Claude especificaciones en lenguaje natural para ocho circuitos cuánticos, junto con un evaluador automatizado para verificar y calificar sus diseños. Trabajando en gran medida por su cuenta, Claude mejoró los mejores circuitos publicados, en algunos casos en un orden de magnitud o más, lo que podría acercar las computadoras cuánticas prácticas más de lo que se anticipaba.
Leer másLos modelos de IA podrían ser capaces de autorreplicarse sin acceso a un centro de datos
Nuestros experimentos sugieren que los modelos de IA pequeños podrían estar a solo meses de ser lo suficientemente capaces de autorreplicarse en dispositivos IoT comerciales, como televisores Android y hornos inteligentes.
Leer másFortaleciendo nuestras defensas contra los ataques de destilación
La destilación ilícita permite a los desarrolladores de modelos copiar capacidades de IA de frontera sin crear salvaguardas proporcionalmente robustas. Aquí describimos cómo hemos reducido la tasa de destilación en más del 90%.
Leer másSuscríbete al boletín del Frontier Red Team
Reciba novedades sobre nuestras últimas investigaciones y hallazgos en equipos rojos (red-teaming).