
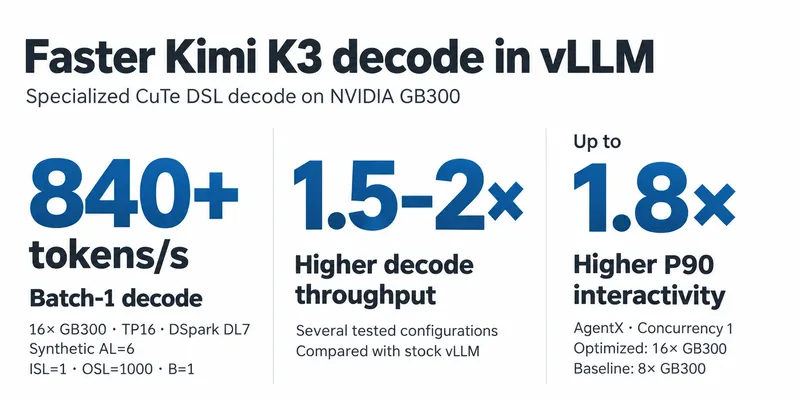
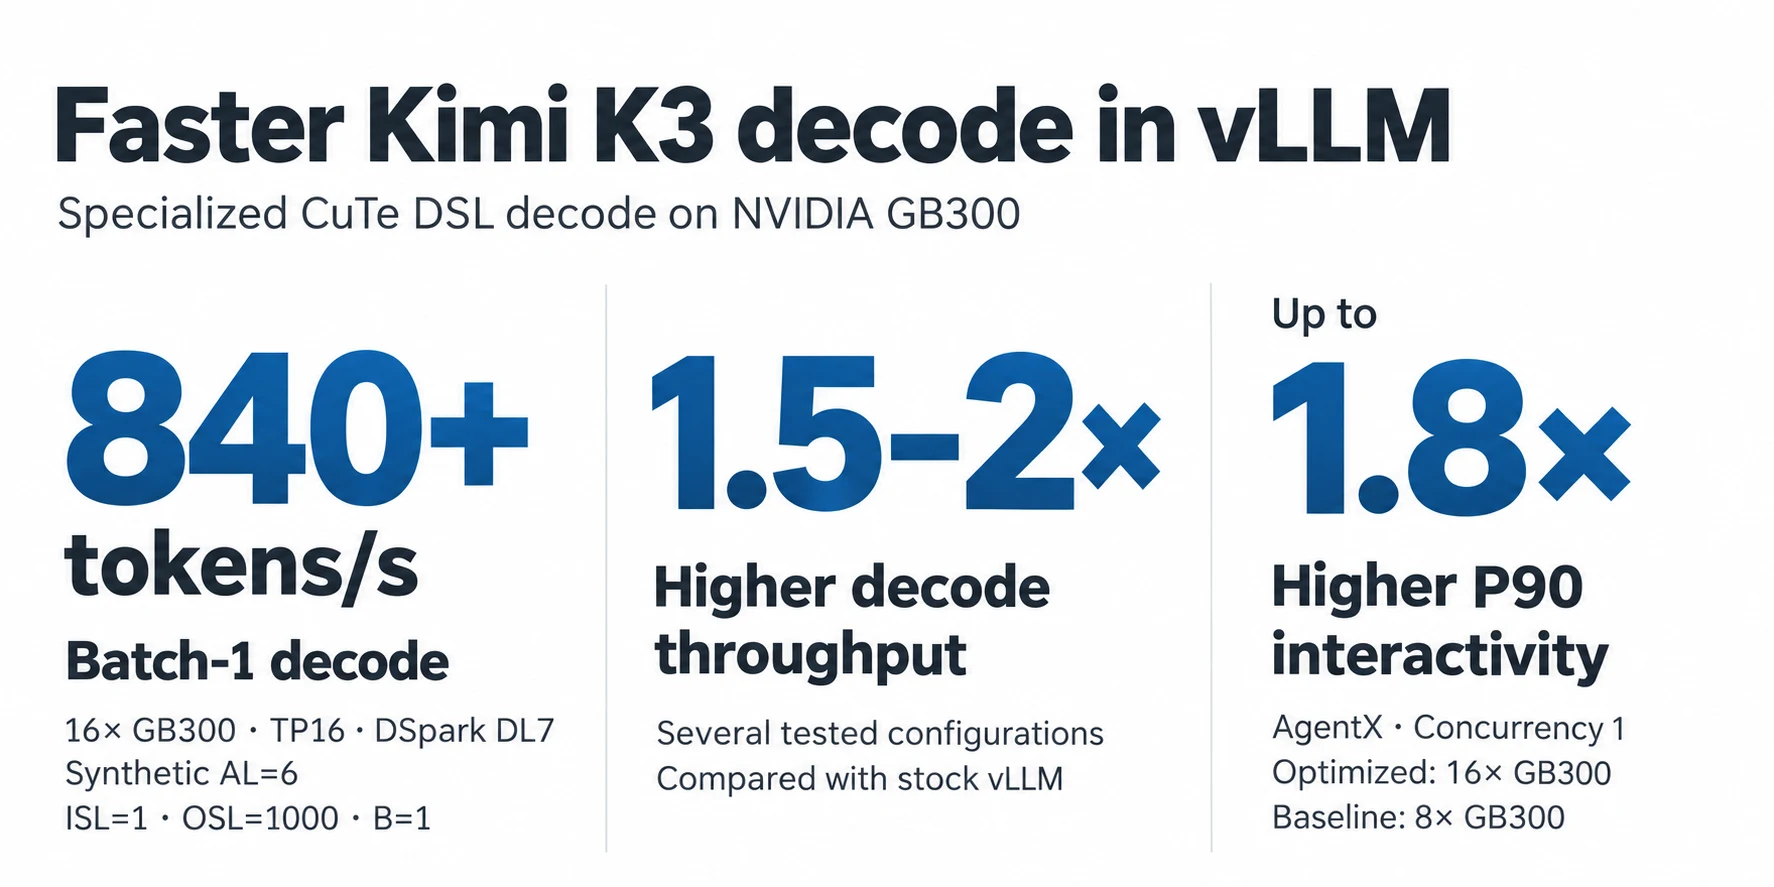
Los agentes de codificación ahora pueden ayudar con algunas de las partes más difíciles de la optimización del modelo: escribir kernels complejos para GPU, realizar fusiones entre operadores, superponer el cálculo con la comunicación y ajustar la ejecución según diferentes tamaños de lote y configuraciones de GPU. Para Kimi K3, utilizamos el desarrollo asistido por agente para construir una ruta de decodificación unificada en CuTe DSL en el NVIDIA GB300, que abarca atención, MoE y comunicación entre 8 o 16 GPUs. Las optimizaciones logran más de 840 tokens/s en el lote 1 con 16 GPUs NVIDIA GB300 usando DSpark (AL sintético = 6), un 1,5–2× mayor rendimiento de decodificación en varias configuraciones probadas, y hasta un 1,8× mayor interactividad P90 en la carga de trabajo AgentX.
El código de inferencia optimizado por el agente está superando el flujo de trabajo de revisión y mantenimiento. El proceso de revisión manual de entender cada línea de cada kernel, identificar posibles problemas y probar cada configuración soportada es un trabajo muy laborioso. Por otro lado, si omitimos este trabajo, corremos el riesgo de lanzar software defectuoso que podría fallar en producción.
Existe una línea de visión clara para lograr ambos objetivos: necesitamos cambiar la forma en que organizamos el trabajo de rendimiento. Además de la optimización agentic, necesitamos diseñar sistemas que permitan la verificación automática de fiabilidad y rendimiento, y necesitamos estructurar el software para imponer la aislamiento y la minimización de riesgos desde el diseño.
El RFC de optimización del modelo de tránsito rápido propuesto proporciona una base para este enfoque. Nuestro principio guía es reducir la carga de revisión mientras se gestiona el riesgo. Para lograr esto, hacemos:
- Isola los cambios. Mantén las optimizaciones dentro del código del modelo.
- Limitar el alcance, conservar las características principales. Definir el hardware y los trabajos de carga soportados, pero preservar las características esenciales para el uso de LLM en producción.
- Verifique la corrección de manera sistemática. Ejecute un conjunto establecido de pruebas de rendimiento y corrección para asegurar la integridad y la fiabilidad, y obtenga un rendimiento estrictamente mejor en todas las configuraciones soportadas.
- Validación de escala. Permita que los contribuyentes realicen evaluaciones estándar en sus propias GPU y compartan resultados reproducibles antes de solicitar la atención del mantenedor.
Kimi K3 es nuestra primera contribución siguiendo este enfoque. Este artículo trata sobre cómo optimizamos Kimi K3, cómo construimos la confianza necesaria para lanzar y mantener esas optimizaciones, y los resultados de rendimiento.
Índice de contenidos
- Parte 1: Optimizar Kimi K3
- Parte 2: Moverse Rápido y Responsablemente
- Parte 3: Análisis profundo del rendimiento
- Lo que sigue
- Agradecimientos
Parte 1: Optimización de Kimi K3
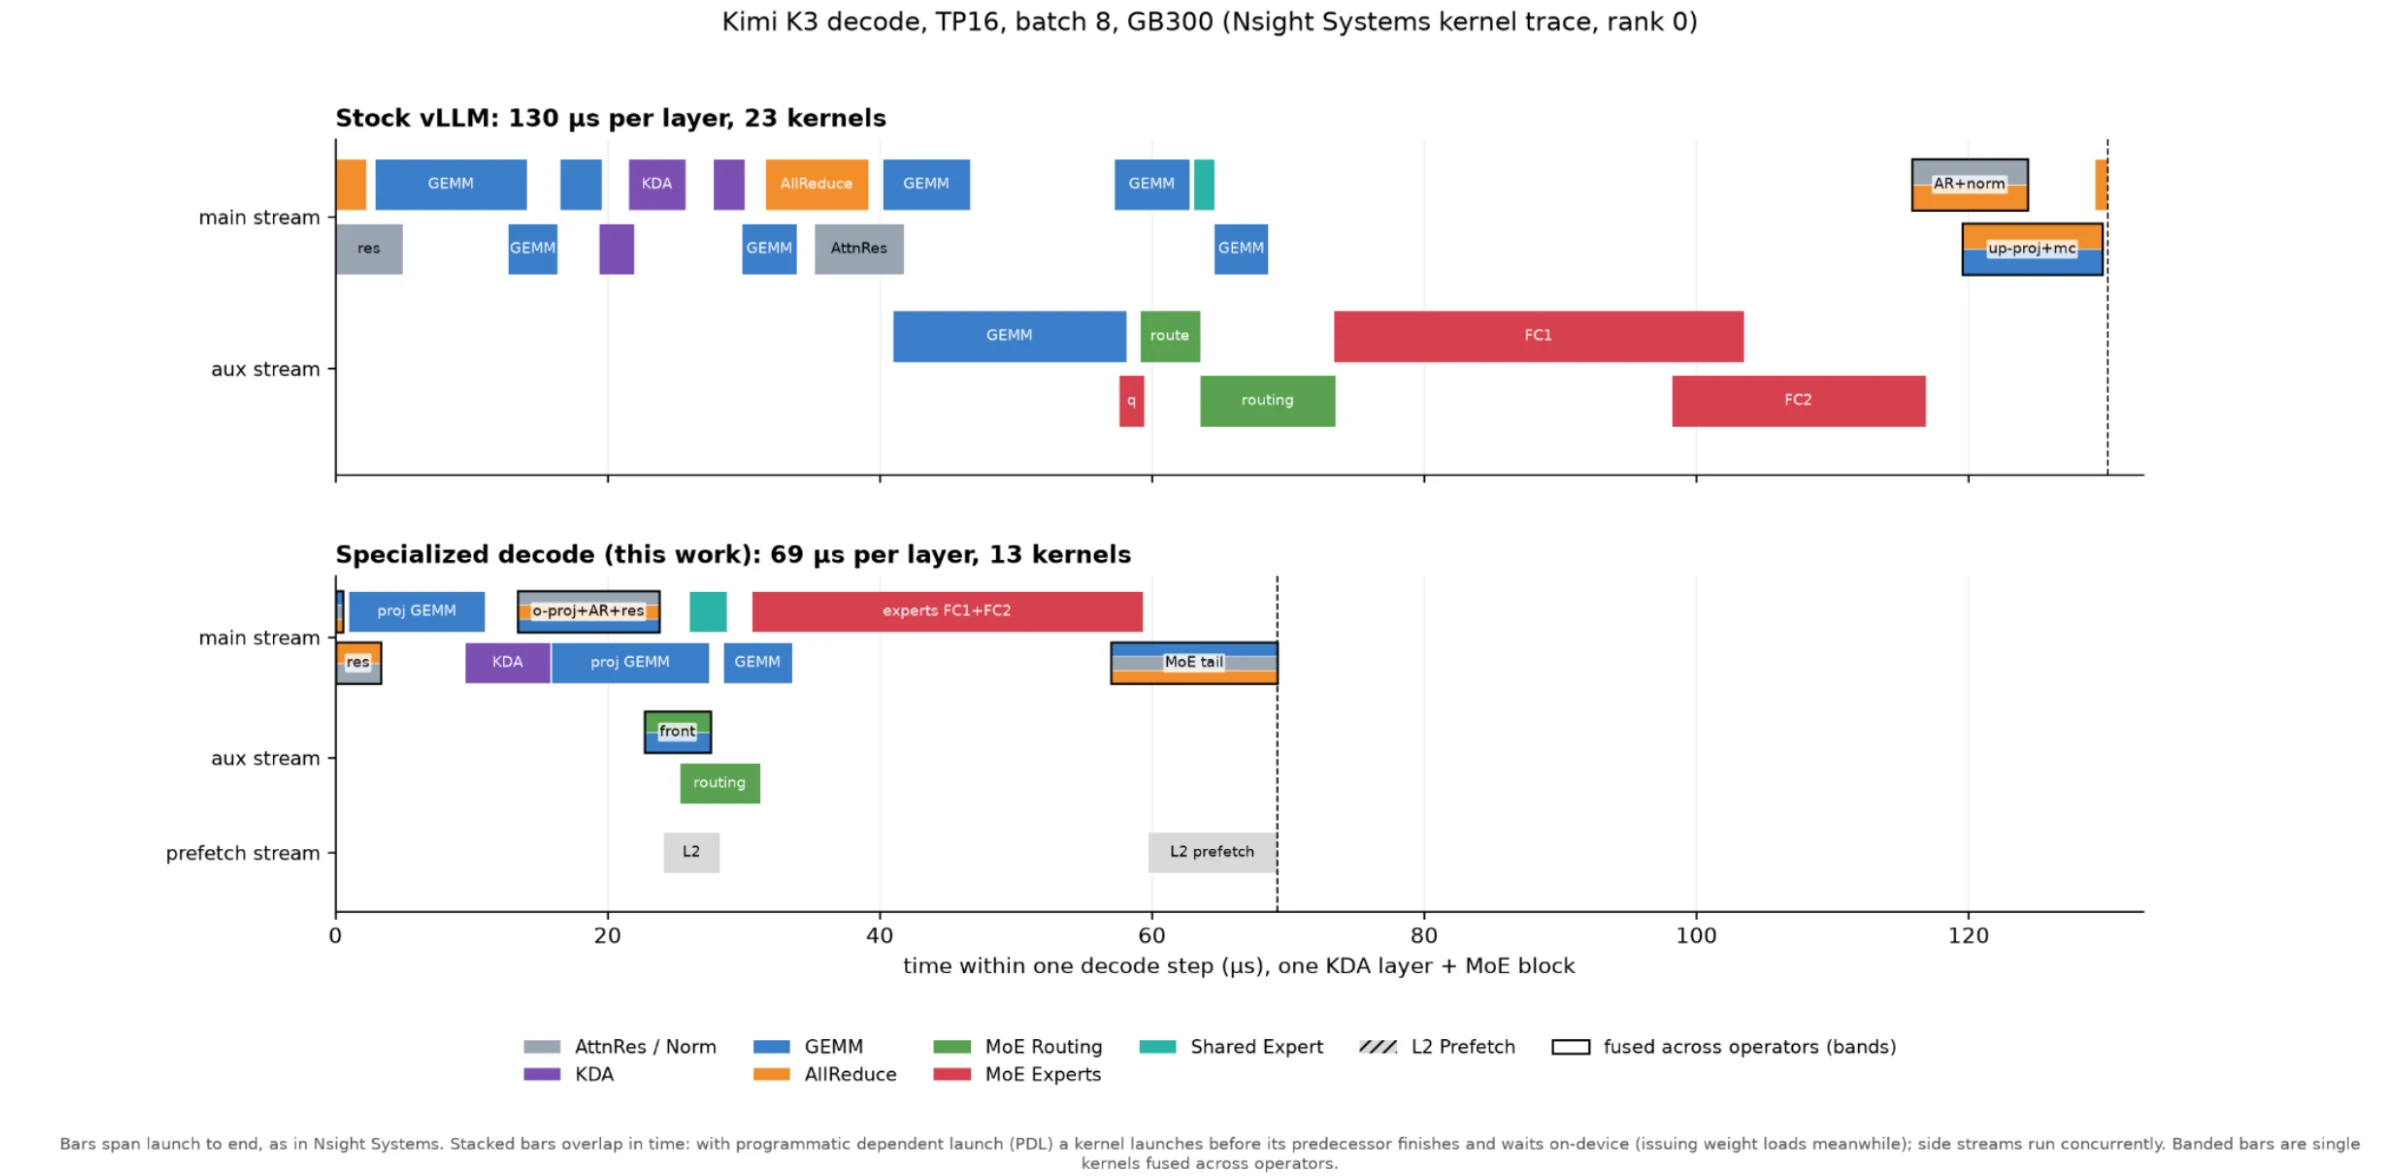
Esta contribución introduce una nueva ruta de decodificación para Kimi K3, que fusiona y reemplaza casi todas las operaciones con kernels CuTe DSL personalizados, ajustados para ciertos subproblemas. Se dirige a GPUs NVIDIA Blackwell con 8 o 16 GPU, decodifica lotes de 1 a 64 y ofrece paralelismo de contexto de decodificación opcional para contextos largos. Las GPU comparten un dominio NVLink con soporte multicast. Para más detalles, por favor consulte el PR.
1. Ajustar las formas según la carga de trabajo
Diferentes tamaños de lote requieren diferentes selecciones de núcleos. Para proyecciones de entrada de atención, utilizamos núcleos especializados de matriz pequeña en tamaños de lote de 1–2 y núcleos split-K en lotes más grandes, lo que divide la multiplicación de matriz entre más trabajadores de GPU. Todas estas proyecciones han sido ajustadas detalladamente para activar núcleos de tamaño adecuado que utilicen completamente los recursos del GPU y compartan las lecturas de memoria, la comunicación y el trabajo de computación tanto como sea posible.
KDA también utiliza un kernel de decodificación CuTe DSL optimizado, con la programación ajustada para el tamaño del lote y el número de cabezas de atención en cada GPU.
Para contextos largos, el decodificado de paralelismo de contexto (DCP) divide la caché KV entre las GPU. Cada GPU calcula la atención sobre su porción local, y un kernel fusionado ajustado combina los resultados parciales con v-proj y gating.
2. Superposición de computación y comunicación
Fusimos la proyección de salida de atención directamente con su all-reduce y el siguiente cálculo del residuo de atención. Los kernels de GPU publican resultados parciales en buffers accesibles por NVLink, y los kernels receptores los combinan y continúan el cálculo. Algunas configuraciones de lotes pequeños fusionan el productor y el consumidor en un único kernel. El intercambio de datos se realiza con un enfoque sin valla y con un sobrecargo mínimo.
En lotes más grandes, la implementación pasa a una reducción de dos etapas: las GPU combinan primero las porciones asignadas del resultado y, posteriormente, distribuyen los resultados. Esto reduce el movimiento de datos entre las GPUs.
3. Mejorar la programación de MoE y el sobrepunto
Aunque los expertos ya utilizan el paralelismo de tensores, el modelo base calcula las puntuaciones completas del enrutador y la proyección de la entrada latente en cada GPU. Dividimos estos cálculos entre los rangos del TP y combinamos la parte correspondiente de cada rango en una multiplicación de matrices. Las GPUs intercambian los resultados a través de NVLink. Esto reduce el cálculo repetido, las lecturas de pesos y los lanzamientos del kernel antes de que comience la ejecución por parte de los expertos.
El experto compartido funciona en un flujo separado. Su trabajo se superpone con el cálculo de routing o routed-expert, dependiendo de la configuración. El horario controla cuántos recursos de GPU utiliza cada operación, y está ajustado cuidadosamente para garantizar un paralelismo bien equilibrado sin conflictos. Los detalles se encuentran en experts_runtime.
4. Prefetching los pesos futuros en la caché
En la inferencia de pequeñas cantidades, a menudo estamos limitados por la memoria: estamos restringidos por la velocidad con la que podemos cargar los pesos desde la memoria. Algunas fases no pueden utilizar completamente el ancho de banda de la memoria disponible, como la comunicación: mientras esto ocurre, podemos ejecutar un kernel dedicado en un flujo secundario para asegurar que, una vez que la comunicación se complete, los pesos para la siguiente operación tendrán una tasa de hit en la caché mucho mayor.
Parte 2: Moverse rápido y de manera responsable
Kimi K3 es solo uno de los primeros ejemplos. Creemos que la comunidad puede construir esto juntos, para lanzar más modelos, GPU y cargas de trabajo hacia la velocidad de la luz.
Diferentes contribuyentes/agentes encontrarán diferentes oportunidades: un mejor horario de comunicación, o una fusión que ayude a una implementación específica. Pero si cada contribución llega con supuestos diferentes, pruebas incompletas y un benchmark difícil de reproducir, el trabajo de validación y mantenimiento se convierte rápidamente en un cuello de botella, o corremos el riesgo de enviar código defectuoso. Necesitamos una forma común para convertir esas ideas en mejoras en las que los usuarios puedan confiar para sus casos de uso de producción a largo plazo.
Esto cambia lo que pedimos a los agentes que entreguen. Deberíamos establecer expectativas claras en cuanto a las pruebas, las validaciones y los requisitos del código que producen los agentes. Los agentes construirán pruebas, realizarán evaluaciones y puntos de referencia completos, investigarán los fallos y documentarán las condiciones bajo las cuales funciona la optimización. Los revisores humanos todavía juzgarán el diseño y las pruebas, pero pueden comenzar desde una abstracción de nivel alto, en lugar de una revisión del código línea por línea.
Basándonos en el RFC de acceso rápido propuesto, organizamos este trabajo en torno a cuatro principios.
1. Aislar los cambios
Mantenga las optimizaciones específicas para el modelo dentro del código del modelo. Esto hace que los caminos afectados sean más fáciles de identificar y reduce el radio de influencia que el revisor necesita considerar.
La aislamiento también debe mantenerse en tiempo de ejecución. Los revisores deben poder rastrear cuándo se selecciona el camino optimizado, en qué estado cambia y cómo la ejecución vuelve al camino estándar.
Esta restricción realmente excluye algunas optimizaciones: la preparación de entradas, el muestreo y la gestión de la caché KV pueden generar sobrecarga que la isolación no permite. Esta es una consecuencia del diseño y en gran medida intencional: todos estos componentes son compartidos en la mayoría de las implementaciones de vLLM, y cambiarlos para optimizar para un trabajo específico puede arruinar decenas de otras configuraciones estables de vLLM. El trabajo en estos componentes es importante y debe involucrar a los mantenedores principales de manera mucho más estrecha de lo que permitiría el proceso rápido.
2. Limite el alcance, pero preserve las características del usuario
Una optimización no necesita mejorar cada implementación para ser útil. Puede dirigirse a un determinado GPU, un ajuste de paralelismo o un rango de tamaños de lote. Los límites claros facilitan la configuración del trabajo y nos proporcionan un conjunto definido de configuraciones para validar.
Para K3, la validación de hardware inicial abarca GB300 con TP8 y TP16, decodifica batallas hasta 64, decodificación especulativa con diversos largos de borrador, y decodifica de configuraciones paralelas de contexto dentro de un dominio NVLink.
Estos límites describen dónde se aplica la optimización, pero no impiden la ‘cobertura de funciones’. La implementación en producción requiere funciones fundamentales que hagan que el punto final sea útil. Funciones como el servicio de contexto completo, muestreo de temperatura y salida estructurada no pueden ser ‘optimizadas’ o ‘desactivadas’, son funciones de servicio de primera clase y forman parte del plan de validación junto con las formas del kernel y los controles numéricos.
3. Validar la corrección
Los pruebas de kernel y las evaluaciones de modelo responden a preguntas diferentes. Las pruebas de kernel verifican los resultados numéricos en diferentes formas y valores de entrada. Las evaluaciones de modelo determinan si el camino completo de ejecución preserva las respuestas del modelo. Necesitamos ambos.
Los tests deben realmente ejercer el código modificado. Una optimización en lotes pequeños necesita ser evaluada en lotes pequeños. Un cambio en el kernel de atención necesita cobertura de contexto largo. Los tests que utilizan silenciosamente el camino estándar proporcionan poca evidencia sobre la optimización y son una trampa común.
El desarrollo de K3 muestra por qué esto es importante. Nuestra auditoría reveló que el compilador realizaba lecturas de activación antes de la espera de sincronización. La solución limitó ese tipo de carga a pesos estáticos. Tales errores pueden sobrevivir a las simples verificaciones funcionales y requieren una investigación específica.
Además, evaluaciones de largo contexto y de larga generación, como MRCR y AIME25, revelaron problemas numéricos sensibles en los núcleos de atención y comunicación que no podían reproducirse en pruebas de núcleo independientes utilizando entradas simuladas y/o tiempos de lanzamiento consistentes.
4. Verificar el rendimiento en general
Un aceleración en el título es un punto de partida. También necesitamos saber cómo se comporta el cambio en los cargas de trabajo que afecta. Esto significa tamaños de lote amplios, longitudes de contexto y configuraciones de paralelismo soportadas. Las mediciones MoE deben incluir prompts reales, porque la selección de expertos afecta qué pesos se leen y cuánto trabajo puede ser reutilizado. Los resultados puros de decodificación también deben distinguirse de las cargas de trabajo que combinan preenganche y decodificación.
La validación confiable también requiere tiempo en GPU. La RFC de evaluación con GPU propia relacionada propone imágenes de evaluación estándar que los colaboradores pueden ejecutar en su propio hardware. Los paquetes de resultados reproducibles y las entregas vinculadas a PRs en GitHub harían que la evidencia sea mucho más accesible. Diferentes niveles de evaluación y el cálculo computacional compartido de la comunidad ayudarían a ampliar la cobertura, al mismo tiempo que se gestiona la demanda de GPU y se reduce la presión sobre el CI financiado por el proyecto.
Parte 3: Análisis profundo del rendimiento
Rendimiento de decodificación con DSpark
Con DSpark, Kimi K3 alcanza 842 tokens por segundo en 16 GPU NVIDIA GB300 en el benchmark controlado AL=6. Eso es 1.73× más rápido que vLLM sin configuración de decodificación especulativa. Refiérase al PR para ver la tabla de resultados completa.
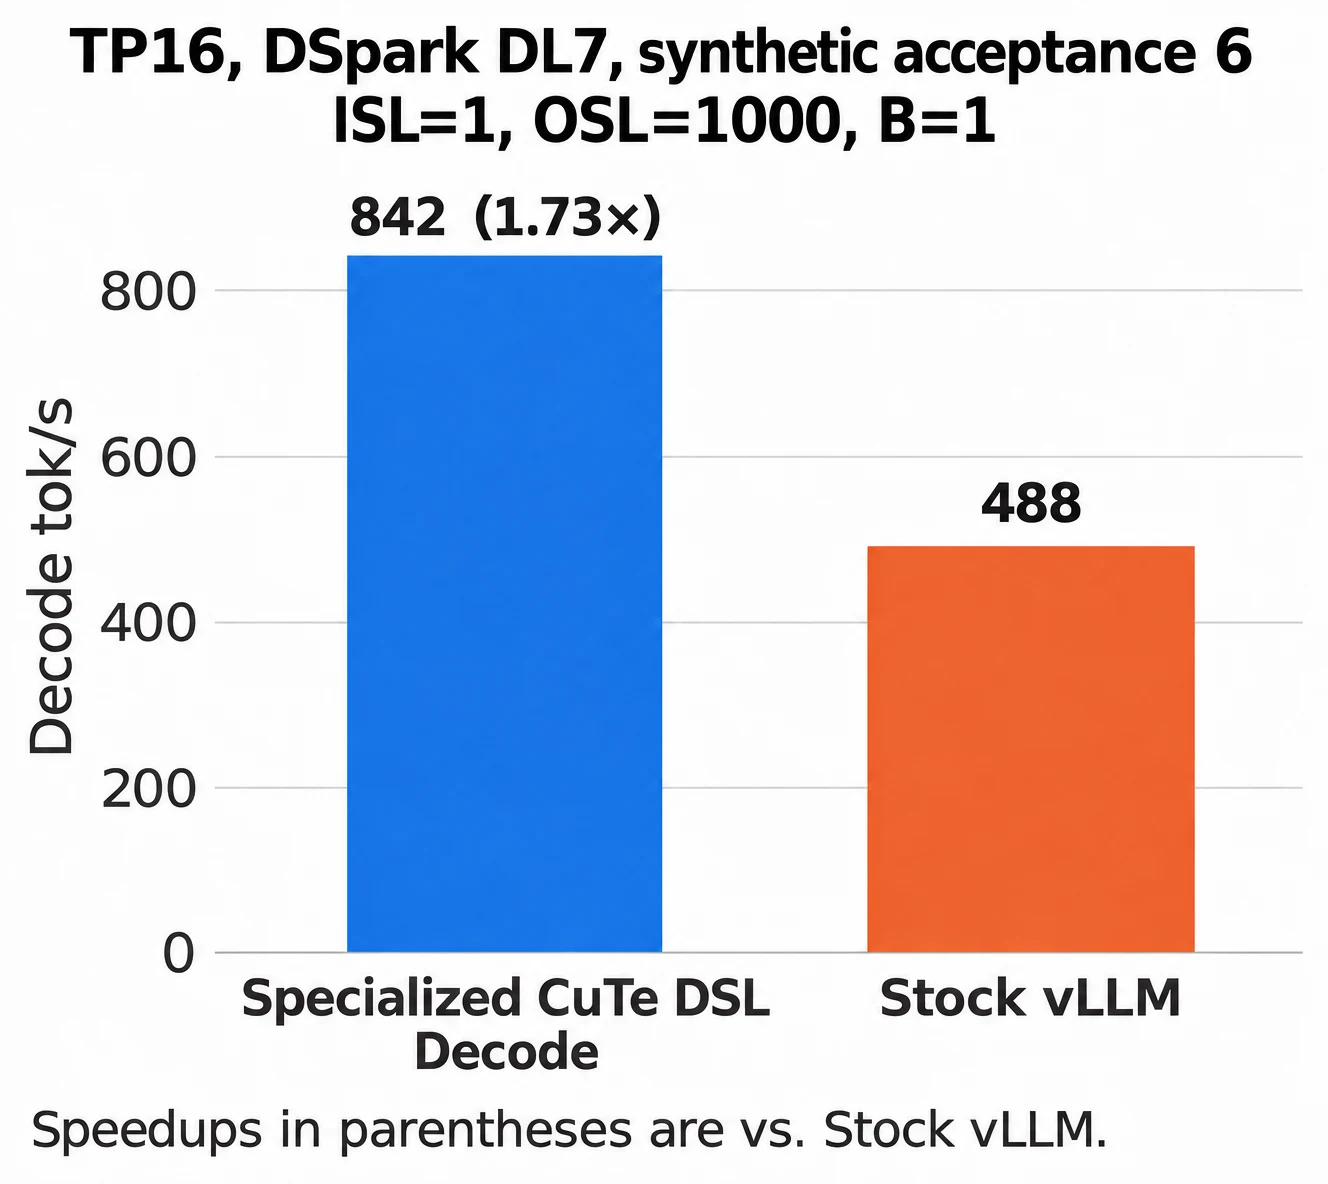
Configuración: TP16, DSpark con siete tokens de borrador, longitud sintética de aceptación de 6, DL=7, ISL=1, OSL=1k, tamaño de lote 1. TPS mide el rendimiento total de decodificación y excluye el prellenado.
Rendimiento de decodificación sin especulaciones
Las mejoras se extienden a todo el rango de lotes probados. TP16 mantiene un 1.62–1.71× de ganancia en los lotes 16–64, mientras que TP8 ofrece 1.31–1.43× en el mismo rango.
| Tamaño del lote | TP8 tokens/s | TP8 aceleración | TP16 tokens/s | TP16 aceleración |
|---|---|---|---|---|
| 1 | 193.3 | 1.58× | 256.4 | 1.88× |
| 2 | 317.8 | 1.50× | 436.7 | 1.92× |
| 4 | 540.6 | 1.55× | 702.5 | 1.81× |
| 8 | 820.1 | 1.45× | 1,157.9 | 1.79× |
| 16 | 1,274.8 | 1.43× | 1,758.3 | 1.71× |
| 32 | 1,702.6 | 1.33× | 2,550.9 | 1.64× |
| 64 | 2,375.9 | 1.31× | 3,606.1 | 1.62× |
No hay decodificación especulativa. El rendimiento se refiere al grupo completo de TP.
Mejora en AgentX
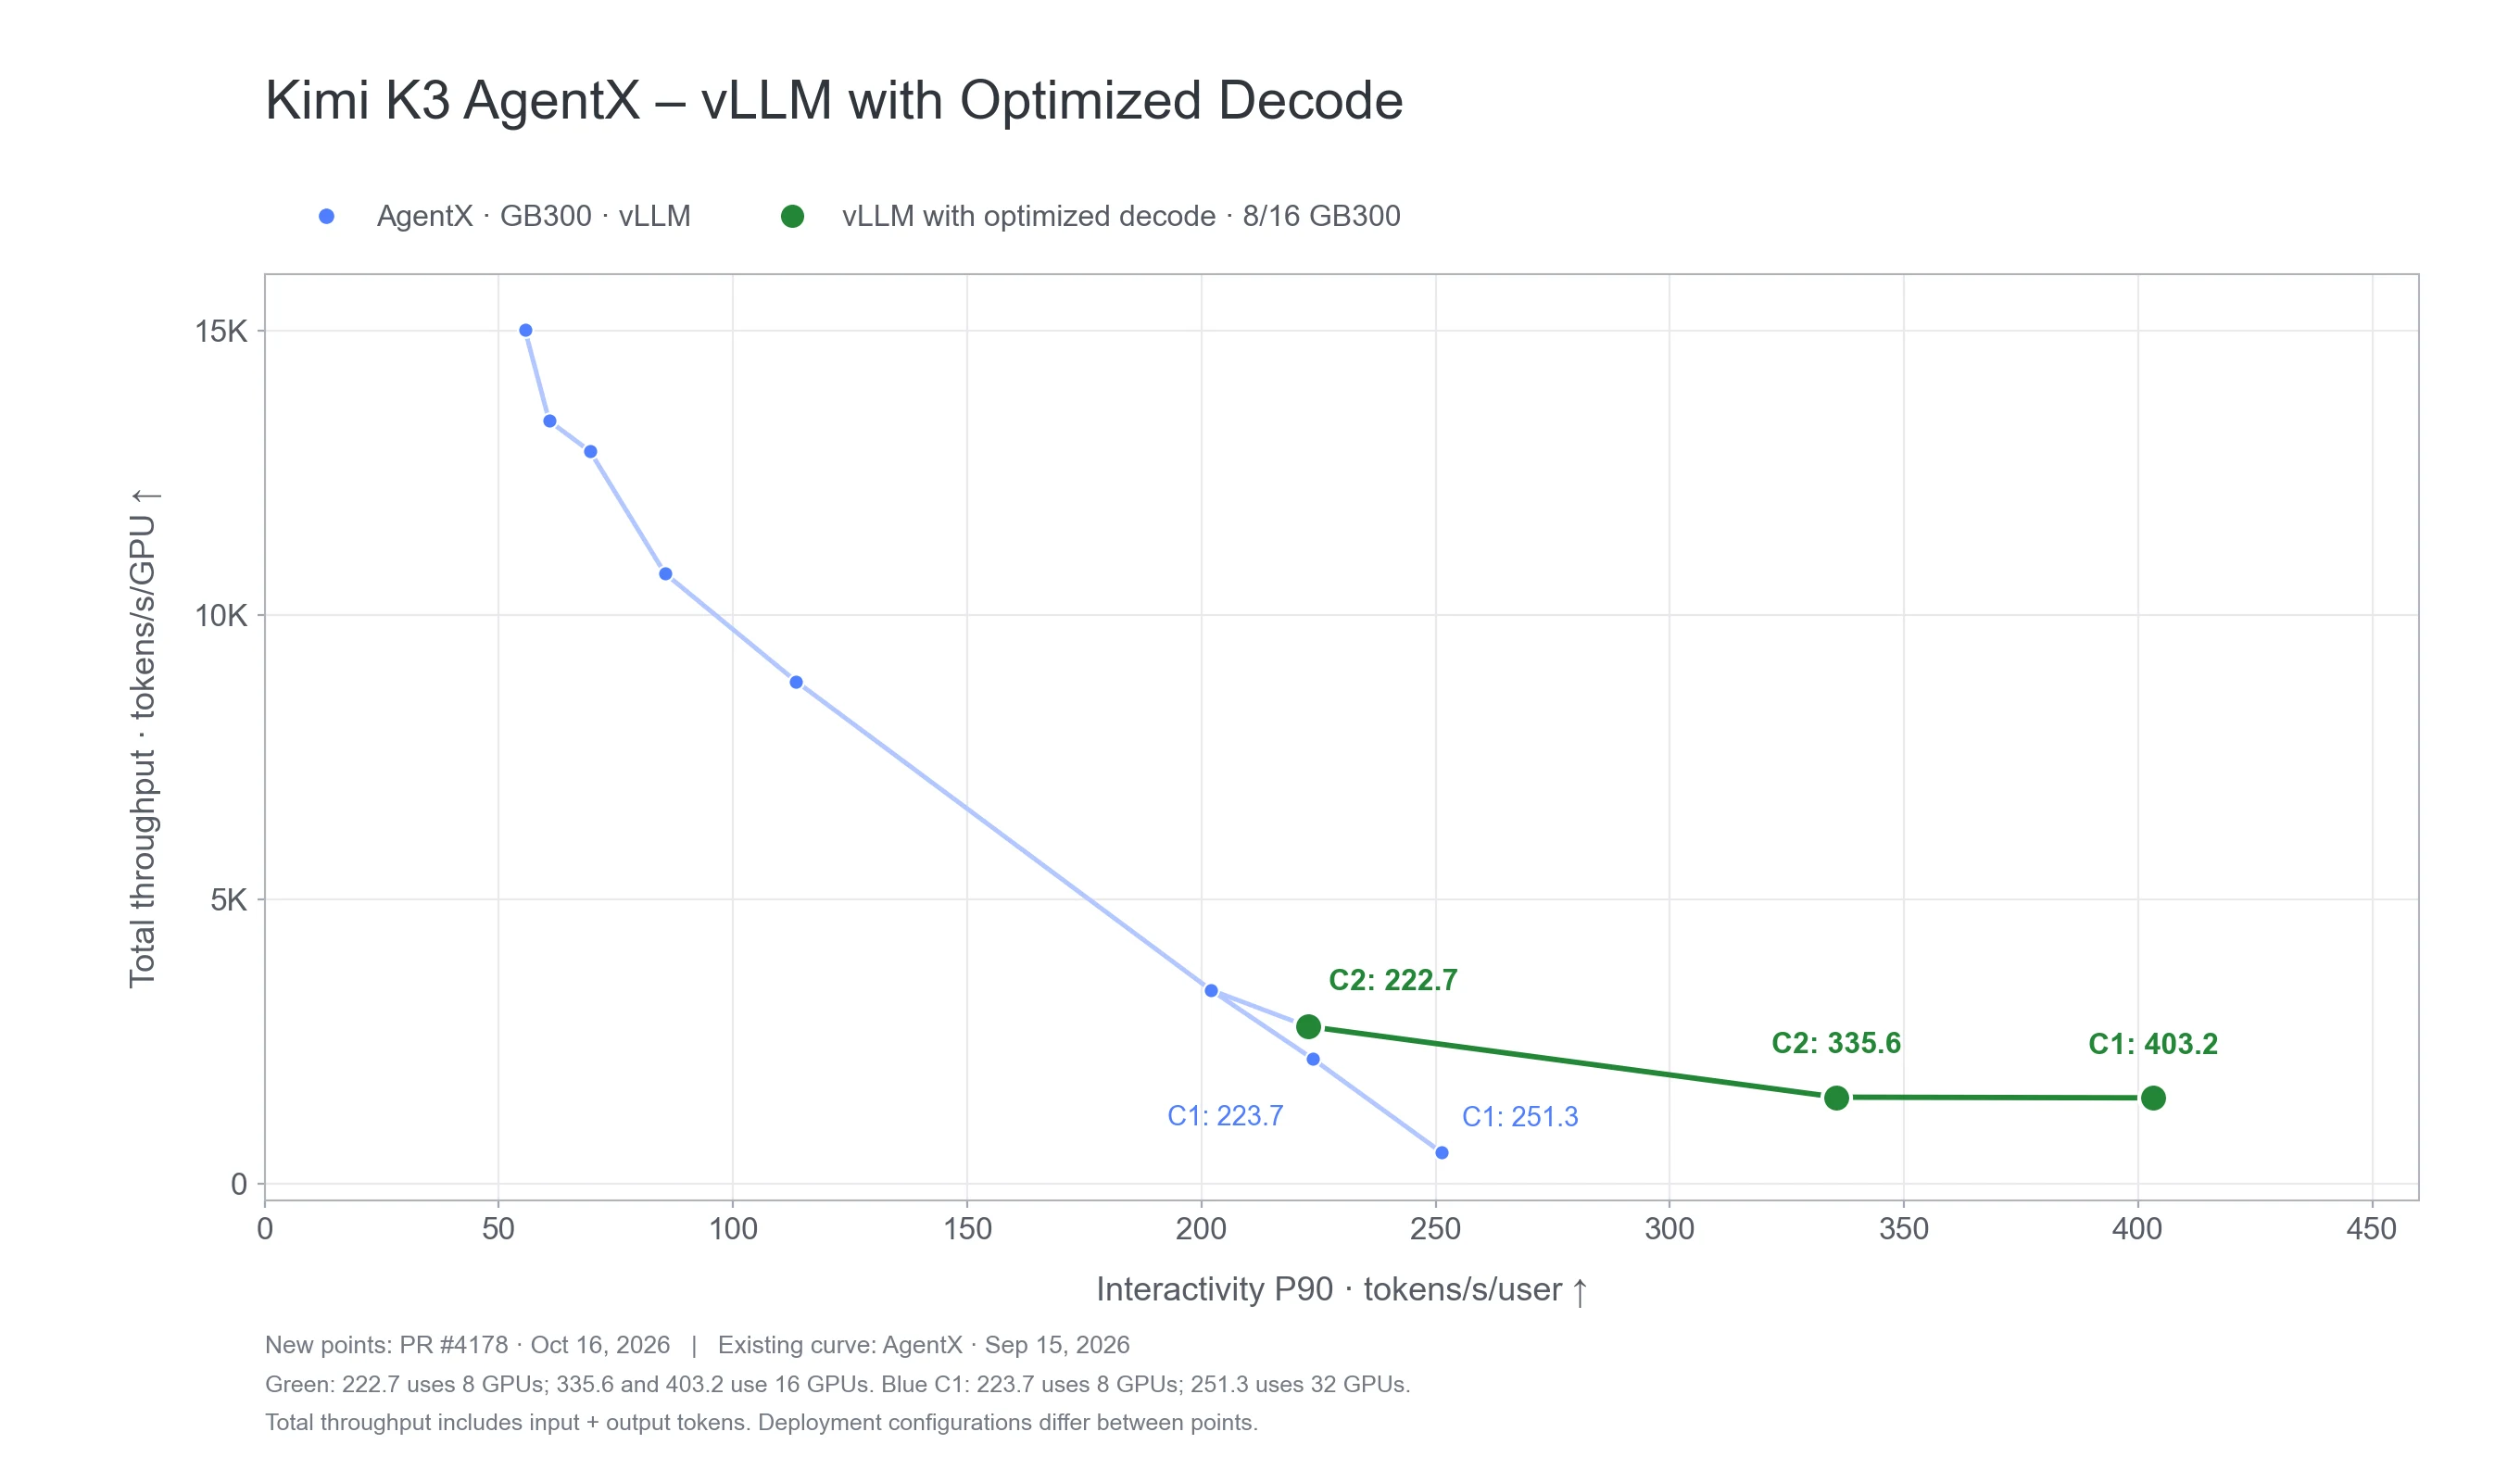
Nuestra implementación optimizada de Kimi K3 también ofrece 1.8× más interactividad en P90 con concurrencia 1 en AgentX: 403.2 frente a 223.7 tokens/s/user. Esto compara la ejecución optimizada con 16 GB300 GPUs con el resultado anterior de vLLM con 8 GB300 GPUs.
AgentX reproduce los patrones de tráfico de las sesiones reales de agentes de codificación, incluyendo contextos largos, múltiples turnos de conversación, pausas de herramientas, subagentes paralelos y reutilización del almacenamiento KV-cache. Preserva estos patrones de carga de trabajo mientras reemplaza el contenido privado por texto sintético, probando el sistema de servicio bajo tráfico real de agentes. Metodología AgentX.
¿Qué sigue?
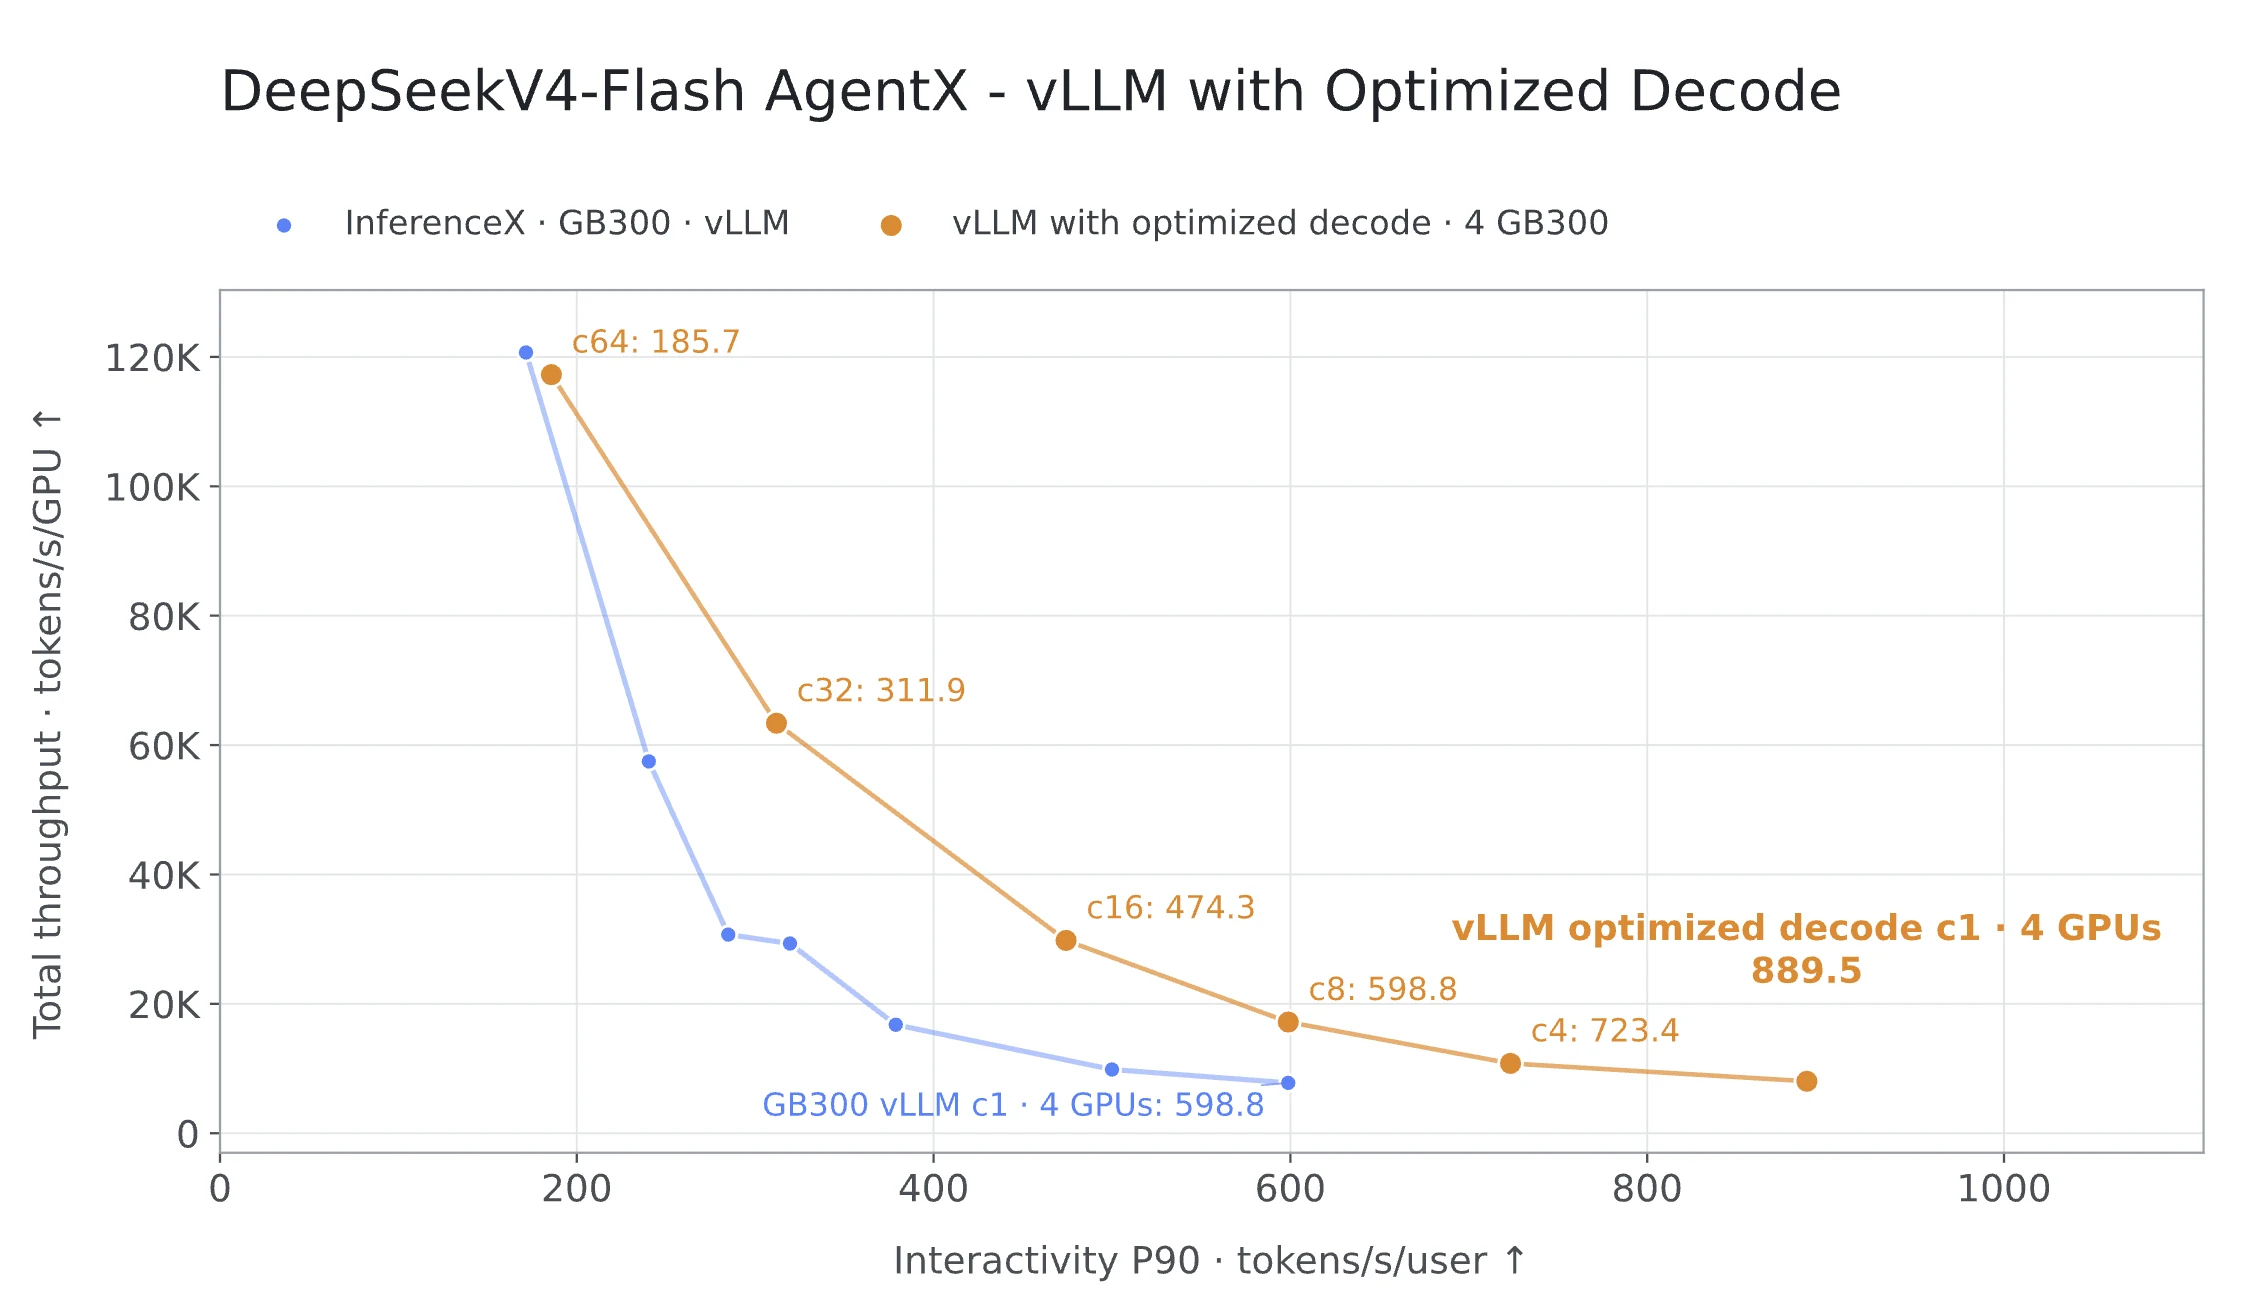
Para DeepSeek-V4.1-Flash, #61868 sigue los patrones de diseño K3: detrás del mismo interruptor opt-in decode_backend: latency_specialized, la implementación también soporta hasta 64 solicitudes concurrentes, un fallback sin interrupciones para los prefill y lotes mixtos, y decodificación especulativa. En lugar de perseguir un único punto caliente, ese executor divide los kernels y el trabajo del host: fusiona todo lo de reducción total + mHC en cada frontera de subcapa, reemplaza los kernels MoE y GEMMs de lote grande por kernels CuTe DSL diseñados para baja latencia, duplica y fragmenta el trabajo del indexador, y toma el trabajo por paso, que vLLM stock ejecuta eagermente en el CPU, y lo reproduce como un grafo CUDA.
En dos días después del lanzamiento de Muse Spark Open de Meta, nuestros primeros resultados ya superaron 950 tokens por segundo por usuario, con siete tokens de borrador (K=7) y una longitud de aceptación de seis (AL=6). Se están llevando a cabo más optimizaciones.
También estamos lanzando un mecanismo similar para optimizar la latencia de decodificación para GLM5.3 en escenarios de baja concurrencia. Compartiremos los detalles de la optimización y los resultados de rendimiento en una actualización posterior.
Para cada contribución, seguiremos enfocándonos en los beneficios concretos en cuanto a rendimiento, el soporte de las características de producción y las verificaciones de corrección y rendimiento reproducibles.
Agradecimientos
Queríamos agradecer a Rohan Varma (NVIDIA) y Alex Steiner (NVIDIA) por sus contribuciones en este trabajo.
También queremos agradecer a Woosuk Kwon (Inferact), y a Michael Goin y Lucas Wilkinson (Red Hat), por el refactore del modelo y los valiosos comentarios y apoyo.