
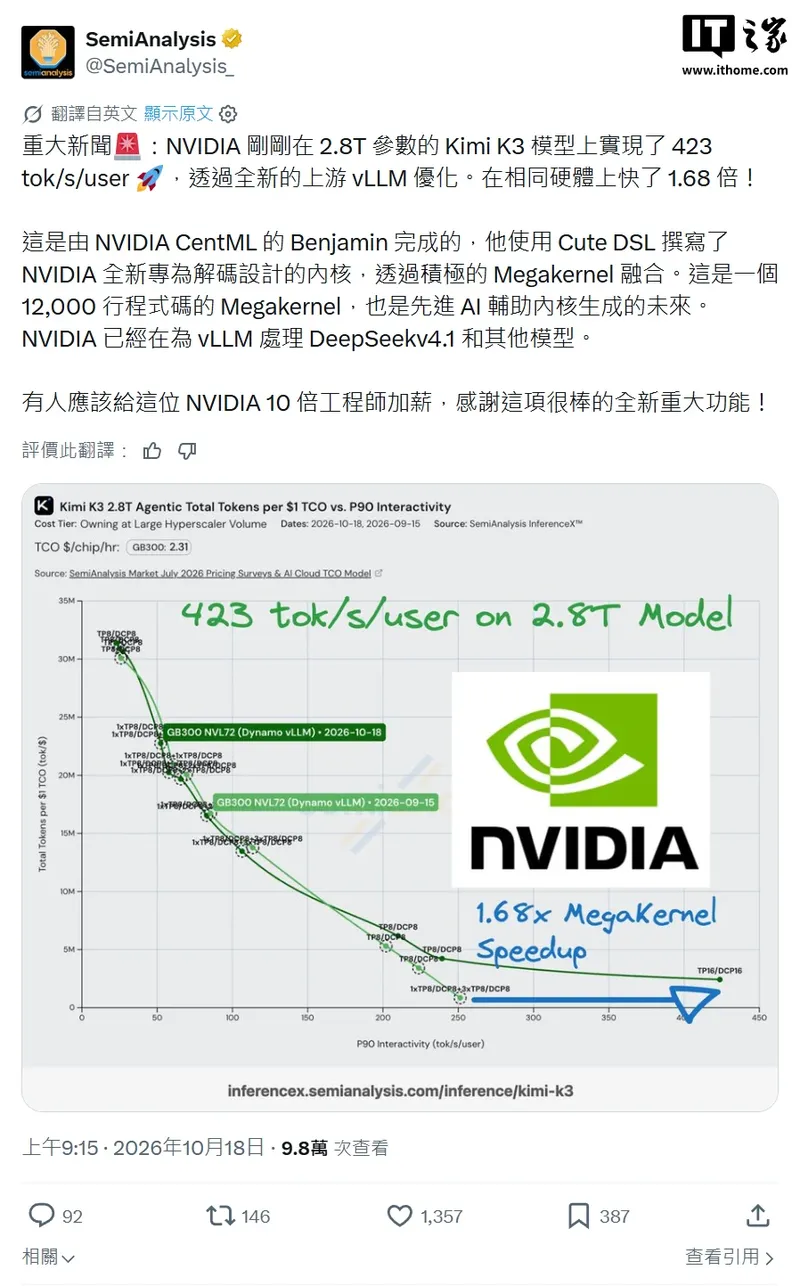
IT之家 18 de octubre: la firma de investigación SemiAnalysis publicó hoy un artículo afirmando que NVIDIA, mediante una optimización upstream en vLLM, logró que el modelo Kimi K3 de 2.8 billones de parámetros alcanzara una velocidad de inferencia de 423 tok/s/user (tokens por segundo por usuario),lo que supone una mejora de rendimiento de 1.68 veces en comparación con el mismo hardware (GB300 NVL72)。
Según el informe, esta optimización fue realizada por Benjamin, ingeniero de CentML de NVIDIA. Mediante una fusión a gran escala de Megakernel, se utilizó Cute DSL para escribir los nuevos kernels de decodificación dedicados que NVIDIA acaba de lanzar.Este Megakernel contiene 1.2 万 (es decir, 12,000) líneas de código, y representa la dirección futura de la generación de kernels de cómputo avanzados asistida por IA. NVIDIA optimiza la velocidad de inferencia del modelo Kimi K3, logrando una mejora de 1.68 veces.
IT之家 señaló que, además de esto, NVIDIA también está desarrollando optimizaciones para vLLM de otros modelos como DeepSeek V4.1.