
El 16 de octubre se celebró en Shenzhen la décima Cumbre CSDI Summit sobre Innovación Tecnológica Inteligente en Investigación y Desarrollo de Software de China. Xuan Shanming, vicepresidente y CTO de SenseTime Lattend, pronunció una ponencia principal titulada «Prácticas y tendencias de la infraestructura de IA en la era Agentic», en la que abordó temas como las tendencias de crecimiento de los Tokens en la era Agentic, la práctica de clústeres de inferencia heterogéneos y la exploración de nuevas tecnologías de infraestructura de IA, compartiendo la exploración técnica y la práctica de SenseTime Lattend en el campo de los servicios de inferencia a gran escala.
Xuan Shanming, vicepresidente y CTO de SenseTime Lattend
Xuan Shanming señaló que, a medida que las aplicaciones de IA evolucionan de los diálogos de preguntas y respuestas hacia la colaboración multiagente y la ejecución de tareas largas, la demanda de Tokens crece en órdenes de magnitud de mil veces, y la infraestructura de IA se enfrentaa una nueva situación en la que coexisten la explosión de la demanda y las restricciones en la oferta de capacidad de cómputo. En el futuro, la clave de la competencia del sector no será solo cuánta capacidad de cómputo se posee, sino cómo, mediante la innovación arquitectónica, la colaboración heterogénea y la programación de recursos, producir de forma continuaTokens de alta calidad con menor costo, mayor eficiencia y mayor estabilidad.
De la escala de cómputo a la capacidad de producción de Tokens, la infraestructura de IA enfrenta un cambio hacia la eficiencia
En comparación con las tradicionales conversaciones de preguntas y respuestas, la invocación de herramientas por un solo agente, la colaboración multiagente y las tareas largas de ejecución no supervisada implican más llamadas a modelos, más rondas de inferencia y más procesamiento de contexto, con un consumo de Tokens que crece en órdenes de magnitud de mil veces. Al mismo tiempo, problemas como el suministro limitado de chips de alta gama y el desajuste entre la capacidad de cómputo existente y los requisitos de recursos de las tareas de inferencia dificultan que la oferta de cómputo pueda expandirse al mismo ritmo. Según datos del sector, se prevé que en 2026 el gasto en inferencia representará el 55 % del gasto total en AI IaaS, y que en 2027 ascenderá al 59 %.
Al mismo tiempo, la demanda de Tokens varía notablemente según las aplicaciones. Las preguntas y respuestas básicas priorizan el costo unitario y la capacidad de concurrencia; escenarios como los agentes de oficina o la atención al cliente tienen requisitos más altos de latencia de respuesta y velocidad de generación, mientras que escenarios de alto valor como la exploración científica o la cuantificación financiera conceden mayor importancia a la exactitud de los resultados, la auditabilidad y la trazabilidad. Métricas como la latencia del primer Token (TTFT), la velocidad de generación (OTPS), la caché de contexto largo, la capacidad de concurrencia y la tasa de éxito de las llamadas determinan conjuntamente la calidad y el costo del servicio de Tokens.
Xuan Shanming afirmó: «Esto significa que la infraestructura de IA ya no puede depender de una única configuración de hardware para satisfacer todas las tareas, sino que debe organizar los recursos de cómputo de formajerarquizada y programarlos con precisión。según los requisitos de servicio de cada escenario. Pasar de la expansión de escala a la optimización de la eficiencia, y de la sustitución puntual de hardware a la colaboración heterogénease convierte en una dirección importante de desarrollo de la infraestructura de IA en la era Agentic».
Con la separación PD como núcleo, construir un clúster de inferencia heterogéneo de nivel de diez mil tarjetas
Ante la contradicción entre las restricciones del suministro de cómputo de alta gama y el crecimiento de la demanda de inferencia, SenseTime Lattend exploró una arquitectura de inferencia disociada,que mediante la separación PD y la programación híbrida heterogénea asigna a cada tipo de capacidad de cómputo las tareas para las que es más adecuado.
En el proceso de inferencia de los grandes modelos, el Prefill procesa los Tokens de entrada y presenta características de alta intensidad computacional; el Decode genera gradualmente los Tokens de salida y requiere leer continuamente la caché de contexto, por lo que exige un gran ancho de banda de memoria. La separación PD desacopla ambas fases: la capacidad de cómputo nacional adecuada se encarga de forma concentrada de las tareas de Prefill, las GPU de alta gama con gran ancho de banda asumen las tareas de Decode, y ambas etapas se conectan mediante la transmisión de KV Cache. Esta solución no consiste simplemente en combinar distintos chips, sino en reorganizar los recursos de cómputo en función de las características computacionales, el ancho de banda de memoria y los requisitos de las tareas. Así, la capacidad de cómputo nacional pasa de asumir tareas básicas de inferencia a participar en servicios de inferencia de nivel superior, mejorando la eficiencia general y la relación costo-beneficio del clúster híbrido, a la vez que satisface los requisitos de calidad de servicio de los distintos escenarios.
Con base en este enfoque, SenseTime Lattend ha desarrollado de forma continua prácticas de inferencia heterogénea en el AIDC de Lingang, construyendo un clúster de inferencia heterogéneo de nivel de diez mil tarjetas. Implementar esta arquitectura requiere resolver los problemas de interconexión entre capacidades de cómputo de distintas generaciones y tipos, integrando en un mismo clúster redes de diferentes especificaciones como 800G, 400G y 200G, para garantizar la transmisión eficiente de KV Cache entre los nodos de Prefill y los nodos de Decode.
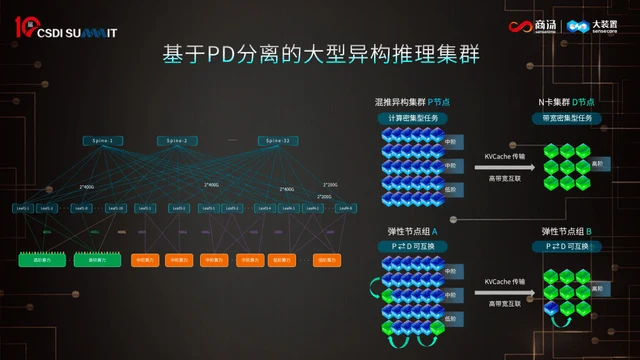
Sin embargo, a medida que el clúster crece en escala, los fallos de nodos y los recursos inactivos se convierten en nuevos desafíos de ingeniería. Por ejemplo, en algunas configuraciones heterogéneas pueden necesitarse entre 30 y 50 nodos de Prefill de gama media o baja para igualar la capacidad de procesamiento de un nodo de Decode. Si un nodo de Decode falla, muchos recursos de Prefill pueden quedar inactivos, afectando la eficiencia general del servicio.
Frente a ello, SenseTime Lattend aplicó dos métodos de optimización. Uno consiste en reservar una pequeña cantidad de capacidad de cómputo de alta gama en el grupo de recursos de Prefill, para poder reemplazar rápidamente con nodos de alta gama cuando un nodo de Decode falla; el otro consiste en dotar a los nodos del clúster de la capacidad de conmutación dinámica entre los roles de Prefill y Decode, ajustando de manera flexible la asignación de funciones según la carga y la presión de recursos en tiempo real, para lograr un flujo dinámico y una programación elástica de los recursos de cómputo. Con estos dos métodos, es posible reducir costos y, al mismo tiempo, garantizar que el clúster heterogéneo a gran escala produzca de forma continua y estable Tokens de alta calidad.
En torno a estas prácticas, SenseTime Lattend construyó además unsistema arquitectónico de seis capasque abarca las instalaciones de energía, la interconexión de recursos, el plano de datos KV, el runtime de inferencia, la programación de servicios y la capa de entrega, organizando el hardware heterogéneo como un sistema de servicios de inferencia unificado en su programación y de funcionamiento elástico.
Según Xuan Shanming, en una configuración de prueba específica, en comparación con el esquema de referencia y con la misma cantidad de tarjetas insignia de alta gama, mediante la inferencia heterogénea y la colaboración de recursos,el rendimiento total de Tokens puede multiplicarse por 5.
De la separación PD entre dominios a la separación AF, ampliando continuamente los límites de la arquitectura de inferencia
Sobre la base de la inferencia heterogénea a gran escala, SenseTime Lattend también exploradirecciones técnicas como la separación PD entre dominios y la separación AFpara liberar aún más el potencial sinérgico de los recursos de cómputo distribuidos.
La separación PD entre dominios (cross-domain) busca romper los límites de recursos de un único centro de datos. Xuan Shanming explicó que, tras lograr la separación PD en un único centro de datos, el siguiente paso a explorar es la separación PD entre dominios, para activar aún más los recursos de cómputo de diferentes regiones. SenseCore (大装置) de SenseTime colabora con gobiernos de todo el país y, mediante la colaboración entre dominios, puede asignar el Prefill a cómputo local de gama media-baja y transferir el KV Cache a clústeres de cómputo de gama alta en otras regiones para completar el Decode,logrando una orquestación de inferencia entre clústeres, entre salas de servidores e incluso entre regiones.
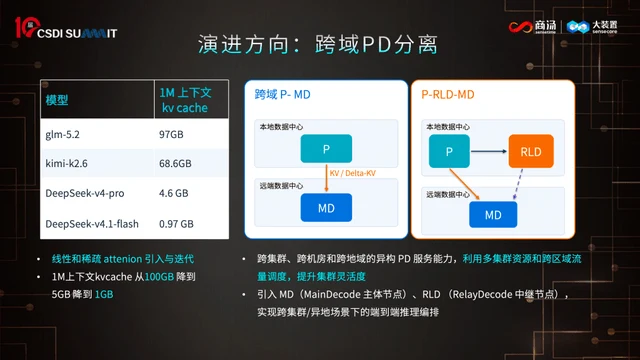
La viabilidad de esta dirección está estrechamente relacionada con la evolución de la arquitectura de los modelos: el tamaño del KV Cache de contexto de 1M ya se ha reducido de casi 100GB a aproximadamente 1GB en algunos modelos, disminuyendo enormemente la presión de la transmisión entre dominios. SenseCore también explora la introducción de nodos Decode principales (MD) y nodos Decode de retransmisión (RLD) para soportar la orquestación de inferencia en escenarios remotos; así, incluso si una región no cuenta con capacidades completas de cómputo de gama alta, puede integrar recursos de cómputo de distintas escalas y rendimientos, impulsando que la red de cómputo integrada pase de la conexión de recursos a la colaboración de tareas, y ofreciendo un servicio de Tokens de mayor rendimiento y mejor calidad.
La separación AF desacopla aún más las diferentes tareas de cómputo durante el proceso de inferencia. En la fase de Decode, la Atención (Attention) se encarga principalmente de procesar el contexto y extraer información clave, con altos requisitos de capacidad y ancho de banda de memoria de vídeo; la FFN realiza una gran cantidad de multiplicaciones de matrices y exige mayor capacidad de cómputo. La arquitectura tradicional vincula ambas en el mismo conjunto de recursos GPU, lo que puede provocar disputas por los recursos. La separación AF despliega la Atención y la FFN en el hardware más adecuado para las características de cada tarea, logrando escalado independiente y optimización de recursos.
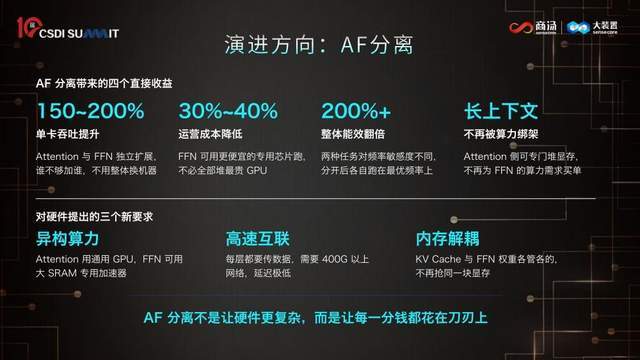
En el futuro, se espera que la separación AF aporte un aumento del 150% al 200% en el rendimiento por tarjeta, una reducción del 30% al 40% en los costos operativos y una mejora de la eficiencia energética global a más del doble. Las ganancias correspondientes aún dependen de la arquitectura específica del modelo, la configuración de hardware y la implementación del sistema, pero su enfoque técnico es el mismo: identificar continuamente los cuellos de botella de rendimiento en el proceso de inferencia y, mediante una división de tareas y una asignación de recursos más finas, mejorar la eficiencia global del sistema.
Desde la separación PD a la separación PD entre dominios, y hasta la separación AF, la continua evolución de las arquitecturas de inferencia promete liberar aún más las ventajas de rendimiento y costo de la infraestructura de inferencia.
Del arte del ajuste de parámetros a la ingeniería de sistemas: medir el valor de la inferencia con SLA y costos
Xuan Shanming considera que la optimización de la infraestructura de inferencia debe volver a dos indicadores centrales: primero, la calidad del servicio de extremo a extremo, es decir, si el sistema puede cumplir con la velocidad de respuesta, la eficiencia de generación, la capacidad de concurrencia y la tasa de éxito de las llamadas acordadas; segundo, el costo, es decir, cuántos Tokens efectivos puede producir cada unidad de inversión bajo el requisito de cumplir dicha calidad de servicio.
Esto también plantea exigencias más altas a la infraestructura. El cómputo nacional, el cómputo avanzado y los diferentes modelos requieren una adaptación continua, y la rápida iteración de modelos y aplicaciones incrementa aún más la complejidad de la optimización. Solo incorporando la configuración de hardware, las características del modelo, las necesidades de las tareas y las estrategias de programación en un sistema unificado se puede seguir encontrando soluciones mejores en combinaciones multidimensionales.
Actualmente, SenseCore (la gran infraestructura de SenseTime) está mejorando su capacidad de servicio de inferencia a gran escala mediante el modelo de fábrica de Tokens. El volumen diario de servicio de Tokens de la plataforma SenseCore ya ha alcanzado los 6 billones, y se prevé que la escala de servicio de Tokens de todo el año 2026 crezca 25 veces, alcanzando en el cuarto trimestre una escala de 10 billones de Tokens diarios.
Xuan Shanming afirmó que, en la era Agentic, lo escaso no son los chips, sinola capacidad sistémica de producir Tokens de forma estable, a bajo costo y con alto nivel de manera continua, lo que abarca un sistema completo de eficiencia del sistema, innovación arquitectónica y capacidad de entrega industrial. Desde la práctica técnica hasta la entrega de negocio, SenseCore espera impulsar que la infraestructura de inferencia pase de ser un proceso de ajuste de parámetros basado en la experiencia auna ingeniería de sistemas medible, optimizable y verificable, de modo que la inversión en cómputo se convierta finalmente en una capacidad estable de producción de servicios de Tokens.
Este artículo fue proporcionado por SenseTime y quantumbit (量子位) está autorizado a reproducirlo; los puntos de vista pertenecen al autor original.