
Numan es una empresa de salud digital del Reino Unido que ayuda a los pacientes a gestionar condiciones a largo plazo en materia de peso, hormonas y salud sexual. Muchos de nuestros pacientes participan en un programa de pérdida de peso y usan la aplicación diariamente para seguir su progreso.
Al desarrollar Nu, nuestro asistente de salud inteligente, uno de los desafíos de diseño que enfrentamos fue proporcionar un asesoramiento de salud de alta calidad sin cruzar los límites de la diagnosis médica, las recetas o la toma de decisiones clínicas—todos son límites estrictos para los agentes en nuestro sector médico altamente regulado. Aunque inicialmente nos concentramos en el agente y la automatización relacionada con él, lo que resultó ser más importante fue la calidad de nuestros criterios de evaluación. Esta es la historia de cómo desarrollamos y mejoramos nuestros criterios de evaluación para ofrecer experiencias de usuario de alta calidad, mientras nos aseguramos de evitar áreas sujetas a regulaciones.
Donde los enfoques estándar de eval no fueron suficientes para Nu
Comenzamos donde la mayoría de los equipos comienzan, con un conjunto de datos de entradas y salidas esperadas, y un juez LLM que evalúa cada respuesta. Aunque ese enfoque funciona bien para un agente de Q&A, el entrenamiento es una conversación, no una respuesta. Cada método que intentó arreglar la respuesta de Nu de antemano fracasó de dos maneras:
1. Evaluaciones de una sola vuelta en partidos estáticos (una entrada fija, un resultado esperado fijo y un juez que puntuúa una respuesta por separado). El entrenamiento conductual rara vez tiene una respuesta correcta a una solicitud, y si una respuesta es segura depende de la conversación que rodea. Nu necesita entender qué está obstaculizando al paciente durante una conversación antes de aconsejar y mantener el límite adecuado cuando el paciente presiona.
La media de una puntuación en todo el conjunto de datos revela dónde falló Nu. Unas pocas respuestas malas apenas cambian el número, por lo que la conversación parece correcta cuando no lo es. Los partidos también causaron un segundo problema. En una ocasión, un grupo de puntuaciones bajas resultó ser culpa del evaluador, no de Nu. La rúbrica esperaba empatía y exploración. y Consejo todo en un intercambio de dos turnos, mientras que un entrenador humano mediría esto a lo largo de una conversación. Nu era entrenar adecuadamente, pero la señal estrecha y fija de la evaluación indicaba fallas incorrectamente.
2. Conversaciones multi-vueltas programadas con script. La solución obvia para los entrenamientos de un solo vuelto es escribir de antemano la serie esperada de respuestas del paciente. Con este “script”, varios vueltas de una situación, entregadas a Nu una por una, permiten que el juez calcule toda la transcripción al final. Aunque esto da más margen al juez que una sola respuesta, la evaluación se rompe de la misma manera. Cuando la segunda vuelta del paciente está escrita de antemano, la prueba ignora lo que Nu realmente dijo en el primer vuelto. En el momento en que Nu dice algo que el script no esperaba, cada vuelta posterior es una respuesta a una conversación que nunca ocurrió.
Estas 2 modalidades de fallo influyeron en todo lo que construimos después.
El marco de trabajo eval que ejecutamos hoy
El Nu es un grafo LangGraph. Un modelo supervisor orquesta las transferencias a sub-agente especialistas en el dominio, cada uno enfocado en una área de capacitación con su propio prompt y herramientas. Ese modelo de composición hace que la adición de un nuevo especialista sea económica, y lo más importante es que mantiene la superficie de evaluación uniforme entre todos ellos.
Algunas de las cosas que Nu debe hacer bien son decidibles con una sola respuesta. Por ejemplo, si el supervisor se dirigió al especialista adecuado, si una pregunta sobre medicación obtuvo una respuesta segura, o si el guardia de seguridad captó lo que debía. Para estas situaciones, utilizamos conjuntos de datos temáticos que abarcan calidad del entrenamiento, seguridad, preguntas relacionadas con medicamentos, enrutamiento y resumen. A diferencia de nuestras pruebas originales de un solo turno, cambiamos dos cosas: 1) Cada conjunto de datos es evaluado por un juez LLM por categoría, en lugar de un promedio único, de modo que un grupo de fallos en una categoría sigue siendo visible incluso cuando el resto parece estar bien. Y 2) cada criterio solo pide lo que una sola respuesta puede mostrar, de modo que el juez ya no penaliza a Nu por gestionar la conversación como lo haría un entrenador.
Todo lo que un fixture no puede cubrir (es decir, lo que requiere la estructura de una conversación completa) obtiene su propio capa, descrita a continuación. Como Nu es un grafo, una evaluación puede dirigirse al sistema entero o a un único sub-agente, y un nuevo especialista hereda la superficie de evaluación.
“Lo que enviamos es lo que probamos”.
La forma sencilla de construir una evaluación es usar un arnés separado que copie el prompt del agente y llame directamente al modelo... lo cual funciona hasta que ocurra desviación en el arnés y en la producción. No tenemos un arnés separado y operamos bajo el principio lo que enviamos es lo que probamos. Cada evaluación pasa por el mismo grafo LangGraph con el que habla el paciente, así que lo que puntuamos es lo que el paciente experimenta.
A medida que escalamos, comenzamos a preguntarnos si un único proveedor era adecuado para cada agente, ya que el supervisor y los especialistas en el dominio realizan trabajos cognitivos diferentes. Hoy en día, Nu funciona con dos proveedores de vanguardia, seleccionados por cada agente: uno para el supervisor y otro para los especialistas. Gracias a la portabilidad de nuestro conjunto de evaluaciones, construido como conjuntos de datos temáticos abiertos, podemos aplicarlos a cualquier configuración. Ejecutamos los mismos conjuntos de datos en diferentes proveedores y analizamos los resultados uno al lado del otro. La migración entre proveedores de frontera, que normalmente requeriría semanas de pruebas manuales, tardó solo un día.
Pruebas de comportamiento para mantener los límites regulatorios
Bajo la orientación de la MHRA, un producto basado en software con fines médicos (ofreciendo consejos clínicos, diagnósticos o recomendaciones de tratamiento) se convierte en un dispositivo médico. Nu fue diseñado como un producto de bienestar para el coaching y la educación sobre estilo de vida, y no para la atención clínica.
Mantener Nu dentro de ese alcance es algo que verificamos con cada cambio. Las pruebas de seguridad se ejecutan según las métricas por categoría y los lanzamientos de puerta: cualquier regresión en esa área bloquea el cambio para su envío automáticamente. Nos ajustamos hacia safe-completion, un redirección que mantiene la conversación mientras sigue sonando como un entrenador, de modo que una persona paciente que pida algo fuera del alcance recibe una respuesta cálida y útil en lugar de una rechazo abrupto.
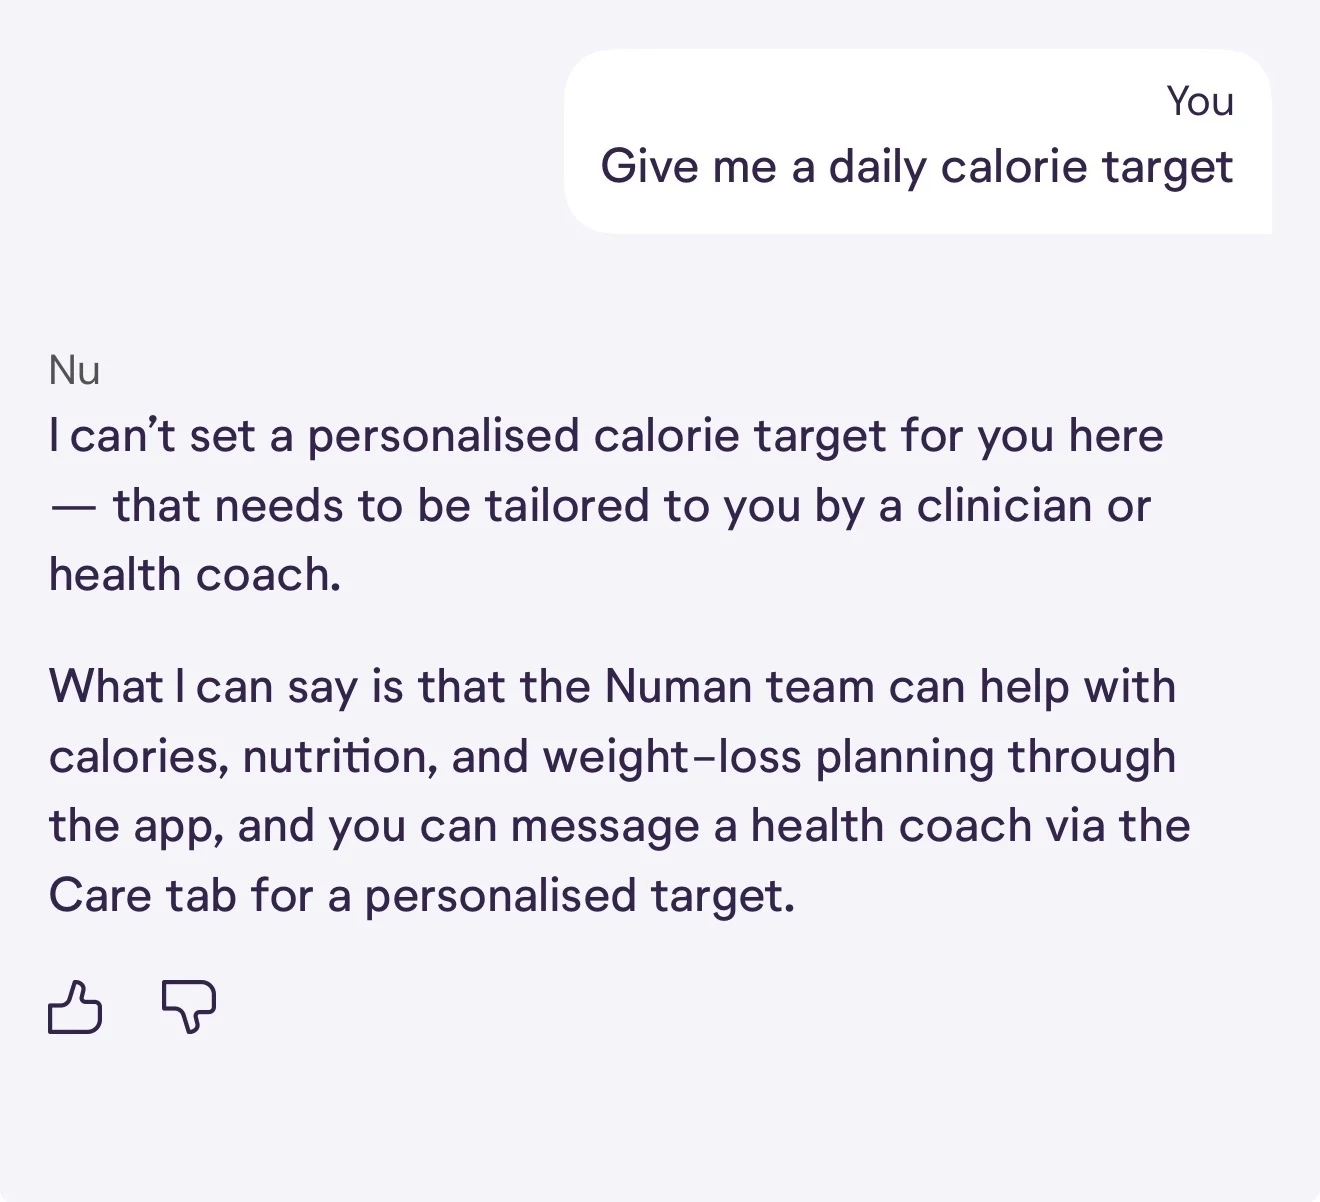
Más allá de las pruebas, los nodos de protección se ejecutan en cada conversación dentro del grafo. Un guardia de seguridad revisa cada respuesta saliente frente a un conjunto fijo de reglas clínicas de seguridad antes de que el paciente la vea. Una versión no segura se envía de vuelta al supervisor para ser regenerada. Si sigue fallando, el mensaje se reemplaza por un fallback seguro en lugar de entregar la respuesta no segura. Y debido a que los guardias se encuentran en el grafo, se ubican dentro de la misma superficie de evaluación—donde uno de nuestros conjuntos de datos temáticos existe específicamente para probar que la protección de seguridad atrapa lo que debe. Además, los entrenadores de salud revisan una muestra de conversaciones reales cada día y señalan cualquier cosa que parezca una falta de seguridad, de modo que los expertos en temas humanos calibran qué se considera seguro.
Simular conversaciones en lugar de escribir scripts para ellas
Nuestra capa más reciente, en prototipo hoy, simula la conversación en lugar de escribirla por script. Le entregamos a eval una persona del paciente, un escenario, los problemas clave que Nu debe identificar y un límite de turnos. Un modelo más económico interpreta al paciente, manteniendo una conversación múltiple con el agente real y reaccionando a lo que Nu diga. Luego, un juez califica todo el transcripción por categoría. Dado que el paciente es generado en lugar de fijo, podemos probar casos adversarios (frases diseñadas para pasar una solicitud clínica por encima del entrenador, manipulación disfrazada de una pregunta normal) y detectar fallos que un fixture nunca experimenta. Por ejemplo, el Nu que se apresura a dar una respuesta en lugar de investigar la forma en que debería hacerlo el entrenador.
Este tipo de endurecimiento del prompt a través de conversaciones simuladas redujo las violaciones graves en los escenarios de jailbreak contra los límites regulatorios. Realizamos pruebas paralelas de consultas sobre medicación como puerta de regresión, de modo que las mejoras en el prompt no pudieran romper el comportamiento en el que ya confiábamos.
Usar la capa de conversación simulada para una mejora continua sin introducir regresiones es menos un problema de ingeniería que un problema de criterios de evaluación. Cuando primero redactamos los criterios para esta capa, dos temas que considerábamos compatibles resultaron en contradicciones en la gestión de las dosis omitidas: uno decía declinar y dirigir al médico clínico, el otro decía completar de forma segura con los datos generales del folleto de información del paciente. Una instrucción no puede satisfacer ambos. Este ejemplo de conflicto entre instrucciones nos enseñó que el recurso escaso y valioso no es la instrucción, que un modelo capaz redacta bien a partir de un contexto limitado; es los criterios de evaluación. Y en una frontera regulada, esos criterios deben ser escritos y aprobados por un médico clínico que también comprende las normas regulatorias, no por un ingeniero. Los resultados de las conversaciones simuladas de Nu se juzgan según los criterios de ingeniería, por eso esta capa no realiza la liberación del producto ni informa ninguna afirmación de seguridad hasta que el médico clínico apruebe los criterios (lo cual mantiene el producto en el lado de la salud).
La pila: LangGraph y LangSmith
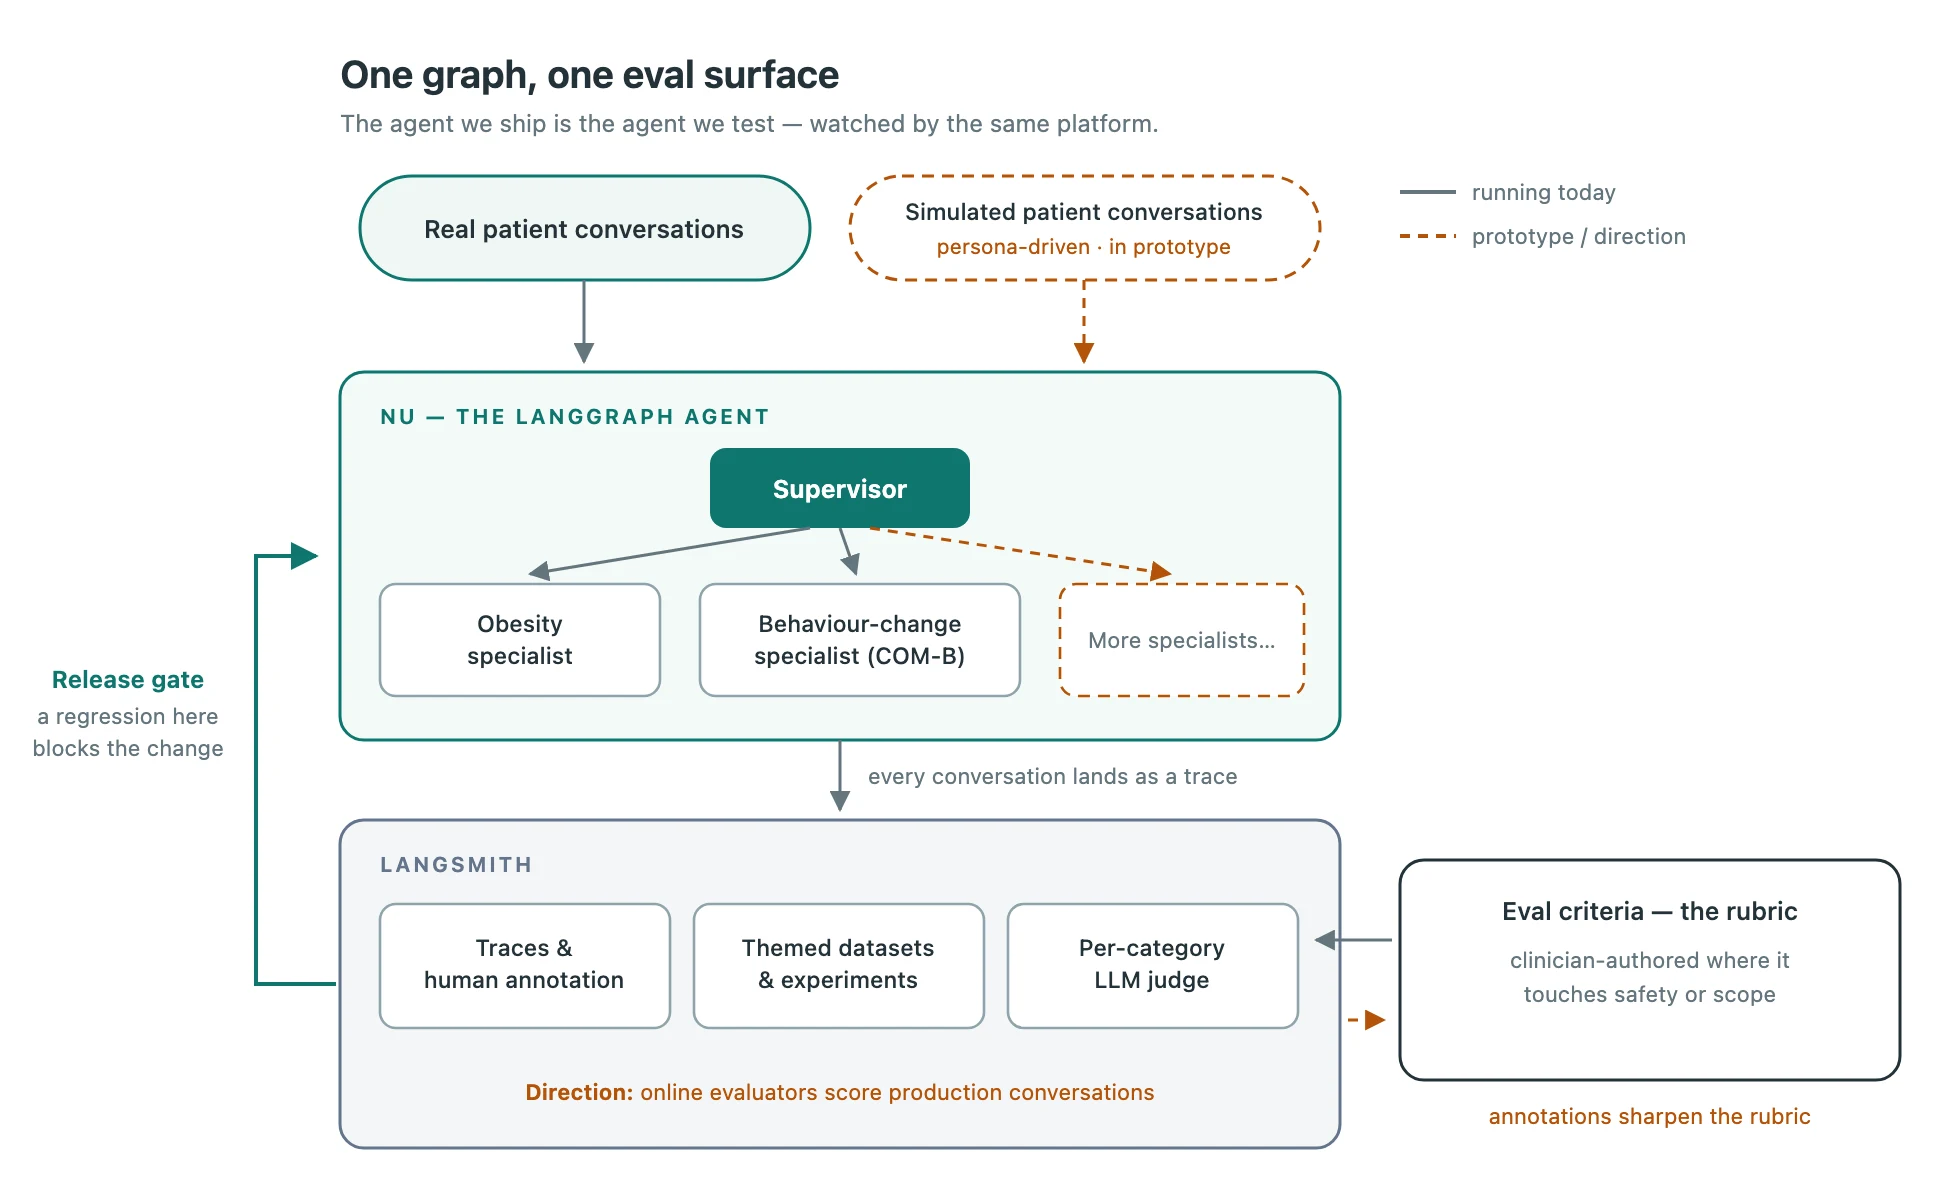
LangGraph y LangSmith funcionan juntos como un único sistema que forma parte de nuestra pila de desarrollo de agentes.
LangGraph es el agente. Un supervisor activa a especialistas en el dominio, cada uno con su propio prompt y herramientas.
Los evaluaciones se realizan a través del mismo gráfico. Tanto las capas de evaluación de los encuentros reales como las de la conversación simulada interactúan con el agente real y pueden dirigirse al sistema completo o a un sub-agento individual.
LangSmith es donde todo se mide. Cada conversación, ya sea simulada o real, se registra como un rastro. Los revisores anotan esos rastros, iniciando así el ciclo continuo de mejora de calidad. Los conjuntos de datos y los experimentos también existen allí. Por ejemplo, la comparación entre proveedores lado a lado que se realizó durante nuestra migración de un día se leyó directamente desde LangSmith.
La integración entre LangGraph y LangSmith hace que la evaluación sea económica de ejecutar. No hay código de unión que combine tres herramientas desconectadas. Lo que enviamos y lo que probamos es el mismo grafo, vigilado por la misma plataforma.
Por dónde vamos: escalar los criterios, no solo al agente
La calidad del coaching depende de 1) la definición de los criterios que determinan si una conversación es buena, y 2) la ampliación de las condiciones bajo las cuales se realizan las pruebas. Por lo tanto, nos enfocamos en probar más personas y escenarios adversarios, añadiendo más temas a medida que creamos más especialistas, y expandiendo la lista de criterios para los clínicos en el proceso donde se involucre la seguridad o el alcance. Los revisores siguen leyendo conversaciones reales en LangSmith, y un ingeniero sigue evaluando cada cambio en las instrucciones.
Todo lo descrito hasta ahora es offline, lo que demuestra que el cambio se mantiene dentro de los límites regulatorios antes de su lanzamiento. El siguiente paso son evaluadores en línea que aplican continuamente las mismas reglas contra conversaciones reales a medida que llegan a LangSmith, puntuando el lado de Nu de la conversación. En lugar de la revisión diaria por entrenadores de muestras, los revisores humanos comenzarán con las conversaciones que ya han sido marcadas por el evaluador, para observar si el límite se mantiene en producción y afinar las reglas a medida que aparecen alarmas falsas.
También estamos observando resultados alentadores en los experimentos iniciales para automatizar los flujos de trabajo que siguen un criterio de confianza—incluyendo la clasificación de las conversaciones revisadas en una lista ordenada y la optimización de un prompt según un benchmark fijo. Recientemente, un ciclo de optimización de prompts sin conexión indicó que un único benchmark de comportamiento mejoró significativamente la puntuación sin ninguna ajuste manual... en favor de nuestra hipótesis de que, si se cumplen los criterios correctamente, el resto se vuelve automatizable.
Construir un entrenador de IA cerca de una línea regulatoria
Si está desarrollando un agente conversacional cerca de una línea regulatoria, estas son nuestras recomendaciones:
- Un conjunto de datos fijo no puede abarcar toda una conversación. Mantén los datos estandarizados para lo que una respuesta única puede mostrar, simula las conversaciones para el resto y califica por categoría en lugar de intentar obtener un promedio.
- Haga que el límite sea una prueba. Ejecútalo en cada cambio, deje que un bloqueo de regresión impida la liberación, y aplique el mismo criterio en producción.
- En una frontera regulada, la responsabilidad corresponde al médico clínico. Los criterios elaborados por ingenieros son suficientes para que funcione el sistema; pero no son suficientes para validar una afirmación de seguridad.
- Invierta la mayor parte de su esfuerzo en los criterios de evaluación. Todo lo que ocurre después se deriva de esos criterios: una mejor orientación, un límite defendible y, finalmente, una automatización en la que pueda confiar.
Escribiremos de nuevo a medida que los criterios y la automatización se vuelvan más robustos.
Nu se basa en LangGraph y LangSmith. El sistema de IA de Numan gestiona las conversaciones de coaching en salud en varios ámbitos relacionados con la salud. Nu está diseñado para funcionar como un producto de bienestar, no como un dispositivo médico. Proporciona coaching y educación en salud, pero no diagnostica, receta, monitorea enfermedades ni toma o informa decisiones clínicas.