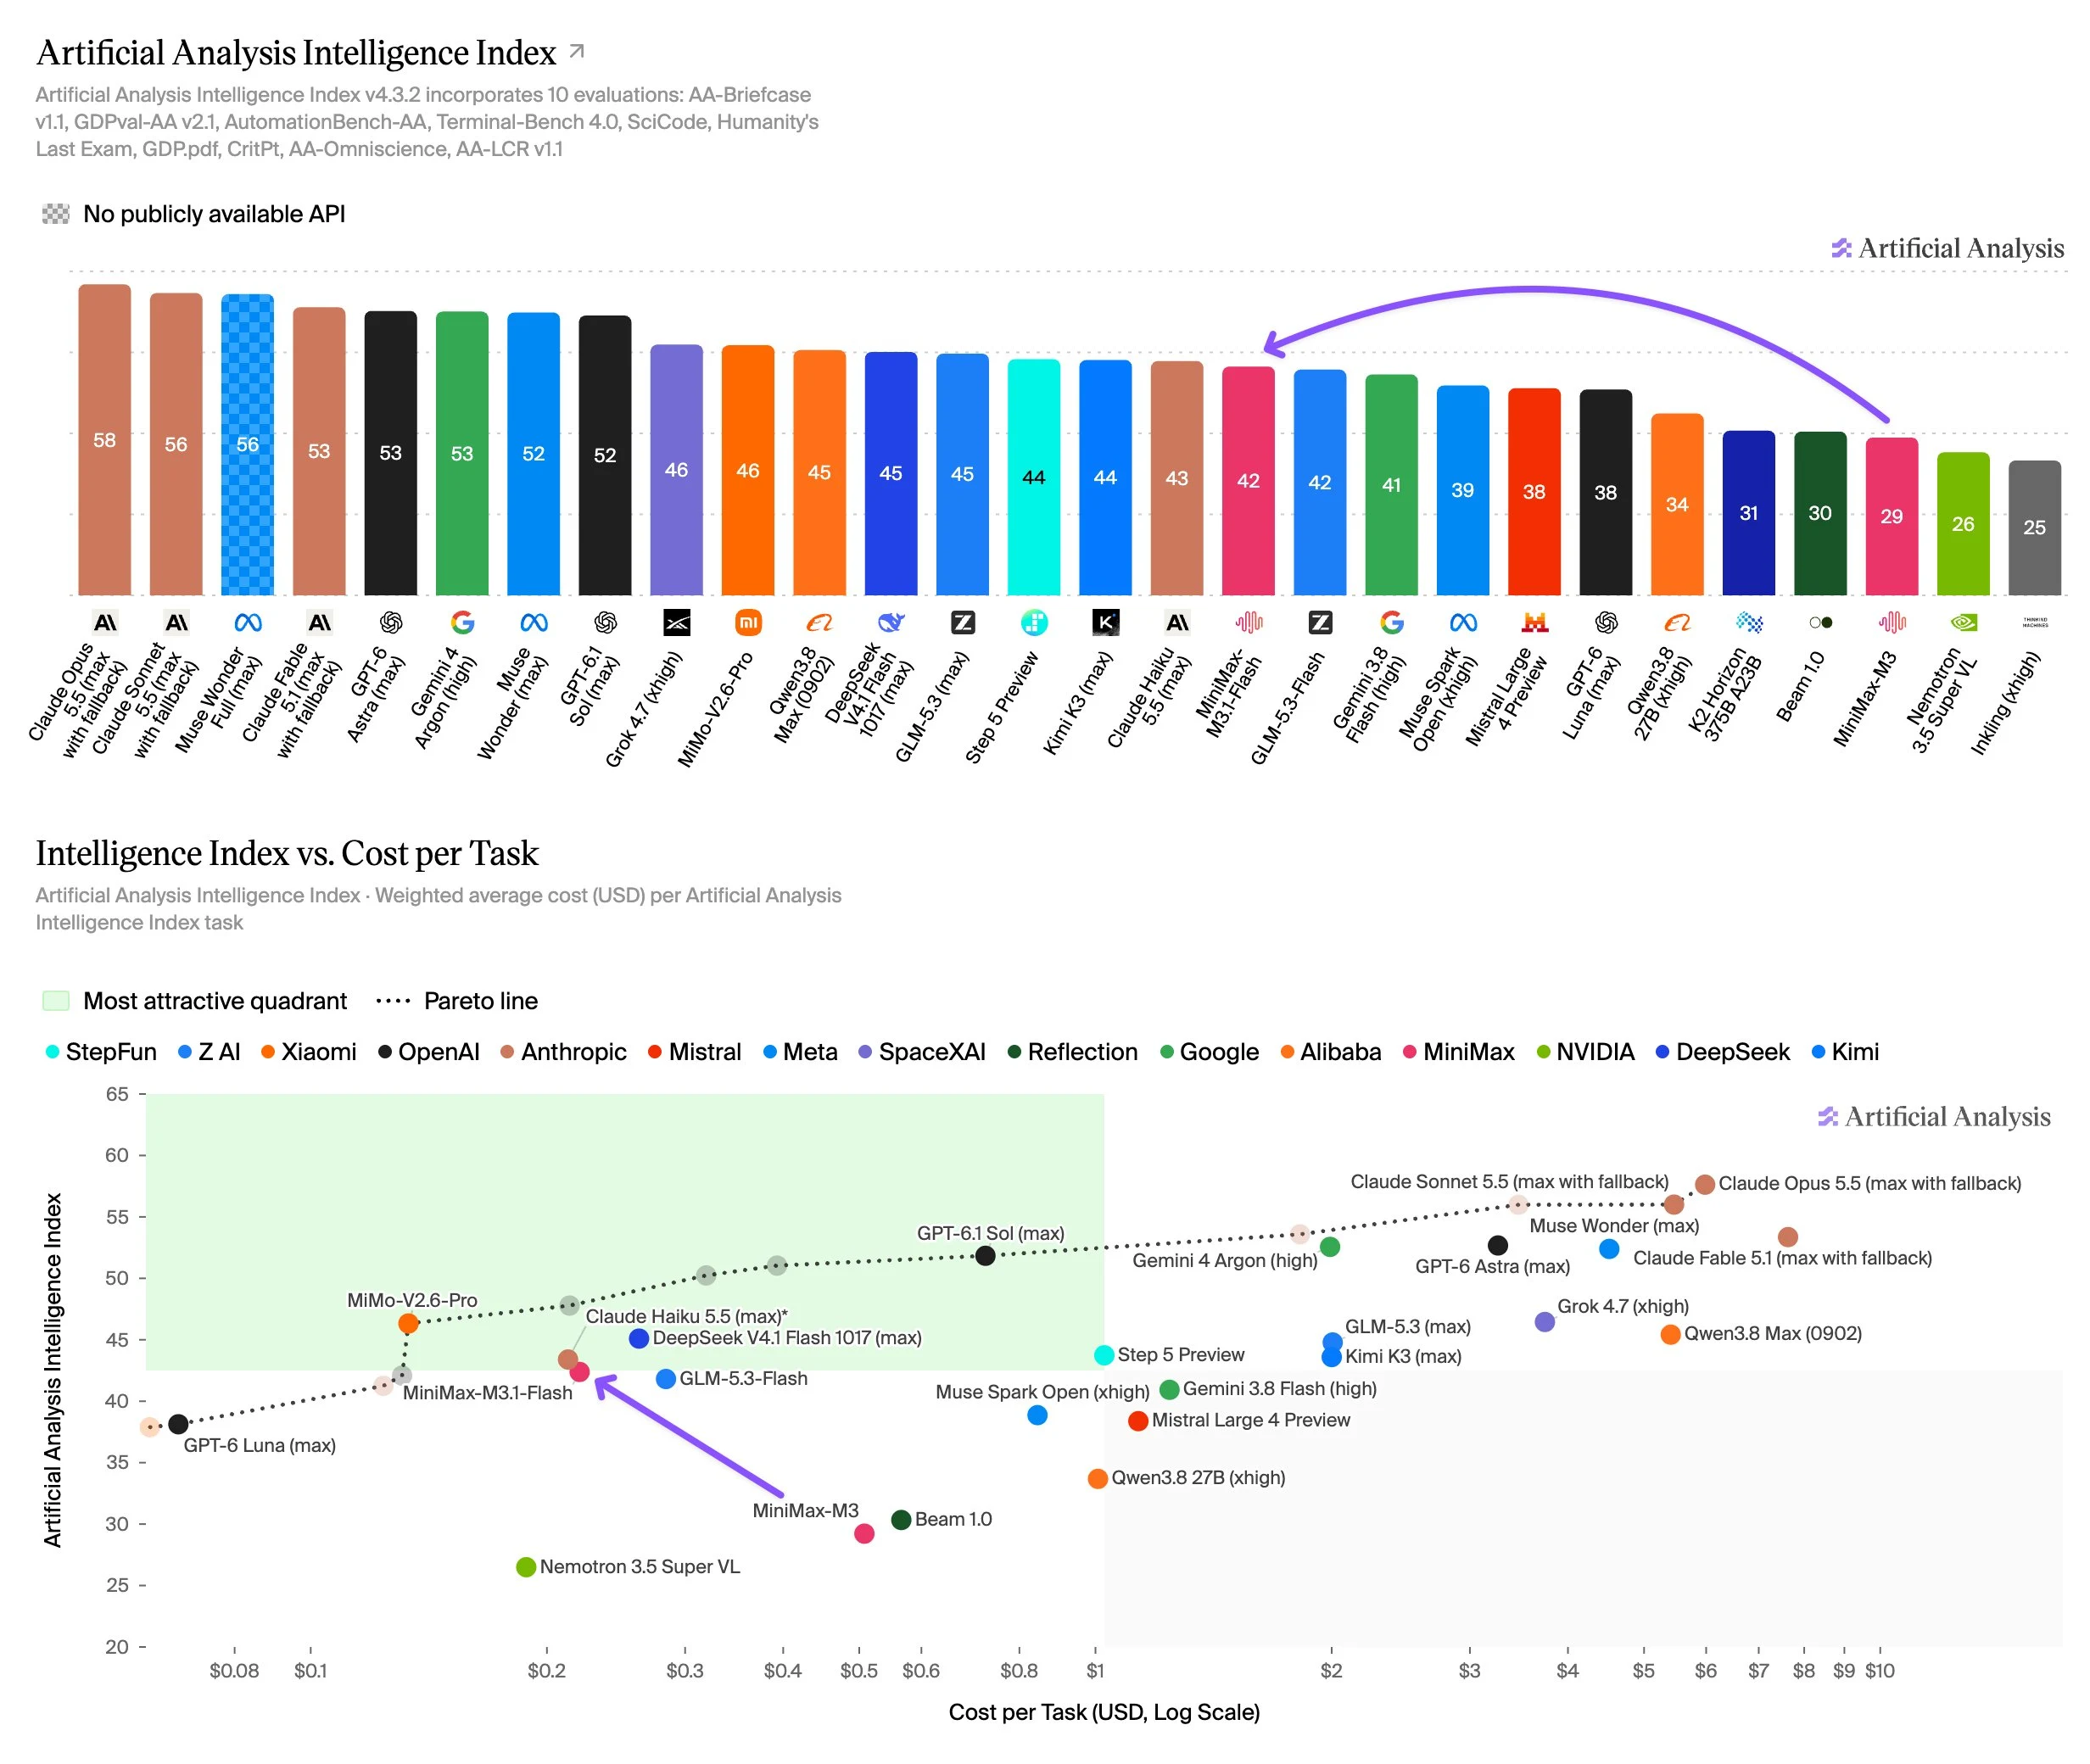
MiniMax-M3.1-Flash obtiene 42 en el Artificial Analysis Intelligence Index, 13 puntos más que MiniMax-M3 y a menos de la mitad del costo por tarea. Empata con GLM-5.3-Flash pero queda detrás de DeepSeek V4.1 Flash 1017
MiniMax-M3.1-Flash es el nuevo modelo de razonamiento Flash de @MiniMax_AI, que evaluamos en su configuración de máximo esfuerzo. Obtiene 42 en el Artificial Analysis Intelligence Index, empatado con GLM-5.3-Flash (max, 42), apenas por delante de Gemini 3.8 Flash (high, 41) y detrás de DeepSeek V4.1 Flash 1017 (max, 45)
Conclusiones clave:
➤ El razonamiento complejo mejoró sustancialmente en comparación con M3: MiniMax-M3.1-Flash obtiene 48% en Humanity's Last Exam, por delante de GLM-5.3-Flash (max, 40%) y DeepSeek V4.1 Flash 1017 (max, 43%), y empatado con Gemini 3.8 Flash (high, 48%). En CritPt obtiene 22%, por delante de GLM-5.3-Flash (15%) y Gemini 3.8 Flash (18%) y apenas detrás de DeepSeek V4.1 Flash 1017 (24%). Estas cifras superan a las de MiniMax-M3, que obtuvo 39% y 4% respectivamente
➤ Menos tokens de salida, menor costo por tarea: MiniMax-M3.1-Flash usó ~189M de tokens de salida para ejecutar el Intelligence Index, considerablemente menos que GLM-5.3-Flash (max, ~324M), DeepSeek V4.1 Flash 1017 (max, ~224M) y Gemini 3.8 Flash (high, ~334M). Combinado con precios de $0.15/$0.60 por 1M de tokens de entrada/salida, esto lleva su costo a ~$0.22 por tarea del Intelligence Index, frente a ~$0.28 para GLM-5.3-Flash, ~$0.26 para DeepSeek V4.1 Flash 1017 y ~$1.24 para Gemini 3.8 Flash, y menos de la mitad del ~$0.51 de MiniMax-M3
➤ Alta precisión en AA-Omniscience, compensada por una alta tasa de alucinación: MiniMax-M3.1-Flash responde correctamente al 56% de las preguntas en AA-Omniscience, nuestro benchmark que mide el recuerdo factual y la alucinación, frente al 28% de GLM-5.3-Flash (max) y el 43% de DeepSeek V4.1 Flash 1017 (max). Intenta casi todas las preguntas, lo que resulta en una tasa de alucinación del 93% y una puntuación general de 16 en AA-Omniscience
Detalles clave del modelo:
➤ Ventana de contexto: 1M de tokens
➤ Multimodalidad: entrada de texto e imagen, salida de texto
➤ Precios: $0.15/$0.60 por 1M de tokens de entrada/salida, con entrada en caché a $0.015/M
➤ Disponibilidad: API de primera parte de MiniMax, con MiniMax anunciando un lanzamiento de pesos abiertos el 23 de octubre
➤ Licenciamiento: pesos cerrados actualmente, con MiniMax anunciando un lanzamiento de pesos el 23 de octubre