
vLLM es un motor de inferencia y servicio de código abierto para modelos de lenguaje grandes (LLMs). La inferencia de LLMs tiene dos fases distintas: prefill, que procesa el prompt de entrada y construye la caché de clave-valor (KV), y decode, que utiliza esa caché para generar salida token por token. Estas fases tienen características diferentes en cuanto a computación, memoria y escalabilidad. Desagregación prefill-decode (P-D) las ejecuta en instancias separadas del motor, permitiendo que cada fase se scale y se optimice de forma independiente. Esto puede mejorar la utilización de recursos, el rendimiento y la latencia bajo carga. Sin embargo, también requiere transferir la caché de KV de la instancia de prefill a la instancia de decode antes de que pueda comenzar la generación de tokens, lo que hace que la transferencia eficiente de KV sea crítica para el tiempo hasta primer token (TTFT).
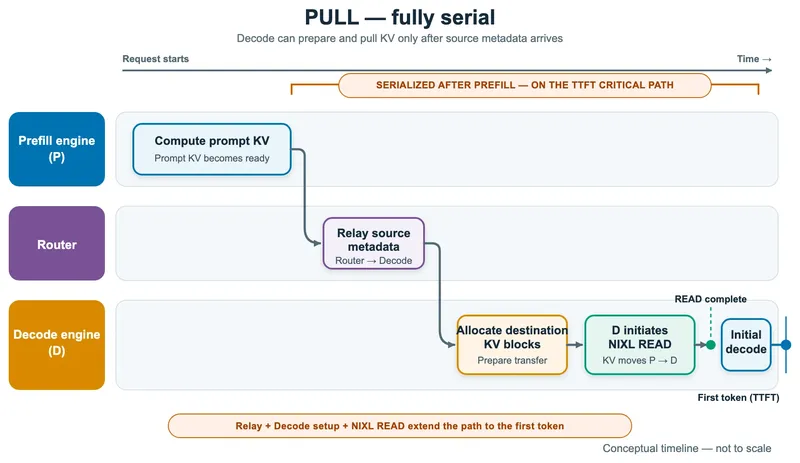
Una de las formas en que vLLM realiza esta transferencia es a través de la Biblioteca NVIDIA Inference Xfer (NIXL) connector, que transmite los bloques KV a través de interconexiones que soportan Acceso Direct a Memoria Remota (RDMA), como el AWS Elastic Fabric Adapter (AWS EFA, la red RDMA de baja latencia utilizada entre servidores en AWS). En tipos de instancias soportadas, el AWS EFA soporta GPUDirect RDMA y Neuron Direct RDMA. Por lo tanto, NIXL puede transferir los bloques KV directamente entre GPU o AWS Trainium sin pasar por la memoria del host. El modo predeterminado para el connector NIXL es pull-based: Después de que la instancia de prefill termine de calcular la caché de KV del prompt, el router transmite los metadatos de origen, incluyendo los IDs de los bloques de prefill, a la instancia de decodificación. La instancia de decodificación luego asigna los bloques de destino, prepara la transferencia NIXL y inicia una solicitud NIXL READ para extraer los bloques KV de la instancia de prefill. Dado que estos pasos de coordinación y configuración ocurren secuencialmente después de la prefill y antes de que comience el decodificación, prolongan el camino crítico TTFT, como se muestra en el siguiente cronograma.
Figura 1: Cronograma de transferencia de KV en modo pull, donde la retransmisión del enrutador, la asignación en el lado de decodificación y NIXL READ se ejecutan de forma serial en el camino hacia el primer token
Este artículo introduce un conector NIXL basado en push que elimina la coordinación y configuración de transferencias posteriores al prellenado del camino crítico. Si utiliza inferencia de prellenado/decodificación desagregada con vLLM, el modo push puede mejorar la capacidad de respuesta de la aplicación al reducir TTFT y TPOT, especialmente a altas tasas de solicitud.
En nuestro benchmark, con una implementación 1P1D utilizando instancias P5en de Amazon Elastic Compute Cloud (Amazon EC2) conectadas a EFA, el modo push proporcionó hasta 3 veces mejor TTFT y hasta un 30 por ciento mejor tiempo-por-token-de-salida (TPOT) en comparación con el modo pull (ver sección de datos de rendimiento) para el modelo Qwen3-32B. Los resultados dependen del carga de trabajo y la configuración.
Construimos y validamos la función en clústeres de instancias AWS Trainium conectados a EFA, y luego la contribuimos a vLLM como una función independiente del acelerador. Los resultados obtenidos provienen de un clúster Amazon EC2 P5en (GPU) con EFA, lo que demuestra que los beneficios se transfieren a las GPU. Este artículo explica la arquitectura basada en empuje, el flujo de transferencia, el modelo de hilos, los resultados de rendimiento y cómo reproducir el benchmark.
Transferencia de KV basada en Push
Esta sección explica el diseño basado en empuje: su arquitectura, el protocolo de transferencia y el modelo de hilos que evita que la transferencia de KV se encuentre en el camino crítico.
Vista general de la arquitectura
La transferencia basada en Push mejora el TTFT y el rendimiento de decodificación por dos razones:
- Elimina la serialización del modelo de extracción mediante la superposición del trabajo del productor y el consumidor. La instancia de decodificación registra sus bloques objetivo de antemano, mientras que el productor sigue calculando KV. La transferencia comienza tan pronto como los bloques del productor estén listos, en lugar de después de un viaje de ida y vuelta de descubrimiento de ID en el lado del consumidor, eliminando así ese viaje de la ruta hacia el primer token.
- Esto reduce el tiempo de configuración de transferencia en la instancia de decodificación. Esa configuración se ejecuta en el lado de prellenado y en un hilo en segundo plano. Prepara los descriptores NIXL y realiza la transferencia, de modo que la instancia de decodificación no desperdice esos ciclos durante su fase crítica de generación de tokens con latencia alta.
El efecto neto es un menor TTFT y un mayor rendimiento de tokens de salida en la instancia de decodificación.
El conector de push coordina tres actores: la instancia de decodificación registra sus bloques objetivo de antemano, la instancia de prellenado coincide con cada solicitud y emite la transferencia, y un hilo de fondo dedicado realiza el escritorio KV fuera del bucle de paso hacia adelante del motor. El siguiente diagrama muestra cómo estos componentes se integran.
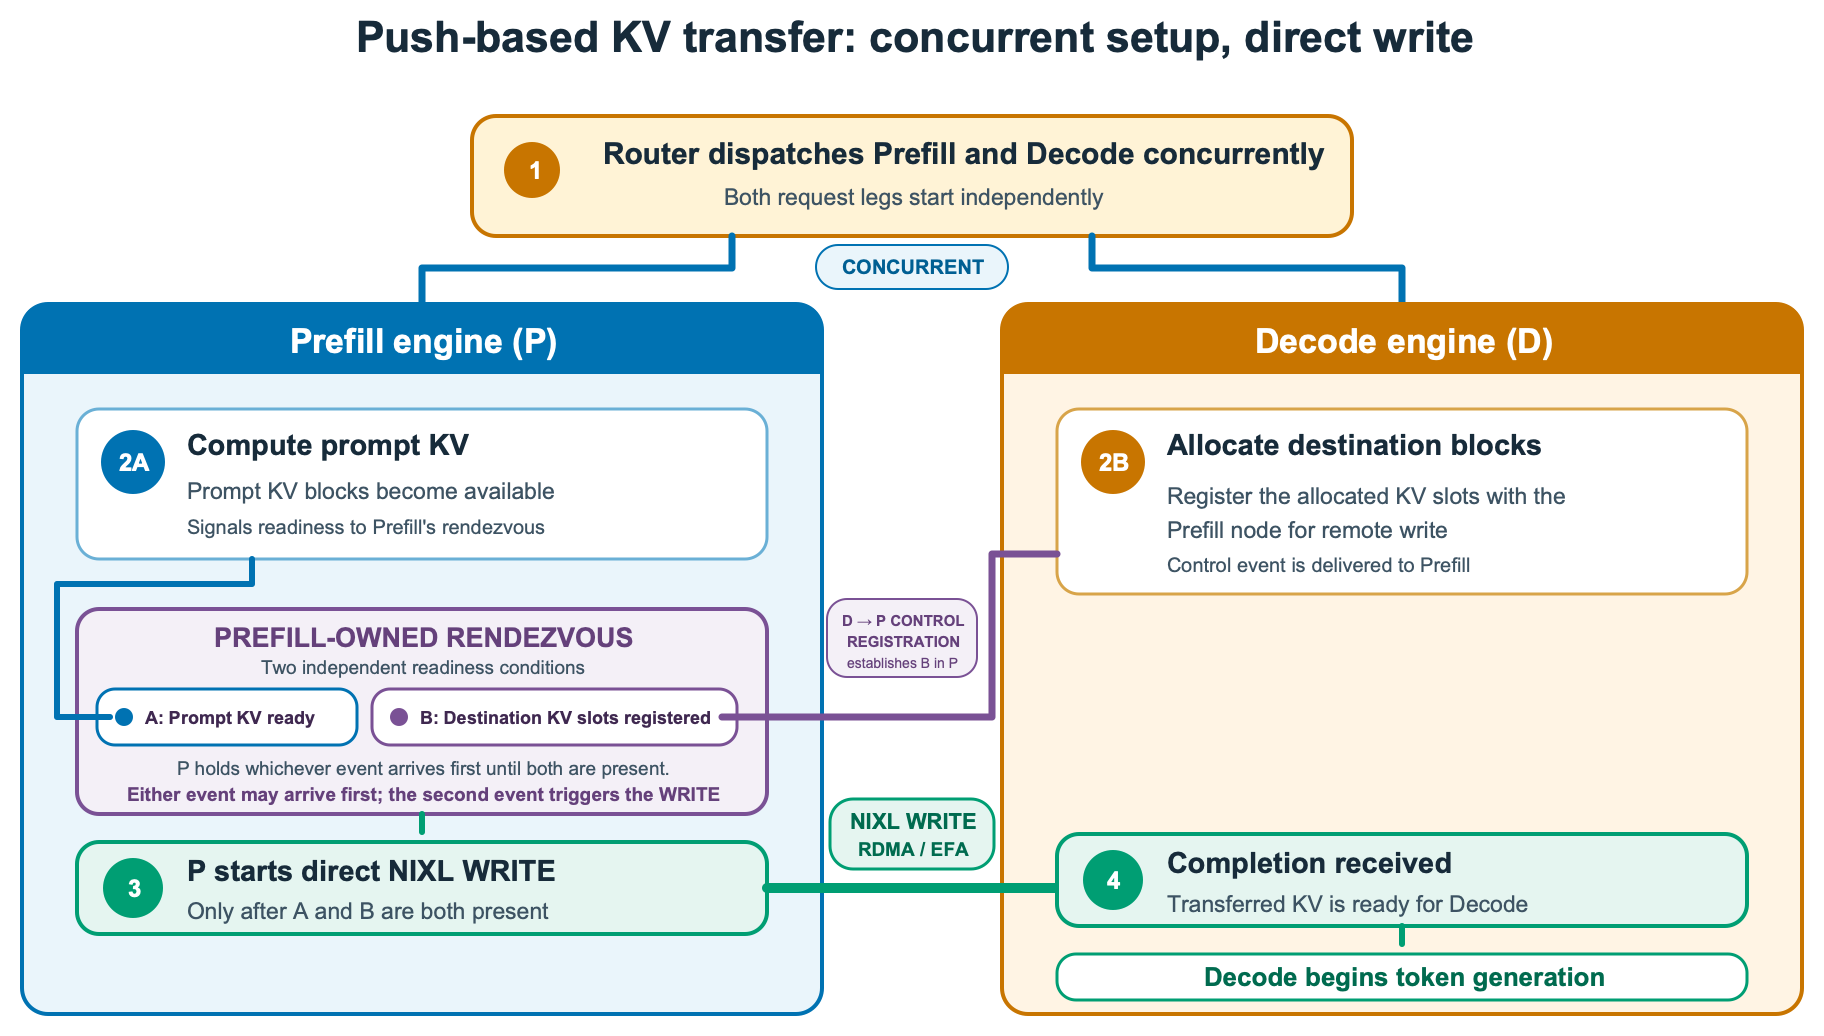
Figura 2: Arquitectura de transferencia de KV basada en push, que muestra cómo la instancia de decodificación, la instancia de prellenado y el hilo de transferencia en segundo plano se coordinan.
Detalles de implementación
El protocolo tiene tres pasos lógicos.
1. Registro (lado de decodificación). Cuando la instancia de decodificación asigna bloques locales para una solicitud que requiere relleno previo remoto, prepara un registro que describe dónde la instancia de relleno previo debe escribir los KV: su propia identidad y las ubicaciones de los bloques que acaba de reservar. En el mismo paso del motor, el trabajador transmite este registro a la instancia de relleno previo como una notificación NIXL. Dado que el registro ocurre en el momento de la asignación, el conector conoce los bloques destino antes de que la instancia de relleno previo complete el relleno previo.
2. Rendezvous (lado de prefill). La registración desde el decodificador y la finalización del prefill en el productor pueden llegar en cualquier orden, y el conector maneja ambos casos. Si la registración llega primero, el productor la retiene hasta que se complete su propio prefill. Si el prefill se completa primero, el productor retiene los bloques de la solicitud hasta que llegue la registración. El evento que ocurra en segundo lugar activa la transferencia. El conector asocia las solicitudes por ID, y gestiona correctamente las solicitudes reemitidas, asociando adecuadamente las solicitudes preteridas o repetidas.
3. Transferencia (lado de llenado). Una vez que la solicitud se encuentra, el productor establece una conexión con la instancia de decodificación (si aún no existe) y emite un NIXL WRITE que copia los bloques KV directamente en la memoria registrada del decodificador, asignando cada rango tensorial paralelo de destino. El productor y el consumidor pueden utilizar diferentes disposiciones internas de bloques. Cada lado asigna las ubicaciones de los bloques a su propia disposición física en tiempo de transferencia, permitiendo tamaños de bloque diferentes en cada lado. Cada WRITE lleva una notificación de finalización que NIXL entrega a la instancia de decodificación una vez que los datos llegan. El decodificador cuenta estas notificaciones, una por cada rango del productor que las escribe. Trata el KV como recibido solo después de que todas las notificaciones esperadas hayan llegado, momento en el cual la solicitud continúa con la decodificación.
Modelo de hilo
El conector de empuje separa la ejecución del modelo de la preparación de transferencia KV, utilizando una hilo de transferencia de fondo dedicado en cada trabajador de relleno previo. Al inicio de una solicitud, el bucle principal de decodificación asigna sus bloques KV de destino y los registra con la instancia de relleno previo, mientras que el bucle principal de relleno previo calcula la caché de KV del prompt. Después de que tanto el registro de destino como el prompt KV estén listos, el bucle principal de relleno de datos pasa los bloques KV al hilo en segundo plano y vuelve rápidamente a la ejecución del modelo.
El hilo de fondo establece o reutiliza la conexión NIXL, mapea los IDs de bloques KV de la solicitud a descriptores de memoria, fusiona los bloques contiguos en regiones de transferencia más grandes y envía el NIXL WRITE a la instancia de decodificación. Cuando NIXL completa la transferencia, envía una notificación de finalización a la instancia de decodificación, la cual entonces comienza la generación de tokens. Evitar la preparación del descriptor y la presentación de transferencia en los bucles principales críticos en términos de latencia evita que este trabajo por solicitud retrase la ejecución del modelo. El siguiente diagrama muestra estos traspasos entre bucles principales y hilos de fondo para una sola solicitud.
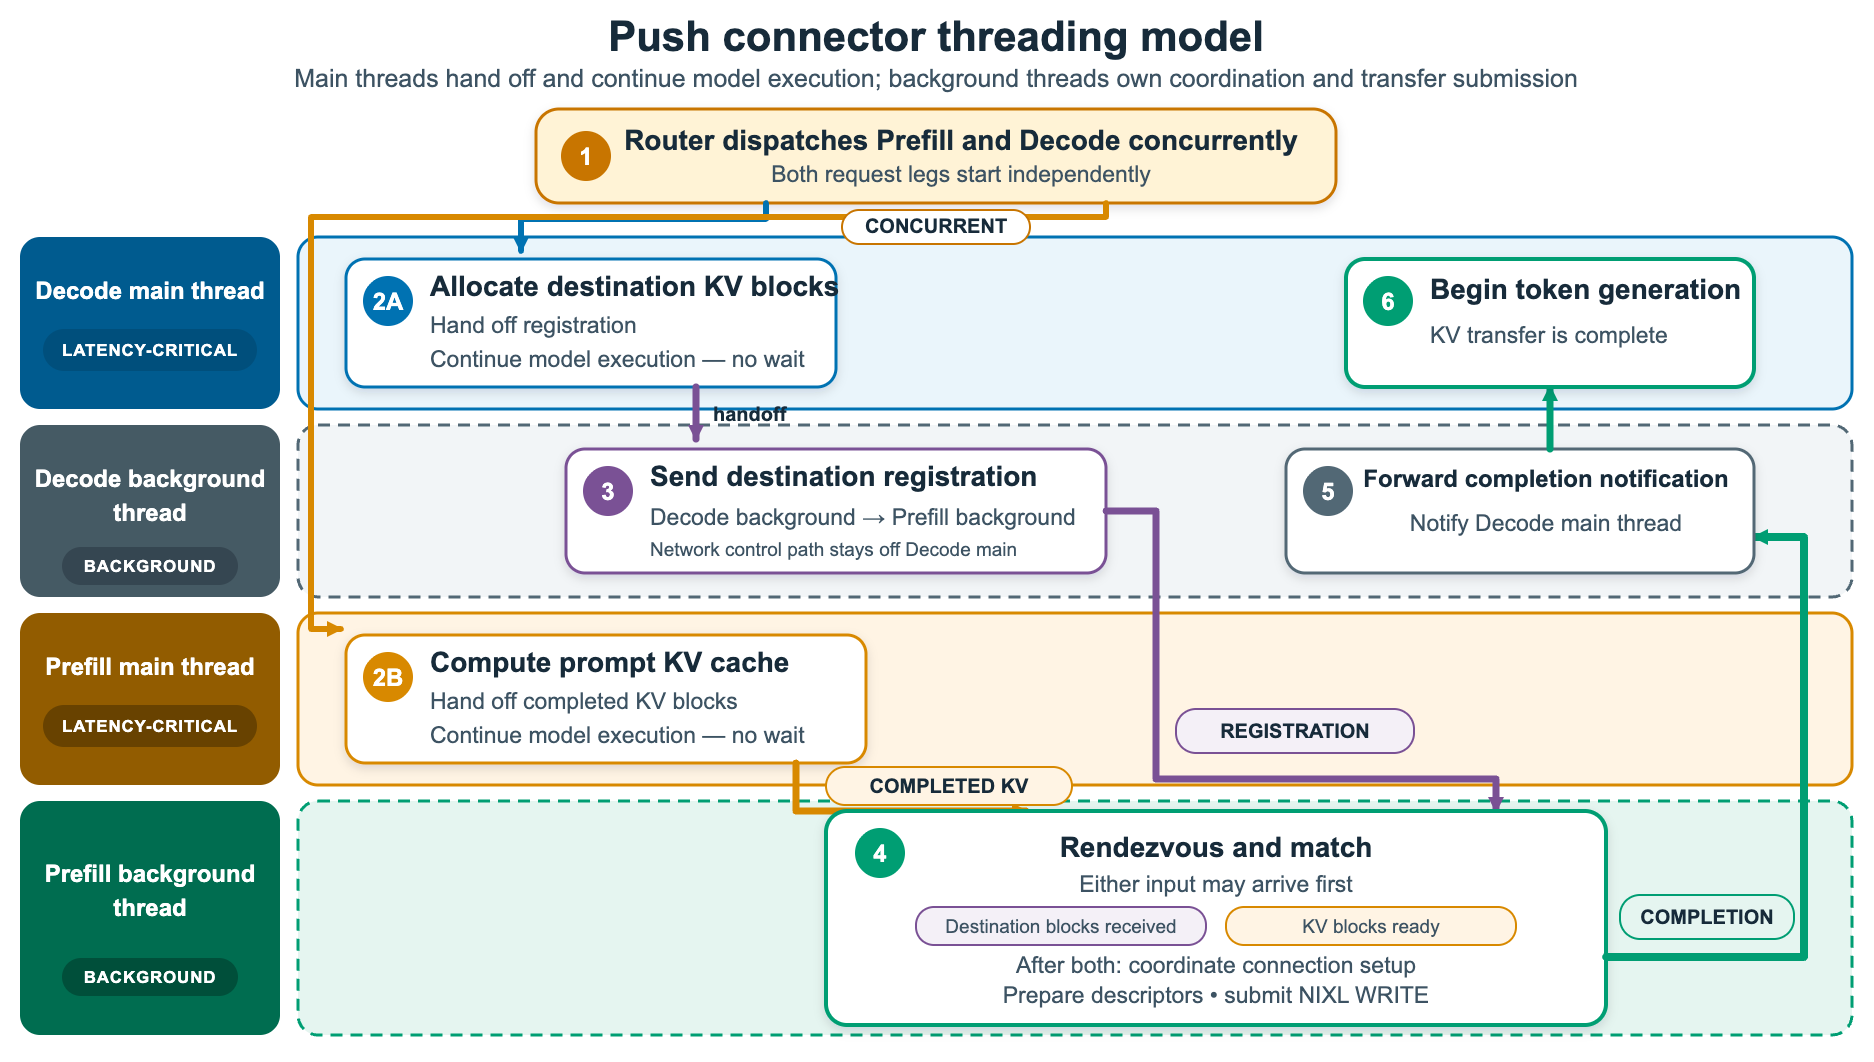
Figura 3: Traslados de hilos principal y de fondo para una solicitud única en el modelo de hilo basado en push
Comparación de tiempo entre pull y push
El siguiente diagrama resume los flujos de transferencia de pull y push descritos en las secciones anteriores y destaca su efecto en el TTFT. Aunque ambos modos utilizan el mismo camino de datos NIXL y EFA/RDMA, el pull realiza la retransmisión de metadatos y la configuración del lado de decodificación después del prefill, mientras que el push superpone la configuración del lado de decodificación con el prefill. Como resultado, el push elimina estas operaciones del camino crítico posterior al prefill, permitiendo que la decodificación comience antes.
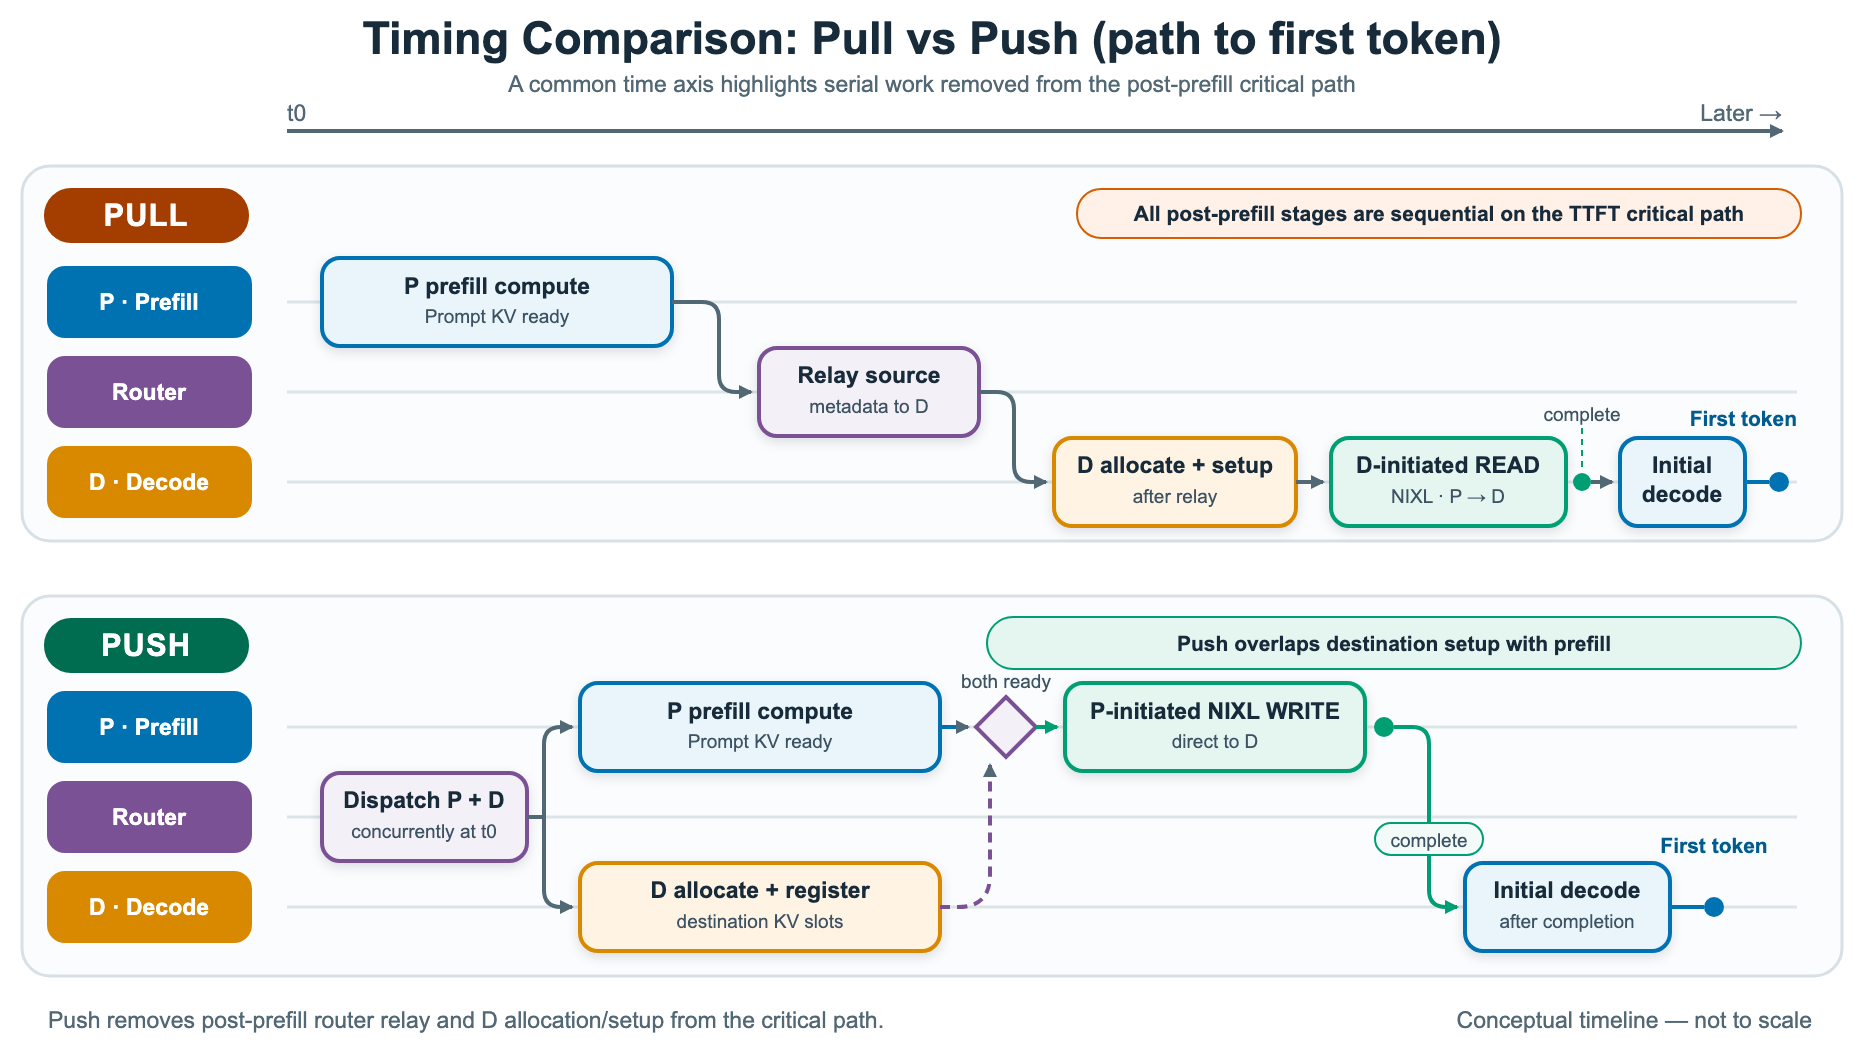
Figura 4: Comparación de los flujos de transferencia pull y push, destacando cómo el push se superpone a la configuración del lado de decodificación con el prellenado
Los dos modos también implican un compromiso en el enrutamiento. El modo Pull permite que el router seleccione una instancia de decodificación después de que se complete el prellenado, lo que proporciona mayor flexibilidad para el enrutamiento que toma en cuenta la carga y la gestión de la calidad del servicio. El modo Push selecciona la instancia de decodificación antes, de modo que la configuración de destino pueda superponerse con el prellenado. A cambio, bajo una carga comparable, la instancia de prellenado puede liberar sus bloques KV más rápido, ya que la transferencia comienza tan pronto como tanto el KV del prompt como el registro de destino estén listos.
Datos de rendimiento
Para la evaluación, utilizamos el modelo Qwen3-32B en una implementación 1P1D con instancias Amazon EC2 P5en conectadas mediante EFA. Para aislar el rendimiento de la transferencia P→D, configuramos el benchmark para desactivar el caché de prefijo con --no-enable-prefix-caching. Esta configuración hace que el nodo de decodificación obtenga toda la caché KV del nodo de prellenado para cada solicitud. De lo contrario, los prompts superpuestos podrían reutilizar el caché local del nodo de decodificación y evitar la transferencia, lo que generaría resultados de comparación engañosos.
El siguiente gráfico compara el TTFT para la transferencia de KV por empuje y por tiraje. Se examinan longitudes de entrada desde 1k hasta 16k y tasas de solicitud de 1 a 8 consultas por segundo (QPS). A baja carga y breves prompts, los dos modos funcionan casi de manera idéntica. A medida que aumentan la QPS y la longitud de entrada, el modo por tiraje degrada drásticamente, alcanzando aproximadamente 1,744 ms a 8 QPS y 16k. El modo por empuje permanece mucho más bajo, en torno a 540 ms, aproximadamente un 3 veces menos. La brecha se abre porque los posts en modo pull incluyen descriptores NIXL dentro del trabajo de decodificación, de forma sincrónica dentro del bucle del motor, lo que hace que el trabajo se detenga en la generación de tokens. El modo push los mueve a un hilo en segundo plano, fuera del camino crítico.
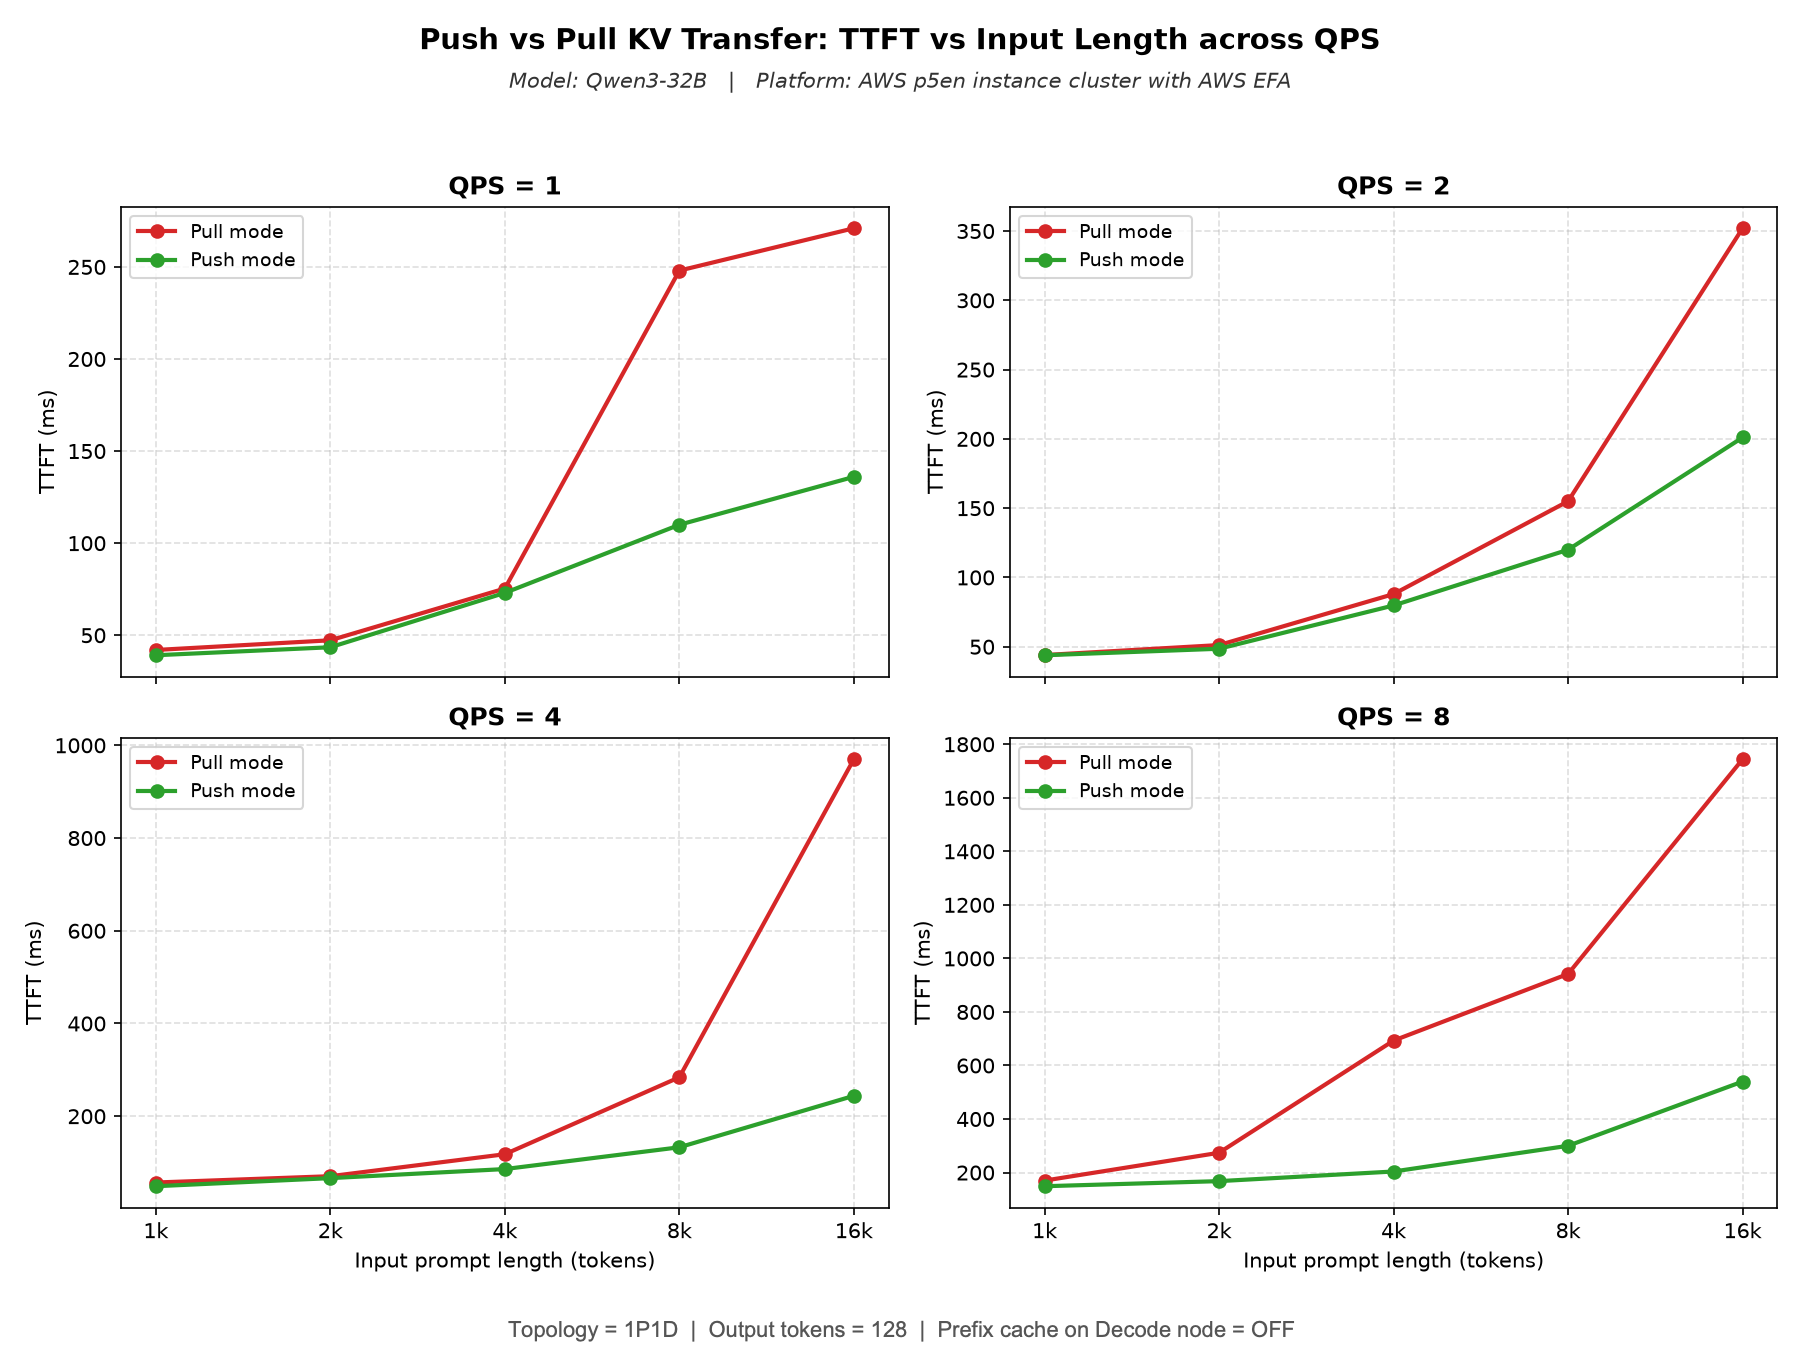
Figura 5: TTFT para la transferencia de KV en push en comparación con la transferencia en pull a través de longitudes de entrada y tasas de solicitud (topología 1P1D, 128 tokens de salida, caché de prefijo deshabilitada en el nodo de decodificación)
Este gráfico muestra TPOT bajo las mismas condiciones. El patrón es similar al de TTFT. Con carga ligera, el empuje y el tirón son cercanos, alrededor de 5.6–5.8 ms. A medida que aumenta la carga y la longitud de la entrada, el tirón aumenta a aproximadamente 10.4 ms en 4–8 QPS y 16k, mientras que el empuje se mantiene cerca de 7 ms. La razón es que el empuje descarga la preparación del descriptor y la presentación de transferencia del trabajador de decodificación. La generación de tokens no se agota, por lo que la latencia por token permanece constante incluso en alta concurrencia y contextos largos.
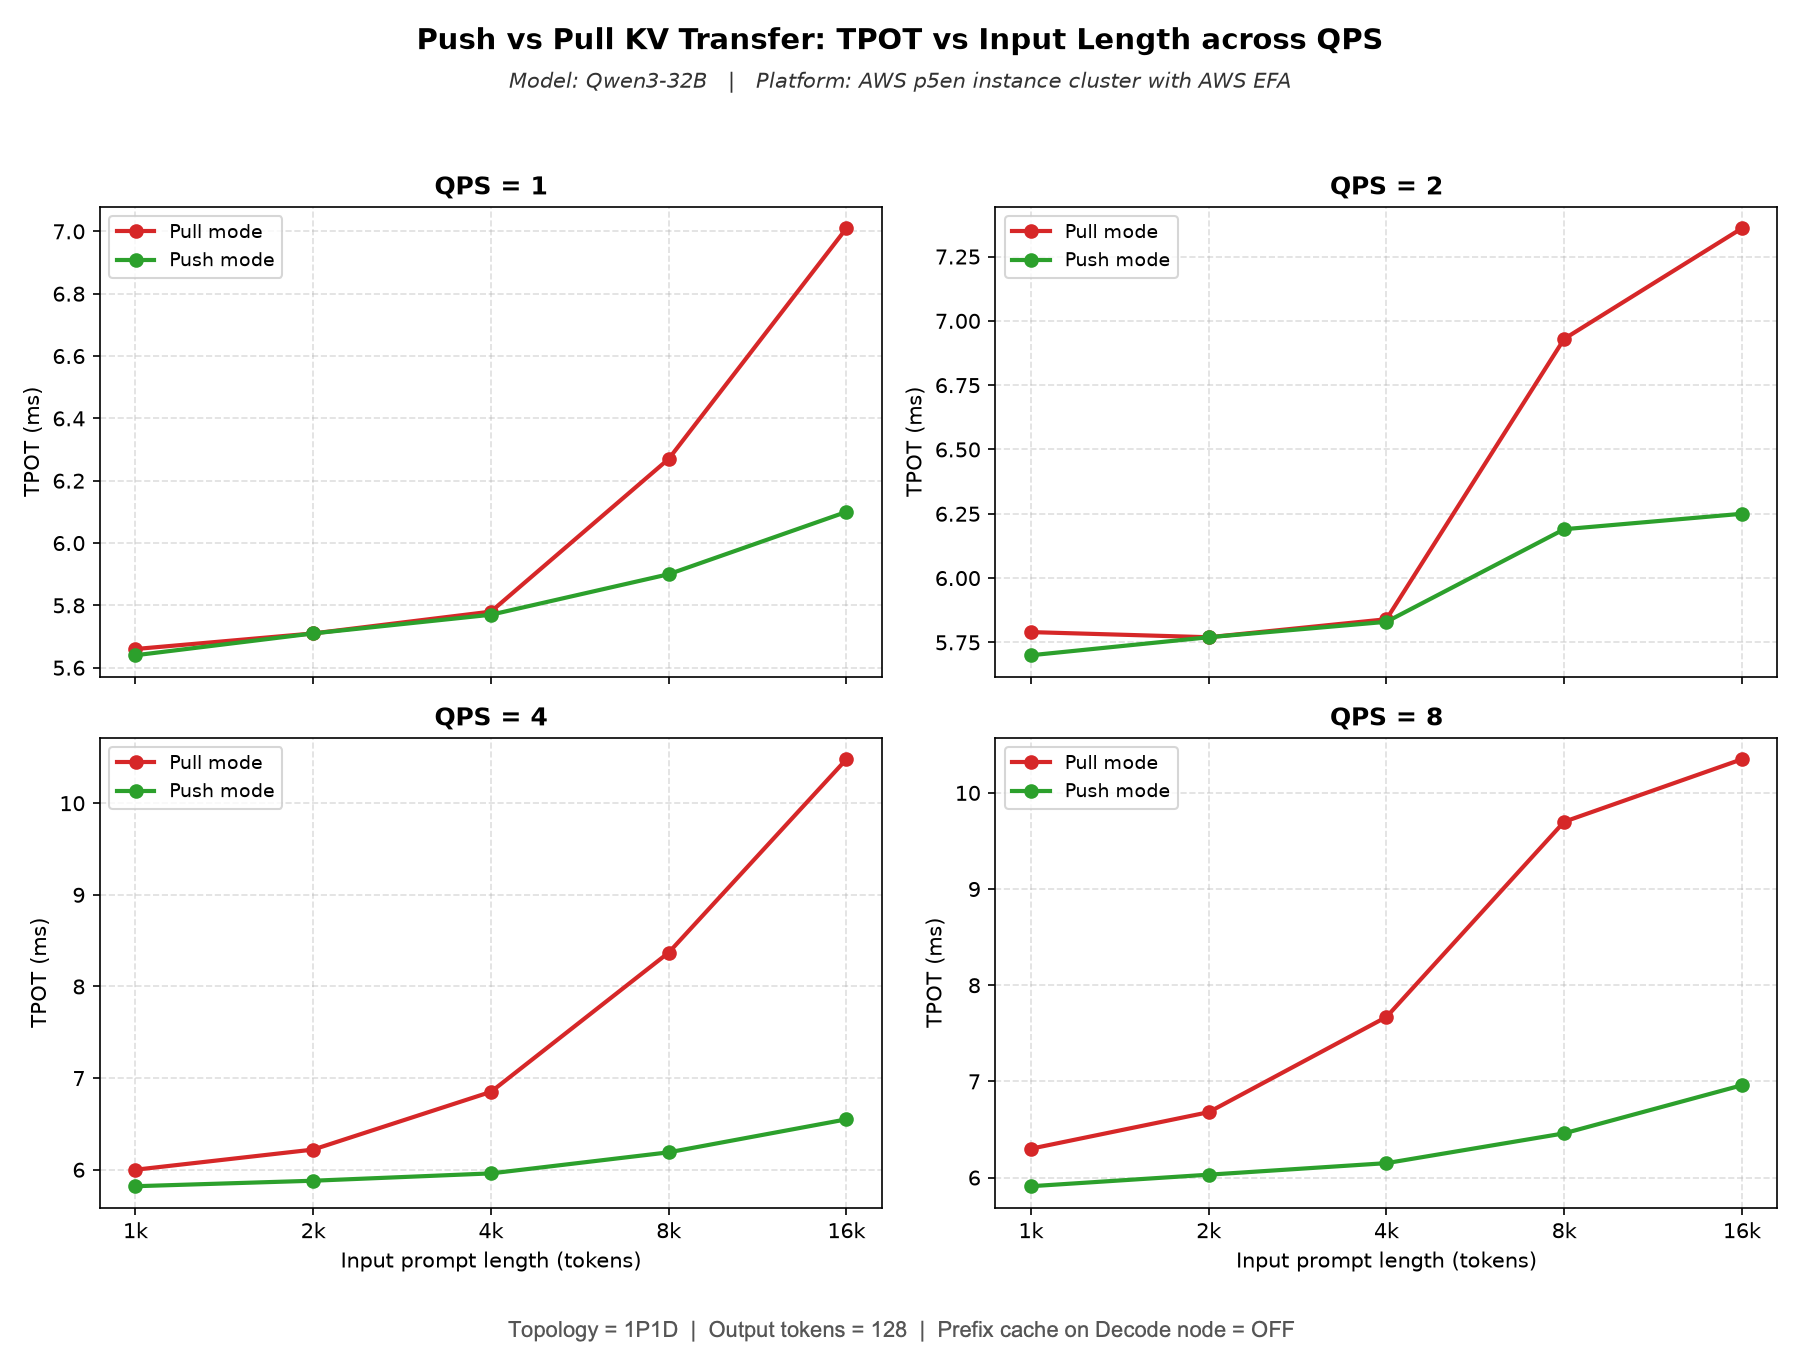
Figura 6: TPOT para el push en comparación con la transferencia de KV por pull a lo largo de los tamaños de entrada y las tasas de solicitud (topología 1P1D, 128 tokens de salida, caché de prefijo deshabilitado en el nodo de decodificación)
Cómo ejecutar un benchmark
Para reproducir la configuración de benchmark 1P1D de nuestro proyecto, se necesita un nodo de prellenado y un nodo de decodificación, utilizando instancias Amazon EC2 P5en conectadas mediante EFA. Para ello, consulte las instrucciones detalladas en el Guía para reproducir nuestros resultados. La guía aborda la configuración del entorno, el inicio de los servidores de prellenado y decodificación vLLM, la ejecución del benchmark y la recolección de resultados. Esta función puede operar en otras configuraciones soportadas, pero los resultados de rendimiento variarán según el hardware, el modelo, la carga de trabajo y la configuración de red.
Conclusión
En este artículo, mostramos cómo el conector KV basado en impulso superpone el cálculo de prellenado con la asignación y registro del bloque en el lado de decodificación, eliminando el viaje de ida y vuelta del router después del prellenado y la configuración de transferencia en el lado de decodificación del camino crítico. Esto reduce el TTFT y el TPOT, especialmente a altas tasas de solicitud. En nuestro benchmark Qwen3-32B en una implementación 1P1D utilizando instancias Amazon EC2 P5en conectadas con EFA, el modo impulso proporciona hasta un mejoramiento del 3x en el TTFT y un mejoramiento del 30 por ciento en el TPOT en comparación con el modo pull. Los resultados varían según la carga de trabajo y la configuración. Para utilizar el modo impulso, configure tanto los servidores de prellenado como los de decodificación para usar NixlPushConnector en lugar de NixlConnector.
Elija el conector basado en push cuando la selección de nodo de decodificación temprana es aceptable y el TTFT más bajo es la prioridad. El conector basado en pull sigue siendo la mejor opción para cargas de trabajo que requieren transferencia bidireccional de KV o retrase la selección de decode-instance hasta después del prefill para un enrutamiento sensible a la carga. vLLM soporta ambos conectores de KV basados en push y pull, por lo que puede elegir el enfoque que mejor se adapte a su implementación.
Como mejoría futura, estamos explorando la posibilidad de incorporar el modelo de hilos NIXL en el conector en modo pull, desplazando la configuración de NIXL fuera del camino crítico, de modo que las cargas de trabajo en modo pull puedan beneficiarse de las mismas optimizaciones. Hemos abierto un request de pull para explorar esto.
Recursos relacionados
Agradecimientos
Agradecemos a la comunidad de vLLM por su apoyo en el mantenimiento de esta función.