
Las cargas de trabajo agénticas de múltiples turnos se construyen sobre un contexto acumulado a medida que un agente razona, invoca herramientas e incorpora resultados anteriores. Con cada nuevo turno, el cliente reenvía el historial de la conversación, incluidas las instrucciones del sistema, los prompts previos, los resultados de las herramientas y las respuestas del modelo, lo que hace que el contexto creciente se procese repetidamente. En Desagregación prefill-decode (P-D), cada solicitud se divide entre nodos especializados: el nodo de prefill procesa el prompt y construye su caché de clave-valor (KV), luego el nodo de decode recupera esos bloques KV y genera la respuesta.
Sin embargo, la desagregación convencional de serving solo transfiere la caché KV en una dirección: del nodo de prefill al nodo de decode. Este flujo unidireccional crea dos ineficiencias para las cargas de trabajo de múltiples turnos. Primero, después de generar una respuesta, el nodo de decode retiene las entradas de la caché KV tanto del prompt como de los tokens recién generados. Al procesar el siguiente turno, el nodo de prefill no puede recuperar esas entradas, por lo que debe recalcular las proyecciones KV de los tokens de respuesta anteriores. Segundo, el nodo de decode mantiene el estado de la sesión mientras que los nodos de prefill no, lo que aumenta la probabilidad de expulsión de la caché para las sesiones activas en los nodos de prefill. Ante un fallo total de la caché, el nodo de prefill debe recalcular las proyecciones KV de todo el historial de la conversación, incluidas las instrucciones del sistema, las solicitudes anteriores del usuario, los resultados de las herramientas y las respuestas generadas por el modelo. A medida que la conversación crece, este trabajo redundante consume más capacidad de acelerador y aumenta el tiempo hasta el primer token (TTFT).
Cuando se crean asistentes conversacionales y aplicaciones agénticas, historiales de interacción más largos pueden aumentar la latencia y consumir capacidad de aceleradores mediante cálculos de prefill repetidos. En esta publicación, mostramos cómo transferencia bidireccional de caché KV permite que los nodos de prefill y decode reutilicen el contexto previamente calculado entre turnos, lo que mejora la utilización de los aceleradores y ayuda a las aplicaciones a mantener un TTFT receptivo a medida que crecen las conversaciones.
En nuestros benchmarks de múltiples turnos en una implementación 1P1D usando instancias P5en de Amazon Elastic Compute Cloud (Amazon EC2), la transferencia bidireccional de KV redujo el TTFT hasta 1.6x para Qwen3-32B y hasta 3.3x para zai-org/GLM-5-FP8 (véase la sección de datos de rendimiento). Los resultados varían según la carga de trabajo y la configuración. Las instancias están conectadas mediante AWS Elastic Fabric Adapter (AWS EFA"), una red de acceso remoto directo a memoria (RDMA) de baja latencia utilizada entre los servidores en AWS. En tipos de instancias compatibles, AWS EFA admite GPUDirect RDMA y Neuron Direct RDMA para mover bloques KV directamente entre la memoria del dispositivo GPU o AWS Trainium en los nodos de prefill y decode.
Originalmente construimos y validamos esta funcionalidad en clústeres de instancias AWS Trainium conectados con EFA y la contribuimos a vLLM como una capacidad independiente del acelerador. Los resultados presentados aquí provienen de un clúster de GPU Amazon EC2 P5en con EFA, lo que demuestra que los beneficios también se aplican a las GPU. Esta publicación explica la arquitectura de transferencia bidireccional de KV, el flujo de metadatos del router, la retención de bloques KV y los controles de recálculo, los resultados de rendimiento y cómo reproducir el benchmark.
Transferencia bidireccional de KV
La transferencia bidireccional de KV es un mecanismo mediante el cual un nodo de decode devuelve el KV calculado previamente a un nodo de prefill en los turnos subsiguientes de una conversación. Esto evita recalcular el contexto compartido en el nodo de prefill y se rige por un umbral de recálculo de KV configurable. Mitiga ambos escenarios de redundancia computacional descritos anteriormente. Para que funcione, el KV debe sobrevivir más allá del turno que lo produjo y viajar en dirección inversa, coordinado por un router consciente de la caché KV.
Mejoras del conector KV de NIXL para la transferencia bidireccional
Ampliamos el conector KV de la NVIDIA Inference Xfer Library (NIXL) conector KV para permitir que los nodos de prefill consuman bloques KV remotos, de manera similar a como los nodos de decode ya consumen los bloques KV que proporciona el nodo de prefill. Este no es un cambio trivial, porque los dos tipos de nodos son arquitectónicamente distintos: los nodos de prefill calculan representaciones KV para los nuevos tokens del prompt y pueden proporcionar bloques KV completos del prompt. Los nodos de decode carecen de la capacidad (o eficiencia) para generar representaciones KV completas y solo pueden servir bloques KV previamente almacenados en caché. Como resultado, los nodos de prefill y decode siguen teniendo sus propios roles y lógica para calcular los metadatos de los bloques KV remotos y locales. Sin embargo, el mecanismo real de transferencia de KV (un NIXL READ) es común a ambas direcciones, la de P->D y D->P la inversa.
El siguiente diagrama muestra primero el flujo existente en azul. El router envía la solicitud al nodo de prefill, el nodo de prefill calcula el KV del prompt y devuelve los metadatos de sus bloques, y el router reenvía la solicitud y los metadatos al nodo de decode para el P→D NIXL READ estándar. La ruta roja numerada ilustra las adiciones de transferencia de KV bidireccional: (1) el nodo de decode retiene los bloques KV elegibles después de la generación, (2) devuelve sus metadatos en la respuesta en streaming, y (3) el router almacena en caché esos metadatos para la próxima solicitud de prefill. Luego, el nodo de prefill (4) verifica el KV reutilizable remotamente después de aplicar las coincidencias de caché locales, (5) encola una recepción asíncrona cuando el número de tokens reutilizables alcanza el umbral, y (6) realiza un D→P NIXL READ antes de calcular el sufijo restante.
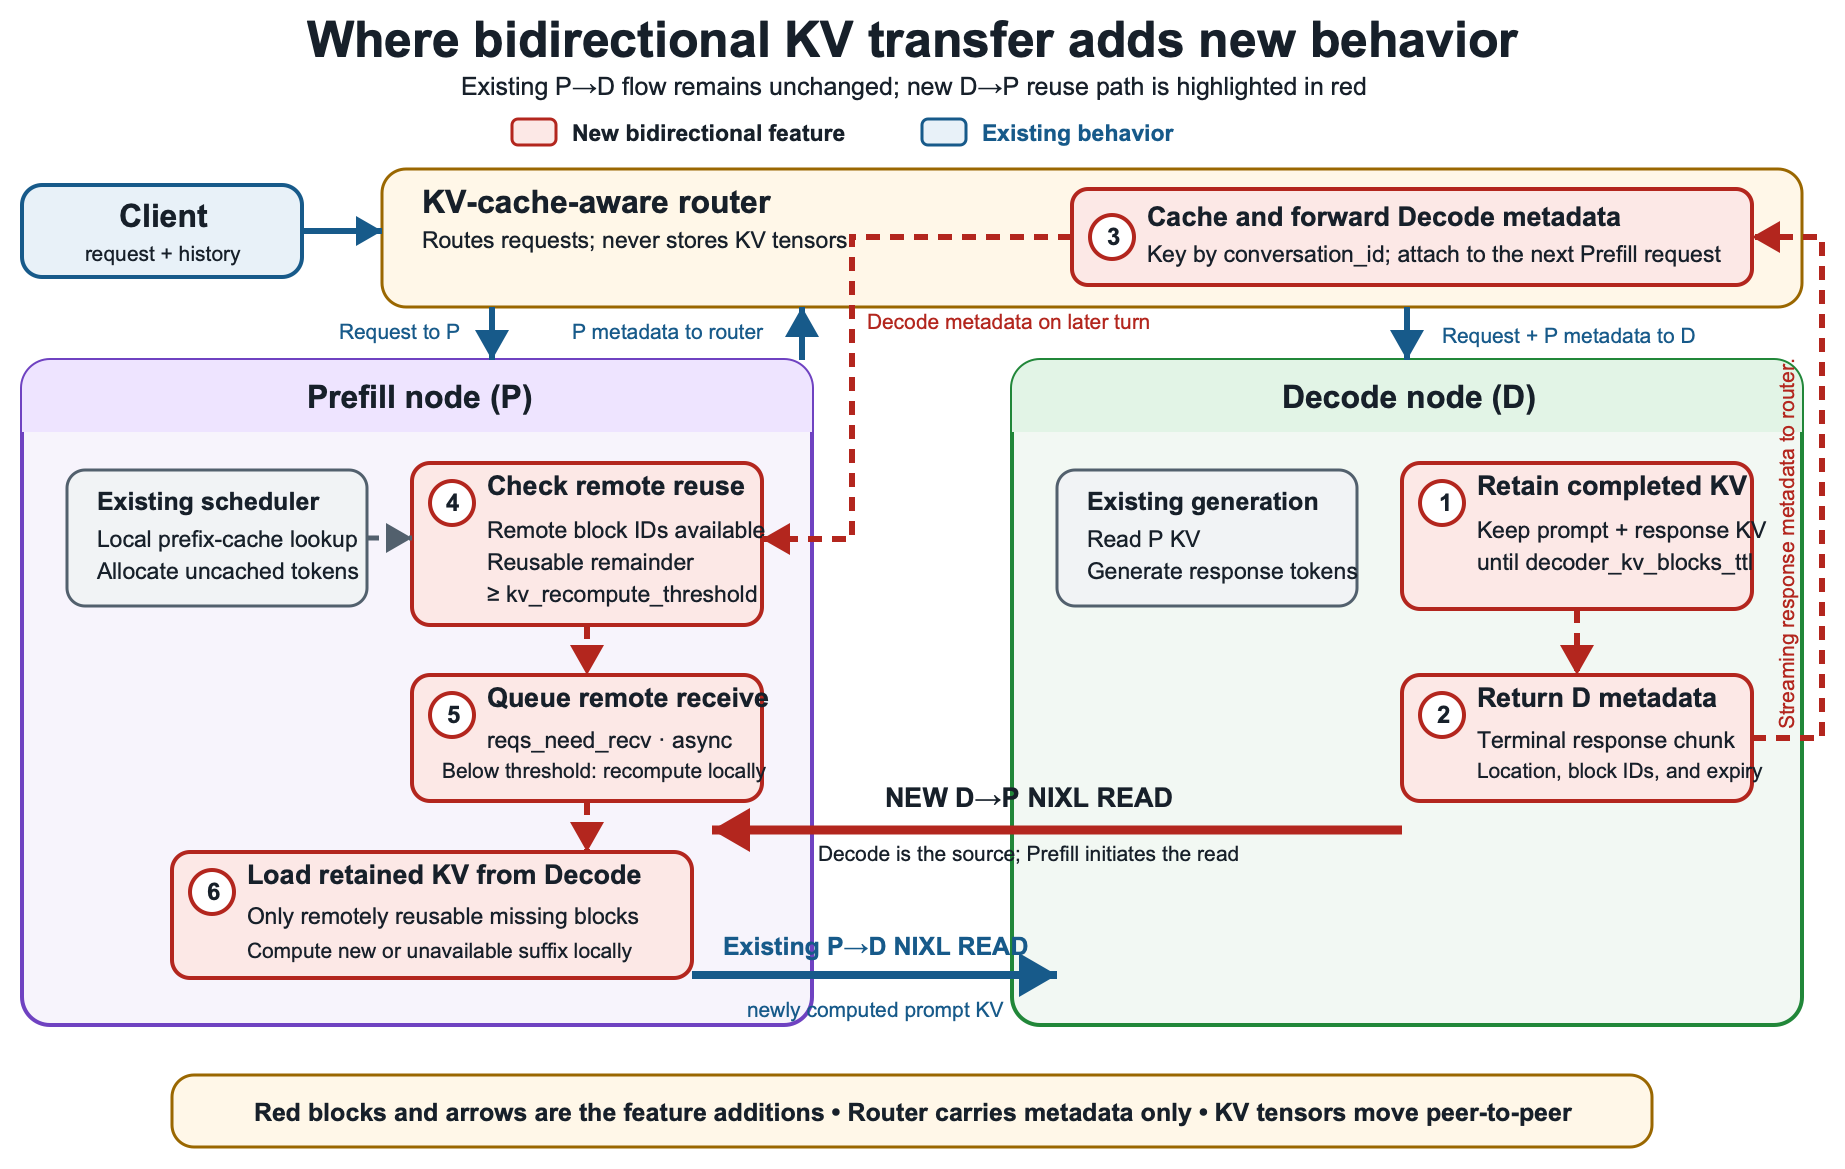
Figura 1: Flujo estándar de prefill a decode (azul) y las adiciones de transferencia de KV bidireccional (rojo)
router consciente de la caché KV
vLLM incluye soporte a nivel de conector para la transferencia de KV bidireccional, mientras que coordinar la reutilización de KV entre turnos de conversación requiere un router consciente de la caché KV. vLLM GitHub proporciona un proxy de ejemplo que implementa el flujo usado en esta publicación y que puede adaptarse a su entorno.
El router consciente de la caché KV es un componente de plano de control con estado y ligero entre el cliente, los nodos de prefill y de decode. Mantiene un mapeo en memoria desde el conversation_id proporcionado por el cliente hacia el kv_transfer_paramsde decode. El router almacena solo metadatos de ubicación de bloques, no tensores KV, y obtiene esos metadatos del flujo de respuesta en lugar de consultar por separado al nodo de decode.
El siguiente diagrama muestra cómo el router gestiona los metadatos KV a lo largo de los turnos de conversación. En el primer turno, la búsqueda en la caché falla y la solicitud sigue el flujo P→D estándar. Luego, el router guarda los metadatos de decode del flujo de respuesta. En turnos posteriores, el router recupera esos metadatos usando el conversation_id para que el prefill pueda reutilizar el KV de decode. Después, actualiza los metadatos tras la generación para el siguiente turno.
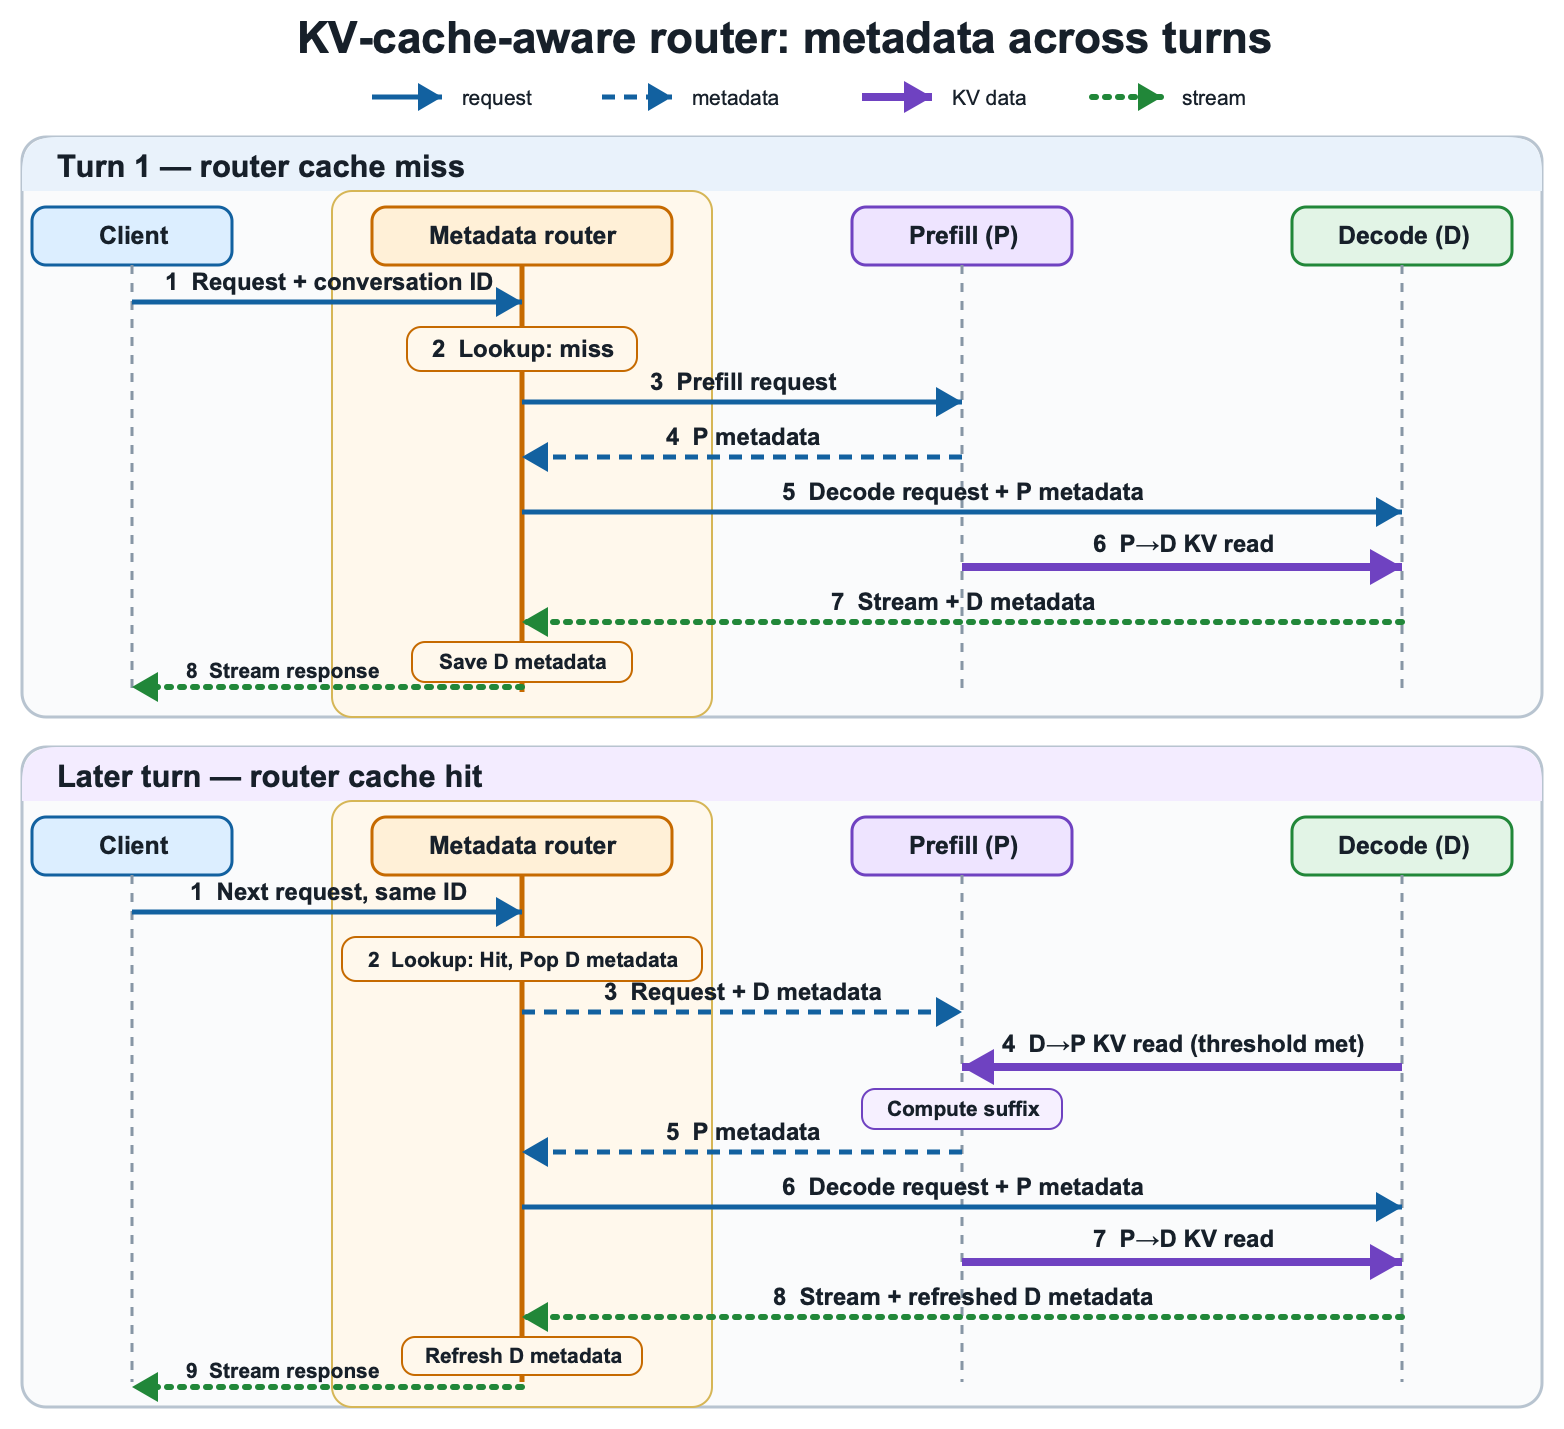
Figura 2: Flujo de metadatos del router consciente de la caché KV a lo largo de los turnos de conversación
TTL de retención de bloques
Normalmente, una instancia de decode libera los bloques de una solicitud tan pronto como termina la generación. En el modo de transferencia de KV bidireccional, los retiene durante un tiempo de vida configurable (decoder_kv_blocks_ttl, por defecto 480 segundos) y publica su ubicación y caducidad. El KV de la conversación, tanto el prefijo del prompt como la respuesta generada, permanece disponible para el siguiente turno. Para un turno que llega antes de que expire el tiempo de vida (TTL), el nodo de prefill reutiliza el KV. Uno que llega después recurre al prefill normal. Como este TTL es fijo y no se renueva, ajústelo al tiempo esperado entre turnos para equilibrar la reutilización del KV con el uso de la memoria del acelerador. Una mejora natural siguiente es extender el lease renovado por latido al lado de decode. Una instancia de decode podría entonces reclamar los bloques tan pronto como una conversación quede inactiva, en lugar de al final de un temporizador fijo.
Umbral de recálculo de KV
La reutilización de KV no siempre es más rápida que el recálculo local. Para un prefijo reutilizable corto, la sobrecarga de interconexión y coordinación puede exceder el tiempo necesario para recalcular los tokens. La configuración de kv_recompute_threshold , que por defecto es de 64 tokens, controla esta decisión. El nodo de prefill recalcula cuando el número de tokens por calcular está por debajo del umbral y extrae el KV del nodo de decode cuando está en o por encima del umbral. Las implementaciones pueden ajustar este valor según el tiempo de cómputo del modelo, el tamaño del KV y el rendimiento de la interconexión.
Datos de rendimiento
Para la evaluación, usamos los modelos Qwen3-32B y GLM-5-FP8 en un despliegue 1P1D utilizando instancias Amazon EC2 P5en conectadas con EFA. Para emular escenarios en los que el nodo de prefill ha desalojado su caché local o el router selecciona un nodo de prefill diferente que no tiene los bloques KV de la conversación, deshabilitamos el prefix caching en el nodo de prefill con --no-enable-prefix-caching.
En ambos modelos, activar la transferencia de KV bidireccional reduce el cómputo de prefill en conversaciones de múltiples turnos, y el beneficio generalmente crece con la longitud del prompt. Con la función DESACTIVADA, la instancia de prefill recalcula todo el contexto crecido en cada turno, por lo que el TTFT aumenta abruptamente. Qwen3-32B sube de 158 ms a 2k hasta 778 ms a 24k, y GLM-5-FP8 de 500 ms a 2k hasta 2,334 ms a 20k. Con ella ACTIVADA, el KV retenido de la instancia de decode se reutiliza en lugar de recalcularse, manteniendo el TTFT mucho más plano. Qwen3-32B sube solo de 122 ms a 460 ms en el mismo rango (aproximadamente una reducción de 1.6x en el prompt más largo), mientras que GLM-5-FP8 sube de 358 ms a 702 ms y se ejecuta hasta 3.3x por debajo de la ruta de recálculo en prompts largos. El desglose de la duración del prefill explica por qué.
La transferencia bidireccional añade un pequeño tiempo de transferencia de KV (aproximadamente 30 ms a 130 ms para Qwen3-32B; aproximadamente 29 ms a 110 ms para GLM-5-FP8), pero el cómputo de prefill que elimina supera con creces ese tiempo de transferencia de KV. Como resultado, la duración total del prefill con la transferencia ACTIVADA (Qwen3-32B: 128 ms a 414 ms; GLM-5-FP8: 316 ms a 541 ms) se mantiene muy por debajo de la ruta de solo recálculo (Qwen3-32B: 153 ms a 744 ms; GLM-5-FP8: 500 ms a 2,331 ms). El modelo más grande, GLM-5-FP8, muestra una brecha mayor en términos absolutos y relativos, ya que su mayor tiempo de recálculo por token hace que la reutilización del KV compense aún más a medida que los modelos y contextos escalan.
Qwen3-32B
El siguiente gráfico representa el TTFT frente a la longitud del prompt para Qwen3-32B, comparando la transferencia de KV bidireccional ACTIVADA frente a DESACTIVADA.
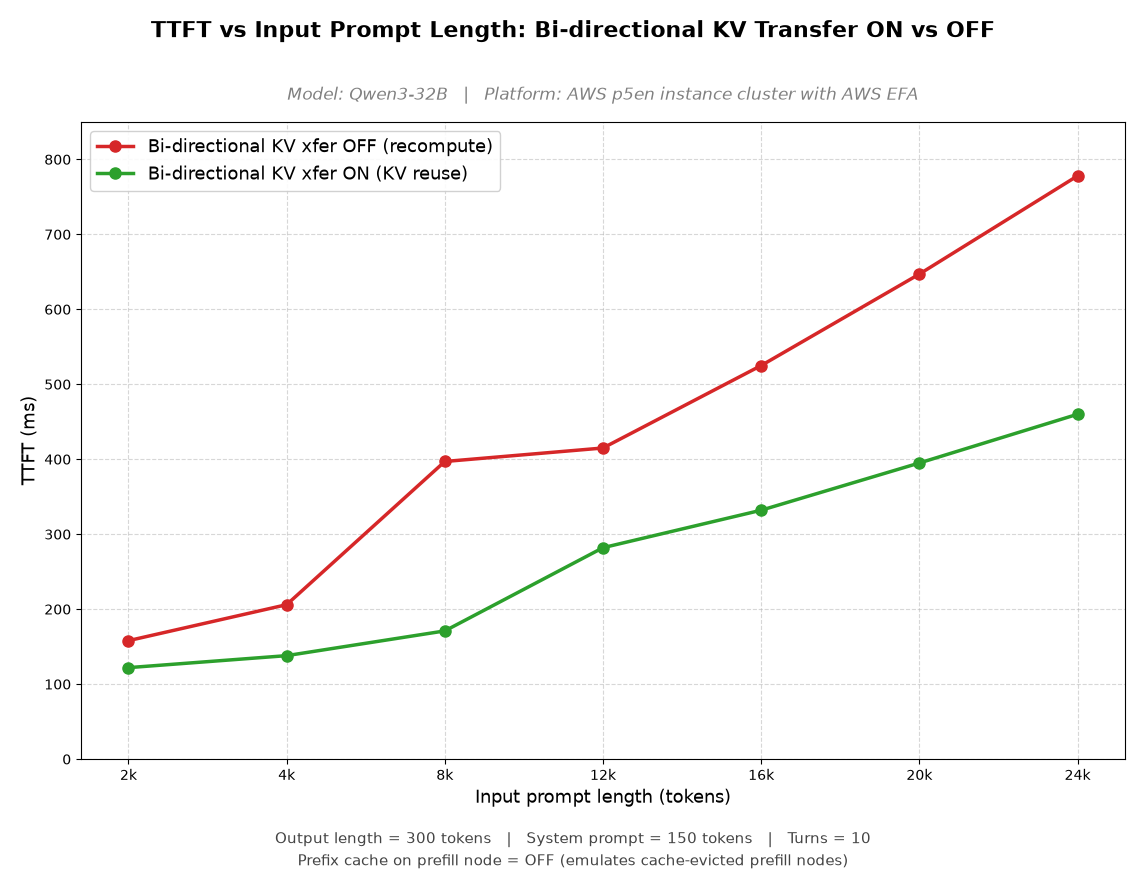
Figura 3: TTFT de Qwen3-32B frente a la longitud del prompt con la transferencia de KV bidireccional activada y desactivada
El siguiente gráfico desglosa la duración del prefill para las mismas ejecuciones en sus componentes de recálculo y transferencia de KV.
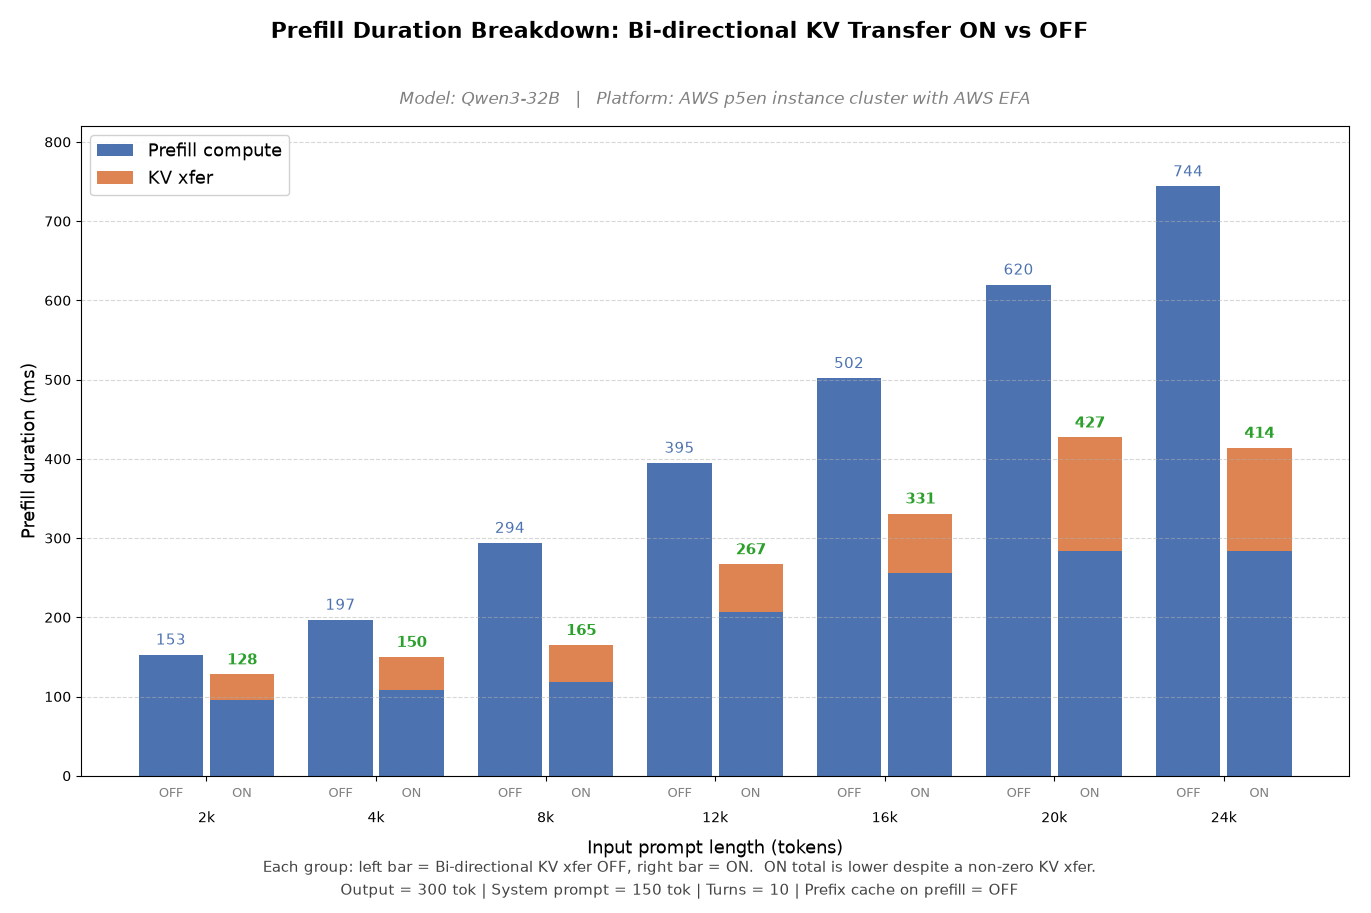
Figura 4: Duración del prefill de Qwen3-32B dividida en componentes de recálculo y transferencia de KV
En conjunto, los gráficos muestran que el TTFT se mantiene casi plano con la función ACTIVADA, mientras que la ruta DESACTIVADA sube de forma pronunciada a medida que crece el contexto, porque el pequeño tiempo de transferencia de KV se ve ampliamente superado por la recomputación que elimina.
zai-org/GLM-5-FP8
Las mismas dos vistas se aplican a GLM-5-FP8. La primera representa el TTFT frente a la longitud del prompt con la función ACTIVADA frente a DESACTIVADA.
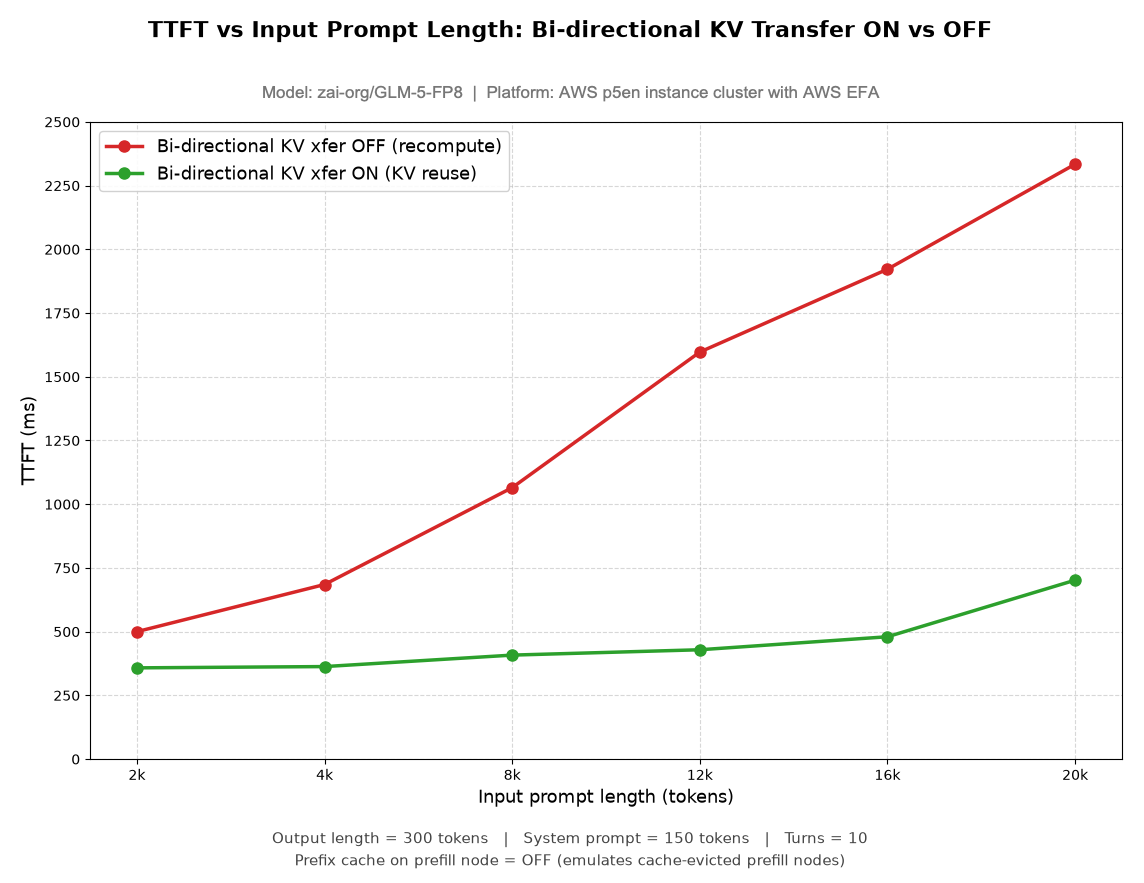
Figura 5: TTFT de zai-org/GLM-5-FP8 con reutilización de KV activada y desactivada
La segunda desglosa la duración del prefill en sus componentes de recomputación y transferencia de KV.
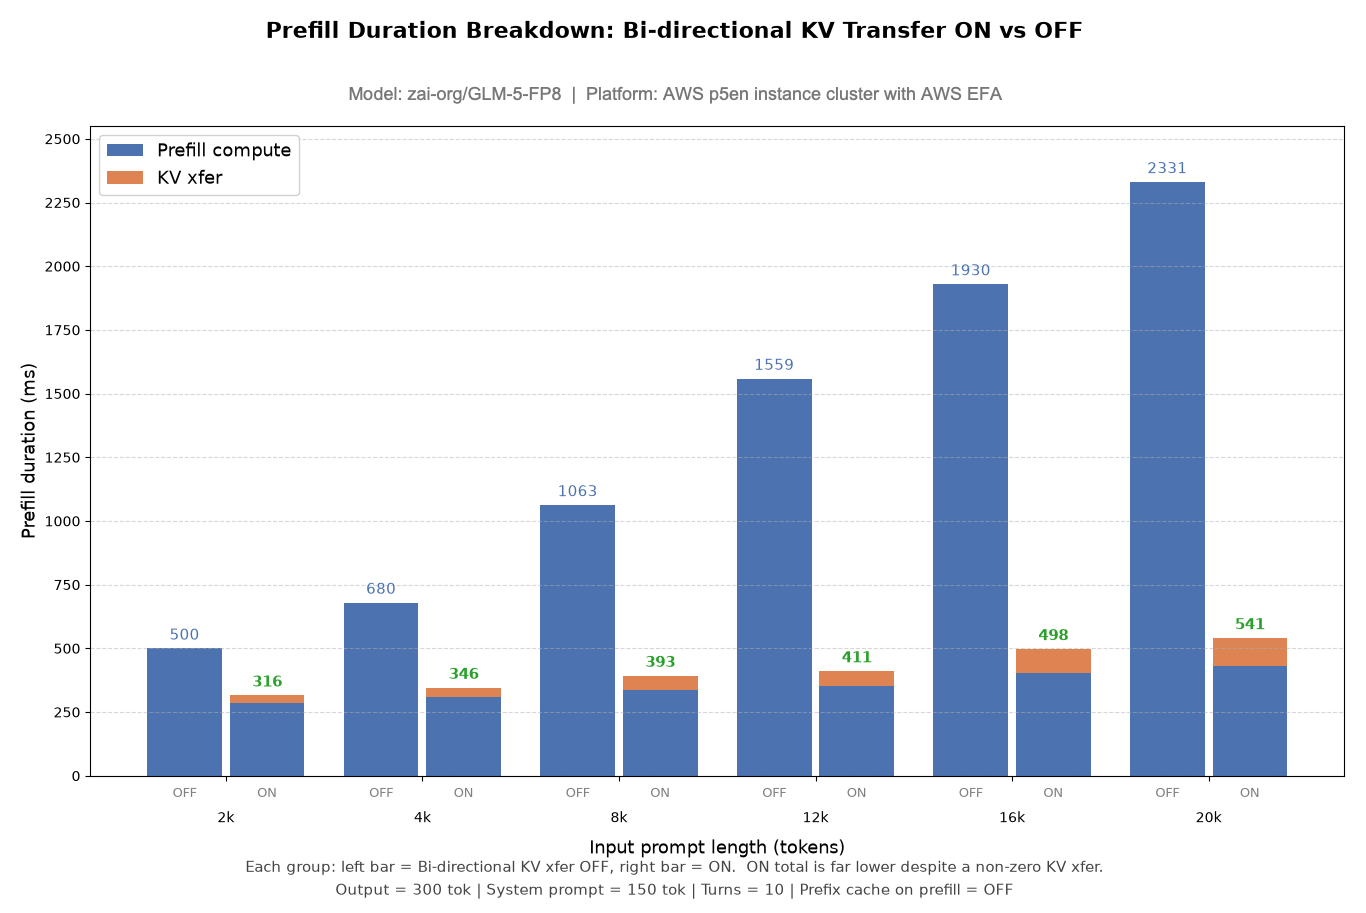
Figura 6: Desglose de la duración del prefill de zai-org/GLM-5-FP8
GLM-5-FP8 muestra una brecha mucho mayor que Qwen3-32B, de hasta alrededor de 3.3 veces menor TTFT en prompts largos, porque su mayor tiempo de recomputación por token hace que la reutilización de KV compense aún más a medida que crece la longitud del contexto.
Cómo ejecutar el benchmark
Para reproducir nuestra configuración de benchmark 1P1D, un nodo de prefill y un nodo de decode, usando instancias Amazon EC2 P5en con EFA, siga las instrucciones paso a paso en la Guía para reproducir nuestros resultados. La guía cubre la configuración del entorno, el lanzamiento de los servidores de prefill y decode de vLLM, la ejecución del benchmark y la recopilación de resultados. La función puede ejecutarse en otras configuraciones compatibles, pero los resultados de rendimiento variarán según el hardware, el modelo, la carga de trabajo y la configuración de red.
Conclusión
En esta publicación, mostramos cómo la transferencia bidireccional de la caché KV puede reducir el TTFT a medida que crece el historial de conversación de un agente. En despliegues P-D desagregados, la función permite que el nodo de prefill reutilice los bloques de KV que el nodo de decode retiene entre turnos, reduciendo el cálculo repetido. Los umbrales configurables de retención de bloques y recomputación determinan cuándo ocurre la reutilización. En un despliegue 1P1D que usa instancias Amazon EC2 P5en conectadas con EFA, en las longitudes de prompt más largas probadas, observamos reducciones de TTFT de 1.6 veces para Qwen3-32B y de 3.3 veces para zai-org/GLM-5-FP8. Los resultados dependen de la carga de trabajo y de la configuración del despliegue. Para implementar esto en su entorno, use vLLM v0.21.0 o posterior con NixlConnector, habilite bidirectional_kv_xfer tanto en los servidores de prefill como de decode, use un router consciente de kv-cache y siga la Guía de reproducción en GitHub.
Recursos relacionados
- AWS EFA
- Servicio desagregado Prefill-Decode (P-D)
- Benchmark KV Cache Offloading with Multi-Turn Conversations
Agradecimientos
Agradecemos a la comunidad de vLLM su apoyo en el mantenimiento de esta función.