
A medida que la voz se convierte en una modalidad de primera clase para la IA, los modelos de Deepgram abarcan procesamiento de voz a texto, texto a voz y agentes vocales. Actualmente, procesan cuadrillones de tokens de audio al año para más de 200,000 desarrolladores y 1,400 organizaciones. Los clientes los utilizan a través de la API Deepgram o los ejecutan en sus propios entornos, incluido Amazon SageMaker AI.
Para Deepgram, la eficiencia de servicio determina cuánto audio el sistema puede procesar para un presupuesto de infraestructura dado. Las cargas de trabajo en lotes de alto volumen ejercen una gran presión sobre ese presupuesto; por lo tanto, cuanto más eficientemente se utilice cada hora de acelerador, más audio podrá servir Deepgram con la misma flota. Esto hizo que la eficiencia de inferencia sea un objetivo natural, y Deepgram recurrió a los chips de IA de AWS para mejorarla. Trabajaron con AWS para llevar su modelo de voz a texto Nova-3 a AWS Trainium2 para cargas de trabajo en lotes sin conexión, como el análisis de centros de contacto y la transcripción médica.
La colaboración comenzó con Deepgram entregando Nova-3 como código estándar de PyTorch. Durante varios meses, Deepgram y el equipo de AWS Forward Deployed Engineering (FDE) portaron Nova-3 a AWS Trainium2 en reconstrucción de PyTorch y lo ajustaron para el nuevo hardware. La configuración final ejecuta ocho réplicas del modelo en una instancia Amazon Elastic Compute Cloud (Amazon EC2) trn2.3xlarge. En las cargas de trabajo de lotes orientadas al rendimiento fuera de línea de Deepgram, esa configuración procesaba entre el 11 y el 70 por ciento más audio por dólar que las opciones de computación que había estado utilizando Deepgram. Medimos esto usando los precios de las instancias en el momento de la evaluación. Estos beneficios ayudan a Deepgram a escalar de manera eficiente, mantener modelos mejorados en producción y ofrecerlos a los clientes a precios más bajos. Estos beneficios pueden extenderse a los clientes que alojan sus propios modelos de Deepgram en su propio cloud privado virtual (VPC) en Amazon SageMaker AI. Allí, Deepgram y AWS continúan mejorando la facilidad de configuración, la fiabilidad y la observabilidad.
En este artículo, explicamos todo el esfuerzo de optimización de inferencia en Trainium: la portación de Nova-3 a la pila de software AWS Neuron, el ajuste a nivel de kernel que siguió, el runtime Rust paralelo a datos que permite al servidor de modelo propio de Deepgram llamar a Trainium, y los resultados de rendimiento y costo que medimos en transcripción por lotes.
Optimizar Nova-3 a Trainium2 con PyTorch nativo
Comenzando con el código estándar de PyTorch, utilizamos TorchNeuron, la integración nativa de PyTorch del Neuron Compiler, que soporta tanto la ejecución eager como torch.compile. Primero ejecutamos Nova-3 en modo eager en Trainium2 y verificamos qué operaciones se desplazaban a la CPU, luego compilamos con torch.compile. La ruta compilada realizó todas las operaciones del modelo en Trainium2 sin detectar ningún desplazamiento a la CPU.
Compilamos el codificador y el decodificador como gráficos de forma estática separados, utilizando torch.compile. En todo momento, verificamos la precisión numérica en dos niveles: la consistencia de la salida a nivel de capa en comparación con la CPU, y el porcentaje de error en palabras de extremo a extremo (WER), el cual debía mantenerse en línea con los valores de referencia y objetivo de Deepgram.
Desde ese punto de partida funcional, iniciamos el trabajo de optimización reemplazando varias capas con núcleos fusionados de la biblioteca pública NKI Library (NKILib), una colección de núcleos de referencia preconstruidos escritos con la Interfaz de Núcleo Neuron (NKI). Los núcleos cubrían operaciones como proyecciones fusionadas QKV, capas de red feed-forward fusionada (FFN) y convolución 1D de profundidad.
Optimizamos para el rendimiento y, por extensión, la eficiencia de costos, dirigiéndonos a las cargas de trabajo de inferencia sin conexión de Deepgram. El rendimiento se reporta como un beneficio relativo en comparación con una configuración de referencia, en lugar de como audio procesado absoluto por segundo, y examinamos los tamaños de lote desde 1 hasta 128 para encontrar el tamaño de lote que maximiza el rendimiento.
Ajuste a nivel de kernel con Neuron Explorer y NAD
Habilitar los kernels es solo el primer paso de un ciclo de optimización: habilitar un kernel NKI (personalizado o proveniente de NKILib), analizar la carga de trabajo, y luego ajustar el kernel existente o reemplazarlo por uno nuevo basado en las conclusiones del análisis. Este ciclo se repite hasta que se cumpla el objetivo de rendimiento. En cada paso, una parte diferente de la pila de Neuron acelera el trabajo: NKILib proporciona kernels de sustitución fácil de instalar, Neuron Explorer es la herramienta recomendada para el perfilado de los trabajos de Neuron, y el toolkit Neuron Agentic Development (NAD) acelera el análisis de perfilado y el ajuste del kernel a través de sus habilidades de perfilado y escritura de kernel.
En nuestro caso, los kernels de NKILib nos ayudaron en gran medida, y el análisis de perfil mostró dónde un kernel escrito a mano sería más eficaz. Cada vez, las habilidades de perfilaje de NAD nos llevaban desde un perfil de Neuron Explorer hasta la causa raíz, y las habilidades de escritura de kernels de NAD ayudaron a producir los kernels sustitutos.
| Capa | Lo que encontramos y cambiamos | Gain |
| FFN | El programa de tiling del kernel de referencia volvió a cargar todo el conjunto de pesos de proyección desde la memoria fuera de la chip para cada tile de token, por lo que el ancho de banda de memoria limitaba el rendimiento a medida que aumentaba el número de tokens. Nuestro kernel ajustado manualmente carga cada tile de peso una vez, lo reutiliza entre múltiples tiles de token y dirige las lecturas de pesos mediante el cálculo en la chip. | 2.0x menor latencia en comparación con el kernel de referencia a un tamaño de lote de 96 |
| Profundidadwise conv1d | El kernel experimental NKILib presentó la operación como un multiplicar matricial general implícito (GEMM), lo que redujo el uso del Tensor Engine. Lo reescribimos como un bucle de multiplicación acumulación difundida en el Vector Engine, logrando un uso completo del motor, suficiente para superar con creces el bajo rendimiento máximo del Vector Engine. | Aceleración del 1.5x en comparación con el kernel de referencia a un tamaño de lote de 96 |
| Conv2d | Los capas conv2d del modelo tocaron un cuello de botella en la compilación: más allá del tamaño del lote 32, estas capas impidieron que el modelo se compilara como un único grafo. Dado que NKILib no tenía un kernel conv2d, escribimos uno desde cero en NKI. El kernel pasó por varias iteraciones basadas en el profiler, siguiendo el ciclo descrito anteriormente, lo que permitió tamaños de lote superiores a 32. | Hasta 50 veces en el módulo de convolución con tamaños de lote ≤32 |
Ejecución de tiempo paralelo de datos en Rust
Cada dispositivo Trainium2 cuenta con ocho núcleos físicos NeuronCores, que se exponen por defecto como cuatro núcleos lógicos NeuronCores (LNC2). Dado que cada instancia del modelo Nova-3 se adapta cómodamente a un único núcleo físico, redujimos la cantidad de núcleos físicos por núcleo lógico a uno (LNC1). Esta configuración nos permite alojar ocho réplicas del modelo (DP8) por dispositivo Trainium2. Las entradas se procesan de forma simultánea, maximizando el rendimiento por dispositivo. El tiempo de ejecución paralelo de datos está impulsado por una cola de robo de trabajo con un hilo por cada réplica.
La pila de servicio de producción de Deepgram está escrita en Rust, por lo que la portación de Nova-3 a Trainium2 requirió más que simplemente compilar el modelo: también era necesario que funcionara sin Python o PyTorch en el proceso de servicio. Por lo tanto, construimos un runtime ligero en el cual Rust coordina las réplicas del modelo a través de una cola compartida de robo de trabajo. Una capa en C carga y ejecuta directamente los archivos ejecutables en formato NEFFs de Neuron, compilados de antemano, a través de la API del runtime de Neuron (libnrt). El runtime se integra directamente con la arquitectura de servicio de Deepgram y reproduce las secuencias de tokens de referencia exactamente en cada tamaño de lote probado.
Lo comparamos con los tiempos de ejecución paralelizados de datos en Python de tipo multithread y multiprocesamiento. En comparación con el punto de partida de MP, el tiempo de ejecución de Rust elimina por completo la sobrecarga del intérprete de Python. En comparación con el punto de partida de MT, también reduce aún más la serialización del bloqueo del intérprete global (GIL), de modo que las llamadas de despacho desde los hilos de trabajador concurrentes ya no se compiten dentro de un único proceso. Estos beneficios son importantes, ya que Nova-3 realiza una secuencia de pequeñas llamadas al decodificador para cada bloque de audio, lo que hace que el desplazamiento desde el lado del host sea el punto débil en tamaños de lote bajos. Por lo tanto, la mejora en el rendimiento es mayor allí, y sigue siendo significativa incluso en el tamaño de lote que maximiza el rendimiento. Allí, el tiempo de ejecución Rust logró una mejora en el rendimiento del 7.5% en comparación con el punto de referencia en Python con multiprocesamiento.
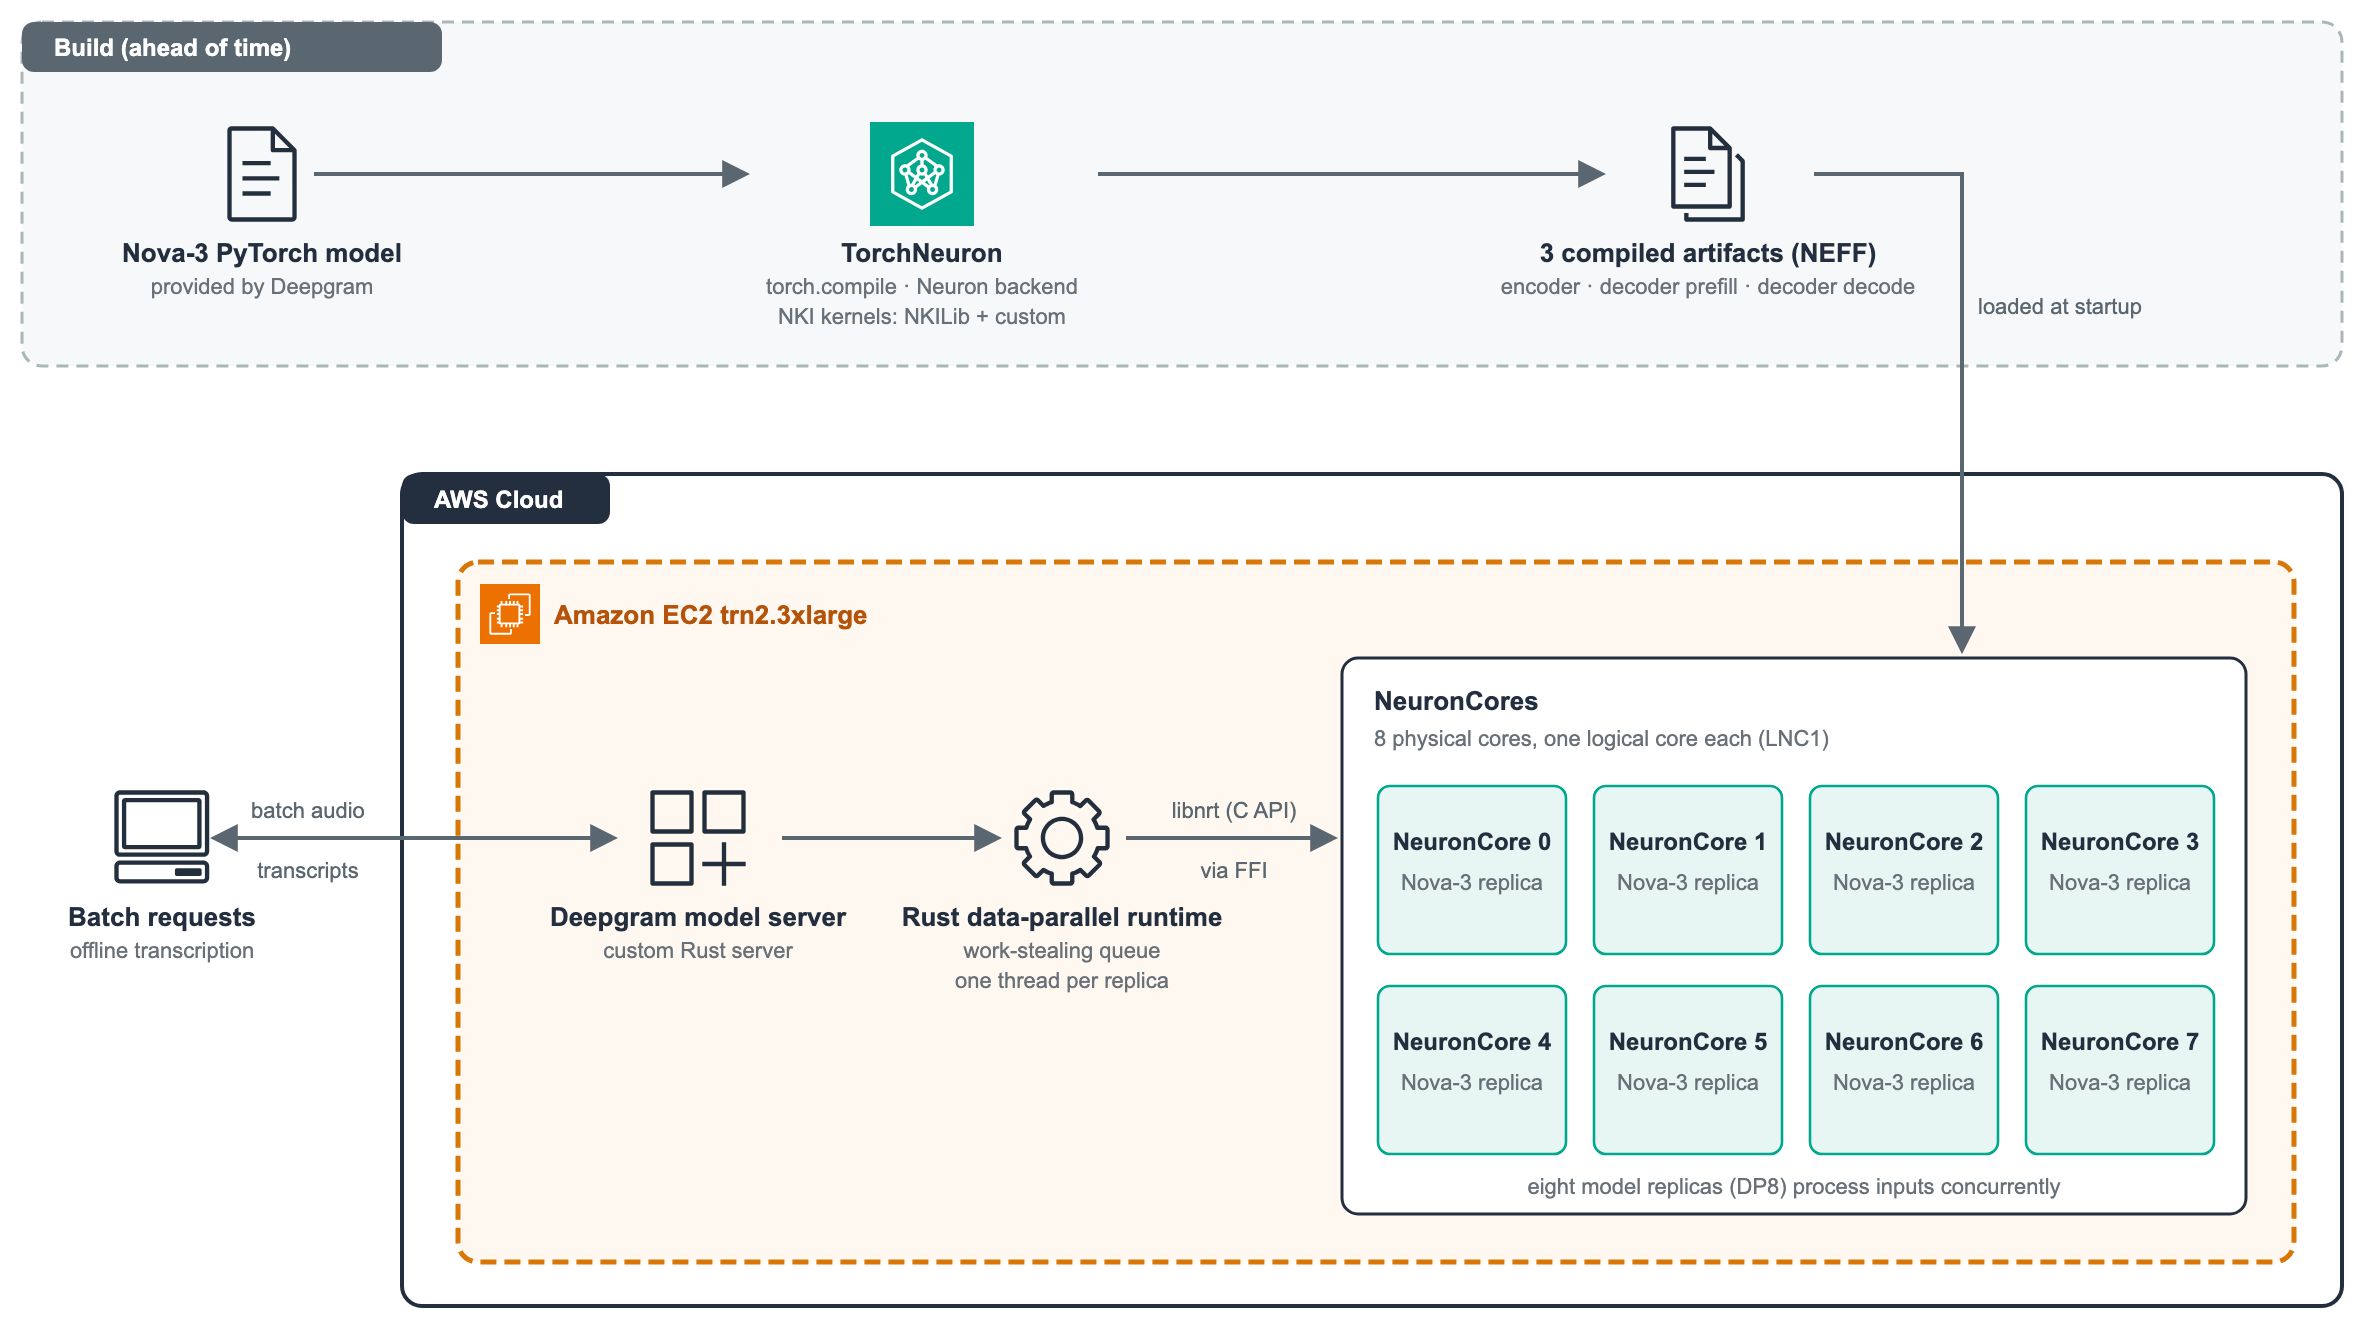
Figura 1: Deepgram Nova-3 en AWS Trainium2, compilado de antemano y servido desde Rust
Impacto en el ahorro de costos
Medimos el precio-rendimiento como audio procesado por dólar. En las cargas de trabajo en lotes orientadas a la velocidad de procesamiento offline de Deepgram, la configuración Trainium2 para un solo dispositivo (trn2.3xlarge) procesaba entre 11 y 70 por ciento más audio por dólar que las opciones de computación que había utilizado Deepgram.
Conclusión
En este artículo, demostramos cómo Deepgram y el puerto AWS FDE portaron el modelo de speech-to-text de Nova-3 de PyTorch a hardware Trainium utilizando TorchNeuron, que proporciona una integración nativa con el framework PyTorch para AWS Trainium. Mejoramos el rendimiento reemplazando las capas directamente con kernels preconstruidos de NKILib. Luego evaluamos el rendimiento mediante Neuron Explorer y utilizamos las habilidades de perfilaje del Neuron Agentic Development (NAD) para consultar los datos de perfilaje y acelerar la resolución de problemas de rendimiento. Basándonos en estos hallazgos, adaptamos el código fuente del kernel utilizando las habilidades de escritura de kernel de NAD. Finalmente, desarrollamos un runtime ligero en Rust para datos paralelos para AWS Trainium, que llama a la API de Neuron Runtime desde Rust. Nuestra configuración demostró ahorros de costos en escenarios orientados a el rendimiento offline, validando a AWS Trainium como una opción viable y eficiente para los trabajos de inferencia de Deepgram.
Para probar este enfoque en sus propios modelos, comience con la documentación de AWS Neuron, que abarca el compilador, el tiempo de ejecución y los frameworks soportados. La guía de la Interfaz del Kernel Neuron (NKI) explica cómo escribir los kernels descritos en este artículo, y el repositorio de ejemplos NKI contiene los kernels de referencia desde los cuales partimos. La documentación de las herramientas para desarrolladores de Neuron abarca el análisis de rendimiento y las herramientas agentic que utilizamos aquí, incluyendo Neuron Explorer y Neuron Agentic Development. Para tamaños e precios, consulte Instancias Amazon EC2 Trn2. Para obtener ayuda en la definición de una puerta similar, contacte a AWS Forward Deployed Engineering.