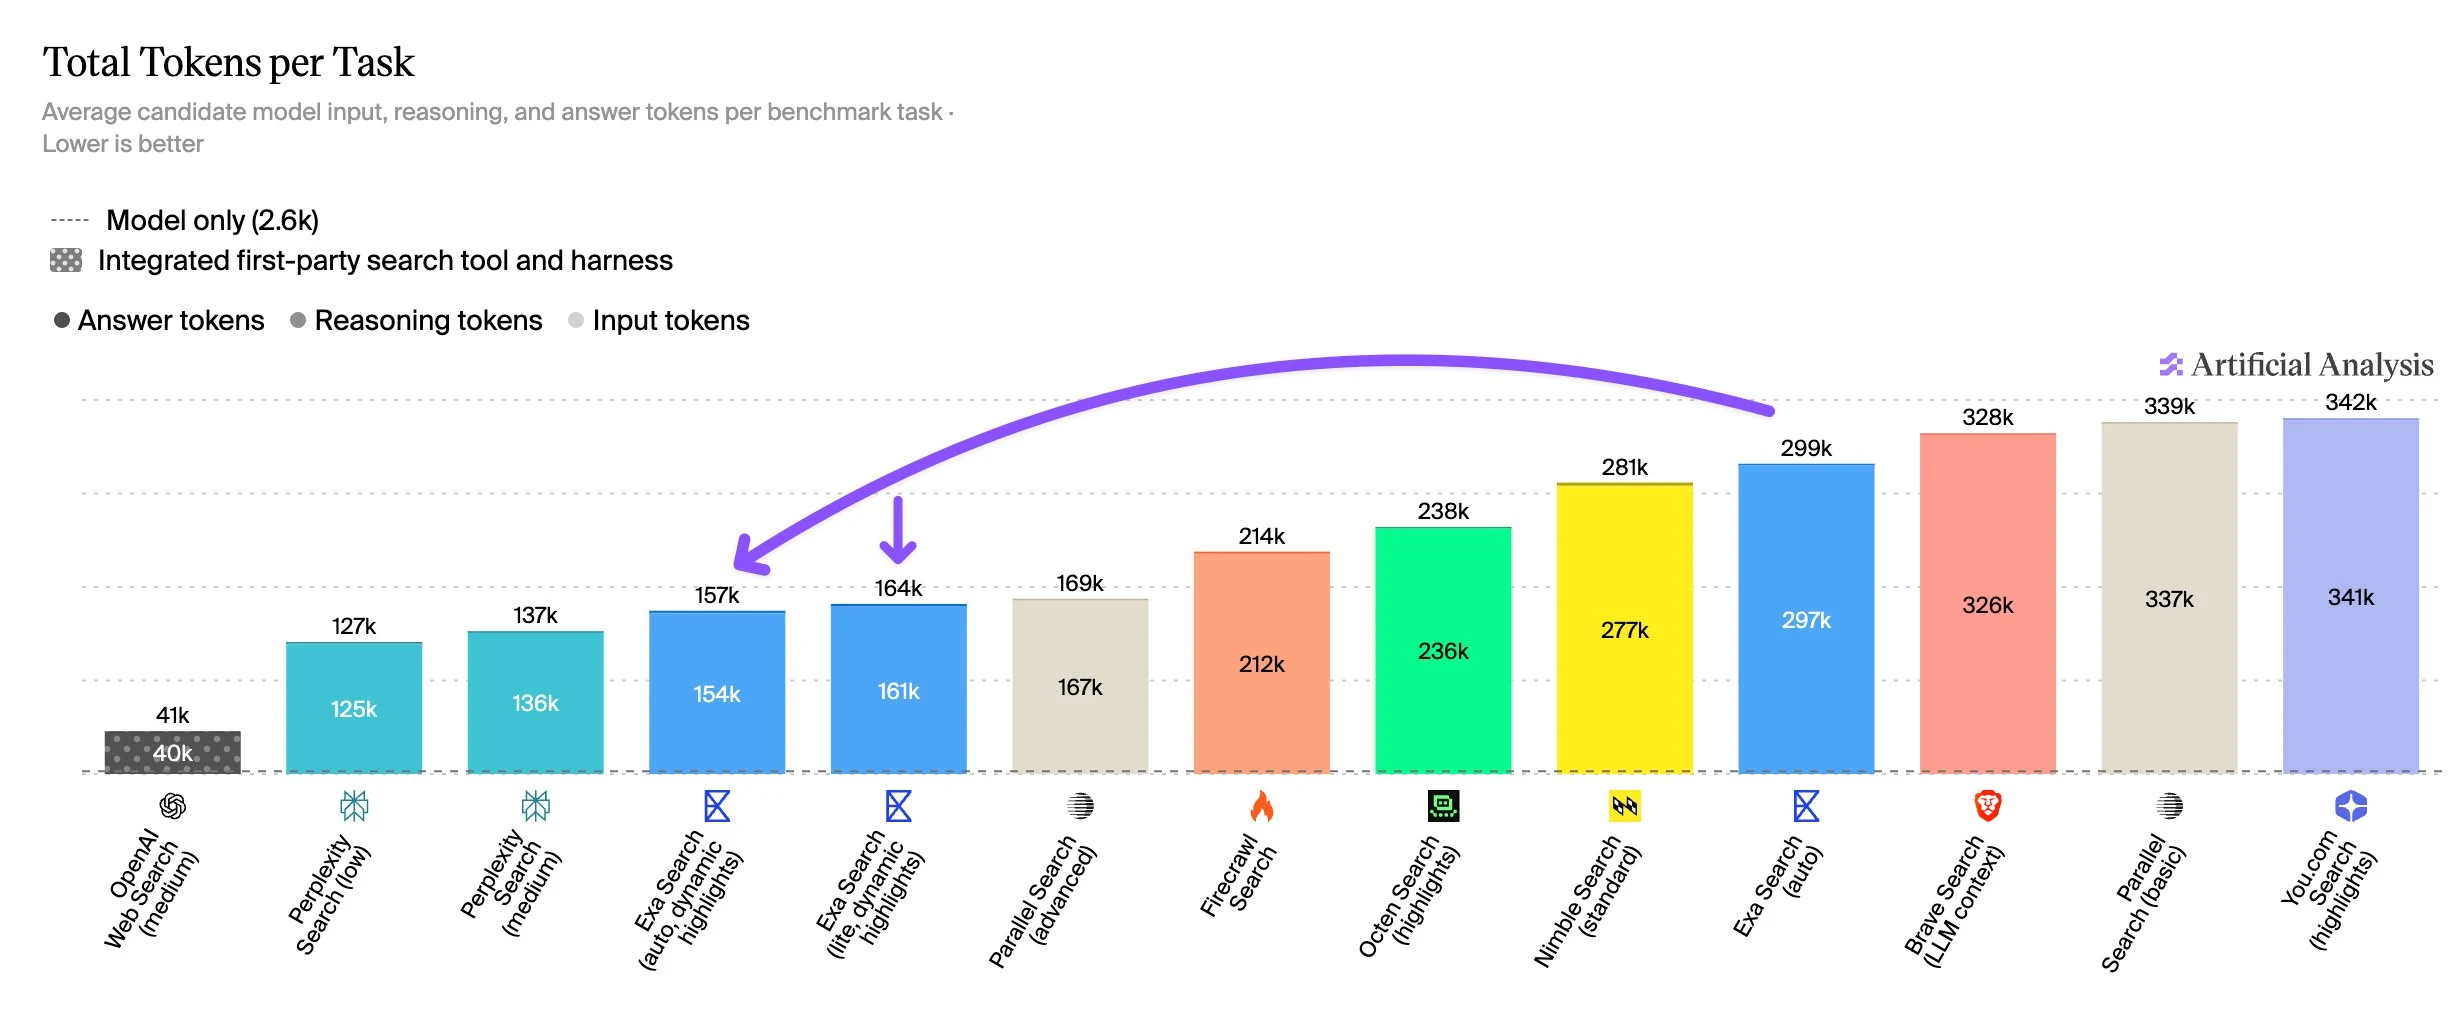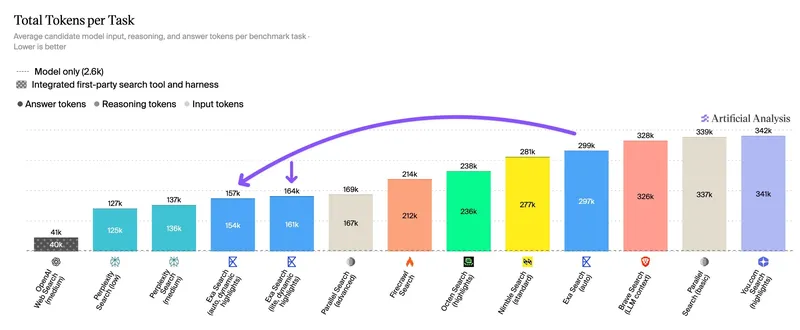
La cantidad total de tokens por tarea mide los tokens de entrada, razonamiento y salida del modelo
Exa (auto, Dynamic Highlights) utiliza 157k tokens por tarea, 47% menos que auto con highlight estándar (299k). Exa (lite, Dynamic Highlights) utiliza 164k tokens, una reducción del 45%.
Los Dynamic Highlights reducen la cantidad de contenido de búsqueda que se devuelve al modelo, disminuyendo así el consumo de tokens y los costos de inferencia del modelo. Entre las API de búsqueda, solo Perplexity (bajo, 127k) y Perplexity (mediano, 137k) utilizan menos tokens por tarea.