Anunciamos AA-PersonalityBench, nuestro nuevo benchmark de la personalidad de los modelos de lenguaje en 30 rasgos y su estilo de comunicación en 21 características
Dos modelos pueden dar respuestas igual de correctas y aun así sentirse muy diferentes de usar. AA-PersonalityBench mide esas diferencias para que las personas puedan entender cuál usar en distintos casos de uso. Algunos casos de uso como la escritura creativa pueden exigir imaginación, mientras que los casos de uso legales pueden exigir franqueza. Evaluamos las respuestas de los modelos a 900 preguntas seleccionadas para juzgar los Rasgos de Personalidad subjetivos y usamos medios programáticos para calcular las Características de Comunicación objetivas.
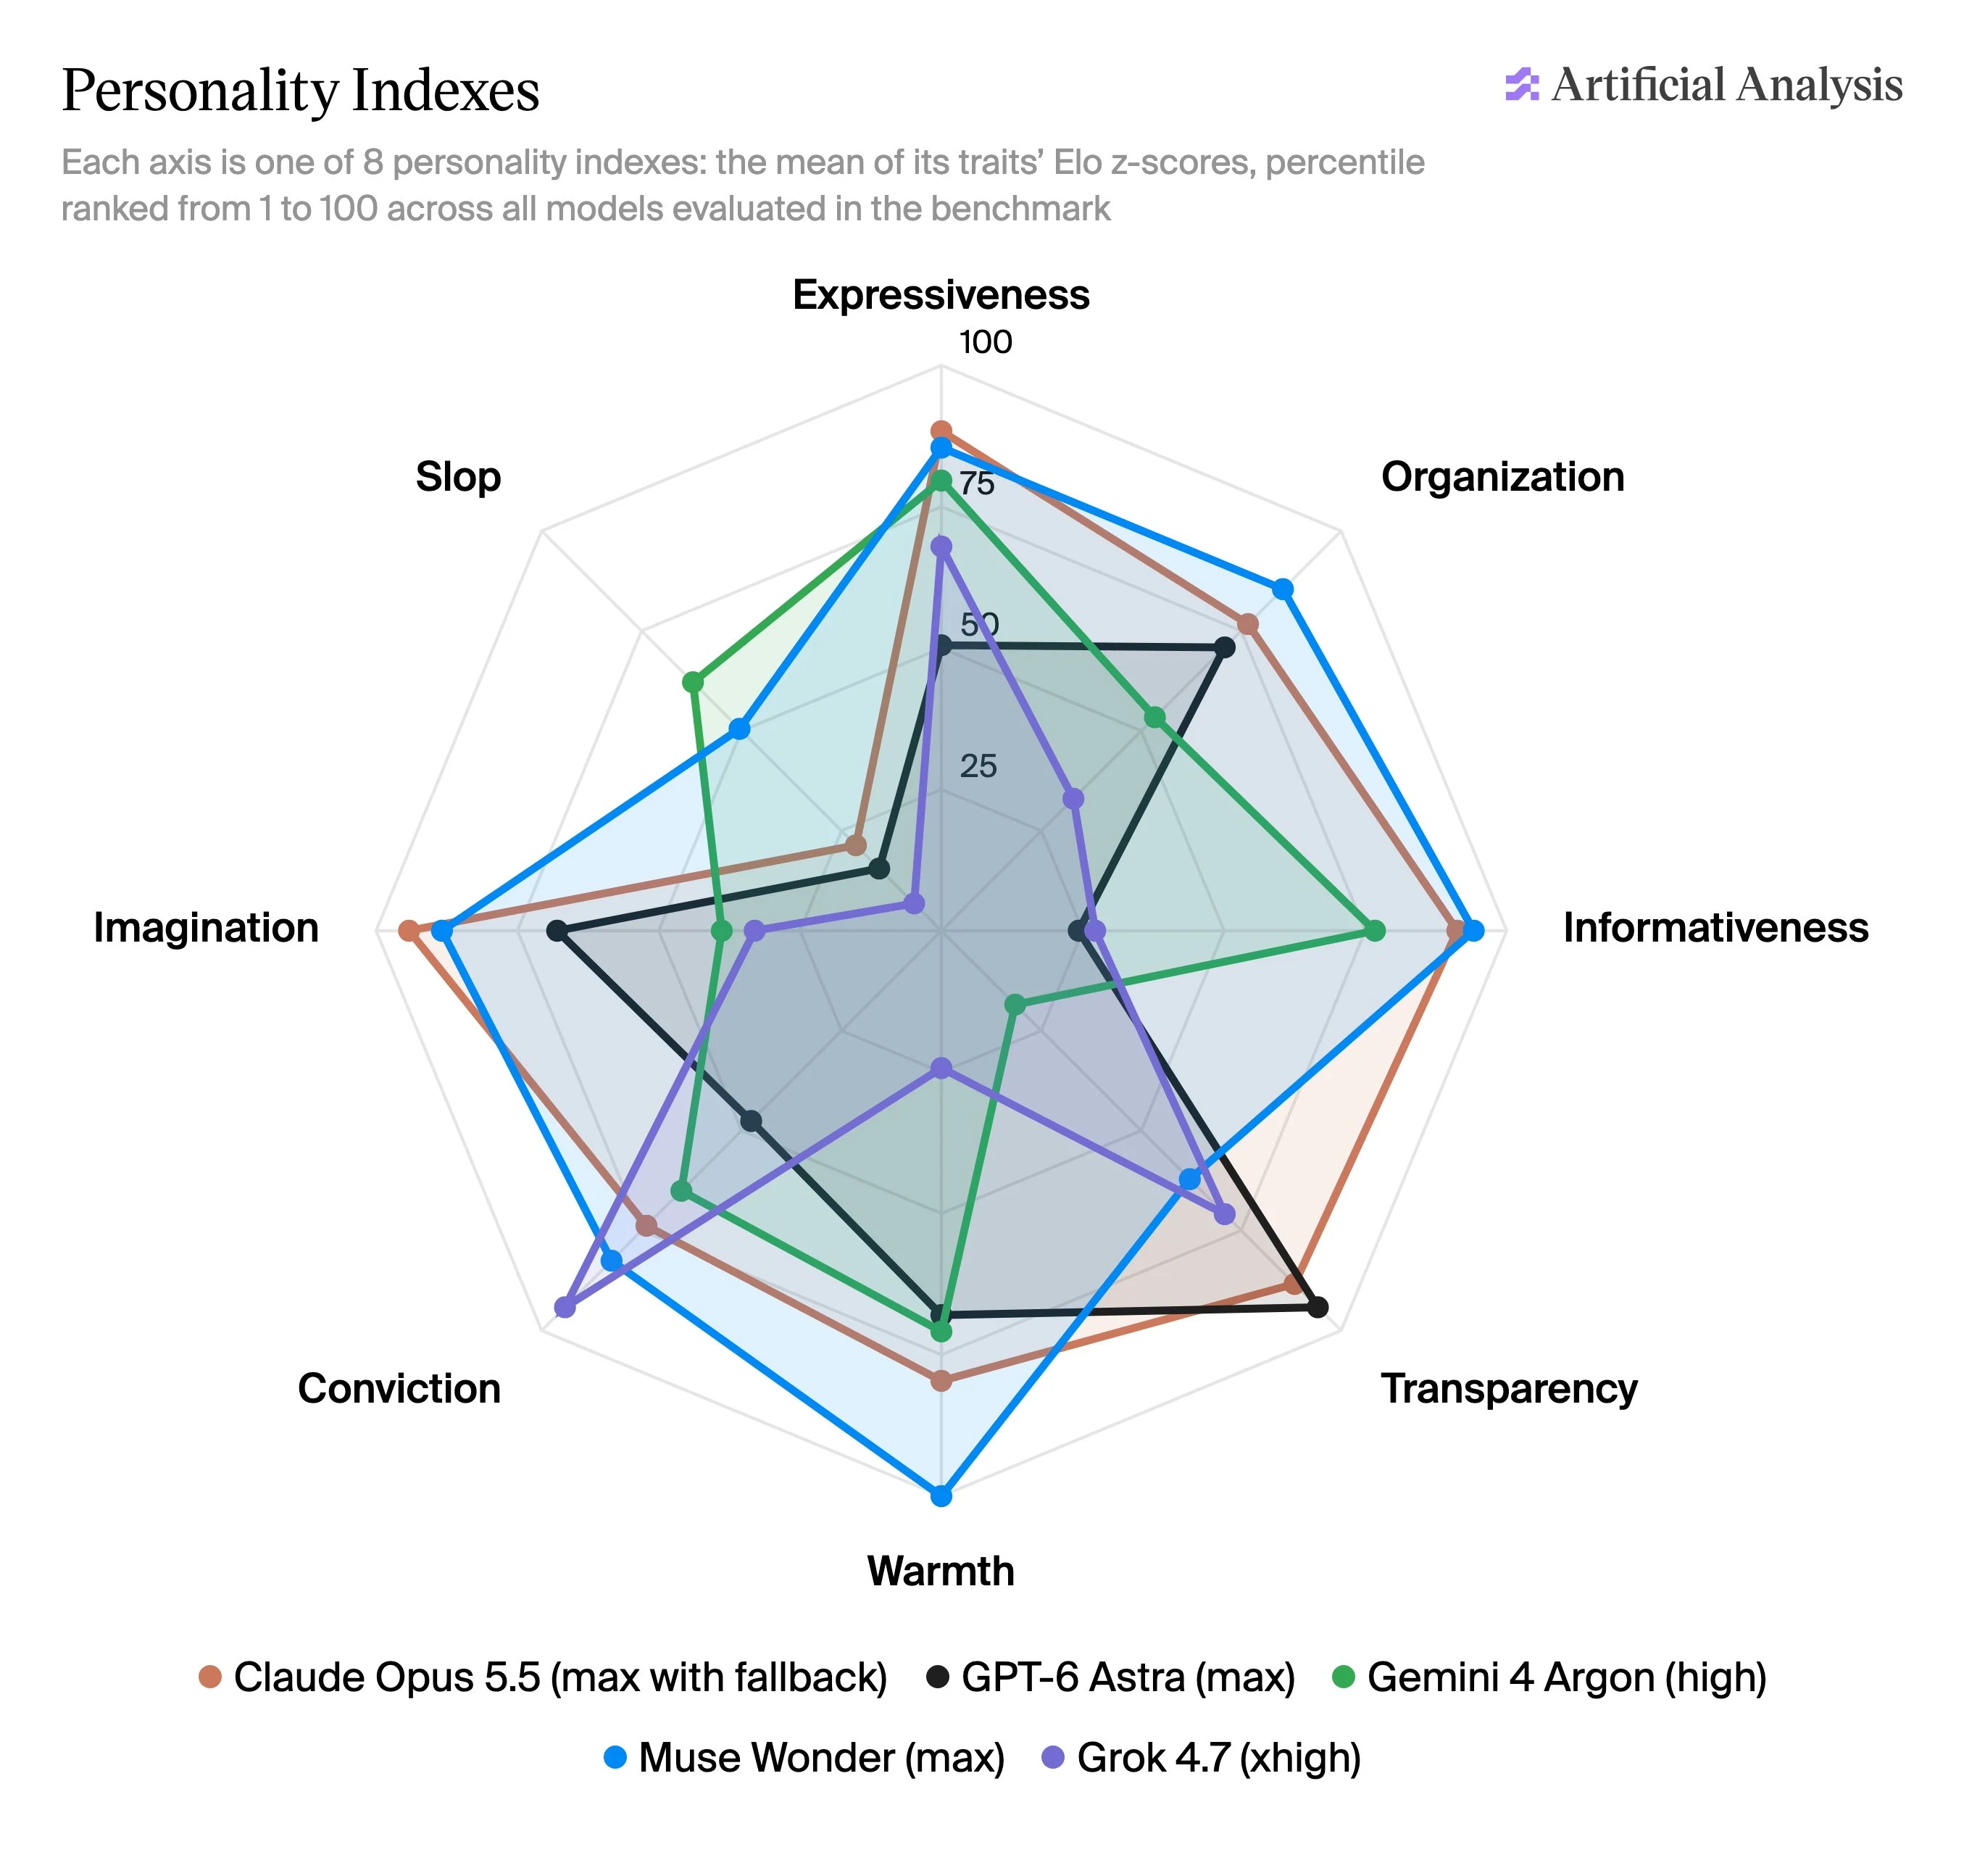
Rasgos e Índices de Personalidad &. Hay 30 rasgos de personalidad (p. ej., elocuente, pragmático, servil) que agrupamos en ocho Índices de Personalidad agregados: Expresividad, Organización, Informatividad, Transparencia, Calidez, Convicción, Imaginación y Slop. Cada rasgo tiene un conjunto de 30 preguntas dedicadas y las respuestas de los modelos se comparan por pares mediante un panel de jueces LLM. Luego calculamos puntuaciones z y percentiles de los Elos de rasgos y personalidad.
Modelos con la representación más fuerte en los 8 Índices de Personalidad:
➤ Expresividad: Claude Fable 5.1, GLM-5.3, GLM-5.3-Flash
➤ Organización: DeepSeek V4.1 Flash, Step 5 Preview, Inkling
➤ Informatividad: Muse Spark 1.3, Claude Fable 5.1, Muse Wonder, Claude Opus 5.5
➤ Transparencia: Claude Sonnet 5.5, Claude Fable 5.1, GPT-6 Astra
➤ Calidez: Muse Wonder, Muse Spark 1.3, Claude Fable 5.1
➤ Convicción: Claude Fable 5.1, DeepSeek V4.1 Flash, Grok 4.7
➤ Imaginación: Muse Spark 1.3, Claude Opus 5.5, GLM-5.3
➤ Slop: Llama 4 Maverick, GPT-4o, K2 Horizon
Características de Comunicación. Hay 21 características de comunicación (p. ej., longitud promedio de las oraciones, uso de emojis, uso de rayas) que agrupamos en cuatro categorías: longitud, estructura, puntuación y énfasis. Calculamos estas características de forma programática en todas las respuestas de los modelos.
➤ Longitud: Qwen3.8 27B promedia unas 1,030 palabras por respuesta, casi cuatro veces los 270 de GPT-6 Luna
➤ Estructura: Nemotron 3 Ultra promedia casi 3 tablas por respuesta, mientras que la mayoría de los modelos rara vez usan una
➤ Puntuación: GLM-5.3 promedia 7 rayas por respuesta, mientras que Claude Opus 5.5, Sonnet 5.5 y Haiku 5.5 casi nunca usan una
➤ Énfasis: K2 Horizon promedia más de 2 emojis por respuesta, mientras que la mayoría de los modelos casi nunca usan uno