
TorchNeuron proporciona un nuevo backend nativo para PyTorch en AWS Trainium. Transformers, Diffusers y Kernels lo soportan de forma nativa, lo que hace más fácil ejecutar modelos en Trainium y compartirlos en el hub de HF.
TorchNeuron
TorchNeuron es un plugin de PyTorch que proporciona un nuevo backend para Trainium, permitiendo el soporte para el modo eager, torch.compile y APIs distribuidas nativas como FSDP y TP.
Lea el blog de Pytorch para aprender más sobre TorchNeuron.
A partir del 20 de octubre de 2026, TorchNeuron estará disponible como una versión beta pública. Investigadores y desarrolladores podrán instalarlo con pip install torch-neuronx.
Nuevo backend, interfaz nativa en las bibliotecas de HF
Hasta ahora, la experiencia de Hugging Face en AWS Trainium e Inferentia —chips de IA diseñados respectivamente para el entrenamiento y la inferencia económicos a gran escala— se ha implementado a través de optimum-neuron. Esta biblioteca depende del paquete torch-neuronx, que se basa en PyTorch XLA. En ese momento, fue la opción natural, pero implicaba pensar como un compilador: tensores perezosos en lugar de ejecución activa, solo formas estáticas y recompilación para cada interrupción del grafo. Optimum Neuron existía para ocultar esa complejidad y mantenía código personalizado (clases de modelado, entrenadores, etc.) para ello.
TorchNeuron cambia esto. Se integra directamente en PyTorch y expone neuron como un dispositivo nativo, con ejecución eager, las primitivas distribuidas propias de PyTorch (DTensor, FSDP2) y torch.compile.
Para las bibliotecas de Hugging Face, Trainium se convierte en un dispositivo como cualquier otro: Transformers, Diffusers, Accelerate, PEFT y TRL funcionan directamente en él, con las mismas clases y scripts que se usarían en cualquier otro acelerador. A partir de ahora, recomendamos que los usuarios de Neuron utilicen estas bibliotecas directamente en lugar de pasar por Optimum Neuron.
Transformers
Inferencia
La generación de texto ahora está soportada de forma nativa en Transformers para una amplia gama de modelos. Con TorchNeuron, el 89% de las 100 arquitecturas de modelos de generación de texto más utilizadas están soportadas de inmediato, en comparación con el 46% en Optimum Neuron v0.4.5. Solo necesita pasar el argumento device_map=neuron en su código y su modelo se moverá a los dispositivos Neuron.
El siguiente es un ejemplo de generación de texto con paralelismo de tensores, lo que permitirá aprovechar al máximo su instancia Neuron. Tenga en cuenta que se utiliza un caché estático para la generación, ya que esto está fuertemente recomendado en Neuron para evitar compilaciones frecuentes.
import os

import torch
import torch.distributed as dist
import torch_neuronx  # noqa: F401
from torch.distributed import DeviceMesh
from transformers import AutoModelForCausalLM, AutoTokenizer, GenerationConfig
from transformers.distributed import DistributedConfig
from transformers.generation.configuration_utils import CompileConfig

MODEL_ID = "Qwen/Qwen3.8-27B"
MAX_SEQ_LEN = 1024
PREFILL_CHUNK_SIZE = 512

dist.init_process_group(backend="neuron")
world_size = dist.get_world_size()

model = AutoModelForCausalLM.from_pretrained(
    MODEL_ID,
    dtype=torch.bfloat16,
    distributed_config=DistributedConfig(tp_size=world_size),
    device_mesh=DeviceMesh("neuron", list(range(world_size))),
).eval()

tokenizer = AutoTokenizer.from_pretrained(MODEL_ID)
if tokenizer.pad_token is None:
    tokenizer.pad_token = tokenizer.eos_token
tokenizer.padding_side = "left"

inputs = tokenizer.apply_chat_template(
    [{"role": "user", "content": "The future of AI is"}],
    add_generation_prompt=True,
    padding=True,
    tokenizer_kwargs={"pad_to_multiple_of": PREFILL_CHUNK_SIZE},
    return_tensors="pt",
)

generation_config = GenerationConfig(
    max_new_tokens=128,
    do_sample=False,
    use_cache=True,
    pad_token_id=tokenizer.pad_token_id,
    eos_token_id=tokenizer.eos_token_id,
    cache_implementation="static",
    max_cache_len=MAX_SEQ_LEN,
    prefill_chunk_size=PREFILL_CHUNK_SIZE,
    compile_config=CompileConfig(backend="neuron", fullgraph=False, dynamic=False),
)

with torch.no_grad():
    output_ids = model.generate(
        inputs["input_ids"],
        attention_mask=inputs["attention_mask"],
        generation_config=generation_config,
    )

if dist.get_rank() == 0:
    prompt_len = inputs["input_ids"].shape[1]
    print(tokenizer.decode(output_ids[0, prompt_len:], skip_special_tokens=True))
Entrenamiento
Ahora que Neuron es un dispositivo nativo de PyTorch, el entrenamiento en Trainium utiliza las mismas bibliotecas de Hugging Face que cualquier otro acelerador: Transformers, Accelerate, PEFT y TRL. Ya no es necesario contar con un entrenador dedicado ni con una versión específica de código del modelo para Neuron. Una secuencia estándar de ajuste fino con TRL se ejecuta en una instancia de Trainium con solo algunas configuraciones específicas de Neuron.
Aquí hay un script de ajuste fino supervisado construido sobre SFTTrainer de TRL. Si ya has sometido un modelo a ajuste fino con TRL en GPU anteriormente, debería resultar familiar.
import os

import torch
from datasets import load_dataset
from transformers.distributed import DistributedConfig

from trl import ModelConfig, ScriptArguments, SFTConfig, SFTTrainer, TrlParser


def main(script_args, training_args, model_args):
    # The Neuron backend can't compile Dynamo's automatic dynamic shapes yet (https://github.com/huggingface/trl/issues/7660)
    torch._dynamo.config.automatic_dynamic_shapes = False

    training_args.model_init_kwargs = {
        "revision": model_args.model_revision,
        "trust_remote_code": training_args.trust_remote_code,
        "attn_implementation": model_args.attn_implementation,
        "dtype": model_args.dtype,
        "device_map": None,
    }
    if int(os.environ.get("WORLD_SIZE", "1")) > 1:
        # The model is sharded on the TP x FSDP grid as its weights are loaded
        training_args.model_init_kwargs["distributed_config"] = DistributedConfig(
            tp_size=int(os.environ.get("TP_SIZE", "1")),
            fsdp_size=int(os.environ.get("FSDP_SIZE", "1")),
        )

    # Prepare dataset
    train_dataset = load_dataset(
        script_args.dataset_name,
        name=script_args.dataset_config,
        split=script_args.dataset_train_split,
    )
    # UltraChat also has a string `prompt` column, which makes TRL treat it as a prompt-completion dataset.
    train_dataset = train_dataset.select_columns(["messages"])

    # Training
    trainer = SFTTrainer(
        model=model_args.model_name_or_path,
        args=training_args,
        train_dataset=train_dataset,
    )

    trainer.train()
    trainer.save_model(training_args.output_dir)
    trainer.end()


if __name__ == "__main__":
    parser = TrlParser((ScriptArguments, SFTConfig, ModelConfig))
    script_args, training_args, model_args = parser.parse_args_and_config()
    main(script_args, training_args, model_args)
El paralelismo se gestiona de forma nativa por Transformers. Se coloca un DistributedConfig con los tamaños de tensor-parallel (TP) y FSDP en model_init_kwargs, SFTTrainer lo pasa a from_pretrained, y el modelo se divide en shards a medida que se cargan sus pesos. El Trainer detecta que el modelo ya está distribuido y no lo vuelve a encapsular. No es necesario usar la flag --fsdp ni una configuración de FSDP para Accelerate.
Nada en el script está vinculado a Trainium: el mismo código funciona en cualquier hardware. Hay algunas cosas que vale la pena saber cuando se ejecuta en Trainium:
- Formas estáticas. El script desactiva las formas dinámicas automáticas en
torch.compiley utiliza el empaquetamiento envuelto para generar secuencias de hasta 2048 tokens. Con TRL ≥ 1.16, los lotes en Neuron se rellenan con un múltiplo de 128 tokens, lo que limita el número de formas de entrada. Los grafos compilados se reutilizan para los pasos siguientes con las mismas formas. torch.compileactivado. Solo es necesario pasar el parámetro--torch_compile true: en una instancia de Trainium,torch.compiledetecta el dispositivo y selecciona automáticamente el backend Neuron, sin necesidad de configurar nada más.- Carga de peso asíncrona desactivada. La carga de peso asíncrona integrada en Transformers no está soportada en Neuron, por lo que, por ahora, la desactivamos con
HF_DEACTIVATE_ASYNC_LOAD=1.
La comandos abajo inicia el entrenamiento con torchrun, que inicia un proceso por cada NeuronCore. TP_SIZE y FSDP_SIZE establecen el diseño de paralelismo, y su producto es el número de procesos: aquí 4 x 8 = 32, que coincide con --nproc_per_node. Los 32 procesos forman una red de 4 x 8. El paralelismo de tensores divide cada capa entre las 4 núcleos de un grupo TP, y FSDP distribuye los parámetros, gradientes y estado del optimizador entre los 8 grupos TP.
TP_SIZE=4 FSDP_SIZE=8 HF_DEACTIVATE_ASYNC_LOAD=1 uv run torchrun --nproc_per_node=32 sft_neuron_example.py \
    --model_name_or_path Qwen/Qwen3-8B \
    --dataset_name HuggingFaceH4/ultrachat_200k \
    --dataset_train_split train_sft \
    --output_dir Qwen3-8B-sft-tp4-fsdp8 \
    --dtype bfloat16 \
    --max_length 2048 \
    --packing true \
    --packing_strategy wrapped \
    --learning_rate 2e-5 \
    --warmup_steps 0.03 \
    --num_train_epochs 1 \
    --logging_steps 2 \
    --per_device_train_batch_size 4 \
    --gradient_accumulation_steps 4 \
    --save_only_model true \
    --torch_compile true
Lo ejecutamos en 8 chips Trainium2 (32 NeuronCores), lo que representa la mitad de una instancia trn2.48xlarge.
Las sesiones de entrenamiento se completan, y trainer.save_model escribe un punto de control estándar de Transformers. Nada en él está vinculado a Neuron: se puede subir al Hugging Face Hub tal cual y cargarlo en cualquier otro hardware.
Diffusers
Inferencia
Muchos pipelines de la biblioteca Diffusers son compatibles con TorchNeuron en modo eager y compilado. FLUX.1-dev, FLUX.2, Qwen-Image, Qwen-Image-2.1 y H3 también son compatibles con el paralelismo de tensores para aprovechar al máximo sus dispositivos Neuron. A continuación, hay un ejemplo que muestra cómo puede utilizar TP:
import torch, torch.distributed as dist, torch_neuronx # TP
from torch.distributed.device_mesh import DeviceMesh # TP
from diffusers import QwenImage21Pipeline, QwenImage21Transformer2DModel, TensorParallelConfig

# Distributed devices initialization
dist.init_process_group(backend="neuron") # TP
dev = torch.neuron.current_device()
mesh = DeviceMesh("neuron", list(range(8))) # TP=8

# Pipeline initialization
model = "Qwen/Qwen-Image-2.1"
transformer = QwenImage21Transformer2DModel.from_pretrained(
    model,
    subfolder="transformer",
    torch_dtype=torch.bfloat16,
    parallel_config=TensorParallelConfig(mesh=mesh), # TP
)
pipe = QwenImage21Pipeline.from_pretrained(
    model,
    transformer=transformer,
    torch_dtype=torch.bfloat16,
)
pipe.vae.to(dev)
pipe.transformer.compile_repeated_blocks(backend="neuron", fullgraph=True, dynamic=False)

# Image generation
emb, mask, _ = pipe.encode_prompt(prompt="A capybara wearing a wizard hat, oil painting", device="cpu")  # text encoder stays on CPU
image = pipe(
    prompt_embeds=emb.to(dev),
    prompt_embeds_mask=mask.to(dev) if mask is not None else None,
    height=1024,
    width=1024,
    num_inference_steps=40,
    generator=torch.Generator("cpu").manual_seed(0), # same noise on every rank
).images[0]
if dist.get_rank() == 0:
    image.save("out.png")
Puede ejecutar este fragmento de código con: NEURON_LOGICAL_NC_CONFIG=2 torchrun --nproc_per_node=8 run.py.
Cada vez más pipelines serán compatibles con TP. Si un pipeline que te gusta no lo es, también puedes añadir soporte para él siguiendo este guía.
Kernels
Asegúrese de echar un vistazo a los kernels del equipo Neuron, ya que cada vez más kernels de Neuron estarán disponibles en el Hub para acelerar sus modelos. Los kernels de Neuron pueden escribirse utilizando la Interfaz de Kernel de Neuron (NKI), lo que permite un control más bajo para optimizar las operaciones. De esta manera, los usuarios pueden ejecutar sus propias operaciones personalizadas y compartirlas en el Hub.
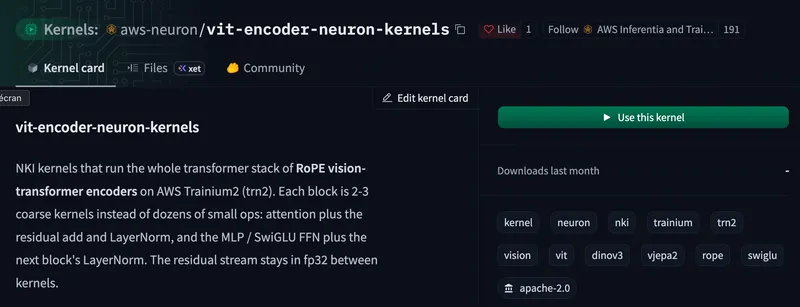
Puedes usar, por ejemplo, este kernel para acelerar tus transformadores de visión con un aumento de velocidad de hasta x2.4 en Trainium.

Agradecimientos
Agradecimientos especiales al equipo de AWS por su trabajo en TorchNeuron y por su reacción a nuestros comentarios para que la integración con HF sea lo más buena posible.