
Tradicionalmente, cambiar el número de GPUs en un servicio de vLLM requería agregar o eliminar réplicas completas del modelo o reiniciar el motor con un número diferente de GPUs. A medida que los modelos crecen, cada réplica necesita más GPUs, por lo que el escalado por réplica agrega o elimina GPUs en incrementos cada vez mayores. Reiniciar vLLM para escalar DeepSeek V4 Pro de 16 a 20 GPUs GB200 detuvo el servicio durante 197 segundos (véase la sección de rendimiento para más detalles), dejando esas costosas GPUs asignadas sin generar tokens.
En nuestro primer artículo sobre Elastic EP, mostramos cómo vLLM podía agregar o eliminar GPUs de un despliegue DEP en ejecución (atención con paralelismo de datos y MoE con paralelismo de expertos) sin reiniciarlo. Aunque evitamos un reinicio, el servicio se detuvo durante toda la reconfiguración mientras inicializábamos nuevos workers, preparábamos los grupos de comunicación ampliados, cargábamos los pesos del modelo y repetíamos el calentamiento de kernels y la captura de CUDA graphs. En nuestro benchmark de DeepSeek V4 Pro, esta pausa duró 100 segundos al escalar de 16 a 20 GPUs y 56 segundos al volver a escalar a 16 GPUs (detalles completos en la sección de rendimiento).
En este artículo, describimos cómo la preparación asíncrona y NIXL EP permitieron la reconfiguración de Elastic EP con tiempo de inactividad casi nulo. En el mismo benchmark, redujimos el tiempo de inactividad a 0.82 segundos al escalar de 16 a 20 GPUs y 1.96 segundos al volver a escalar a 16 GPUs, lo que nos permitió escalar hacia arriba y hacia abajo con casi ningún impacto en el rendimiento del servicio.
Superposición de la preparación de la topología con el servicio
Reorganizamos el flujo de reconfiguración de vLLM en dos fases: preparación en segundo plano y un commit breve. Los workers existentes usan hilos de fondo separados para preparar y calentar la comunicación objetivo, transferir los pesos del modelo y sincronizar la información relacionada con la ejecución (como los resultados de autotuning) con los workers que se unen, mientras continúan atendiendo solicitudes con sus grupos de comunicación y CUDA graphs actuales. En paralelo, los workers que se unen se inicializan, reciben los pesos del modelo y preparan su comunicación y ejecución en GPU. Durante la fase de commit, vLLM pausa brevemente sus schedulers, activa la topología preparada y reanuda el servicio. Estos cambios se introdujeron en preparación asíncrona y optimizaciones de prepare/commit.
La preparación cubre cuatro tareas principales:
- Inicializar los workers que se unen. Iniciar sus procesos y asignar almacenamiento para el modelo y la ejecución.
- Preparar la comunicación. Configure los grupos de comunicación objetivo y expanda el comunicador EP.
- Transferir los pesos del modelo. Transferir los pesos necesarios desde los workers existentes hacia los workers que se incorporan a través de NVLink o RDMA.
- Preparar la ejecución. Completar la compilación requerida, el calentamiento de kernels, la configuración de ajuste y la construcción de CUDA graphs en los workers que se incorporan.
Después de la fase de commit, el balanceo de carga Expert Parallel Load Balancing (EPLB) asíncrono permite que los nuevos workers comiencen a manejar la atención mientras los workers existentes manejan el cómputo de expertos. EPLB luego redistribuye los expertos a través del grupo expandido en segundo plano.
El principal desafío es preparar la comunicación y la ejecución en GPU sin involucrar ni interrumpir a los workers que están atendiendo solicitudes.
Expandir la comunicación EP in situ
Antes de NIXL EP, los backends de comunicación EP disponibles en vLLM usaban membresía fija: cada instancia se creaba para un conjunto específico de ranks. Agregar o eliminar ranks requiere una nueva instancia. Incluso cuando esa instancia puede crearse en segundo plano, quedan dos problemas.
Primero, las instancias antigua y nueva necesitan buffers de comunicación y otros recursos separados, incluidos registros de memoria, IPC handles y RDMA Queue Pairs (QPs). Mantener ambas instancias activas aumenta el uso de memoria de comunicación y requiere repetir la configuración en lugar de reutilizar los recursos existentes.
Segundo, cambiar de comunicadores EP cambia los buffers y el estado de comunicación utilizados por los kernels de comunicación EP. Esto invalida los CUDA graphs capturados previamente, que deben recapturarse antes de que pueda reanudarse el servicio. Eso requiere repetir el calentamiento y la construcción de graphs para muchas formas de batch en todos los workers retenidos. En nuestro benchmark de DeepSeek V4 Pro, incluso con preparación asíncrona, realizar el calentamiento y la recaptura de graphs durante la fase de commit resultó en pausas de servicio de 58 segundos durante el scale-up y 44 segundos durante el scale-down.
Para resolver estos problemas, diseñamos NIXL EP, una biblioteca de comunicación EP hecha a medida para Elastic EP. Agrega o elimina ranks in situ, reutilizando el mismo agente NIXL, buffers y conexiones. Los nuevos peers pueden conectarse mientras los workers existentes continúan atendiendo, y solo los peers que se incorporan necesitan nuevas conexiones y registros. NIXL EP también mantiene válidas las entradas de dispatch y combine de EP capturadas a través de las reconfiguraciones, permitiendo que los workers retenidos reutilicen sus CUDA graphs existentes.
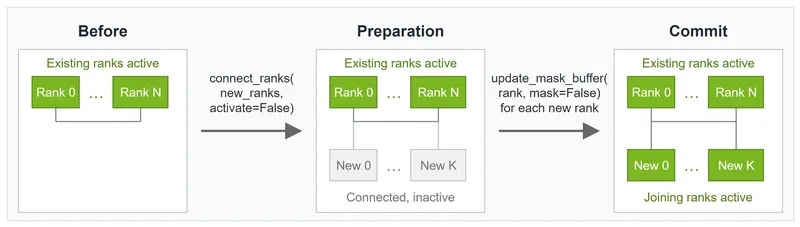
Durante la preparación, el hilo secundario de vLLM conecta a los pares que se unen sin activarlos. La fase de commit activa entonces a los pares preparados sin reemplazar el comunicador.
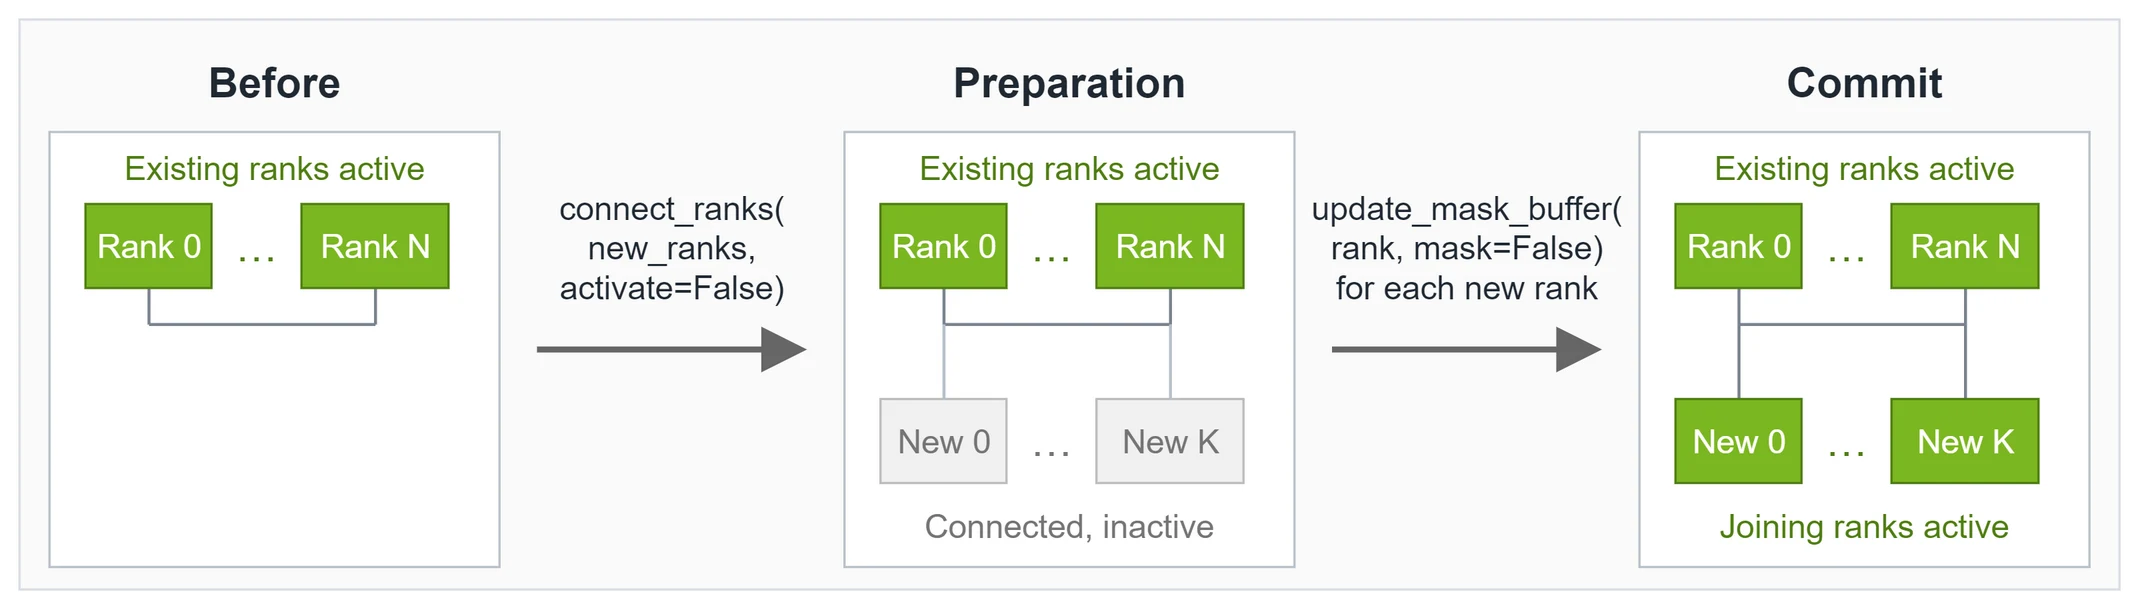
Figura 1. Conexión y activación de nuevos pares EP. Los rangos verdes están activos; los rangos grises están conectados pero enmascarados. Durante la fase de commit, los nuevos pares se activan sin reemplazar el agente ni los búferes.
vLLM sigue creando nuevos grupos de coordinación DP y grupos EPLB para la topología objetivo, pero su comunicación se ejecuta fuera del paso hacia adelante capturado del modelo, por lo que cambiar a ellos no invalida los CUDA graphs.
Preservar los CUDA graphs en los workers existentes
Un CUDA graph registra las operaciones de GPU para que vLLM pueda reproducir un paso hacia adelante sin lanzar repetidamente cada operación desde la CPU. Un nodo de kernel capturado incluye su configuración de lanzamiento y los valores de sus argumentos, incluidos los punteros a los tensores de entrada y salida. El contenido de la memoria puede cambiar entre reproducciones, pero los punteros registrados deben seguir siendo válidos. Estos requisitos forman parte del contrato de ejecución de CUDA graphs.
vLLM captura graphs separados para diferentes formas de lote y modos de ejecución y ejecuta pasos hacia adelante de calentamiento antes de cada captura.
Preservar los CUDA graphs capturados requiere más que mantener vivo el objeto comunicador. NIXL EP también mantiene estables las configuraciones de lanzamiento de kernels, los argumentos de comunicación visibles en el graph y las direcciones de los tensores de entrada y salida durante la reconfiguración. Sus kernels leen la pertenencia al grupo activo desde un estado del dispositivo que puede actualizarse in situ.
También modificamos vLLM para mantener estables los argumentos capturados, las configuraciones de lanzamiento y las direcciones de los tensores de entrada y salida de los kernels de cómputo circundantes durante la reconfiguración:
- Reutilizamos los objetos de ejecución fused-MoE retenidos de los workers en lugar de reconstruirlos para un tamaño de EP activo diferente.
- Mantenemos estables las direcciones y los diseños de los workspaces visibles en el graph y de las salidas de dispatch durante la reconfiguración, de modo que los kernels de expertos capturados puedan seguir usándolos. Las salidas de dispatch también sirven como entradas para el cálculo de los expertos. Si sus direcciones o diseños cambiaran con el tamaño del EP, los kernels de expertos capturados seguirían usando los punteros y desplazamientos antiguos.
- Preservamos el almacenamiento de respaldo de los tensores de enrutamiento de expertos y actualizamos los mapeos in situ. Esto permite que EPLB cambie el contenido de los mapeos sin mover los tensores utilizados por los kernels capturados.
En conjunto, estos cambios permiten que los workers retenidos reutilicen sus CUDA graphs existentes tanto después de un escalado hacia arriba como hacia abajo.
Preparar a los workers que se unen de forma independiente
Los workers existentes tienen graphs que preservar. Los workers que se unen no tienen ninguno.
Los workers que se unen normalmente se preparan ejecutando pasos hacia adelante del modelo con dispatch y combine de EP, además de intercambiar información de lote con otros workers. Estos pasos requieren la participación de otros workers, pero los workers existentes ya están atendiendo solicitudes reales en la topología actual.
NIXL EP permite que cada worker que se une enmascare temporalmente a todos los pares EP remotos durante el calentamiento y la preparación de graphs. Solo el rango local de ese worker está activo para la comunicación EP. También modificamos vLLM para que estos pasos de preparación no esperen la información de lote DP de otros workers. Esto permite que los workers que se unan ejecuten sus lotes ficticios y capturen CUDA graphs sin requerir la participación de los workers existentes.
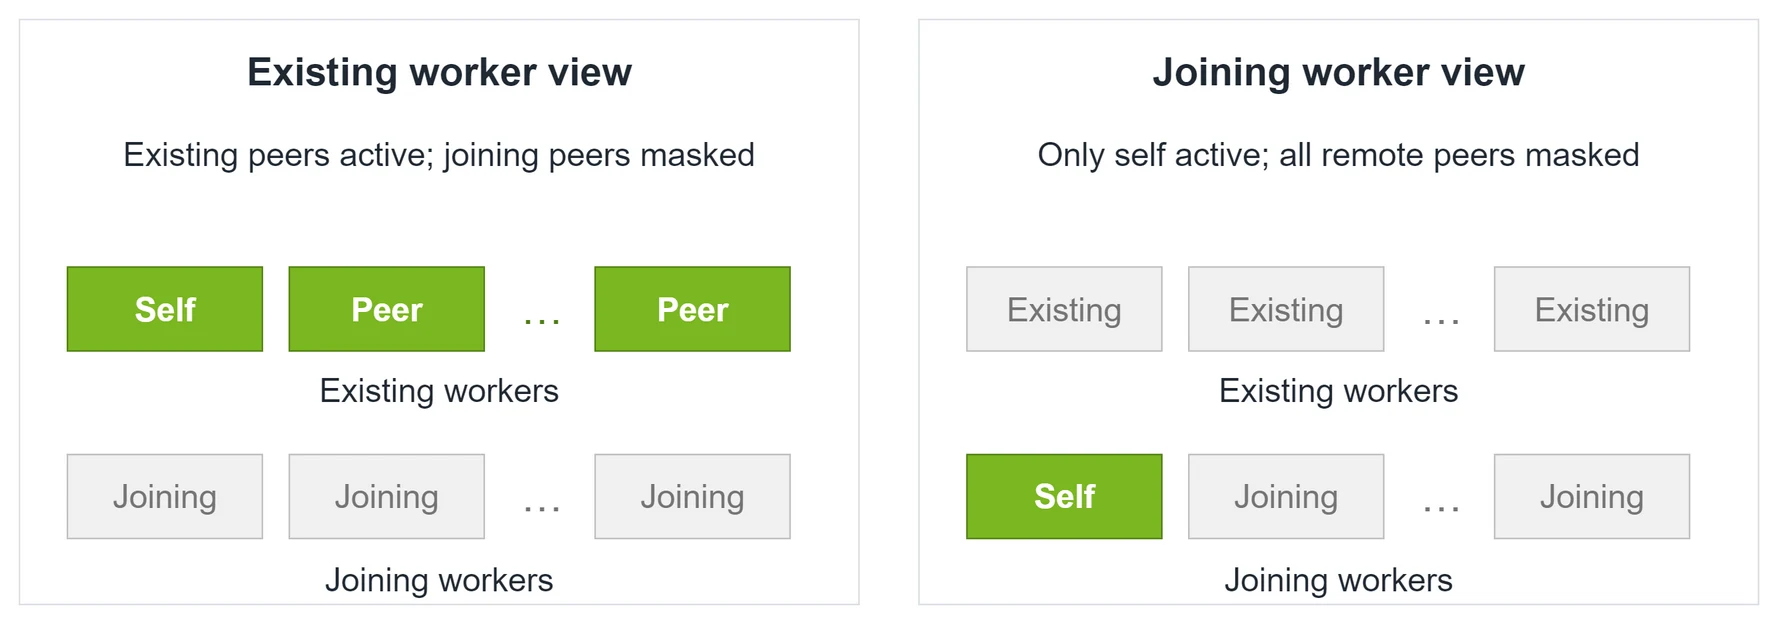
Figura 2. Los rangos verdes están activos para la comunicación EP; los rangos grises están enmascarados. Los workers existentes sirven juntos mientras cada worker que se une enmascara a todos los pares EP remotos para la preparación.
Después de la captura, NIXL EP puede reactivar a los pares sin invalidar los graphs. Los workers que se unen reutilizan sus graphs capturados localmente cuando comienzan a servir como parte del grupo ampliado.
Rendimiento en DeepSeek V4 Pro
Todos los experimentos de esta sección utilizaron DeepSeek V4 Pro en GPUs GB200, con TP=1 y tamaños de DP/EP de 16 y 20. Los pesos del modelo se descargaron previamente en formato safetensors en almacenamiento Lustre compartido y se cargaron usando el --load-format autopor defecto. Las mediciones utilizaron cachés de compilación de kernels calientes (Triton, TileLang y FlashInfer).
Tiempos de escalado hacia arriba y hacia abajo
La tabla muestra qué etapas se ejecutan mientras la prestación del servicio está en pausa y cuáles se ejecutan en segundo plano mientras los trabajadores existentes siguen sirviendo.
| Etapa | A: Bloqueante | B: Preparación asíncrona | C: Preparación asíncrona + reutilización de grafos |
|---|---|---|---|
| Inicializar los trabajadores que se incorporan | Servicio en pausa | Segundo plano | Segundo plano |
| Preparar la comunicación de destino | Servicio en pausa | Segundo plano | Segundo plano |
| Transferir los pesos del modelo | Servicio en pausa | Segundo plano | Segundo plano |
| Warmup y captura de grafo en los workers que se unen | Servicio en pausa | Servicio en pausa | Segundo plano |
| Warmup y captura de grafo en los workers existentes | Servicio en pausa | Servicio en pausa | No es necesario (los grafos existentes siguen siendo válidos) |
| Activar la topología de destino | Servicio en pausa | Servicio en pausa | Servicio en pausa |
La configuración C es compatible solo con NIXL EP.
- Tiempo de inactividad: la interrupción del servicio observada, cuando las solicitudes en curso dejan de avanzar y no se admiten nuevas solicitudes.
- Tiempo total: la duración de toda la operación de escalado, incluida la preparación.
Las dos duraciones se miden por separado.
| Métrica | A: Bloqueante | B: Preparación asíncrona | C: Preparación asíncrona + reutilización de grafos |
|---|---|---|---|
| 16 a 20 GPUs: tiempo de inactividad | 99.62 s | 58.04 s | 0.82 s |
| 20 a 16 GPUs: tiempo de inactividad | 56.25 s | 44.07 s | 1.96 s |
| 16 a 20 GPUs: tiempo total | 99.72 s | 97.27 s | 92.34 s |
| 20 a 16 GPUs: tiempo total | 56.21 s | 51.46 s | 9.32 s |
Todas las configuraciones pasaron las comprobaciones de corrección numérica, incluidas las comprobaciones en cada worker que se incorporaba.
Mantener el SLO mientras se añaden GPUs
Servimos DeepSeek V4 Pro en 16 GPUs y luego aumentamos gradualmente la tasa de solicitudes entrantes de unos 8 a 16 solicitudes por segundo. Reprodujimos el mismo escenario de 11,391 solicitudes contra tres despliegues: uno se mantuvo en 16 GPUs, otro se reinició con 20 GPUs y otro escaló a 20 GPUs usando Elastic EP con NIXL EP. El objetivo de nivel de servicio (SLO) fue un p95 móvil del tiempo hasta el primer token por debajo de 5 segundos.
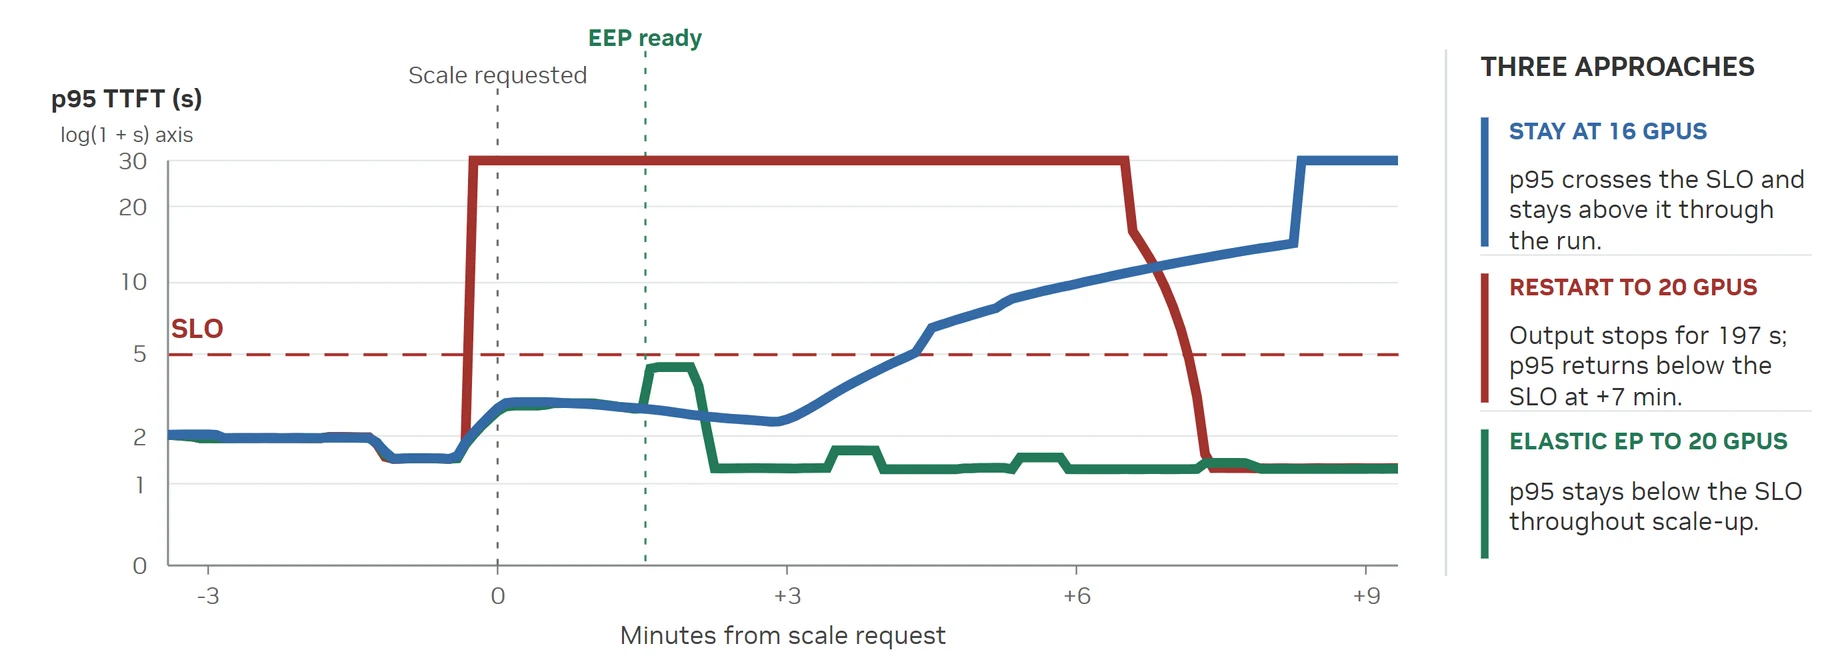
Figura 3. Servicio de extremo a extremo bajo una carga de solicitudes creciente. Las curvas muestran resultados de p95 móvil de 30 segundos, con las solicitudes fallidas asignadas a una penalización de 30 segundos en lugar de un TTFT medido.
- Elastic EP completó las 11,391 solicitudes y se mantuvo por debajo del SLO durante todo el escenario.
- Durante la preparación, Elastic EP igualó el rendimiento de servicio del despliegue estático de 16 GPUs, sin degradación visible debida a la preparación en segundo plano.
- Tras el escalado, Elastic EP igualó el rendimiento del despliegue recuperado de 20 GPUs, sin degradación visible después del escalado.
Prueba Elastic EP
La preparación en segundo plano, la reutilización de grafos CUDA y la captura independiente de grafos en los workers que se incorporan están disponibles hoy en las últimas versiones de vLLM y NIXL . Instálalos con pip y empieza a usar Elastic EP.
Para ver un ejemplo de uso completo, consulta el cuda_graphs_heavy_nixl_ep caso en la prueba de Elastic EP de vLLM. El ejemplo incluye la configuración del servidor y las llamadas a la API de escalado. Escala de dos GPUs a cuatro y de vuelta mientras envía solicitudes, comprobando el servicio durante la preparación y la precisión del modelo alrededor de cada cambio de tamaño.
¿Qué viene después?
Restaurar workers calientes con Dynamo Snapshot
Hemos resuelto eficazmente la larga interrupción del servicio. El siguiente desafío es tener la nueva capacidad lista antes. Planeamos integrar Instantánea de Dynamo de modo que los workers que se unen pueden restaurar un proceso inicializado y el estado de CUDA en lugar de repetir la compilación, el calentamiento de kernels, la construcción de grafos y otros trabajos de arranque.
La comunicación para la topología objetivo debe prepararse por separado porque no se restaura desde la instantánea. Restaurar los pesos de modelos grandes desde el almacenamiento de checkpoints puede dominar el tiempo de restauración, por lo que planeamos conservar la transferencia de pesos de GPU a GPU de Elastic EP desde workers existentes.
Lograr comunicación EP de vanguardia con NIXL EP
Apuntamos a un rendimiento de dispatch y combine de vanguardia con NIXL EP mientras mantenemos compatibilidad total con Elastic EP y tolerancia a fallos. Una próxima actualización de rendimiento de NIXL EP es el siguiente paso hacia ese objetivo (véase el RFC de la hoja de ruta de NIXL EP).
Conectar Elastic EP con la orquestación de Dynamo y llm-d
Con la capacidad a nivel de motor en su lugar, el siguiente paso es usar Elastic EP desde los autoscalers del orquestador. El trabajo hacia esta integración ya está en curso en las comunidades de vLLM, Dynamo y llm-d.
Estos esfuerzos incluyen el trabajo de balanceador de carga externo de vLLM y la propuesta de Elastic EP de Dynamo.
Si ejecutas inferencia a gran escala, te animamos a probar Elastic EP y compartir tus cargas de trabajo y requisitos operativos. Si desarrollas infraestructura de inferencia, agradecemos contribuciones a vLLM Elastic EP y NIXL EP. Logremos que Elastic EP funcione en producción.
Agradecimientos
- A Tyler Michael Smith y Sage Moore de Red Hat por sus invaluables comentarios y revisiones exhaustivas a lo largo de este trabajo.
- A Linoy Geva (NVIDIA) por su trabajo en el rendimiento de servicio durante la preparación.
- A todo el equipo de NIXL por sus esfuerzos en NIXL EP.
- A Tzu-Ling Kan, Julien Mancuso y todo el equipo de Dynamo por sus esfuerzos para dar soporte a Elastic EP en Dynamo.