
Los laboratorios de IA han apostado su reputación a la evaluación comparativa de modelos: el sistema supuestamente neutral y preciso de evaluaciones diseñadas para medir si un producto de IA es mejor que otro.
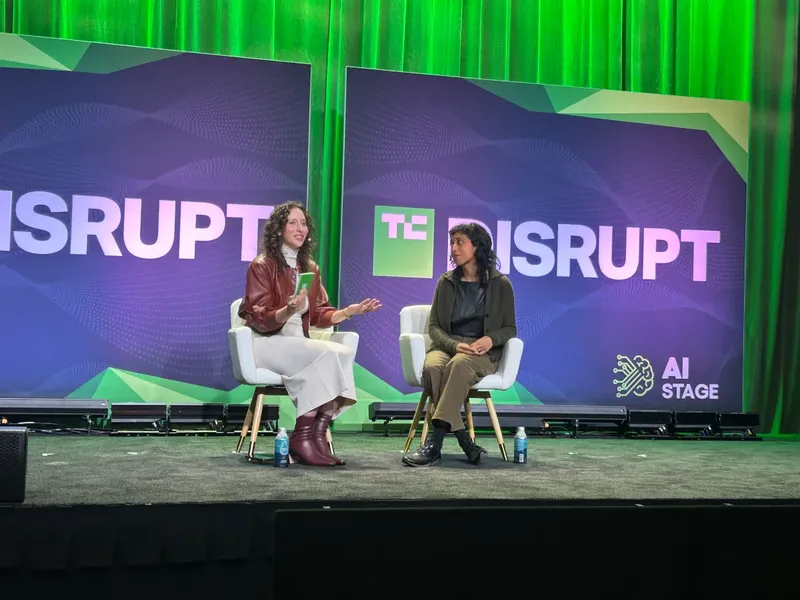
Sin embargo, los métodos detrás de estas evaluaciones son complicados y aún están madurando, dijo Irene Solaiman, directora de políticas de Hugging Face, durante una conversación en TechCrunch Disrupt la semana pasada. Las pruebas necesitan converger en una ciencia más consistente si la industria quiere confiar en ellas en el futuro.
Con esto en mente, ¿podemos confiar en las pruebas actuales que se están publicando?
“Confianza es un término con mucho peso”, dijo Solaiman. “En cuanto a si podemos confiar en los resultados, una gran parte [de eso] es: ¿puedes reproducir los resultados de una evaluación? ¿Tienes el nivel de acceso que necesitas al modelo mismo? Aquí es donde los pesos abiertos entran en juego de manera importante”, agregó.
La reproducibilidad en las evaluaciones de modelos ha sido durante mucho tiempo uno de los aspectos más espinosos de la evaluación comparativa —y sigue siendo un tema de debate significativo en la industria.
Además de la validez de una prueba individual, surge también la pregunta adicional de cómo se compara esa prueba con otras evaluaciones.
“Son una ciencia en evolución —donde no sabemos cómo compararlas de manera significativa entre sí”, dijo Solaiman.
“Empiezan a volverse ineficaces relativamente rápido, y no tenemos un ecosistema tan próspero como necesitamos”, agregó. “Hay un hambre de un ecosistema de evaluadores integrados ahora, pero las calificaciones que determinan quién es un evaluador eficaz en qué tareas necesitan mucha más estandarización.”
La idea de los evaluadores integrados —en la que observadores terceros supuestamente “neutrales” son colocados dentro de las organizaciones de IA— se ha popularizado durante los últimos meses, a medida que los laboratorios de IA lidian con una oleada de incidentes de seguridad que han generado preocupaciones sobre los posibles daños de su tecnología. Hugging Face fue notoriamente el objetivo de uno de esos incidentes.
En lugar de una regulación gubernamental activa para identificar y mitigar preocupaciones de seguridad de los modelos, los laboratorios han impulsado la solución de terceros. Sin embargo, persisten dudas sobre cuán neutrales o eficaces serán realmente esos evaluadores. La decisión de Anthropic de contratar a Accenture como su primer evaluador generó una buena cantidad de reacciones negativas, con algunos críticos burlándose de la idea de que la consultora estuviera calificada para la tarea en cuestión.
Las evaluaciones ahora están pasando de ser meramente una prueba del modelo mismo a una prueba de todo el sistema alrededor del modelo —incluyendo el harness y el agente. El harness —la herramienta que el usuario usa para acceder al modelo— específicamente, tiene mucho que ver con el rendimiento de un modelo, y un modelo más débil con un mejor harness podría superar fácilmente a un modelo de frontera, compartió Solaiman.
“Las evaluaciones agénticas son realmente difíciles y realmente costosas”, dijo Solaiman. “Tenemos simplemente más evaluaciones para modelos. … No tenemos tantas evaluaciones para harnesses, y estamos desarrollando mejores evaluaciones para el agente holístico —porque de eso es de donde mucha gente está obteniendo valor”, agregó.
En otras palabras, el espacio de las evaluaciones es un poco un todos contra todos en este momento, y si la evaluación comparativa va a seguir siendo vista como una herramienta útil para los líderes de la industria, puede ser necesario un enfoque más uniforme y de toda la industria —donde todos estén en la misma página.