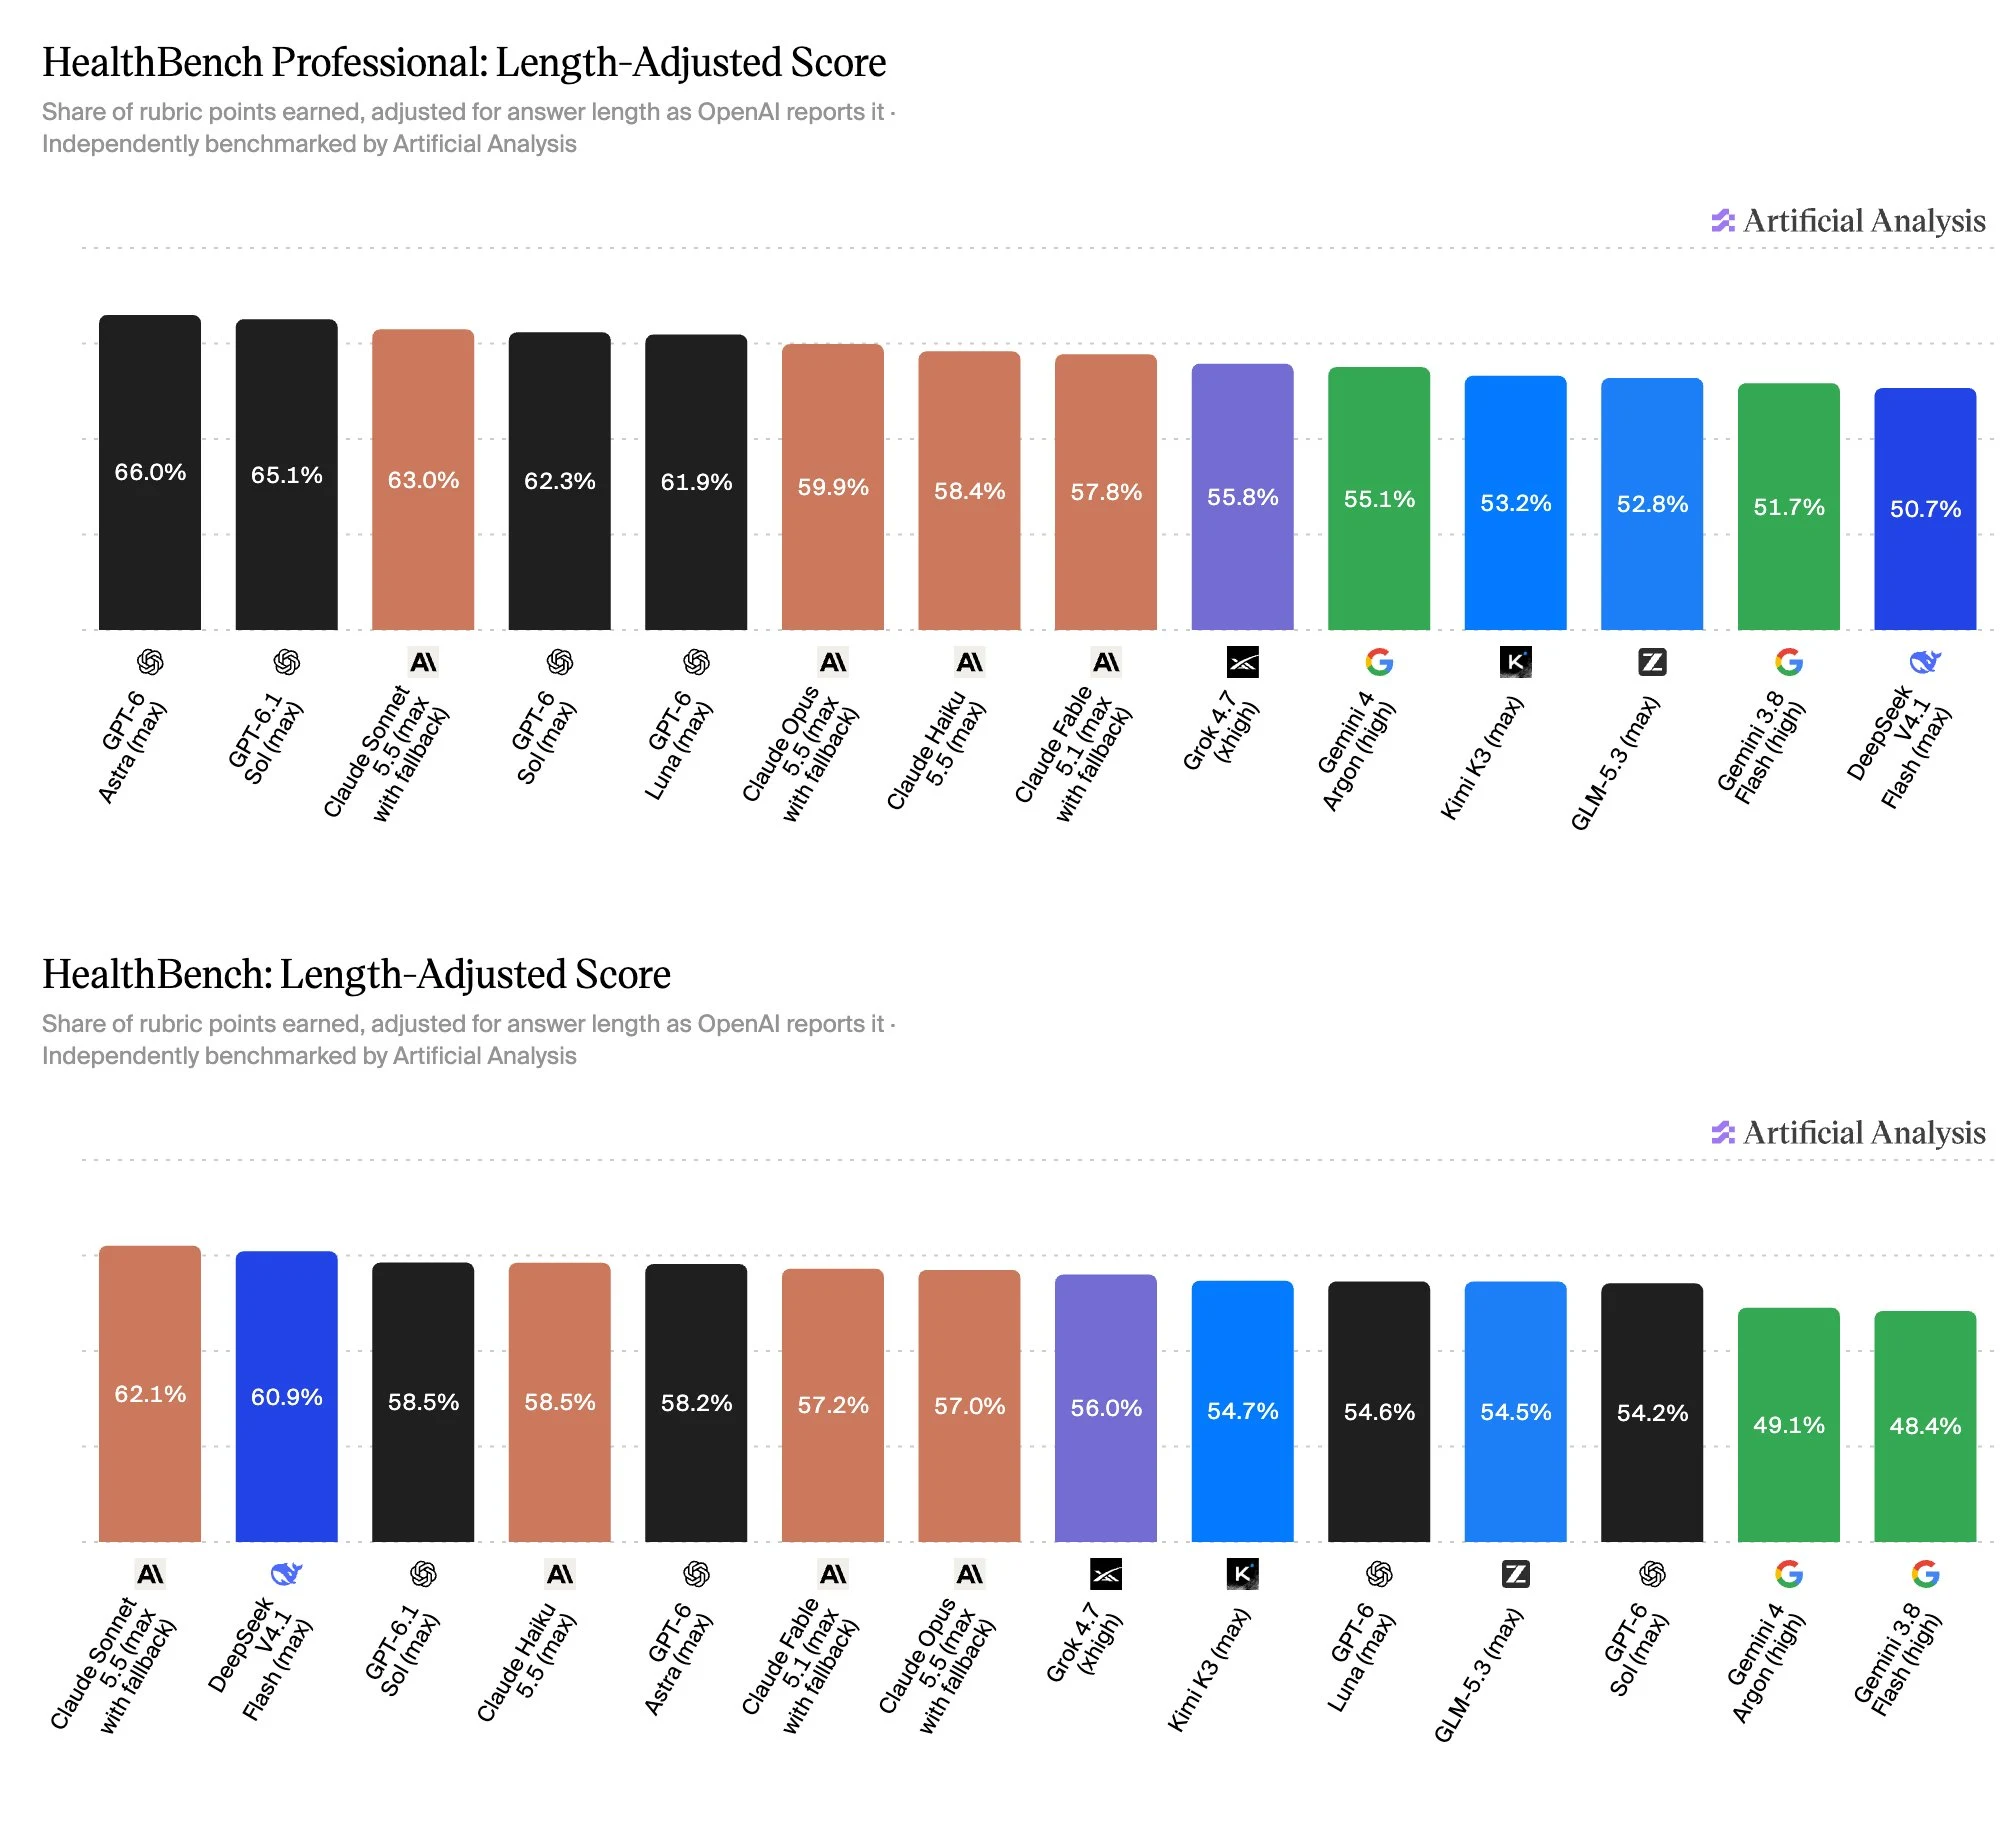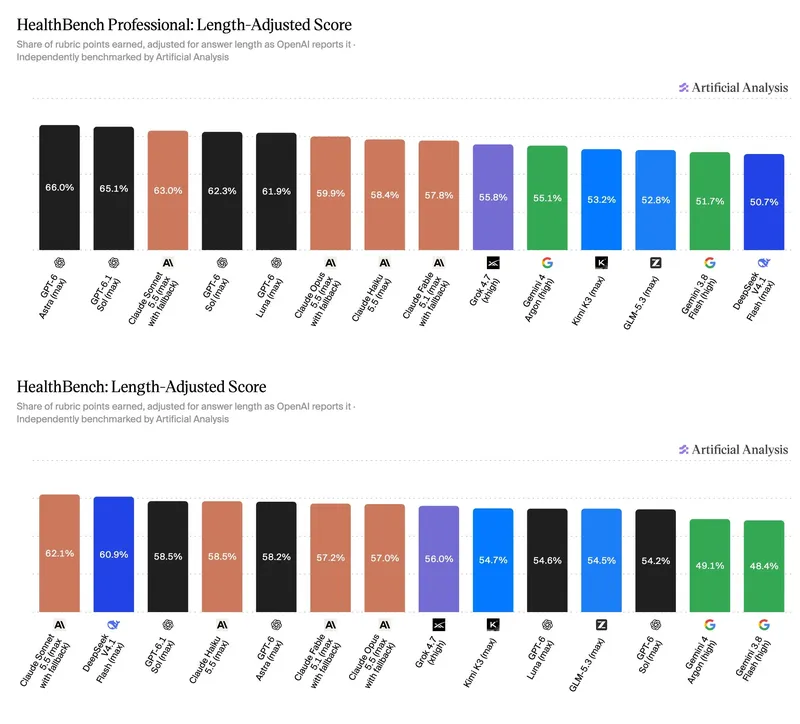
Estamos lanzando tablas de clasificación para HealthBench y HealthBench Professional, dos herramientas que evalúan cómo responden los modelos de IA en conversaciones realistas sobre salud.
HealthBench y HealthBench Professional son referencias de @OpenAI que evalúan las respuestas del modelo a conversaciones sobre salud realistas según criterios establecidos por médicos.
HealthBench prueba los modelos en 5,000 conversaciones de salud con usuarios cotidianos y trabajadores de la salud. Cubren siete temas, desde referencias de emergencias hasta salud global, y cada criterio de la rúbrica corresponde a uno de los cinco ejes: precisión, completitud, calidad de comunicación, conciencia del contexto y seguimiento de instrucciones. HealthBench Professional es un conjunto más pequeño de 525 conversaciones que, a diferencia de HealthBench, están todas con clínicos. Estos abarcan tareas de consulta, escritura e investigación, e incluyen conversaciones adversarias y difíciles diseñadas para poner a prueba los modelos.
Informamos tanto la puntuación bruta (la proporción de puntos obtenidos en la rúbrica) como la puntuación ajustada por longitud que reporta OpenAI. La puntuación ajustada por longitud disminuye la puntuación de las respuestas más largas de 2,000 caracteres y aumenta la puntuación de las más cortas. De acuerdo con la implementación original de OpenAI, las respuestas son calificadas por GPT-5.4 (bajo) (HealthBench Professional) y GPT-4.1 (HealthBench).
Resultados clave para HealthBench Professional:
➤ GPT-6 Astra y GPT-6.1 Sol encabezan el tablero: GPT-6 Astra (máx) obtiene un 66.0% en la puntuación ajustada por longitud, comparable a GPT-6.1 Sol (máx, 65.1%), y está por delante de Claude Sonnet 5.5 (máx con fallback, 63.0%)
➤ Los modelos de OpenAI constituyen toda la frontera de Pareto para puntaje total vs. Costo por tarea: La frontera de Pareto incluye GPT-6 Luna (máx., 61.9%, $0.004 por tarea) hasta GPT-6 Sol (máx., 62.3%, $0.036) y GPT-6.1 Sol (máx., 65.1%, $0.047) hasta GPT-6 Astra (máx., 66.0%, $0.27). GPT-6 Luna (máx.) obtiene 4 puntos menos que GPT-6 Astra (máx.), lo que representa menos del 2% del costo.
➤ Claude Opus 5.5 y Claude Fable 5.1 reciben las peores penalizaciones de longitud: Ambos tienen un promedio de ~5,900 caracteres por respuesta, casi 3 veces el umbral de 2,000 caracteres, y pierden más de 11 puntos después del ajuste. Claude Opus 5.5 (máximo con fallback) tiene la puntuación bruta más alta (71.4%), pero cae al sexto lugar (59.9%). GPT-6 Sol (máximo) es el único modelo que promedia menos de 2,000 caracteres (~1,600), y el único cuya puntuación aumenta
Resultados clave para HealthBench:
➤ Claude Sonnet 5.5 tops HealthBench: Claude Sonnet 5.5 (máximo con fallback) obtiene un 62.1% en la puntuación ajustada por longitud, por encima de DeepSeek V4.1 Flash (máximo, 60.9%) y GPT-6.1 Sol (máximo, 58.5%)
➤ GPT-6 Luna, DeepSeek V4.1 Flash y Claude Sonnet 5.5 forman la frontera de Pareto del costo por tarea: GPT-6 Luna (máximo) obtiene un 54.6% con $0.002 por tarea y DeepSeek V4.1 Flash (máximo) obtiene un 60.9% con $0.005 por tarea. Claude Sonnet 5.5 (máximo con fallback) tiene un costo promedio por tarea de $0.08, ~16 veces más costoso que DeepSeek V4.1 Flash para un aumento de puntuación de ~1 punto
➤ Respuestas más cortas sacrifican la completitud por la calidad de la comunicación: cada ítem de la rúbrica de HealthBench está etiquetado con uno de los cinco ejes. La completitud verifica si una respuesta incluye toda la información importante, mientras que la calidad de la comunicación verifica si es clara, bien estructurada y tiene el tamaño y nivel de detalle adecuados. GPT-6 Sol (máx) escribe las respuestas más cortas (~1,000 caracteres) y tiene el puntaje bruto más alto de calidad de comunicación (81%), pero el puntaje más bajo de completitud (34%). Claude Sonnet 5.5 (máximo con fallback) lidera en Completitud (63%)